Appearance
第 00 章 机器学习基础:从数据拟合到可信预测
0.0 从一次分子性质预测开始
你手里有一批分子的水溶解度数据,接下来还有一批候选分子需要筛选。逐个测量需要时间,我们希望先根据已有数据估计它们的溶解度,再决定优先研究哪些分子。
分子量、疏水性和氢键能力都可能提供线索。一个自然的想法是:把这些信息整理成一张表,用已有分子的测量结果拟合一个模型,再让它预测新分子。
这件事与实验课中的数据拟合有不少相通之处。我们仍然要选择输入、确定函数形式,并根据误差调整参数。接下来还要回答一个问题:模型在已有数据上拟合得不错,遇到没有参与拟合的分子时,表现会怎样?
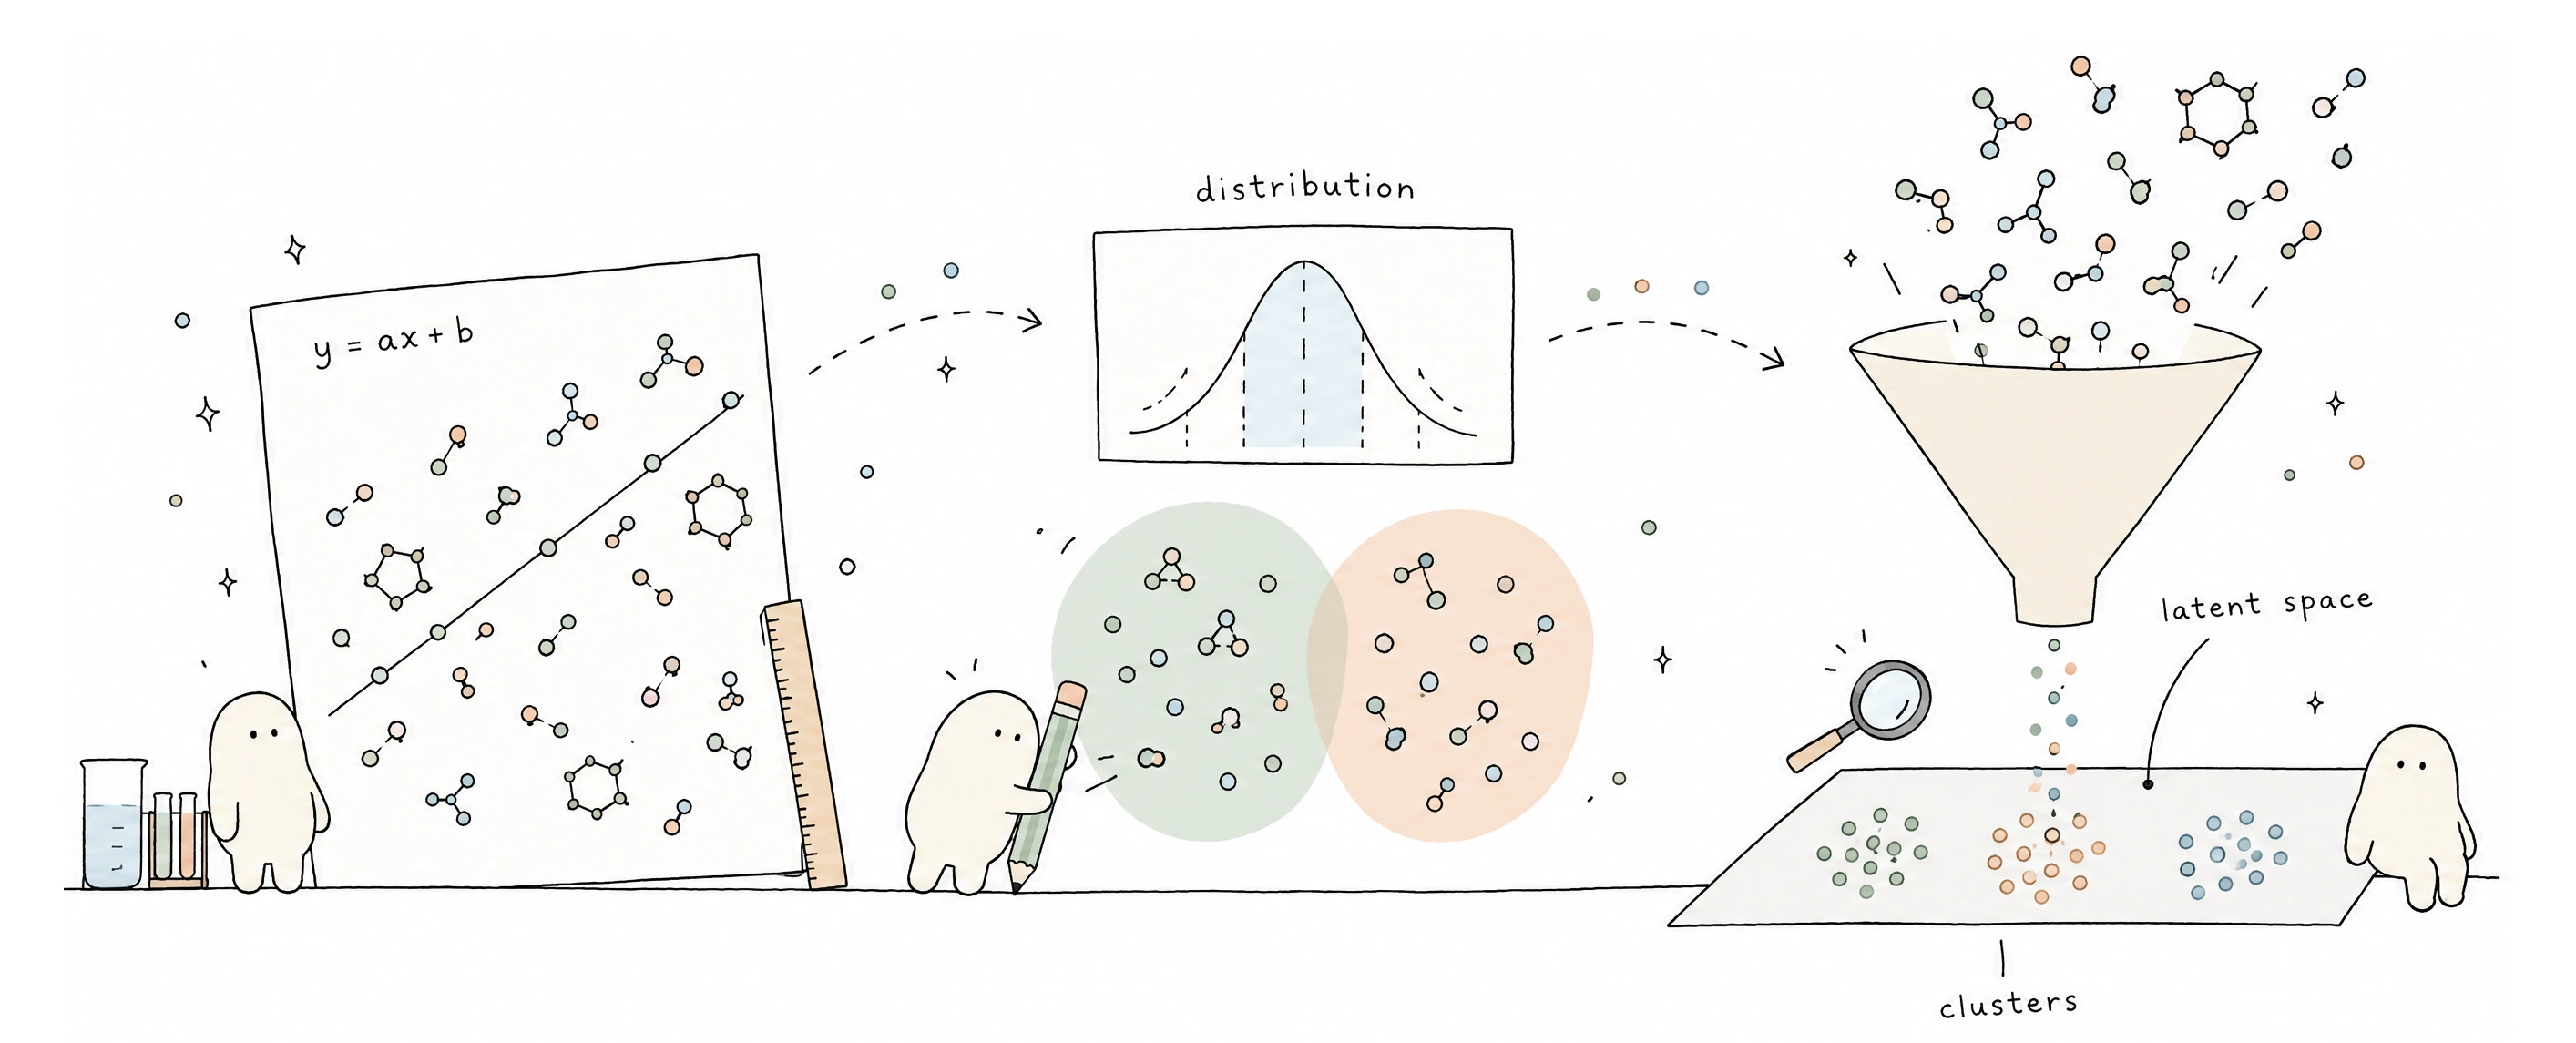
本章沿着这个问题展开。先完成一次简单的溶解度预测,看看结果有什么用、错在哪里,再解释参数怎样更新,以及怎样改进模型。做材料研究时,可以把预测对象换成带隙、形成能或电导率;具体的数据和评估方式需要调整,基本思路可以对应起来。
0.0.1 本章要预测什么
本章用 DeepChem 加载公开的 Delaney/ESOL 数据集 [1,2]。它包含 1,128 个分子的结构与水溶解度记录。我们用分子描述符预测数据中的实测 logS;“描述符”就是把结构转换成模型可以读取的数,例如分子量或极性表面积。
化学中通常用下面的形式解释 logS:
按这一约定,logS=-3 对应 。预测误差为 1 个对数单位,意味着浓度尺度相差约一个数量级。logS 是浓度比值的对数,不能直接把它的单位写成 mol/L。
需要注意的是,DeepChem 加载的数据中,目标列名为 measured log solubility in mols per litre,没有逐条提供温度、pH 或测定协议。因此,这是一组公开水溶解度记录,不能假定所有样本的测量条件已经一致。我们先用它练习建模,解释结果时再回头检查这些缺失信息可能造成的影响。
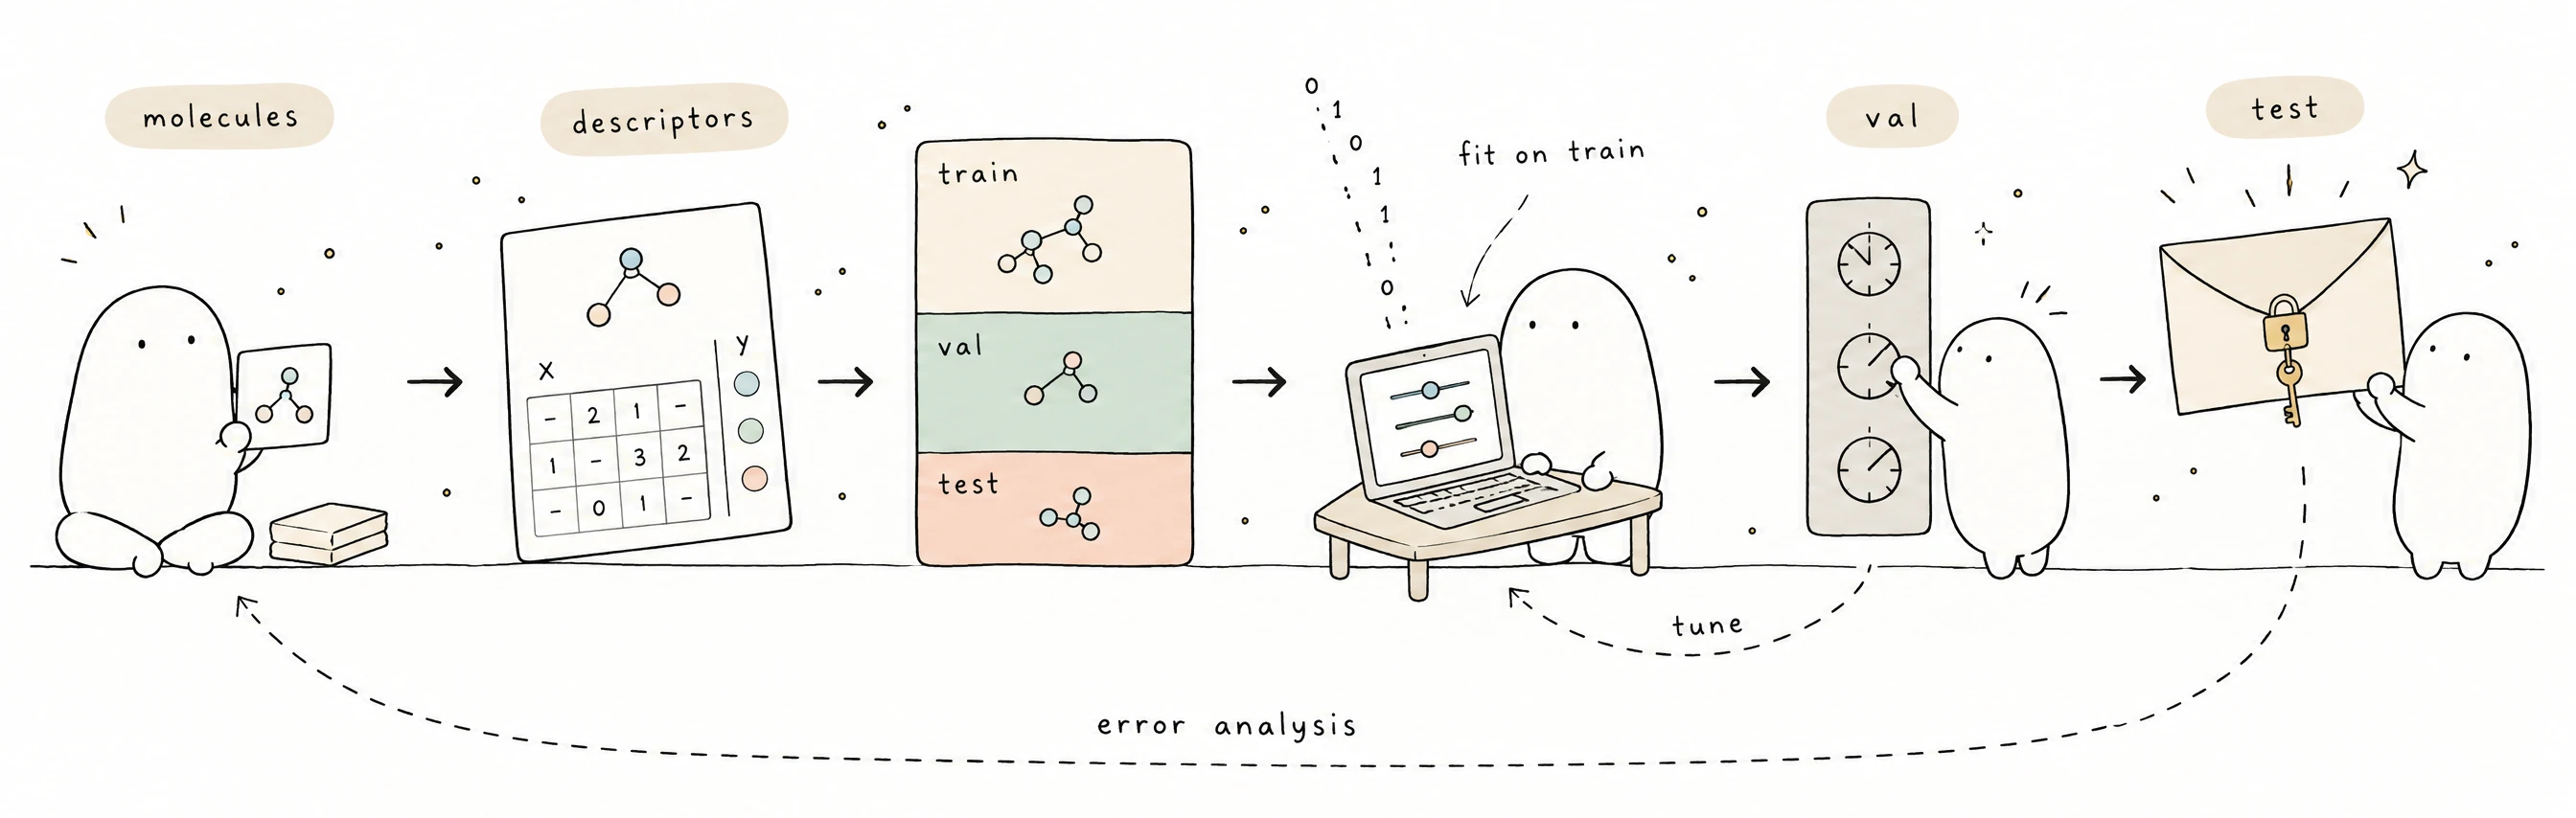
图 1 给出了接下来要走的路线:整理数据、留出评估样本、拟合模型,再检查预测结果。
0.0.2 先做一个简单模型,有什么用
同一份数据可以尝试很多模型。开始之前,先用一个简单模型建立参照,会更容易判断后续改动是否有用。例如,只用六个描述符的线性模型已经能做到什么程度?换成更复杂的模型后,在相同评估规则下是否确实更好?
这个参照称为基线。基线能帮助我们发现哪些特征已经携带预测信息,也能提醒我们检查数据、训练和评估方法。它的预测有效,并不自动说明某个描述符是性质变化的原因。
学完本章,你应当能把性质预测问题整理成数据表,完成一次基本的训练与评估,并根据误差提出下一步要核查的问题。梯度下降、正则化和表示学习会在这个过程中逐一引入;完整推导和手写实现可以留到第二轮。
0.0.3 本章怎样读、代码怎样运行
本章我们默认大家接触过函数、导数和基本的 Python 数组操作。机器学习术语会结合案例解释;遇到暂时不熟悉的矩阵写法,可以先看它对应的数据表和数值例子。
首次阅读可以顺着正文往下读。 第 0.1–0.2 节完成数据、拟合、评估与误差分析;第 0.3–0.4 节解释参数怎样学出来,以及怎样检查和改善训练;第 0.5 节把同一份数据改写成筛选任务;第 0.6–0.7 节介绍神经网络与可学习表示,为后续章节铺路。
标有“第二轮”的折叠内容保存完整推导和较长实验。学过第 01–03 章的计算图与反向传播后,再回来独立实现这些方法。第一轮重点看每种方法解决什么问题,以及数值结果说明了什么。
本章的代码分为两类:
- ESOL 建模主线使用真实分子数据。未折叠的主线代码按出现顺序运行,后面的模型会沿用前面读取的数据和划分结果。
- 机制实验使用合成数据、玩具函数或人为向量,单独观察一种算法的行为。请在独立脚本或新会话中运行这些折叠实验,避免覆盖 ESOL 的
X、y等变量。它们的数值用于解释机制,不能当作真实分子任务的性能。
读代码时,先找输入、输出和数组形状。X.shape 表示各维度的长度;X @ w 是矩阵乘法,X * w 是逐元素乘法;对本章“行是样本、列是特征”的表格,mean(axis=0) 求出每一列的均值。具体例子会在用到时展开。
表 1 本章实验导览。首次阅读先走通 ESOL 主线,机制实验可在理解用途后再做。
| 所在小节 | 实验内容 | 数据 | 重点观察 |
|---|---|---|---|
| 0.1.2、0.2.1–0.2.2 | 读取分子数据,训练线性模型并与基线比较 | 真实 ESOL | 模型是否比始终预测平均值更好 |
| 0.2.3 | 检查验证集上残差最大的分子 | 真实 ESOL | 误差提示哪些信息需要核查 |
| 0.2.4、0.4.3 | 比较划分方式,用验证集选择正则强度 | 真实 ESOL | 未来预测对象怎样影响评估 |
| 0.3.5 | 比较优化器的更新轨迹 | 玩具函数 | 同一步数下,参数和损失怎样变化 |
| 0.4.2 | 比较 Ridge 与 Lasso | 合成数据 | 系数是否变小,选中的是否为真实变量 |
| 0.5.1–0.5.2 | 用逻辑回归筛选“较易溶”分子 | 真实 ESOL | 推荐了多少、误报了多少、漏掉了多少 |
| 0.5.3 | 比较稀有阳性任务中的 ROC 与 PR | 合成数据 | 排序分数高是否足以指导实验 |
| 0.6.3–0.6.4 | 观察深层信号传播,手写 BatchNorm | 合成数据 | 信号尺度和归一化的统计范围 |
| 0.6.6 | 比较随机留出与整簇留出 | 合成数据 | 新簇出现时,三种模型的表现怎样变化 |
| 0.7.3 | 计算负采样与三元组损失 | 人为向量 | 哪些样本产生损失和梯度 |
0.1 把研究问题整理成数据表
0.1.1 从熟悉的数据拟合认识机器学习
在我们学习物理化学课程时,已经知道,Arrhenius 方程描述速率常数随温度的变化:
令 、,就得到 。我们用实验散点拟合斜率和截距,再根据 、 得到物理参数。这里已经包含几个机器学习的基本动作:选择输入、选定函数形式、定义误差,并用数据确定参数。表 2 把这些动作换成机器学习的通用语言,并对应到本章的溶解度案例。
表 2 数据拟合与机器学习的术语对照。左列是物理化学实验课中的习惯说法,中列是本章使用的机器学习术语,右列是它们在 ESOL 溶解度案例中的具体对象。
| 数据拟合中的说法 | 机器学习中的说法 | 本章溶解度案例 |
|---|---|---|
| 一条实验记录 | 样本 | 一个分子的结构和实测 logS |
| 自变量 | 特征 | 分子量、疏水性等描述符 |
| 因变量 | 标签 | 实测 logS |
| 拟合方程 | 模型 | 描述符到 logS 的映射 |
| 斜率、截距 | 参数 | 权重 与截距 |
| 残差的总体大小 | 损失 | 按选定规则汇总误差,例如残差平方的平均值 |
| 拟合参数 | 训练 | 用训练数据更新参数 |
把这些术语放回实验课的情境中,含义就很熟悉了:“训练”是用数据确定参数,“模型”是用于预测的函数。线性回归、决策树和神经网络允许的函数形式不同,需要的数据量也可能不同。
对已有样本拟合得好,只说明模型能重现这批记录中的数值关系。我们还希望它对没参与拟合的分子有用,这种能力称为泛化。要评价泛化,就得先想清楚未来的分子是什么样的:是已有结构的近似衍生物,还是全新的骨架?第 0.2 节会把这两种情境分开评估。
因此,后面会专门留出一部分分子,不让它们参与拟合,再检查预测效果。在此之前,先看怎样把分子结构整理成模型能读取的数据。
第二轮理解:经验风险与泛化理论
设训练集有 个样本,模型预测为 ,单个样本的损失为 ,训练集平均损失是:
统计学中把损失的期望称为“风险”。“经验”表示这里用手上这一批观测数据的平均代替了期望;“经验风险最小化”就是寻找使这个平均损失尽量小的参数。
未来样本的输入和目标服从某个联合分布 。我们真正希望减小的是该分布上的平均损失:
若分布具有密度,可以写成相应积分;分子类别等离散变量则需要求和或采用一般的期望表达。实际中不知道整个分布,只能用有限样本估计。经验风险最小化写成:
表示允许选择的参数集合, 返回使目标最小的参数。训练数据若不能代表未来分布,单纯把经验风险压低不能解决分布差异。
归纳偏置指模型在数据之外采用的假设,例如线性关系、局部作用,或能量对整体旋转不变。它帮助模型在多个能拟合训练数据的函数中作出选择。“没有免费午餐”定理 [3] 提醒我们,算法优势依赖所考虑的任务集合与假设;选择化学模型时,需要判断这些假设是否适合研究对象。物理先验是其中一种来源。
在独立同分布样本、损失限制在 等条件下,一类常见的泛化界为:
这里 是候选预测函数的集合, 表示它们对应的损失函数集合; 和 分别表示真实风险和训练集上的经验风险,即前文的 与 ,只是自变量从参数 换成了它所确定的函数 。 称为经验 Rademacher 复杂度,衡量这一函数集合对随机正负符号的拟合能力。 是允许界不成立的概率,因而界以至少 的概率成立。
这类结果把训练误差、模型的函数范围和样本量联系起来。式(6)要求损失有界,不能直接套到未有界的 MSE;具体常数也随定理版本而异 [4,5]。
物理约束可以减少不合理预测,例如由 的梯度定义力 ,或要求整体旋转不改变标量能量。哪些量应保持不变、哪些量应随坐标变换,以及需要什么边界条件,都应由目标性质决定。采用这些约束后,仍需独立评估预测效果。
0.1.2 一行一个分子,一列一个特征
一张用于预测的数据表,需要同时记录分子的已知信息和我们想预测的性质。已知信息放在特征列中,实测 logS 则作为目标值。本章先采用六个描述符:分子量 MolWt(g/mol)、用 Crippen 原子贡献法估算的辛醇/水分配系数对数 MolLogP(无量纲,反映疏水性;注意它是计算估计值而非实测值 [6])、氢键供体数、氢键受体数、拓扑极性表面积 TPSA(Ų)、可旋转键数。它们是一个方便解释的起点,并不完整描述构象、晶体堆积或实验环境。
一行是一个分子,一列是一个特征。 把所有特征排成矩阵 ,则 有 行、 列。本例 、;标签向量 有 1128 个数。SMILES 是结构的字符串表示,先由 RDKit 解析,再计算描述符。表 3 给出数据的前三行,可以对照着理解“行是样本、列是特征”。
表 3 ESOL 数据的前三条记录及其六个描述符。为便于阅读,连续量保留两位小数,计数类描述符(供体数、受体数、可旋转键数)为整数;训练时使用原始精度。分子名称保留数据集中的原始拼写(例如 Amigdalin,即苦杏仁苷 amygdalin)。SMILES 只用于计算描述符,本身不是六个数值特征中的一列。
| 分子(Compound ID) | 分子量 | MolLogP | 供体数 | 受体数 | TPSA | 可旋转键数 | 实测 logS |
|---|---|---|---|---|---|---|---|
| Amigdalin | 457.43 | -3.11 | 7 | 12 | 202.32 | 7 | -0.77 |
| Fenfuram | 201.23 | 2.84 | 1 | 2 | 42.24 | 2 | -3.30 |
| citral | 152.24 | 2.88 | 0 | 1 | 17.07 | 4 | -2.06 |
先对照熟悉的化学知识读这三行:苦杏仁苷有 7 个氢键供体、TPSA 超过 200 Ų,MolLogP 为负,溶解度在三者中最高;另外两个分子 MolLogP 接近 3,溶解度分别低约 2.5 和 1.3 个数量级。这三条记录可以帮助理解数据,但还不足以确定一般规律。接下来让模型利用全部训练记录,拟合描述符与 logS 的关系。
下面先把这张表读入程序。取数代码调用 DeepChem 官方加载器,并显式指定处理方式:计算六个描述符,暂不划分数据,保持实测 logS 的原始尺度;随后在独立步骤中划分数据和标准化输入。
python
import numpy as np
import deepchem as dc
from rdkit import Chem
from rdkit.Chem import Descriptors

FEATURE_NAMES = ["MolWt", "MolLogP", "NumHDonors", "NumHAcceptors",
                 "TPSA", "NumRotatableBonds"]


class SixDescriptors(dc.feat.MolecularFeaturizer):
    """明确列顺序:每个分子生成六个数,不调用训练好的预测器。"""
    def _featurize(self, mol, **kwargs):
        return np.array([getattr(Descriptors, name)(mol)
                         for name in FEATURE_NAMES], dtype=float)


def load_data():
    # 首次运行会自动下载公开 CSV;splitter=None 表示暂不划分,
    # transformers=[] 表示不对 logS 做任何变换。
    tasks, datasets, _ = dc.molnet.load_delaney(
        featurizer=SixDescriptors(), splitter=None, transformers=[],
        reload=False)
    dataset = datasets[0]
    # y 原形状是 (N, 1),取单个任务这一列,成为 (N,)。
    X, y = dataset.X.astype(float), dataset.y[:, 0].astype(float)
    if not np.isfinite(X).all() or not np.isfinite(y).all():
        raise ValueError("数据有非有限值,需要先检查,而不能直接训练。")
    if not (dataset.w[:, 0] > 0).all():
        raise ValueError("有缺失目标值,需要明确处理。")
    return dataset, X, y, tasks


dataset, X, y, tasks = load_data()
print(X.shape, y.shape) # (1128, 6) (1128,)class SixDescriptors 定义一种描述符计算器,_featurize 告诉 DeepChem 怎样把一个分子变成六个数;这是取数接口,首次阅读先抓住列顺序和输出形状。getattr(Descriptors, name) 按名称取出 RDKit 的对应计算函数。
首次运行时,DeepChem 会把数据下载到它的默认数据目录;如需指定位置,可以设置环境变量 DEEPCHEM_DATA_DIR,代码本身不需要写入任何本地路径。
datasets[0] 是一个 DeepChem 数据集对象。dataset.X 是特征;dataset.y 的形状为 ,末尾的 1 表示这里只有一个预测任务;[:,0] 取这一列后得到 。dataset.ids 保存 SMILES,骨架划分会用到它。
CSV 还包含 ESOL predicted log solubility in mols per litre,那是 Delaney 原文 ESOL 模型的预测值。本章只使用上述六个结构描述符作为输入;如果把这一列也作为输入,比较的就不再是“六个结构描述符能预测到什么程度”,还会混入已有预测模型的信息,可能使结果显得更好。因此,特征列要按研究问题明确指定。取数时检查缺失目标和非有限特征值;划分后应保存各子集的索引,以便复现。
输入与目标已经分开了。预测连续的 logS 数值,称为回归任务。接下来需要规定:怎样评价一次预测错得有多远?
拓展阅读:性质预测与其他学习任务
本章根据输入预测已有的实测值,属于监督学习。按有没有目标值、目标是什么形式,常见的学习任务可以这样区分:
- 监督学习:已知输入和目标,学习二者之间的预测关系。预测 logS 是回归;判断 logS 是否超过某个筛选阈值是分类。标签可以来自实验或计算,不必假定它们毫无误差。
- 无监督学习:没有指定目标值,分析样本结构,例如把分子分组、降低轨迹维度。分出来的组是否具有化学意义,还需要领域检查。
- 半监督与自监督学习:半监督利用少量标注与大量未标注数据;自监督从数据自身构造训练目标,例如遮住一部分结构后预测它。这两者有联系,但含义不同。
- 生成式建模:学习怎样生成结构或其他数据,也可以加上目标性质条件。它可以采用不同训练方式,与前面几类不是互斥的分类层次。
本章先做监督学习中的回归,第 0.5 节再做分类。预训练和逆向设计会在后续章节继续讨论。
0.1.3 先说清楚预测错了多少
对一个分子,先用预测值减去实测值,得到残差。残差为正,表示预测偏高;为负,表示预测偏低。要比较一批分子的预测效果,还需要把这些残差汇总起来。用于衡量预测错误的汇总值,称为损失;训练时通过调整参数让它减小。
把第 个分子的实测值记为 ,预测值记为 ,共有 个分子。下面的公式只是把逐个计算、再求平均的过程写在一起。
一种办法是先平方,再求平均,称为均方误差(MSE)。平方后,正负残差不会互相抵消,大的错误也会占更大权重:
如果三个预测残差分别为 个 logS 单位,MSE 为 。平方使大残差贡献更大。另一种办法是先取绝对值再平均,称为平均绝对误差(MAE)。同一组残差的 MAE 为 ,表达的是平均相差多少个 logS 单位。
MSE 和 MAE 都可以用作训练目标或评估指标。选择时要看研究对大误差、异常值和筛选失误的代价。正因为平方会放大大残差,MSE 对少数异常样本特别敏感:如果数据中混入了录入错误的实验值,或者在材料计算数据中混入了自洽场(SCF)迭代未收敛的结果,这几个样本就可能主导整个损失。遇到这类可疑样本,应先核查数据来源,而不是先换损失函数掩盖问题。
下面先用 MSE 来确定模型参数,用 MAE 帮助解释结果。
第二轮推导:为什么平方误差可以作为训练目标
假设 ,误差独立且 ,其中 不随样本或模型参数改变。条件密度为:
把全部观测数据的联合密度看作参数 的函数,就得到似然函数。误差独立时,联合密度是各样本密度的乘积;取负对数后,乘积变为求和:
固定 后,最小化式(9)的负对数似然与最小化式(7)的 MSE 有相同的最优参数。这说明 MSE 的一种概率解释;使用 MSE 本身不要求先证明所有实验噪声一定是高斯噪声。若各样本噪声尺度不同,可以考虑加权损失或显式建模方差。
若误差采用拉普拉斯分布,负对数似然对应绝对误差。MAE 较少放大极端残差,但也不是所有异常值问题的完整解决方案。
现在有了输入、目标和误差的定义,可以把它们接成第一个预测模型。
0.2 完成第一次溶解度预测
0.2.1 留出评估数据,再训练线性模型
把一个分子的六个描述符记为 ,线性回归预测:
每个 决定对应特征在预测中的贡献, 是截距。先把六列分别乘以各自的权重,再相加,就得到一个分子的预测 logS。这是线性模型;实际关系可能更复杂,我们先看这一简单假设能做到什么程度。
例如,只有两个已经缩放过的特征 ,权重 ,截距 ,则预测为 。把一批分子一起算,就是 :矩阵的每一行与同一个权重向量做内积,得到这一行分子的预测值。图 2 用一个小例子展示了这些数组的形状关系。
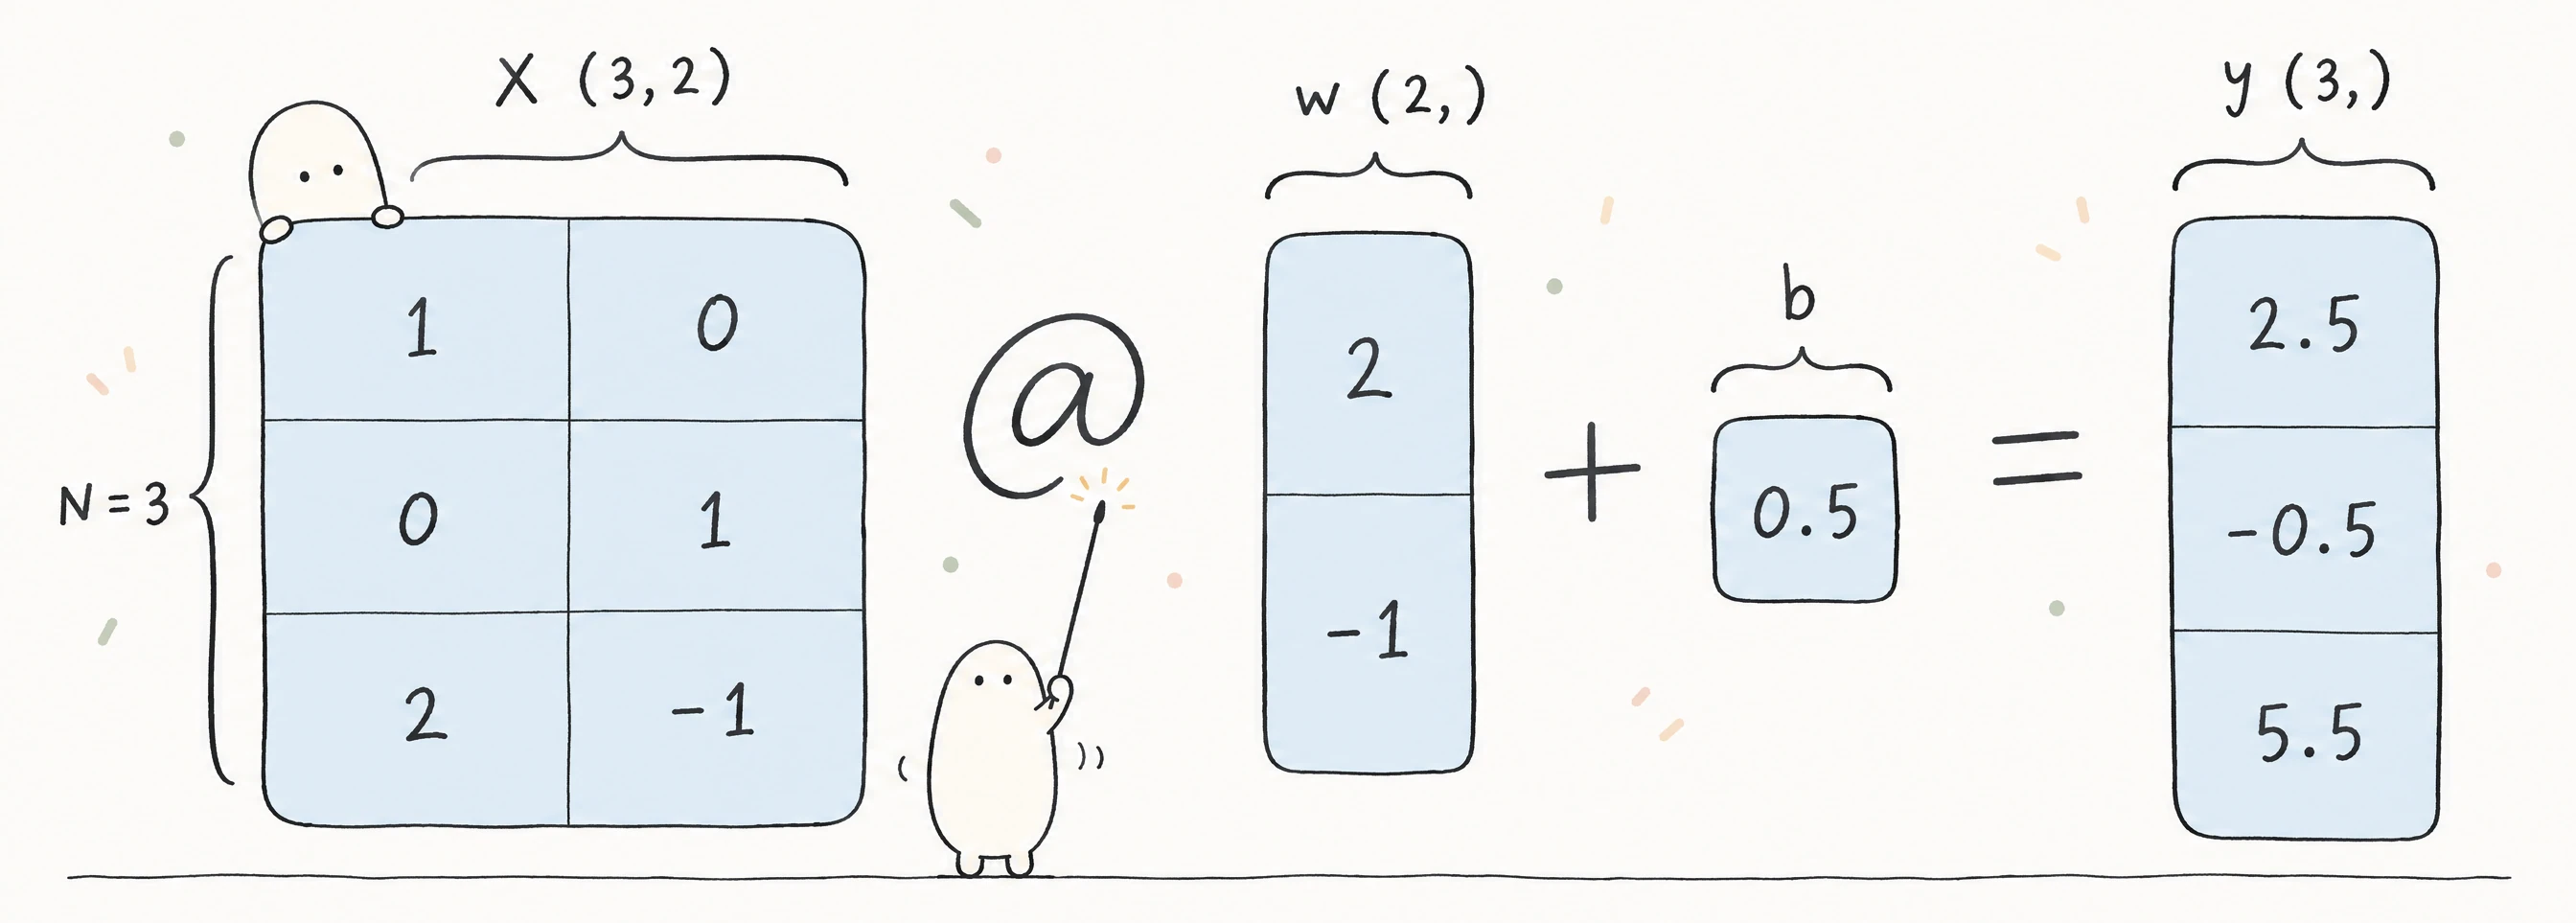
X 乘以 的 w,得到 的输出;截距会加到每个样本上。第一步,先留出用于评估的分子。 如果一边用某个分子的实测值调整参数,一边拿它证明模型预测得准,就还没有检查过新分子的表现。因此,我们把数据分成三份:
- 训练集用于确定模型参数。
- 验证集用于比较模型和设置,例如选多大的正则强度;有些教材称它为开发集,代码中用
dev表示。 - 测试集留到所有选择固定后做最终评估。根据测试结果反复改模型,会让它失去独立评估的作用。
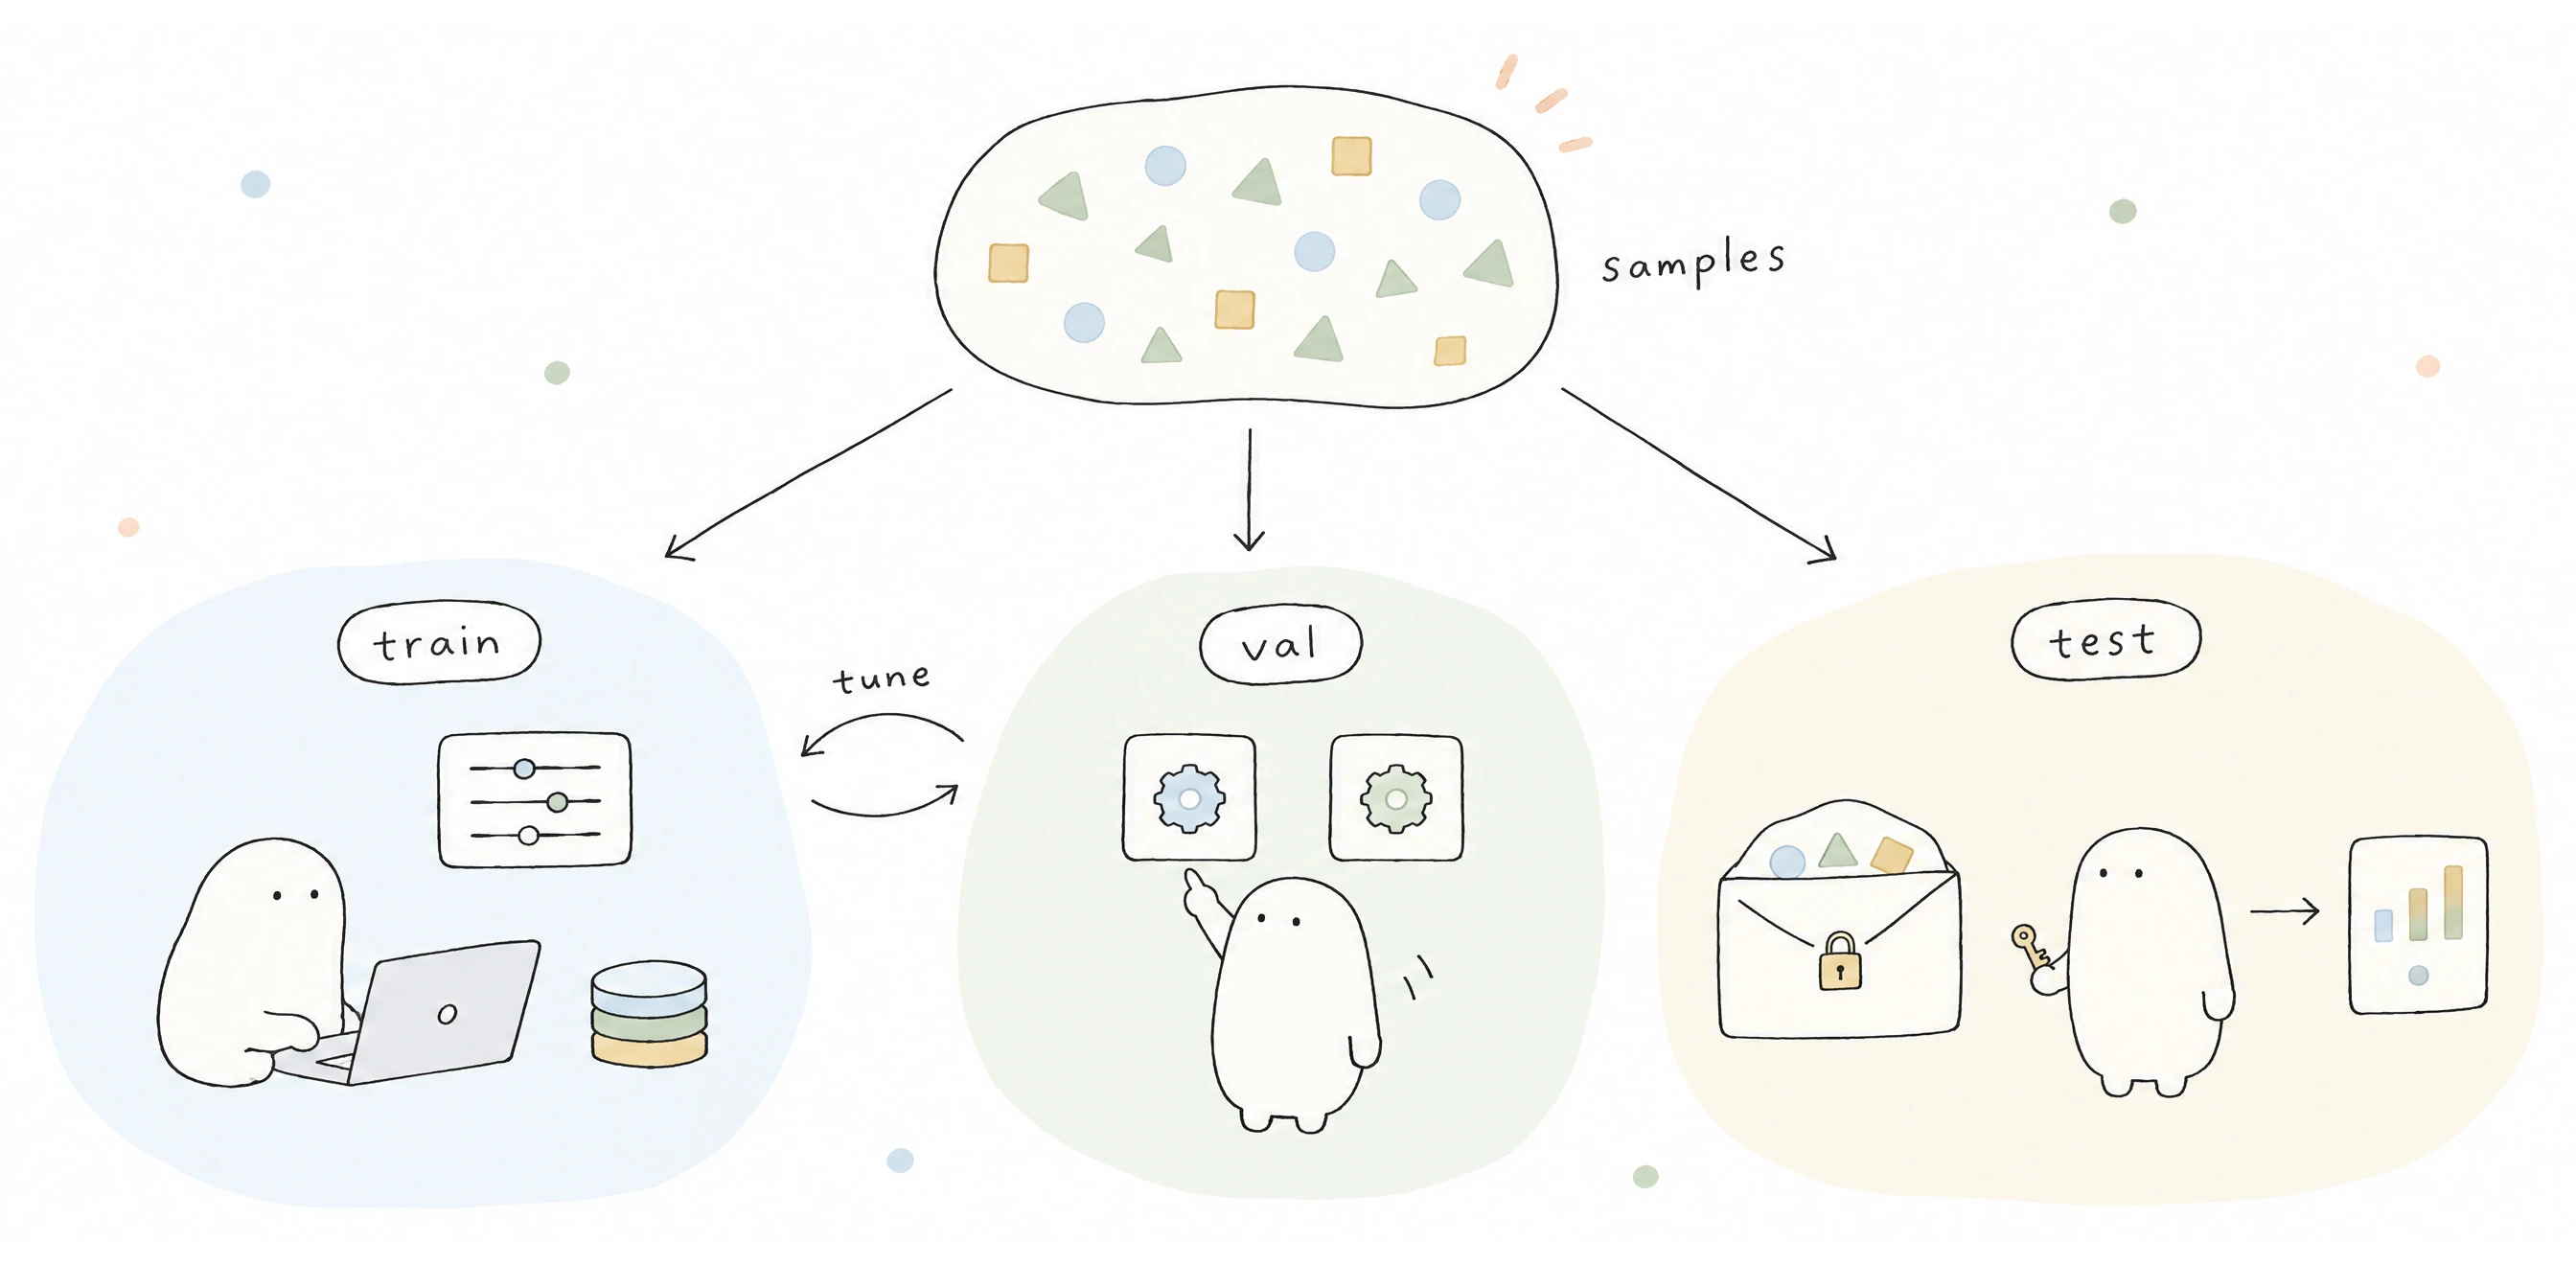
还要避免把同一个结构的重复记录拆到不同子集。本数据集按 RDKit 规范化 SMILES 后,有 1,117 种结构表示;11 组重复结构涉及 22 条记录,其中 6 组的两条标签不同。我们保留这些记录,但让相同表示始终进入同一子集。这一规则并不保证处理了所有盐型、互变异构或测定差异。
下面按结构分组,再随机分配这些组,固定随机种子为 42。RandomGroupSplitter 按组数取 80%/10%/10%,所以记录数只近似满足比例;本次为 901、115、112 条。
python
# 接着第 0.1.2 节的取数代码运行。先确定训练/验证/测试索引。
canonical_smiles = [Chem.MolToSmiles(Chem.MolFromSmiles(sm))
                    for sm in dataset.ids]
train_idx, dev_idx, test_idx = dc.splits.RandomGroupSplitter(
    groups=canonical_smiles).split(
dataset, frac_train=0.8, frac_valid=0.1, frac_test=0.1, seed=42)第二步,让各列特征处在便于计算的尺度上。 分子量可能是几百,供体数通常只有几个。这里对每列减去训练均值,再除以训练标准差,称为标准化;第 0.3.2 节会用数值例子解释它怎样帮助训练。
均值和标准差只从训练集计算,验证集和测试集沿用这组数值。特征选择等需要从数据估计的处理,也应在训练数据上拟合。
python
def standardize(X_train, *others):
    # 只从训练集计算;验证和测试不能参与估计均值、标准差。
    mu, sd = X_train.mean(axis=0), X_train.std(axis=0)
    sd = np.where(sd == 0, 1.0, sd)
return [(X - mu) / sd for X in (X_train,) + others], mu, sd第三步,用训练数据调整权重。 下面先从零权重开始,反复计算预测误差并更新参数。第一次读时,抓住“计算预测—比较实测值—调整参数”这一循环即可;grad_w、grad_b 的含义和推导放在第 0.3.1 节。
python
def fit_linear(X, y, lr=0.03, epochs=10000):
    """目标 L = mean((X @ w + b - y)**2) / 2。"""
    w, b = np.zeros(X.shape[1]), 0.0
    for _ in range(epochs):
        error = X @ w + b - y                  # (N,)
        grad_w = X.T @ error / len(y)          # (D,)
        grad_b = error.mean()                  # 标量
        w = w - lr * grad_w
        b = b - lr * grad_b
    return w, b

(Xtr, Xdev, Xte), mu, sd = standardize(X[train_idx], X[dev_idx], X[test_idx])
ytr, ydev = y[train_idx], y[dev_idx]
w, b = fit_linear(Xtr, ytr)
prediction = Xdev @ w + b
print(f"验证 MAE: {np.abs(prediction - ydev).mean():.4f}") # 0.6970prediction 中保存了 115 个验证分子的预测值。w 的长度为 6,与特征表的六列一一对应;同一组参数用于所有分子。线性回归可以从零权重开始,各系数仍会因对应特征不同而得到不同更新;隐藏层的初始化问题在第 0.6.3 节讨论。
现在先读这个结果:验证 MAE 约为 0.697。它代表什么,是否已经有用?需要把它放回 logS 的尺度,并与一个更简单的参照比较。
0.2.2 预测有多准,先和基线比一比
先与一个完全不看分子结构的模型比较:无论输入什么,都预测训练集的平均 logS。它提供了判断描述符是否有用的最低限度参照。
python
baseline = ytr.mean()                                  # 只用训练标签
print(f"均值基线验证 MAE: {np.abs(baseline - ydev).mean():.4f}") # 1.6911表 4 固定随机分组划分(种子 42)下,均值基线与六特征线性回归的训练和验证 MAE,来自实际运行。误差单位是 logS 单位;验证样本没有参与训练。测试集结果在第 0.2.4 节与另一种划分方式一起报告。
| 模型 | 训练 MAE | 验证 MAE |
|---|---|---|
| 训练均值基线 | 1.6415 | 1.6911 |
| 六特征线性回归 | 0.7793 | 0.6970 |
表 4 有两点值得注意。第一,线性回归把验证 MAE 从 1.69 降到 0.70,即平均误差从约 1.7 个数量级降到约 0.7 个数量级,说明这六个描述符确实携带溶解度信息。第二,验证误差(0.697)反而略低于训练误差(0.779)。本次验证集的平均误差确实更低,但不能据此断言模型总会对新分子预测得更好。验证集只有 115 条,分子的难易组成会影响这个数值。小样本上的误差本身有波动,第 0.2.4 节还会遇到这一现象。
除了 MAE,后面还会用到两个回归指标。RMSE 先计算均方误差再开方,对少数大残差更敏感; 比较模型的平方误差与标签围绕本评估集均值的变化大小。它们分别写为:
跨数据集比较 要注意目标范围;同样 MAE,在变化范围很窄或很宽的测试集上有不同含义。ESOL 应在原始 logS 尺度报告,不能拿标准化后目标的误差与原始尺度直接比较。
“化学精度”常以能量误差约 表示,其中 eV 换算按单分子事件的能量理解。它不是所有材料性质和实验筛选的统一成功标准;溶解度、带隙、力、选择性都需要自己的可接受误差与应用条件。
这些指标描述的是整批样本的表现。MAE 为 0.70 个 logS 单位,不表示每个分子的误差都小于 0.70;一个平均数也看不出错误集中在哪类分子。下一节就把大残差样本单独拿出来看。
第二轮核对:训练是否收敛,系数可以怎样解释
线性回归还可以直接求最小二乘解。把它与刚才的梯度下降预测比较,可以检查训练是否充分收敛:
python
# 在特征矩阵末尾加一列 1 表示截距,直接求最小二乘解
A = np.c_[Xtr, np.ones(len(Xtr))]
theta = np.linalg.lstsq(A, ytr, rcond=None)[0]
gap = np.abs(np.c_[Xdev, np.ones(len(Xdev))] @ theta - prediction).max()
print(f"与最小二乘解的最大预测差: {gap:.1e}") # 约 2e-09两种解法的最大预测差约为 ,说明这组设置下的梯度下降已收敛到最小二乘解。这个检查验证的是训练计算;模型预测新分子的能力仍要由独立数据评估。
训练得到的标准化系数也可以读出一些信息。w 依次对应六个描述符,约为 。MolLogP 的系数绝对值最大:MolLogP 每升高一个训练集标准差,预测 logS 约降低 1.66 个单位,与“越疏水越难溶”的化学直觉一致。不过,描述符之间存在相关(例如分子量与氢键受体数、TPSA 的相关系数约为 0.5–0.6),单个系数的大小和符号会受其他特征影响;氢键受体数的系数为正、TPSA 的系数为负,就不宜分别解读为它们各自的独立作用。
练习:把特征列与 w 的位置对应起来;读完第 0.3 节后,不看代码推导梯度,再重写训练循环并核对结果。
0.2.3 找出预测最不准的分子
如果只看一个平均分数,很难决定该补数据还是换模型。把验证残差较大的样本拿出来,连同结构、数据来源、实验记录一起检查。下面沿用第 0.2.1 节的预测,列出残差最大的五条验证记录。这里分析验证集,便于据此提出改进;测试集继续保留到最终评估。
python
error = prediction - ydev
worst = np.argsort(np.abs(error))[-5:][::-1]
for k in worst:
    sample_idx = dev_idx[k]
    print(dataset.ids[sample_idx].strip(),
          "实测", round(float(ydev[k]), 2),
          "预测", round(float(prediction[k]), 2),
"残差", round(float(error[k]), 2))实际运行输出:
text
c1ccc2c(c1)ccc3c4ccccc4ccc23 实测 -8.06 预测 -5.38 残差 2.68
CCNc1nc(Cl)nc(NCC)n1 实测 -4.55 预测 -2.05 残差 2.5
c1cc2ccc3ccc4ccc5cccc6c(c1)c2c3c4c56 实测 -9.02 预测 -6.67 残差 2.35
C1CCC2CCCCC2C1 实测 -5.19 预测 -3.35 残差 1.84
C1CCc2ccccc2C1 实测 -4.37 预测 -2.59 残差 1.78k 是验证子集内的行号,sample_idx 是原始数据中的行号;核查结构时要保持这个对应关系。strip() 去掉原始 CSV 中 SMILES 末尾的空格,只影响显示。
这五条记录的残差全部为正,表示模型都高估了溶解度。先把结构与预测结果对应起来:第 1、3 条是稠环芳烃 chrysene 和苯并[ghi]苝,第 2 条是西玛津(simazine),第 4、5 条是十氢萘和四氢萘。
可以先检查固态信息。前三个分子是熔点在 200 °C 以上的固体,溶解时需要考虑离开固态的代价;六个描述符主要描述单个分子,没有直接包含晶体堆积等固态信息。通用溶解度方程(GSE)在 logP 之外加入熔点项来描述这部分贡献 [7]。因此,一个可以检验的改进是:加入熔点或其他固态描述符,再看这类样本的验证误差是否减小。残差本身还不能证明具体是哪种固态因素造成了偏差。
十氢萘和四氢萘在室温下是液体,需要另找线索。例如,四氢萘的实测 logP 约为 3.5,而本章使用的 Crippen 估算值约为 2.6;十氢萘的估算值约为 3.4,也值得与实测记录对照。疏水性特征的偏差可能影响溶解度预测,具体解释仍需核查实测值的来源、条件及其他描述符的共同作用。
同样是高估溶解度,不同分子可能需要核查不同原因。误差分析的作用,是把“模型不够准”变成几个能够继续检查的问题。
更一般地,对 ESOL 可以问:错误是否集中在高分子量或某类骨架?极低溶解度样本是否更难?分子是否易电离?pH、盐型、温度与晶体形态是否影响结果,却没有出现在输入中?这些是需要核查的假设,不能因为残差大就直接认定原因。
对材料数据,可以检查结构是否充分弛豫、计算协议是否一致、实验温度是否遗漏、同一样品是否重复记录。残差大不意味着数据一定错误,不能为了提高分数直接删除困难样本。
在验证集上提出假设、核查数据并比较改进后,才固定规则进行最终测试。如果已经根据测试错误改进模型,就需要新的独立评估,或明确说明原测试集已参与研发。
我们还差一个问题没有回答:留出的分子与训练分子有多相似?这会决定当前评估能够支持什么样的应用。
0.2.4 未来遇到新骨架,结果还可靠吗
前面把相同结构放在同一组,避免了重复记录跨集合。但同一骨架的不同衍生物,仍可能分散在训练集和测试集。如果未来只预测熟悉结构的衍生物,这种评估可能合适;如果要寻找新的分子骨架,还需要另一种检查。
前面使用的随机分组划分,把相同结构放在一组后随机分配,适合评估来自类似总体的新记录;但若未来目标是全新分子骨架,仅报告随机划分容易过于乐观。同骨架衍生物分到训练和测试,并不在所有任务中都等于泄漏;关键是这种相似性是否符合预定应用。重复记录、同一测量的派生样本跨集合,以及利用测试目标做处理,则属于更直接的泄漏问题。
骨架划分把同一骨架组放入同一子集,检验未见骨架的表现。Bemis–Murcko 骨架主要保留环和连接环的链 [8],对无环分子可能给出空骨架;骨架不同也不保证分子完全不相似。因此它是一种有用的评估规则,并非完全隔离一切化学相似性的保证。
DeepChem 的 ScaffoldSplitter 先计算每个分子的骨架,把同骨架分子归为一组,再按组的大小从大到小依次放入训练集,训练集装满后再放验证集,最后剩下的组进入测试集。
这一规则影响了本次 ESOL 评估的含义。1,128 个分子共有 269 种骨架,其中 317 个无环分子共享“空骨架”,254 个分子的骨架是苯环。这两个最大的组都进入了训练集。测试集中 113 个分子的骨架,在整个数据集中则都只出现一次。因此,本次测试主要检查模型面对这些稀有、未见骨架时的表现。
ScaffoldSplitter 是确定性的:同一份数据、同样的比例总是得到同一划分,改变随机种子不会产生新的骨架划分。若需要多次骨架划分来估计结果的波动,可以随机打乱骨架组的顺序,或采用按骨架分组的交叉验证。本章使用其默认骨架定义,并保存索引以便复现。
材料任务可能需要按组成、结构原型、实验批次或时间留出;分子动力学(MD)轨迹还需注意相邻帧之间的相关性。划分规则应对应研究对象及未来预测的情境。
划分方式
分子数据集
随机划分 RMSE0.682
骨架划分 RMSE1.267
随机划分乐观程度×1.86
最近训练邻居同骨架0%测试 29 个
描述符空间与外推误差12 个骨架簇 · k 近邻回归
训练 测试
下面用相同的六个描述符和线性模型比较两种划分。每次都只从该划分的训练集计算均值、标准差并拟合模型。这里固定模型设置后报告测试结果,后面不会根据这些测试分数回头调参。
python
def report_linear_split(name, tr, dv, te):
    (Xa, Xv, Xt), _, _ = standardize(X[tr], X[dv], X[te])
    sw, sb = fit_linear(Xa, y[tr])
    pred = Xt @ sw + sb
    residual = pred - y[te]
    mae = np.abs(residual).mean()
    rmse = np.sqrt(np.mean(residual ** 2))
    r2 = 1 - np.sum(residual ** 2) / np.sum((y[te] - y[te].mean()) ** 2)
    print(f"{name}: {len(tr)}/{len(dv)}/{len(te)} 条,"
          f"测试 MAE={mae:.4f},RMSE={rmse:.4f},R²={r2:.4f}")


scaffold_idx = dc.splits.ScaffoldSplitter().split(
    dataset, frac_train=0.8, frac_valid=0.1, frac_test=0.1)
report_linear_split("按结构分组随机", train_idx, dev_idx, test_idx)
report_linear_split("骨架", *scaffold_idx)输出为:
text
按结构分组随机: 901/115/112 条,测试 MAE=0.8227,RMSE=1.0203,R²=0.7815
骨架: 902/113/113 条,测试 MAE=0.9445,RMSE=1.2110,R²=0.6736表 5 固定设置下,均值基线与线性回归在两种划分中的表现。MAE、RMSE 以 logS 单位报告;两种划分的训练集和测试集不同。
| 划分 | 模型 | 训练 MAE | 验证 MAE | 测试 MAE | 测试 RMSE | 测试 R² |
|---|---|---|---|---|---|---|
| 按结构分组随机 | 训练均值基线 | 1.6415 | 1.6911 | 1.7726 | 2.1864 | -0.0033 |
| 按结构分组随机 | 线性回归 | 0.7793 | 0.6970 | 0.8227 | 1.0203 | 0.7815 |
| 骨架 | 训练均值基线 | 1.6416 | 1.6358 | 1.7759 | 2.3150 | -0.1928 |
| 骨架 | 线性回归 | 0.7229 | 1.0297 | 0.9445 | 1.2110 | 0.6736 |
两种划分下,线性模型都明显优于均值基线。从随机分组换到骨架划分,测试 MAE 从约 0.82 升到约 0.94,说明在本次设置下,预测这些未见骨架更困难。一个模型的分数总是连着评估情境,报告时需要把两者一起说明。
骨架划分中,验证 MAE(1.03)比测试 MAE(0.94)更高,也不必立刻解释成模型出了问题。两个子集各约 113 个分子,而且按骨架组分配,化学组成和难易程度可能不同。若要形成更一般的结论,需要合适的重复划分或交叉验证,并报告结果的波动。
到这里,我们已经走完一次基本建模:结构转成数据表,留出评估样本,拟合简单模型,再结合平均误差、具体分子和划分方式解释结果。接下来回到训练代码,看看权重究竟是怎样一步步学出来的。
0.3 参数是怎样一步步学出来的
0.3.1 梯度下降:往哪里改,每次改多少
第 0.2.1 节的代码每次先计算残差,再用 grad_w 和 grad_b 改变参数。为什么按这个方向改?
以一个权重 为例:如果把它稍微增大,损失也随之增大,就应该尝试把它减小。导数描述的正是这种变化关系。多个参数对应多个导数,把它们放在一起就是梯度。梯度下降沿负梯度调整参数:
是已经更新的步数, 是学习率。梯度给出当前位置的变化方向,学习率控制每次调整的幅度;步长足够小时,沿负梯度可以减小损失。
先看一个只有斜率的例子:、、模型 ,取 。从 开始,残差为 -3,梯度是 。若 ,新权重为 ;预测从 0 变成 1.2,损失从 4.5 降到 1.62。
学习率若过大,可能跨过最低点并反复振荡;过小,则需要很多步。损失不下降时,要分别检查梯度是否正确、步长是否合适,而不是一概认为模型太简单。
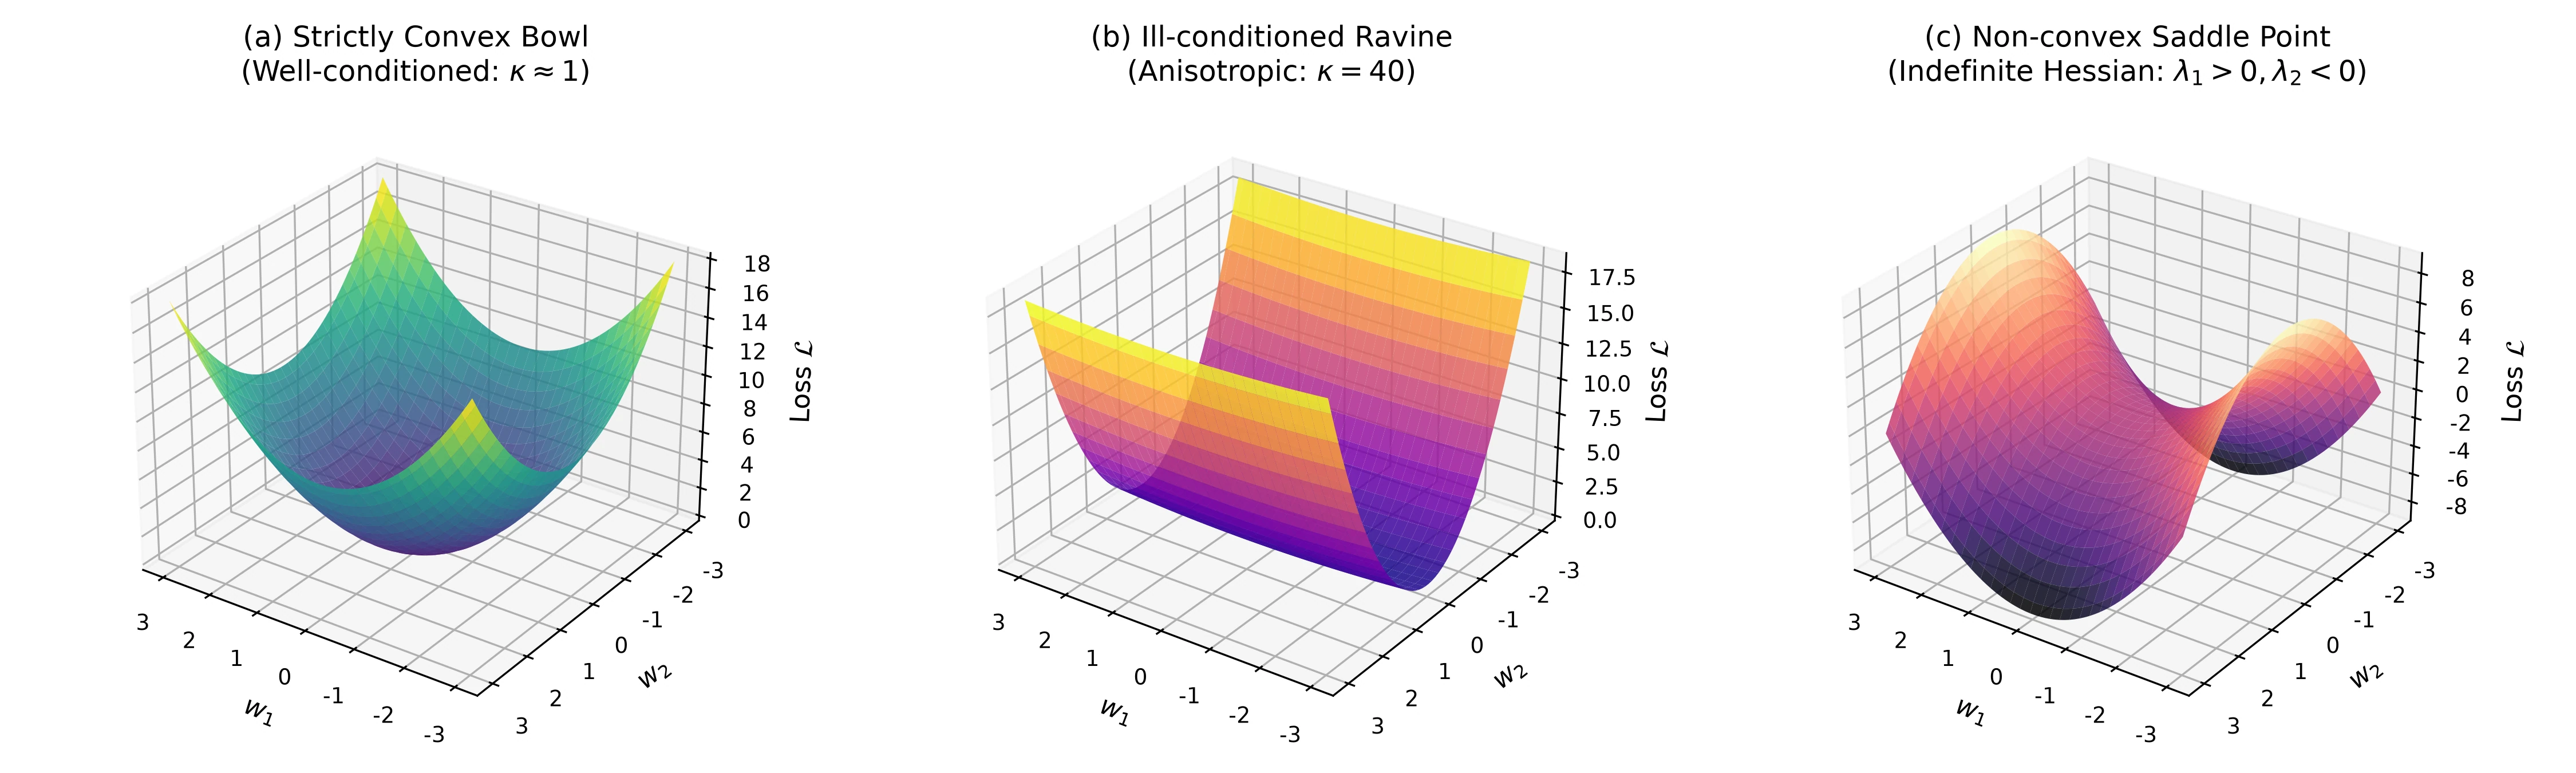
损失函数的“地形”决定了梯度下降好不好走。图 4 画出了三种典型地形,后面讨论特征缩放、动量和自适应学习率时都会回到它们。
第二轮推导:线性回归的梯度与条件数
本章训练代码采用 ,即 MSE 的一半。乘上常数不改变最优参数,但会改变同一学习率下的更新大小。令 ,则:
对 的 Hessian 为 。正定二次函数中, 大,意味着不同方向曲率相差大:沿陡方向需要小步,沿缓方向又希望大步。共线导致 奇异时,最小特征值为零,应分别讨论非零子空间与不可辨识方向。
对标准正定二次目标,固定步长梯度下降在 时收敛。这个结论不应不加条件地套到一般非凸网络。一般 Hessian 可能有负特征值;单纯用最大与最小特征值之比描述它容易误导。
0.3.2 为什么先把输入缩放到相近尺度
回看第 0.2.1 节,训练前先标准化了六列输入。这一步与学习率有关:分子量可能是几百,氢键供体数通常只有几个。相同幅度的权重变化,对两列输入产生的预测变化可能相差很大,优化时就容易出现某些方向太陡、另一些方向太平的情况。
把各列缩放到相近尺度,可以缓解这类困难,也让后面讨论的权重惩罚更容易比较。
常用的 Z-score 标准化是:
和 分别是训练集第 列的均值和标准差。新分子也要使用这组值。一个特征的值为 300,训练均值为 200、标准差为 50,则变换后为 2,表示它比训练均值高两个标准差。
零方差列需要单独处理,不能直接除以零。第 0.2 节代码把这类列的除数设为 1;还可以在明确记录规则后删除常数特征。Min-Max 缩放也是常见方法,但它并不等于“零均值、单位方差”。
标准化通常能改善尺度悬殊带来的优化困难,不会自动消除特征相关性。两列高度共线,标准化后仍可能共线;损失等高线不保证变成圆形,条件数也不保证趋近于 1。它同样不是所有模型的强制步骤,树模型通常不像梯度线性模型那样依赖这一处理。
回到 ESOL:缩放是为了帮助拟合,不会新增化学信息。模型若缺少 pH 或晶体形态等相关因素,标准化不能补回这些因素。
输入尺度处理好后,还可以决定每次更新到底使用多少条训练记录。
0.3.3 每次更新需要看多少样本
前面的线性模型每次用全部 901 条训练记录计算梯度,再更新一次参数,称为全批量梯度下降。数据量大时,也可以每次只取一部分样本。这改变了梯度的估计方式,表 6 比较了三种做法。
表 6 按一次参数更新所用样本数区分的三种梯度下降方式。 为训练样本总数, 为批大小()。
| 方法 | 一次更新使用的数据 | 主要特点 |
|---|---|---|
| 全批量 | 全部 个训练样本 | 对固定训练目标给出确定梯度;单步计算量较大 |
| 单样本 SGD | 随机一个样本 | 单步轻,但更新波动大 |
| 小批量 | 随机 个样本 | 在计算效率与梯度波动间折中 |
实际软件中“SGD”也常指使用小批量的优化器。读文献时应同时看优化规则与批大小。
遍历一次训练集通常称为一个 epoch。以本章随机分组得到的 901 条训练记录为例,每批 64 条、不丢弃末批时,一个 epoch 包含 15 次更新。
每批样本越少,单次更新通常越轻,但抽到的分子不同,梯度也更容易波动。批大小需要同时考虑计算速度、内存和验证表现。
第二轮理解:批大小、梯度波动与泛化
独立随机采样时,小批量平均梯度的方差约与 成正比,即批越大,梯度估计越稳定;无放回采样还涉及有限总体修正。批大小可以取内存允许的整数,运行效率则取决于模型、数组形状、硬件与实现。批大小还可能影响最终解的泛化:有研究报告,很大的批量更容易收敛到“尖锐”的极小点,泛化略差 [9],但这一现象与学习率等设置相互作用,并非定论。实际选择时,应同时测量速度和验证表现。
0.3.4 动量:把最近几步的方向一起考虑
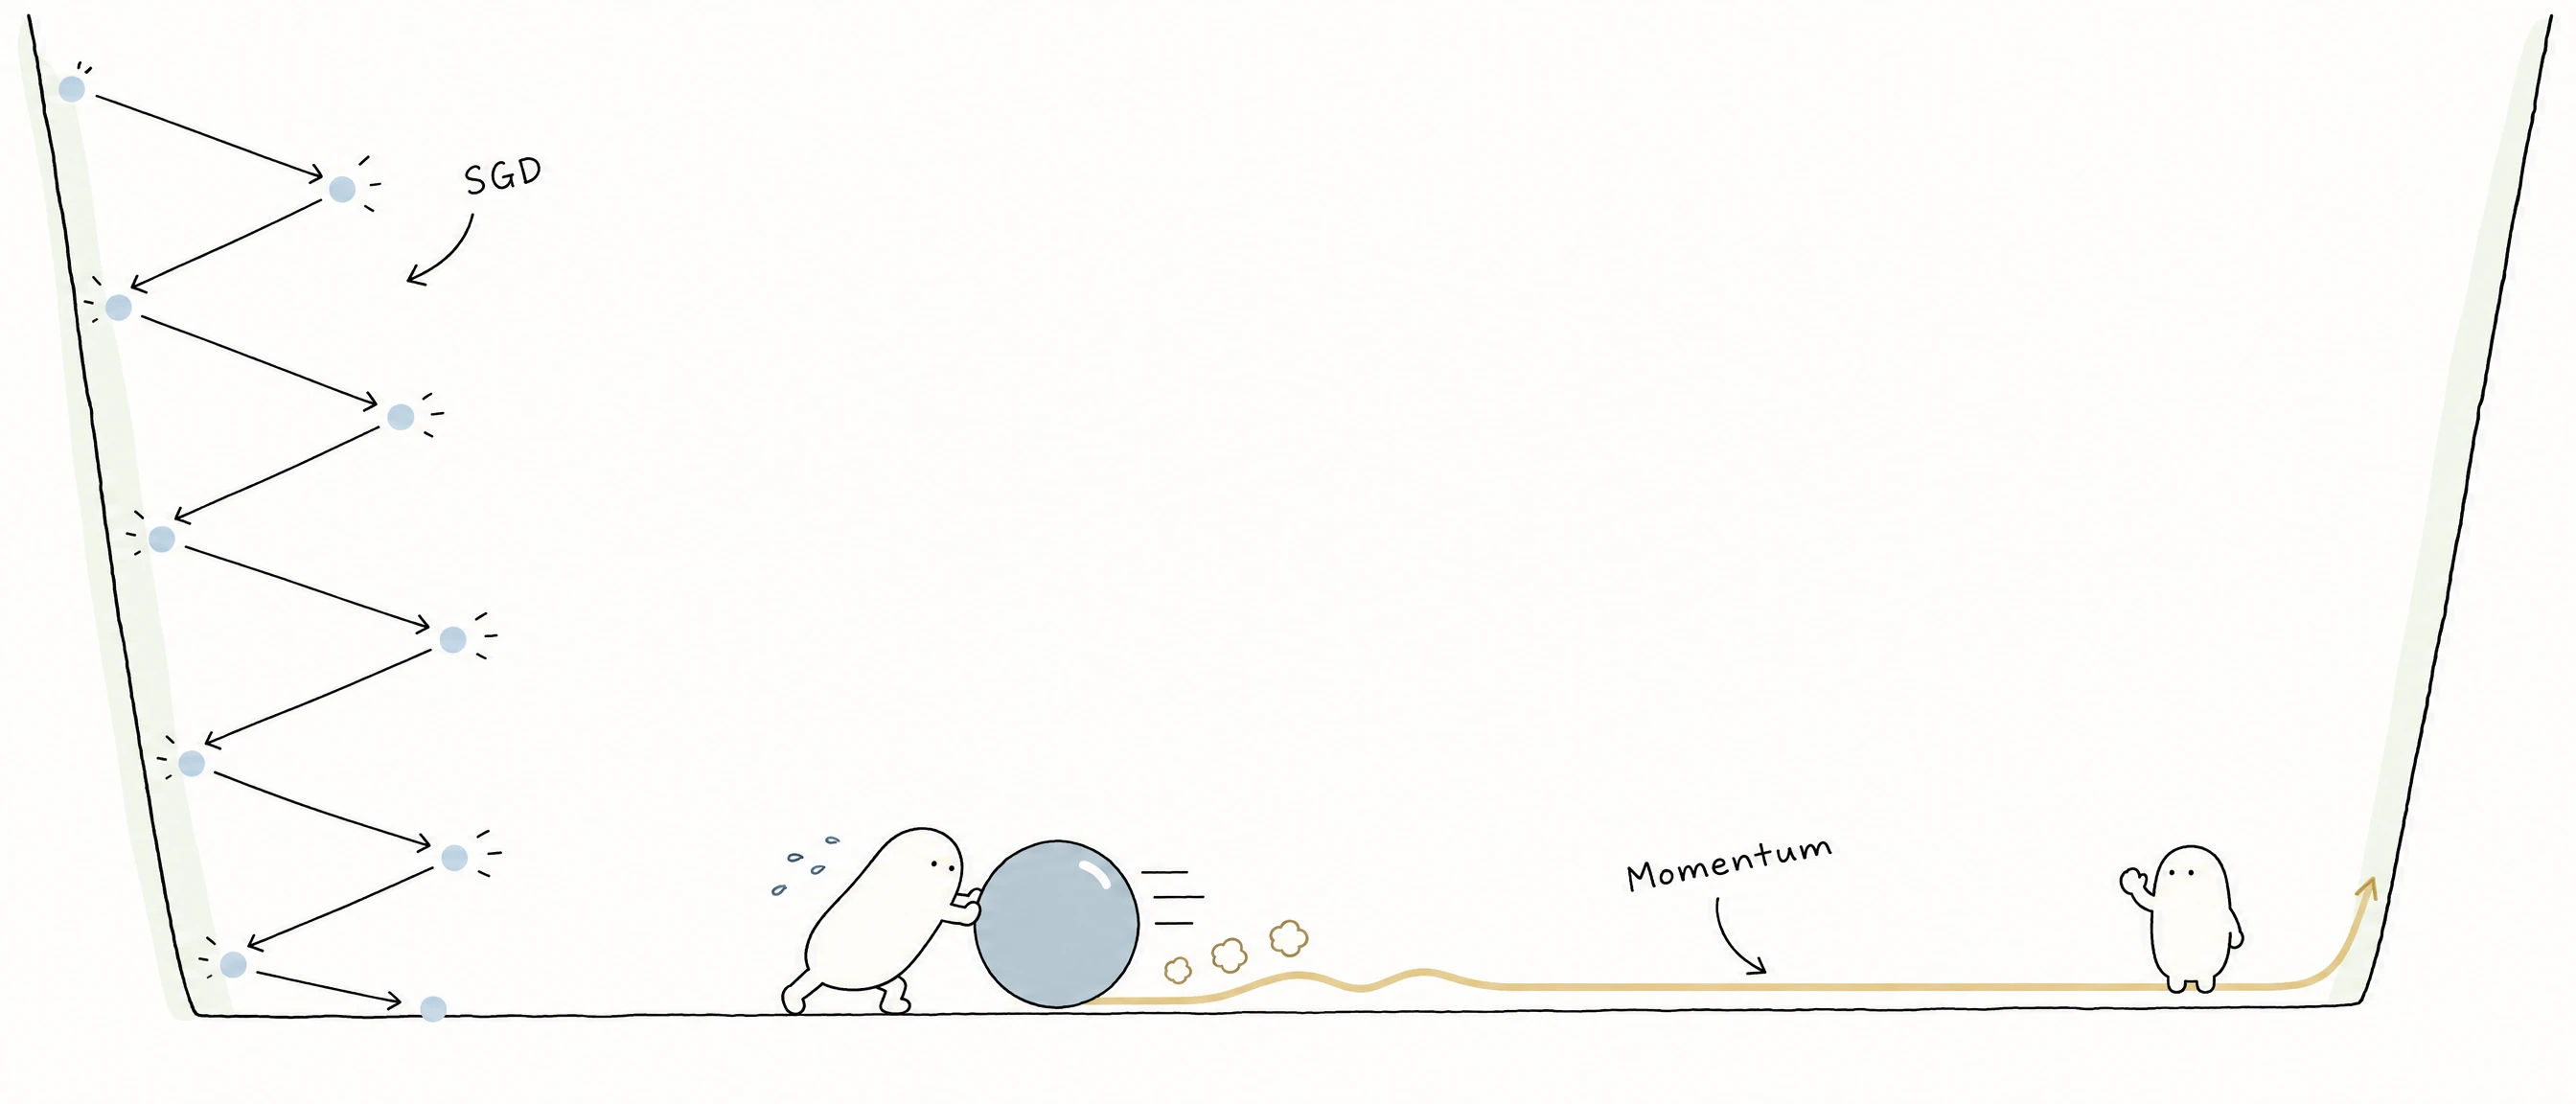
即使输入经过缩放,损失曲面仍可能存在狭长谷地。只跟随当前梯度时,参数可能在谷壁之间来回调整,沿谷底却走得很慢。动量法保留最近几步的方向,让持续一致的方向得到保留,让正负交替的摆动减弱:
是当前梯度, 是平滑后的方向。若最近几步方向相似,平均会持续保留这个方向;若正负交替,平均会减弱摆动。物理上可以把它想象成一个在阻尼介质中滚动的重球:惯性使它沿一致的方向越滚越顺,阻尼又抑制来回摆动,如图 5 所示。
第二轮理解:动量保留了多少步历史
展开递推,初值为零时:
当 ,常用 估计其历史时间尺度。另一些实现使用 ,没有 ;比较代码与学习率时要先核对约定。
在同一二次损失面上,从同一起点比较普通梯度下降和动量法。
等损失 0.08等损失 0.5等损失 2等损失 4.5普通梯度下降动量法当前位置
当前损失
第 0 次更新,L=8.75。
思考与说明
思考动量越大一定越好吗?观察轨迹是否越过谷底。
L=(x²+6y²)/2;动量约定 v←βv+∇L,θ←θ−ηv。
0.3.5 RMSprop、Adam 和 AdamW 各自增加了什么
损失面
优化器
SGD 8.3e-7收敛 @101
动量 3.9e-9收敛 @68
RMSprop 8.7e-4收敛 @104
Adam 5.8e-9收敛 @44
参数轨迹与损失下降
○ 起点 ★ 极小值 灰度越深损失越大
动量利用了最近的方向,但不同参数仍可能具有不同的梯度尺度。RMSprop、Adam 和 AdamW 在此基础上进一步处理更新:
- RMSprop 记录每个参数最近的梯度平方,用它分别缩放各参数的步长 [10]。
- Adam 同时记录梯度的平均方向与平方平均,并修正零初值造成的早期偏小 [11]。
- AdamW 在 Adam 的更新之外,单独把权重适度拉向零,处理权重衰减 [12]。
第一次阅读先区分它们在记录什么。公式中的“梯度平方”不是二阶导数;这些方法也仍然需要选择学习率。权重衰减与正则化的关系在第 0.4 节展开。
第二轮推导:RMSprop、Adam 与 AdamW 的更新公式
动量解决了方向波动的一部分问题,但所有参数仍共用一个学习率。RMSprop [10] 换了一个思路:为每个坐标分别记录梯度平方的指数平均,用它来缩放该坐标的步长:
平方、开方与除法都是逐元素操作。梯度尺度长期较大的坐标,分母也较大,更新会被缩小; 用来避免除以过小的数。它是一种自适应缩放,不是精确计算 Hessian。
Adam 同时记录一阶平均 与平方平均 ,并修正零初值造成的早期偏小 [11]:
这里的“二阶矩”是梯度平方的平均,不是二阶导数。AdamW 将权重衰减与上述自适应梯度更新分开 [12]:
在 Adam 中,把 L2 惩罚直接加进梯度,与这种独立衰减一般不等价。第 0.4 节再解释正则化的作用。
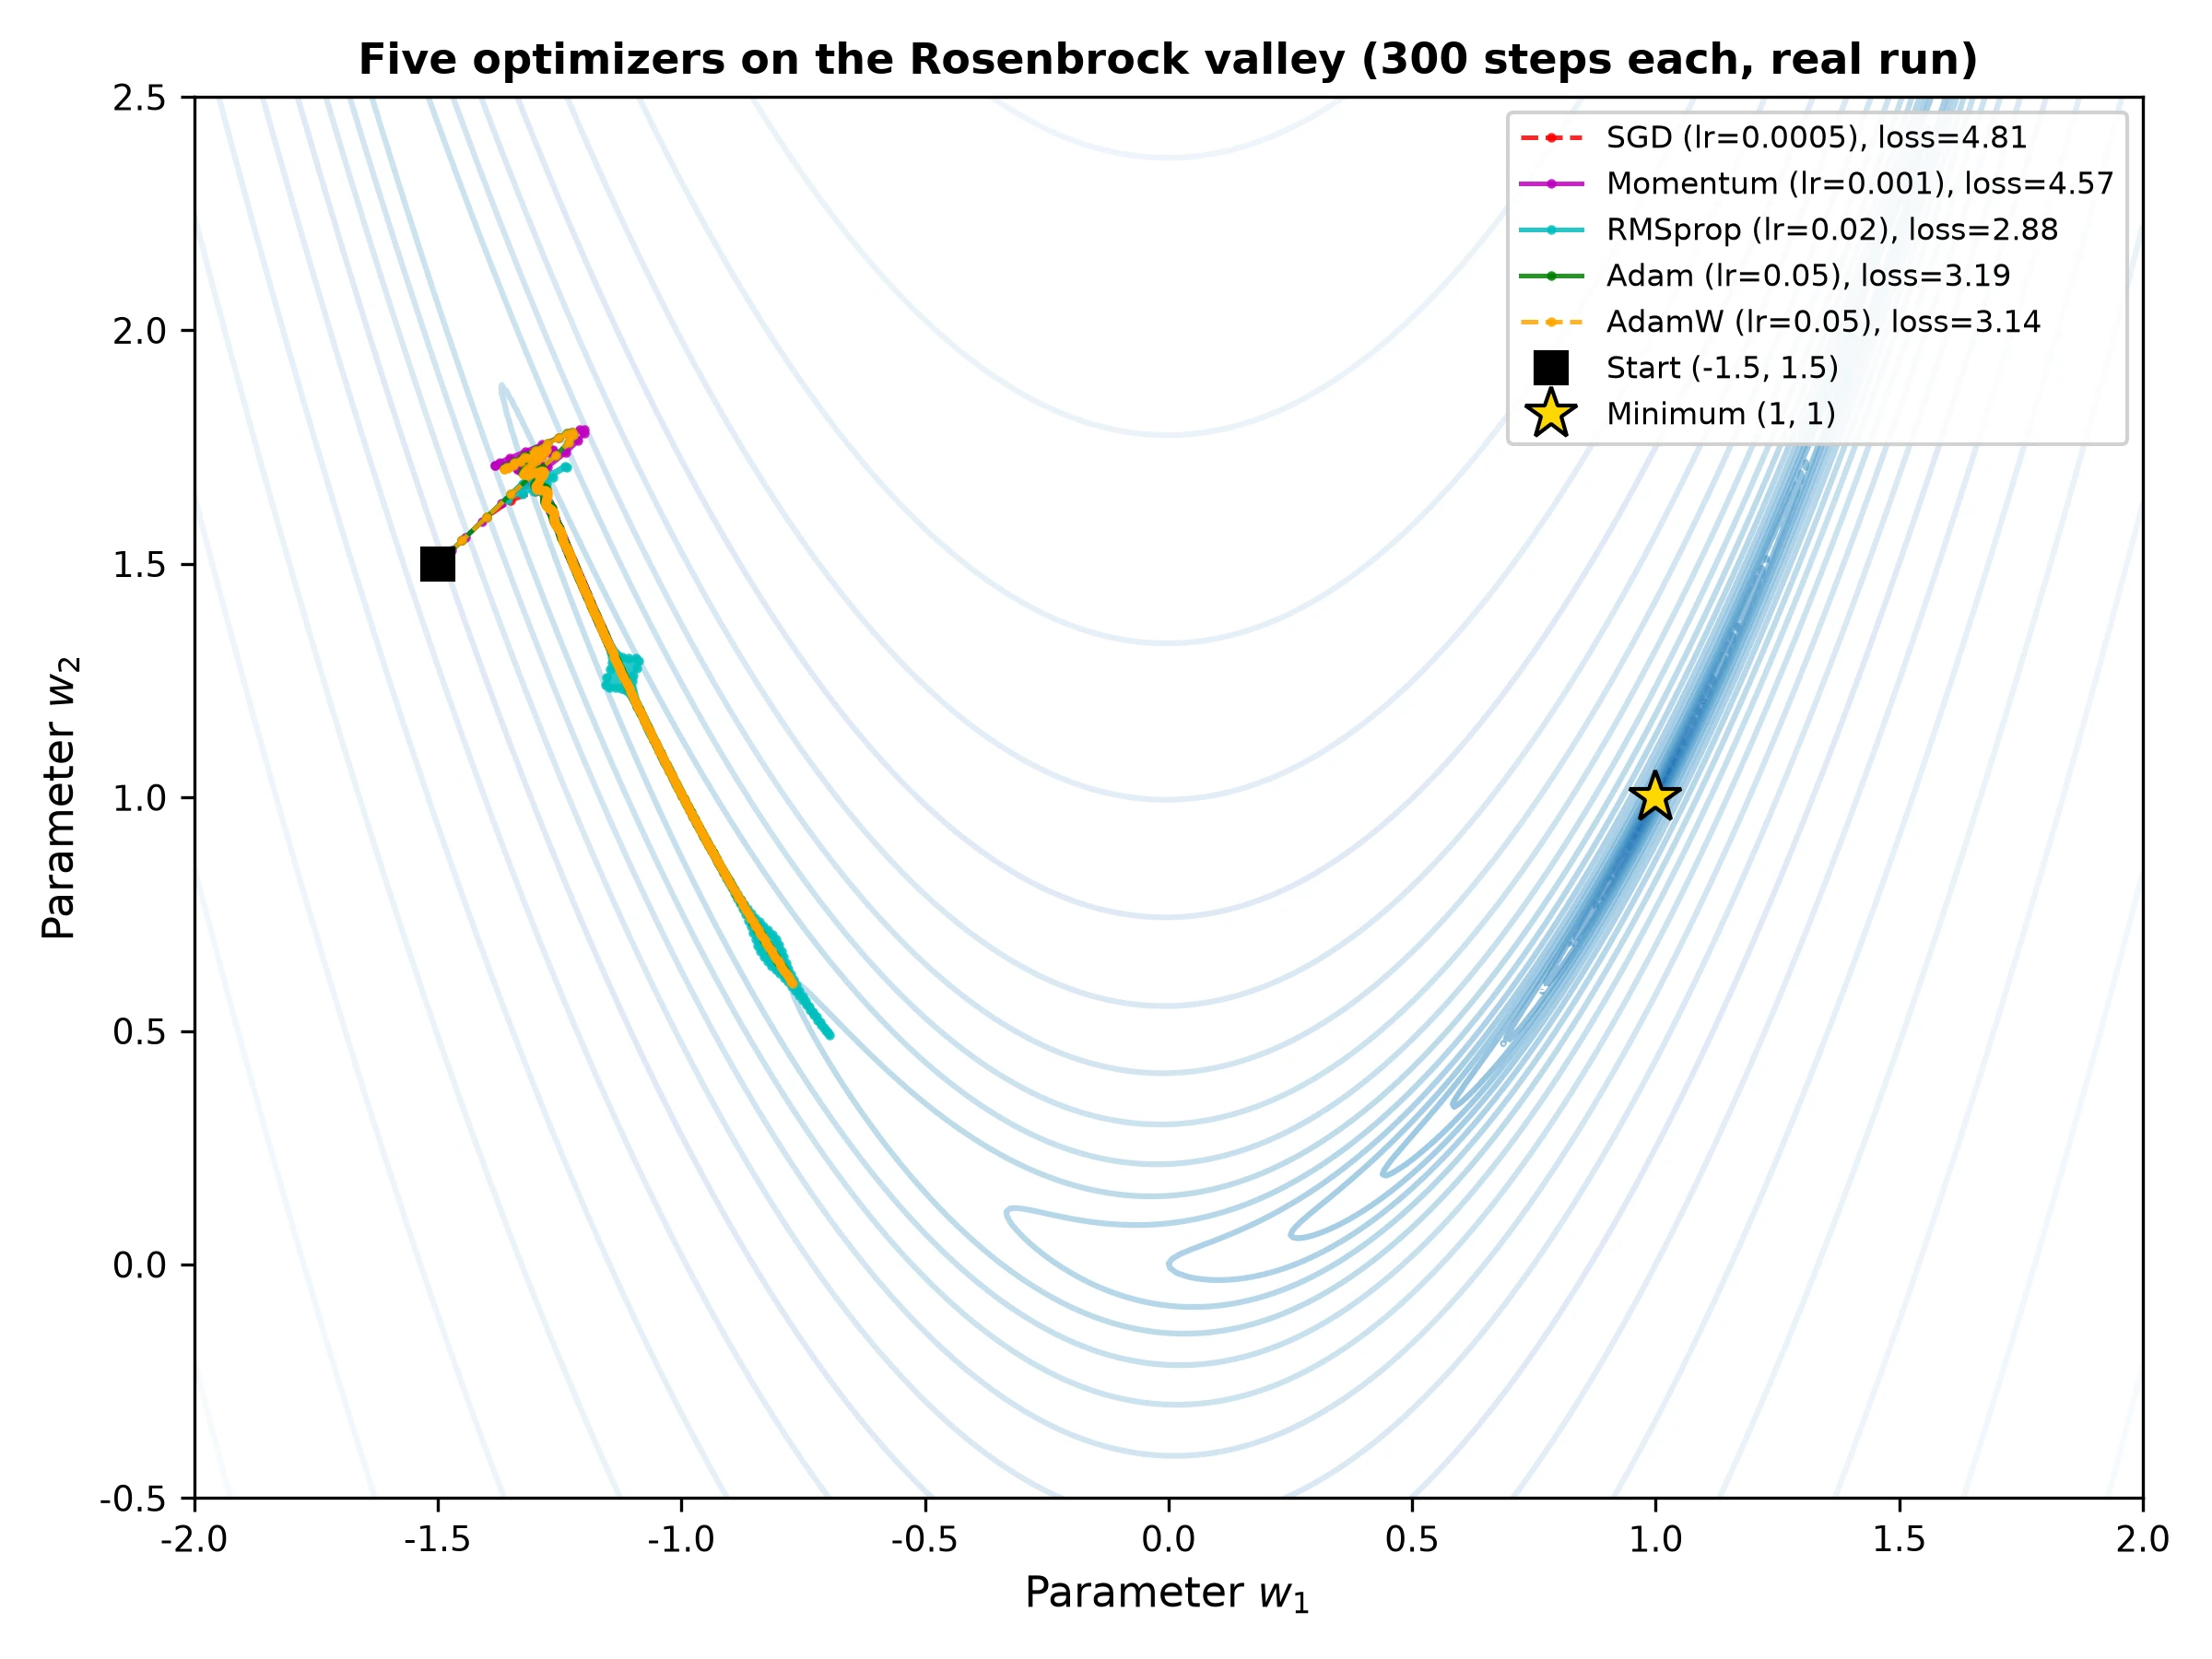
为了单独观察优化器的更新行为,下面使用只有两个参数的 Rosenbrock 函数 。它有一条弯曲的狭长谷地,最小点在 ,是检验优化器的经典难题。这里 表示待优化参数,而不是数据中的特征和标签。下面的代码从 出发,用五种优化器各更新 300 步,图 6 画出了它们的轨迹。
第二轮实验:手写五种优化器,保存每一步的位置
python
import numpy as np

def rosenbrock(p, a=1.0, b=100.0):
    return (a - p[0]) ** 2 + b * (p[1] - p[0] ** 2) ** 2

def rosenbrock_grad(p, a=1.0, b=100.0):
    return np.array([-2 * (a - p[0]) - 4 * b * p[0] * (p[1] - p[0] ** 2),
                     2 * b * (p[1] - p[0] ** 2)])

def optimize(name, lr, start=(-1.5, 1.5), steps=300, beta=0.9, beta2=0.999, wd=0.0, eps=1e-8):
    """在 Rosenbrock 峡谷上运行一种优化器,返回整条轨迹(steps+1 个点)。"""
    p = np.array(start, dtype=float)
    v = np.zeros(2); s = np.zeros(2)                         # 梯度平均、梯度平方平均
    traj = [p.copy()]
    for t in range(1, steps + 1):
        g = np.clip(rosenbrock_grad(p), -100.0, 100.0)       # 梯度裁剪,防止溢出
        if name == "sgd":
            p = p - lr * g
        elif name == "momentum":
            v = beta * v + (1 - beta) * g
            p = p - lr * v
        elif name == "rmsprop":
            s = 0.99 * s + 0.01 * g ** 2                      # 记录各坐标梯度的平方均值
            p = p - lr * g / (np.sqrt(s) + eps)
        else:                                                 # adam / adamw
            v = beta * v + (1 - beta) * g
            s = beta2 * s + (1 - beta2) * g ** 2
            vh, sh = v / (1 - beta ** t), s / (1 - beta2 ** t)  # 偏差校正
            p = p - lr * wd * p - lr * vh / (np.sqrt(sh) + eps)  # wd>0 即 AdamW:衰减项不进入动量
        traj.append(p.copy())
    return np.array(traj)

settings = {"SGD": ("sgd", 5e-4, {}), "Momentum": ("momentum", 1e-3, {}), "RMSprop": ("rmsprop", 0.02, {}),
            "Adam": ("adam", 0.05, {}), "AdamW": ("adamw", 0.05, {"wd": 1e-3})}
for label, (name, lr, kw) in settings.items():
    tr = optimize(name, lr, **kw)
    print(f"{label:9s} lr={lr:<7} 300 步后位置 {np.round(tr[-1], 3)}, 损失 {rosenbrock(tr[-1]):.4f}")
print("全局极小点 (1, 1),损失 0;起点损失", round(rosenbrock(np.array([-1.5, 1.5])), 2))读代码时,p 是两个参数;g 是当前梯度;v、s 与参数同形状,分别记录方向平均和平方平均。traj 保存每一步的位置。np.clip 会改变过大的梯度分量,是本实验的数值保护措施。RMSprop 分支的平方平均系数固定为 0.99,Adam 分支则使用参数 beta2。
实际运行输出:
text
SGD       lr=0.0005  300 步后位置 [-1.193  1.43 ], 损失 4.8139
Momentum  lr=0.001   300 步后位置 [-1.136  1.298], 损失 4.5685
RMSprop   lr=0.02    300 步后位置 [-0.696  0.491], 损失 2.8807
Adam      lr=0.05    300 步后位置 [-0.786  0.624], 损失 3.1929
AdamW     lr=0.05    300 步后位置 [-0.771  0.601], 损失 3.1403
全局极小点 (1, 1),损失 0;起点损失 62.5对照输出与图 6:起点损失为 62.5,300 步后五种方法都把损失降到了 5 以下,但没有一种到达最低点 ,所有位置仍停在谷地左段()。
困难在于,垂直谷底的方向很陡,步长需要足够小,才不容易在谷壁间振荡;沿谷底的方向却很平,小步又使前进缓慢。本次 SGD 和 Momentum 使用 量级的学习率,沿谷底推进较少。RMSprop、Adam 和 AdamW 分别缩放各坐标的步长,在这组设置下走得更远,损失降到约 3。
AdamW 与 Adam 的差别来自权重衰减,在这个二维问题中影响较小。增加步数或重新调节学习率,排序都可能改变。因此,这个实验主要帮助观察更新方式,不能据此判断真实分子任务该选哪个优化器。
第一轮练习:只改步长,观察是否更快下降或开始振荡。第二轮练习:从递推式重写每个分支,并解释为什么 Adam 的偏差修正需要步数 。在真实数据上比较优化器,应给各方法合理的调参预算,并看验证结果。
0.3.6 训练前后可以采用不同步长
训练前期可能需要较大的调整,后期则希望在已找到的区域精细更新。学习率调度就是让 随训练进程改变。图 7 比较了四种常见的调度方式。
调度策略
峰值 ηλ1.43处于稳定区
当前损失4.1e-3t = 400
最低损失4.1e-3@ 399
预热步数40共 400 步
学习率曲线与训练损失早期曲率 λ 较大,稳定界较低
当前策略 其他策略
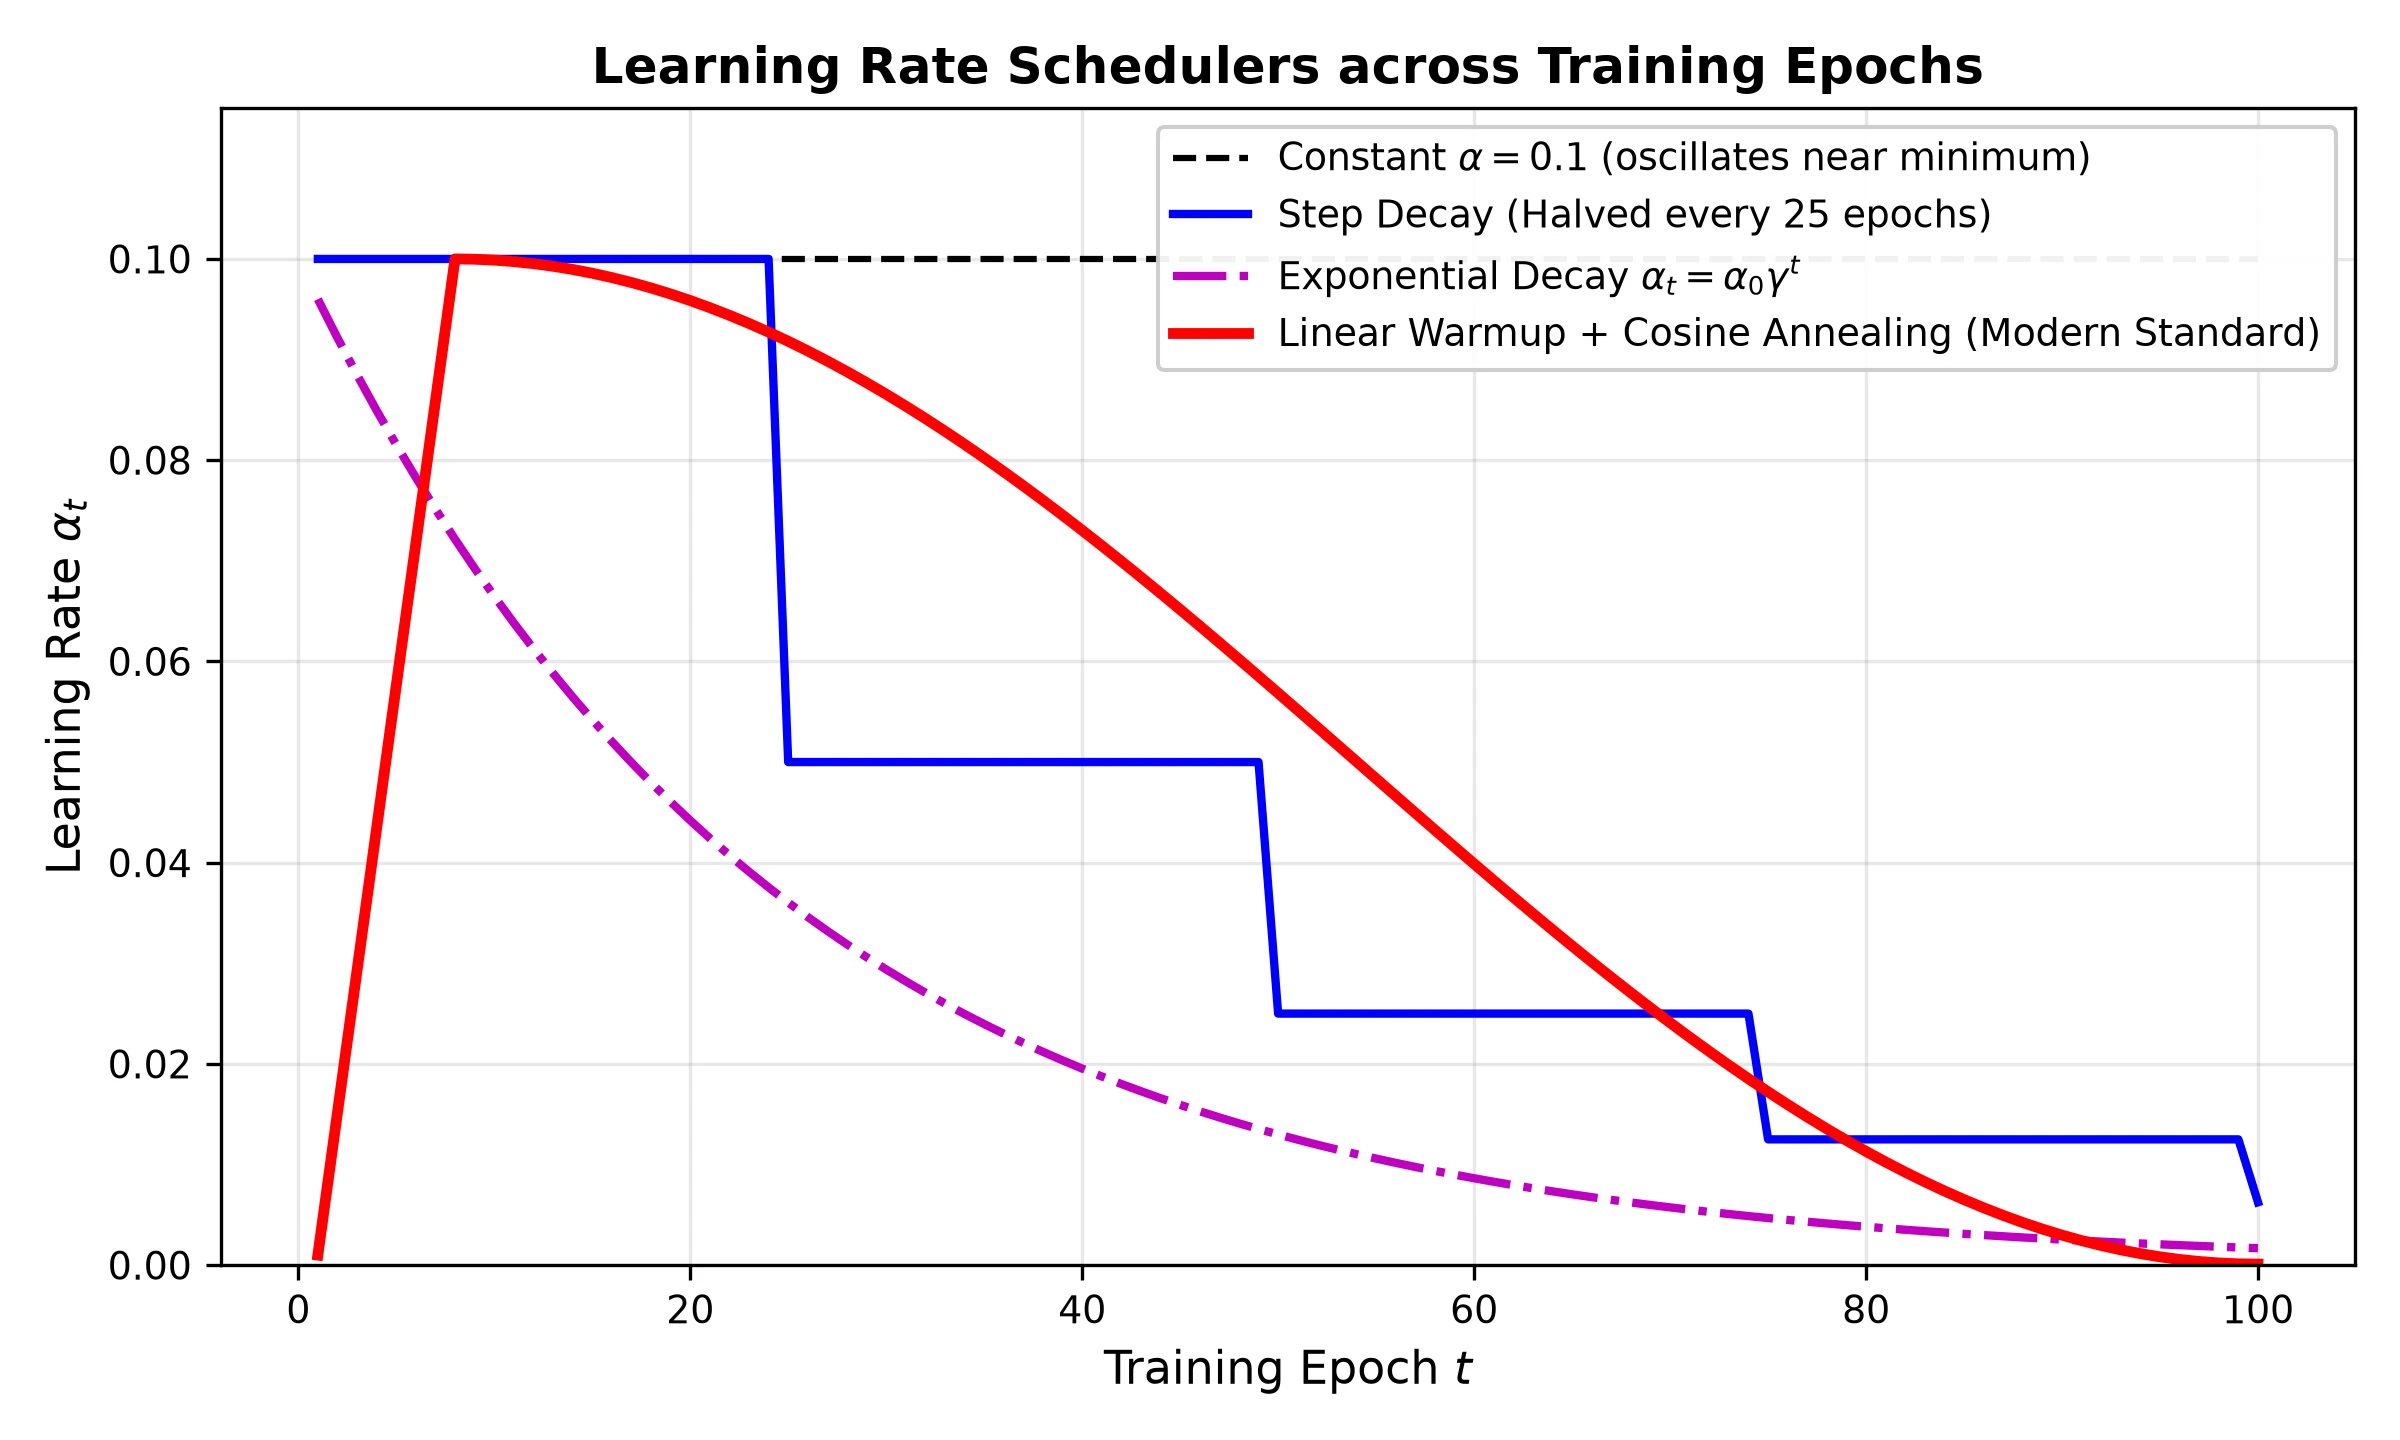
预热从较小学习率逐渐升到目标值,常用于降低训练初期的不稳定;余弦衰减随后平滑降低步长:
是衰减阶段的长度,式(20)中的 从该阶段开始时计数。预热是否有帮助,需要结合训练表现判断;本章的小型线性基线使用固定学习率即可训练。
0.3.7 怎样用验证集选择超参数
权重是训练得到的参数;学习率、正则强度、隐藏宽度等是我们设定的超参数。通常用验证集选择它们,测试集不参与选择。
如果同时给六个超参数各取五个值,网格共有 种组合。算力有限时,先缩小问题:保持大部分设置不变,优先检查学习率、正则强度和明显影响容量的参数。
对于跨数量级的学习率或正则强度,可以在对数尺度上取值。例如:
python
rng = np.random.default_rng(42)
learning_rates = 10 ** rng.uniform(-4, -1, size=20)这会在 至 的各数量级分配相近的采样机会。它不意味着这个区间对所有模型合适,应根据损失与验证表现调整。
随机搜索在只有少数超参数很重要时,往往比同样预算的粗网格探索更多不同值 [13]。网格搜索适合参数较少或候选集合较小的情况。可以先粗略探索,再围绕较好的范围细化;也可以根据已有试验结果选择下一组设置,例如使用贝叶斯优化。
动量系数接近 1 时,可以对 做对数采样,因为其历史时间尺度约为 。但初学阶段不需要同时搜索所有 Adam 参数。
现在可以解释前面线性模型的训练过程了:先缩放输入,用梯度确定调整方向,再用学习率控制幅度。如果训练损失能下降,验证表现却不好,就需要把注意力从“怎样拟合”转到“拟合到了什么”。
0.4 训练得好,为什么新样本仍可能预测不好
0.4.1 先分清训练问题与过拟合
训练损失、验证误差和新结构上的表现,提供的是不同线索。遇到问题时,先把观察到的现象说清楚,再决定要检查数据、训练还是模型。表 7 给出一个排查起点;其中的筛选指标在第 0.5 节解释。
表 7 按观察到的现象排查问题。每一行给出最值得先核查的原因和可以尝试的行动,并非唯一可能。
| 观察到的现象 | 优先核查 | 可以尝试的行动 |
|---|---|---|
| 训练和验证都差 | 特征、标签、代码、优化是否完成 | 先改善数据与训练,再比较更强模型 |
| 训练很好、同分布验证差 | 样本量、过拟合、重复样本 | 合理正则化、增加独立数据、检查划分 |
| 随机划分好,新结构族差 | 未来样本是否离开已有化学空间 | 按结构族评估,补充相关数据 |
| 训练不稳定或出现 NaN | 数据有限性、步长、除法与对数 | 找第一次异常,核对梯度与数值尺度 |
| ROC-AUC 高但筛选命中少 | 阳性比例、实际决策阈值 | 检查 Precision、Recall 与前 K 个候选 |
这是一张排查表,不是根据一个现象就能确定原因的诊断证明。比如验证误差大,既可能是过拟合,也可能是训练与验证分布不同。
假设线性模型在训练和验证集上的误差都较大,可能是关系太复杂、特征不足,也可能是优化尚未完成或标签噪声较大。若更灵活的模型训练误差很小,验证误差却明显增大,则需要检查它是否记住了训练样本的特有变化。
欠拟合指模型没有充分捕捉需要学习的关系;过拟合指模型过度适应当前训练样本,泛化表现较差。它们是诊断方向,不能只看一个分数就确定原因。
训练误差低、验证误差高时,可以尝试限制模型对当前样本的适应程度。下一节介绍一种做法:在拟合误差之外,给过大的权重增加代价。
第二轮理解:偏差、方差和模型容量
Bias²0.007
Variance0.036
期望测试误差0.106最优 d=3
训练误差0.052
30 组重采样数据上的拟合灰线为其他数据集的拟合
真实函数 当前拟合 平均拟合
图 8 是讨论这两种情况时最常用的示意图。
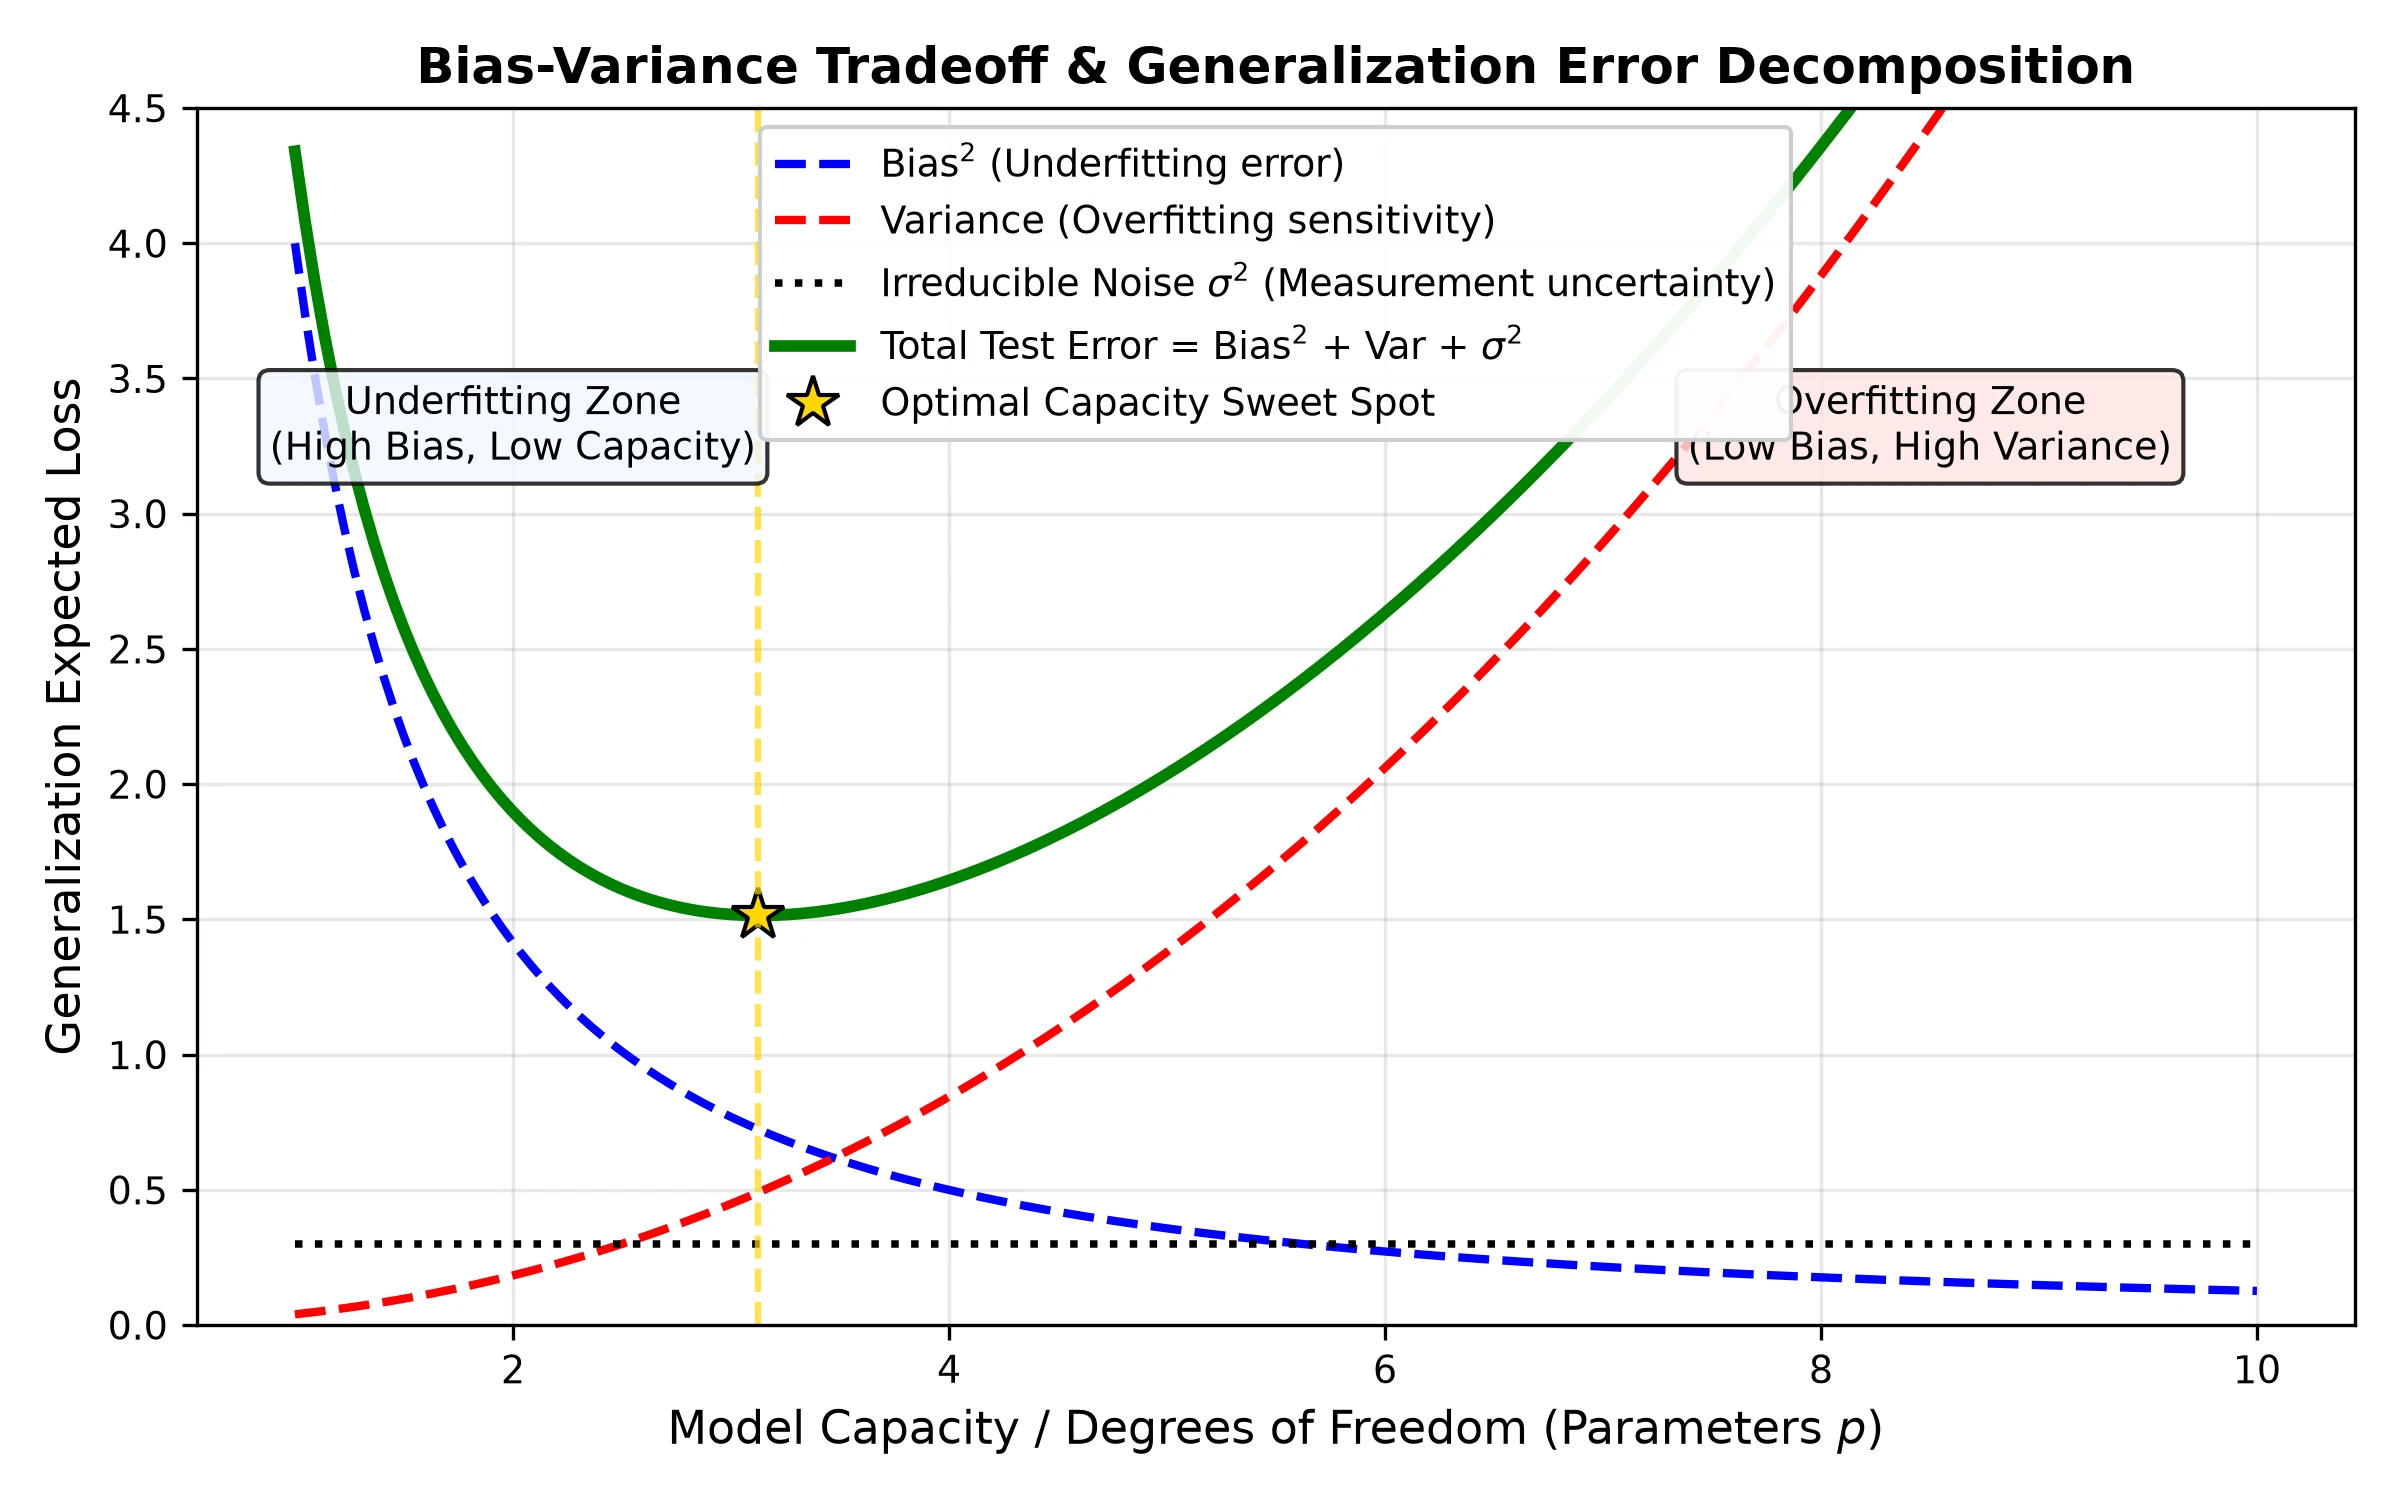
“偏差”衡量模型在多次重新采样训练后,平均预测与目标函数的系统差异;“方差”衡量这些不同训练结果之间的波动。它们与单次划分的训练、验证误差差值有关,但不是同一个定义。
模型容量是模型表达不同关系的能力。增加容量可能减少偏差,也可能增加对有限样本的敏感性。有些模型的测试误差会随容量增加先下降、再上升、随后再次下降,这称为“双重下降”[14]。因此,参数数量与泛化误差的关系仍需在具体任务上验证。
平方误差的分解。
设 ,,,训练数据 决定模型 。在相应独立性条件下,对固定 :
期望包含重新采样训练数据带来的随机性;不可约噪声相对于当前输入信息与任务定义而言。补充实验条件或更好的特征,有时可以减少原先表现为“不可预测”的变化。模型拟合密度泛函理论(DFT)的计算标签,与预测真实实验性质,也是不同目标。
推导练习:在 中加减 ,展开平方,说明各交叉项为什么在假设下为零。
对于复杂势能面等任务,模型可能需要较强的表达能力。可以先建立简单基线,再分别比较增加容量、补充特征和加入物理假设带来的变化。
0.4.2 L1 与 L2:给过大的权重增加代价
如果几个相关描述符可以互相补偿,模型可能用一组较大的正负系数完成拟合,换一批数据后系数却明显变化。正则化给参数增加限制,让训练同时考虑拟合误差和参数大小。本节采用:
控制约束强度,截距通常不惩罚。特征尺度会影响惩罚效果,所以比较线性模型的系数前,先明确输入处理。
**L2(Ridge)**取 ,倾向于把系数整体缩小,常有助于处理相关特征 [15];**L1(Lasso)**取 ,能使部分系数恰好为零 [16]。图 9 用两个系数说明这种差别。
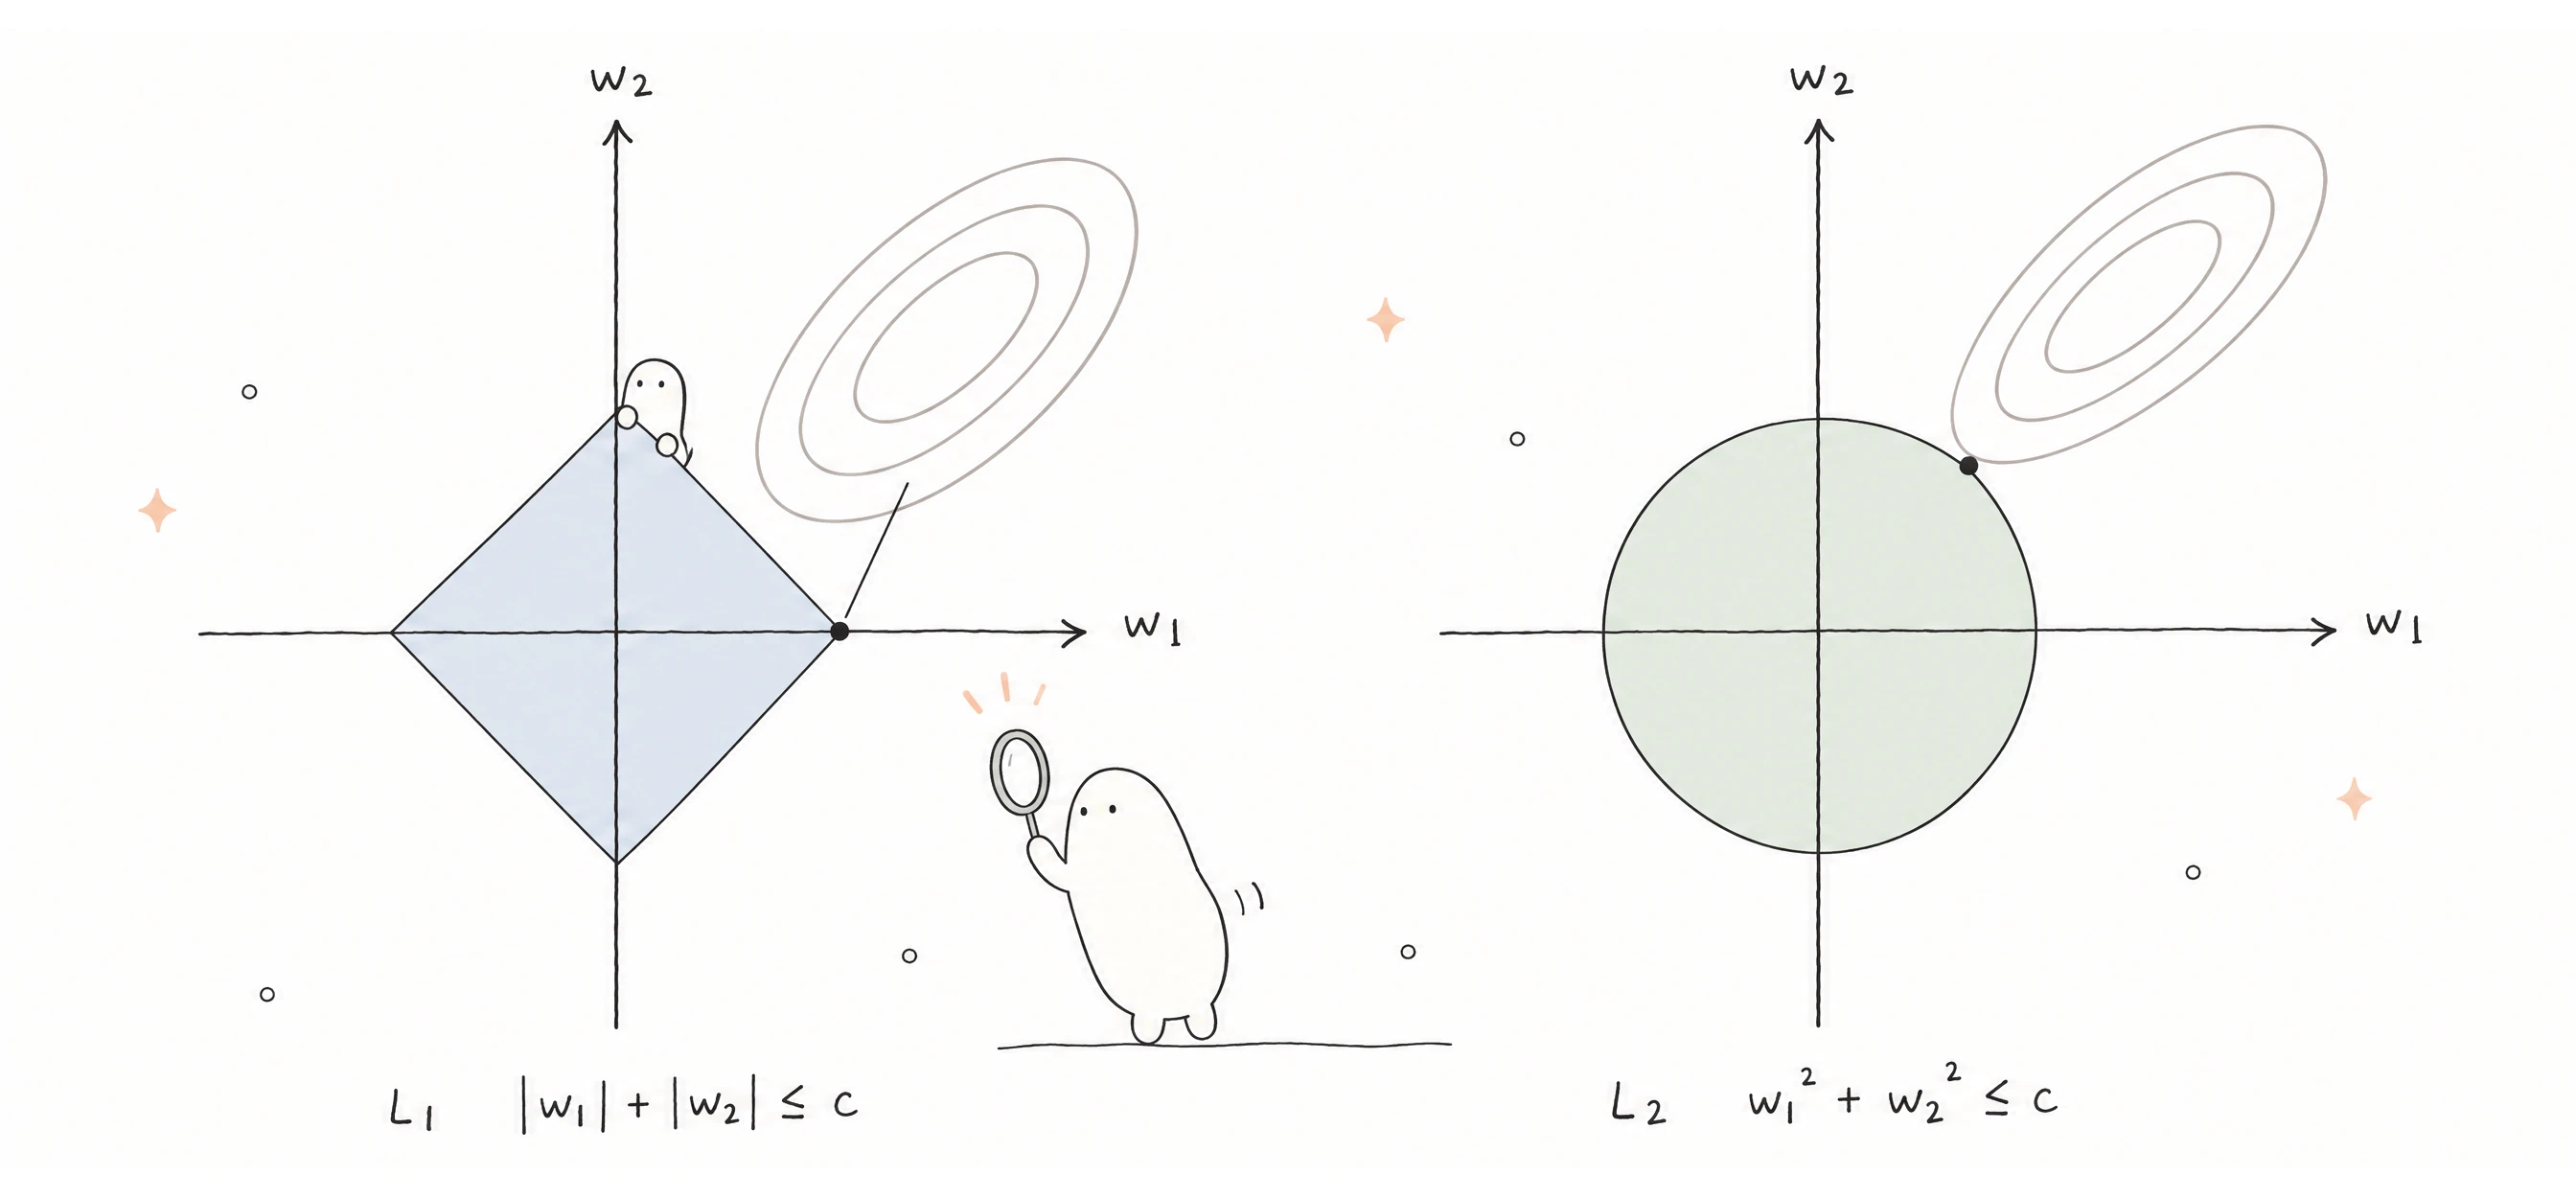
罚项
无约束最优
解 ŵ(1.61, 0.00)
零系数1 / 2稀疏解
数据损失0.368
罚项值1.610
约束几何与正则化路径等高线与约束区域相切于解处
约束边界 解路径 w₁ w₂
如果两个描述符高度相关,Lasso 可能选其中一个,换一批数据又选另一个。“被选中”意味着当前拟合下有预测作用,不能直接解释为唯一的化学决定因素。
这里要特别检查一个容易误解的问题:Lasso 保留下来的变量,能否直接解释为决定性质的因素?下面构造 50 个具有较强相关性的模拟描述符:前 5 列是独立的随机变量,后 45 列是前 5 列的随机线性组合再加少量噪声,目标只由前 5 列和噪声产生。生成规则已知,就能检查 Lasso 选中的是不是“真正起作用”的变量;这个实验用于说明机制,与 ESOL 的真实特征筛选分开讨论。
第二轮实验:构造相关描述符,比较 Ridge 与 Lasso

python
import numpy as np

def generate_chemical_dataset(num_samples=200, num_features=50, seed=42):
    np.random.seed(seed)
    # 模拟高度相关的化学描述符协方差矩阵
    base = np.random.randn(num_samples, 5)
    correlated = base @ np.random.randn(5, num_features - 5) + np.random.randn(num_samples, num_features - 5) * 0.2
    X = np.hstack([base, correlated])

    # 真实权重:仅前 5 个特征有非零影响
    true_w = np.zeros(num_features)
    true_w[:5] = [3.5, -2.0, 4.0, -1.5, 2.5]

    # y 为人为构造的模拟性质值,不是实验测量值
    y = X @ true_w + np.random.randn(num_samples) * 0.5
    return X, y, true_w

def solve_ridge(X, y, lmbda):
    """L2 正则化解析解: w = (X^T X + lambda I)^-1 X^T y"""
    n, d = X.shape
    return np.linalg.solve(X.T @ X + lmbda * np.eye(d), X.T @ y)

def solve_lasso_coord_descent(X, y, lmbda, max_iter=200, tol=1e-4):
    """L1 正则化坐标下降法 (软阈值算子)"""
    n, d = X.shape
    w = np.zeros(d)

    for _ in range(max_iter):
        w_old = w.copy()
        for j in range(d):
            # 扣除第 j 个特征的影响
            r_j = y - (X @ w - X[:, j] * w[j])
            rho_j = X[:, j] @ r_j
            z_j = np.sum(X[:, j] ** 2)

            # 软阈值 (Soft-thresholding)
            if rho_j < -lmbda / 2.0:
                w[j] = (rho_j + lmbda / 2.0) / z_j
            elif rho_j > lmbda / 2.0:
                w[j] = (rho_j - lmbda / 2.0) / z_j
            else:
                w[j] = 0.0

        if np.max(np.abs(w - w_old)) < tol:
            break
    return w

if __name__ == "__main__":
    X, y, true_w = generate_chemical_dataset()
    w_ridge = solve_ridge(X, y, lmbda=10.0)
    w_lasso = solve_lasso_coord_descent(X, y, lmbda=50.0)

    zero_ridge = np.sum(np.abs(w_ridge) < 1e-3)
    kept = np.where(np.abs(w_lasso) >= 1e-3)[0]        # Lasso 保留的特征位置

    print(">>> 在模拟描述符上比较 L2 (Ridge) 与 L1 (Lasso):")
    print(f"真实非零权重的位置: {np.where(true_w != 0)[0]}")
    print(f"Ridge (lambda=10.0) 近零系数数: {zero_ridge} / 50")
    print(f"Lasso (lambda=50.0) 近零系数数: {50 - len(kept)} / 50")
    print(f"Lasso 保留的特征位置: {kept}")
print(f"其中属于真实变量的数量: {np.sum(true_w[kept] != 0)} / 5")solve_ridge 解线性方程组;solve_lasso_coord_descent 每次调整一个系数,并使用软阈值。这里统计的是绝对值小于 的“近零系数”,不能把这个计数严格称为数学上的零。
还可以直接核对这个例子中的目标值:Lasso 解的 L1 范数约为 3.6,生成规则中真实系数的 L1 范数为 13.5;残差平方和从约 42 增加到约 53。较小的 L1 惩罚可以补偿这部分拟合误差,因此优化目标更偏好代理特征。即使先标准化全部特征,本例仍会选中代理特征,可以修改代码自行检查。
阅读实验代码时还要注意:它没有把全部特征标准化,且使用未除以样本数的目标:Ridge 对应 ,Lasso 对应 。其 数值不能直接与本节主线的平均损失约定相比。它也未设置验证集,只用于展示收缩机制;科研中的强度选择需要验证。
实际运行输出:
text
>>> 在模拟描述符上比较 L2 (Ridge) 与 L1 (Lasso):
真实非零权重的位置: [0 1 2 3 4]
Ridge (lambda=10.0) 近零系数数: 0 / 50
Lasso (lambda=50.0) 近零系数数: 40 / 50
Lasso 保留的特征位置: [ 7  8 15 16 17 21 24 28 44 47]
其中属于真实变量的数量: 0 / 5先看 Ridge:50 个系数没有一个接近零,符合 L2 收缩权重而通常不产生稀疏解的特点。
再看 Lasso:40 个系数接近零,保留了 10 个特征,其中没有一个是生成目标时使用的前 5 列。它确实完成了筛选,却没有找回生成规则中的变量。
原因是,后 45 列由前 5 列线性组合再加噪声得到,携带了相近的信息。模型用这些“代理”特征也能较好地拟合目标,而且所需系数更小。Lasso 同时考虑拟合误差和 L1 惩罚,因此可能更偏好这组代理特征。
这个实验说明:在高度相关的描述符中,Lasso 选出的是“在当前数据上足以完成拟合的一组”,而不一定是真正起作用的变量。用 Lasso 筛选描述符后,把被选中的描述符解释为性质的“决定因素”,需要额外的化学证据或实验设计来支持。
权重惩罚可能改善泛化;若任务还要求能量守恒等物理性质,需要另外设计相应约束。回到真实 ESOL 数据,下一节沿用前面的划分,演示怎样只根据验证集选择正则强度。
第二轮推导:Ridge、Lasso 与权重衰减
将截距加入矩阵,记 ,。本节 Ridge 目标求导得到:
式(23)的数值实现用线性求解器,不必显式求逆;无正则且矩阵奇异时可使用最小二乘或伪逆。
对未平均的 Lasso 目标,固定其他系数,记 ,,,则:
这正是式(24)的三个分支。若改用平均目标,阈值也要相应改变,不能只更改正文中的系数。
普通梯度下降中,L2 项 给出:
仅当 时,式(25)中前面的乘数处于 0 与 1 之间。对普通无动量梯度下降,这种 L2 更新与相应的参数衰减等价;对 Adam 等自适应规则,一般不等价,AdamW 为此把衰减独立处理。
0.4.3 在 ESOL 上用验证集选择正则强度
正则强度 太小,权重受到的限制较弱;太大,又可能使拟合不足。这里预先指定 ,分别训练,再用验证 MAE 选择。两种划分仍使用同样的六个描述符,各自只从训练集估计标准化统计量。
本节与第 0.2.4 节分阶段展示同一组教学比较:候选集合和选择规则固定,不能因已经看到前面的测试结果就改动它们。代码沿用 ESOL 主线变量:
python
def fit_ridge_gd(X, y, lam, lr=0.03, epochs=10000):
    """目标 L = mean((X @ w + b - y)**2) / 2 + lam * ||w||^2 / 2,截距不惩罚。"""
    w, b = np.zeros(X.shape[1]), 0.0
    for _ in range(epochs):
        error = X @ w + b - y
        w = w - lr * (X.T @ error / len(y) + lam * w)
        b = b - lr * error.mean()
    return w, b


def report(name, tr, dv, te, lambdas=(0, 0.001, 0.01, 0.1, 1)):
    (Xa, Xv, Xt), _, _ = standardize(X[tr], X[dv], X[te])
    ya, yv, yt = y[tr], y[dv], y[te]
    fits = {lam: fit_ridge_gd(Xa, ya, lam) for lam in lambdas}
    dev_mae = {lam: np.abs(Xv @ w + b - yv).mean() for lam, (w, b) in fits.items()}
    best = min(dev_mae, key=dev_mae.get)               # 只看验证 MAE 选 λ
    w, b = fits[best]
    p = Xt @ w + b
    rmse = np.sqrt(np.mean((p - yt) ** 2))
    r2 = 1 - np.sum((p - yt) ** 2) / np.sum((yt - yt.mean()) ** 2)
    print(f"{name}: {len(tr)}/{len(dv)}/{len(te)} 条,验证选中 λ={best},"
          f"测试 MAE={np.abs(p - yt).mean():.4f},RMSE={rmse:.4f},R²={r2:.4f}")


scaffold_idx = dc.splits.ScaffoldSplitter().split(
    dataset, frac_train=0.8, frac_valid=0.1, frac_test=0.1)
report("按结构分组随机", train_idx, dev_idx, test_idx)
report("骨架", *scaffold_idx)实际运行输出:
text
按结构分组随机: 901/115/112 条,验证选中 λ=0.01,测试 MAE=0.8236,RMSE=1.0216,R²=0.7810
骨架: 902/113/113 条,验证选中 λ=0,测试 MAE=0.9445,RMSE=1.2110,R²=0.6736 时 fit_ridge_gd 就是第 0.2.1 节的 fit_linear。表 8 汇总了两种划分下三种模型的完整结果;表中的训练、验证 MAE 以及均值基线一行,可以在 report 中补充几行打印得到。
表 8 ESOL 上两种划分方式的实际运行结果。MAE、RMSE 以 logS 单位报告, 无量纲,定义见第 0.2.2 节。随机分组(种子 42)为 901/115/112 条训练、验证、测试记录,骨架划分(ScaffoldSplitter 默认规则)为 902/113/113 条。“验证选择的 Ridge”在两种划分下分别选中 和 ;后者与无正则的线性回归完全相同,因此最后两行数值一致。
| 划分 | 模型 | 训练 MAE | 验证 MAE | 测试 MAE | 测试 RMSE | 测试 R² |
|---|---|---|---|---|---|---|
| 按结构分组随机 | 训练均值基线 | 1.6415 | 1.6911 | 1.7726 | 2.1864 | -0.0033 |
| 按结构分组随机 | 线性回归 | 0.7793 | 0.6970 | 0.8227 | 1.0203 | 0.7815 |
| 按结构分组随机 | 验证选择的 Ridge | 0.7805 | 0.6939 | 0.8236 | 1.0216 | 0.7810 |
| 骨架 | 训练均值基线 | 1.6416 | 1.6358 | 1.7759 | 2.3150 | -0.1928 |
| 骨架 | 线性回归 | 0.7229 | 1.0297 | 0.9445 | 1.2110 | 0.6736 |
| 骨架 | 验证选择的 Ridge | 0.7229 | 1.0297 | 0.9445 | 1.2110 | 0.6736 |
表 8 在前面线性基线的结果上,增加了验证集选择的 Ridge。重点看它是否改善了独立预测。
正则化不一定带来改善。随机分组时,验证集选中 ,其验证 MAE 比 略低(0.6939 对 0.6970),测试 MAE 却略高(0.8236 对 0.8227);骨架划分时验证集选中 。小数据中,验证集上略好的设置,未必在测试集上也略好。仍应遵守预先确定的选择规则。
这里比较的是不同训练与测试子集上的一次固定评估,只能说明本次设置下的表现。若要形成更一般的科研结论,还应采用合适的重复划分或交叉验证,并报告不确定性。
平均误差也不说明每个分子都可用。例如误差集中在某些结构族、极低溶解度范围或测定条件不同的样本上,后续工作可能完全不同。
第二轮辨析:为什么不能回头选择测试分数更好的设置
如果事后查看测试集,会发现骨架划分下 的测试 MAE(约 0.91)更低——但这一信息恰恰来自测试集,不能用来回头修改选择,否则测试集就不再独立。
正则化之后还可以调整训练时长。下一节介绍怎样用验证表现决定何时停止。
0.4.4 早停:根据验证表现决定训练到哪里
训练误差继续下降,验证误差却不再改善时,继续训练未必有价值。早停每隔若干步或每个 epoch 检查验证损失,保存目前最好的参数。如果连续 patience 次检查都没有足够改善,就停止并恢复最佳参数。
早停需要设定等待次数 patience、最小改善量和检查频率。验证曲线可能有波动或平台,因此应观察一段训练过程,而不只根据相邻两次检查作决定。
一种清楚的调试顺序是:
- 先确认程序正确、优化能降低训练损失。
- 再检查验证表现,比较正则化、训练长度和模型容量。
- 确认选择规则后,再进行最终测试。
- 将误差与真实实验需求比较,检查应用条件是否一致。
这些步骤可以帮助定位问题,不过学习率、早停与权重衰减会共同影响最后得到的模型。比较时应记录它们的设置,并用验证表现决定是否继续训练。
以上方法主要处理拟合与泛化。如果已有数据与未来应用来自不同来源,还需要把这种差异单独检查。
0.4.5 区分过拟合与数据来源差异
假设模型用理想晶胞的计算结果训练,未来却要预测真实含缺陷样品。即使它能预测同类计算数据,也不代表能直接用于这些实验样品。标签定义、结构分布和实验条件都可能发生变化。
所以,验证误差较大时,要区分两件事:模型是否过度适应了训练样本,以及验证数据是否已经换了来源。
当确实需要同时诊断这两个问题时,可以设置表 9 中的四个数据子集。其中关键的是 Train-Dev:它与训练集来源相同但不参与训练,起到“隔离变量”的作用。
表 9 同时诊断过拟合与来源差异时的四个数据子集。“训练来源分布”指已有数据的来源(例如理想晶胞计算),“目标应用分布”指模型将来要预测的对象(例如真实含缺陷样品)。
| 子集 | 数据来源 | 用途 |
|---|---|---|
| Train | 训练来源分布 | 拟合参数 |
| Train-Dev | 与训练来源相同,独立留出 | 检查在训练来源上的泛化 |
| Dev | 目标应用分布 | 选超参数和改进方向 |
| Test | 目标应用分布,独立留出 | 最终评估 |
若 Train 误差低而 Train-Dev 高,优先检查过拟合;若 Train-Dev 低而 Dev 高,优先检查来源差异。这些比较还会受样本量、噪声和标签尺度影响,适合用来提出排查方向。
四组划分不是所有项目的默认要求。实验数据少时,硬分成四小份可能让估计更不稳定。应根据实际来源、数据量选择留出、分组交叉验证或其他评估方案。
在可比较的损失与标签定义下,常用下面的差值作线索:
式(26)中的两个差值是可直接观察的量,不严格等于偏差—方差分解中的方差或“纯分布失配”。 大,也不自动证明验证集过拟合;有限样本波动和分布差异都可能贡献。
贝叶斯最优误差是相对于给定输入、目标分布和损失函数的理论最低期望误差。它通常未知。DFT 计算的自洽收敛阈值、泛函相对实验的系统误差、仪器精度,以及第 0.2.2 节提到的“化学精度”,各有不同含义,需要分别判断。
如果模型学习固定 DFT 方法的计算标签,可以非常准确地复现该方法,同时仍保留该方法相对真实实验的系统偏差。反之,仪器给出的分辨率也不一定就是整个数据集的不可约噪声。估计可靠的误差底线需要重复测量、任务定义与数据来源分析。
最终报告至少交代目标与单位、数据来源、特征与预处理、划分规则、模型选择方式、基线、指标和局限。模型指导实验前,还要判断预测对象是否接近训练覆盖范围;不确定性估计和独立实验验证可以作为后续步骤。
对于以原子坐标为输入的模型(例如后续章节的势能面模型),整体旋转、平移和同种原子重排等对称性检查也很有用,但预期变换应由目标量决定:标量能量应不变,力向量应相应旋转。数值容差需结合单位、精度与系统大小设定,不能统一指定一个没有单位的阈值。
到这里,我们已经知道怎样拟合一个连续性质,以及怎样检查预测是否可信。若实验只需要保留达到某个条件的候选分子,就可以把问题改写成分类。
0.5 从预测数值到筛选候选分子
0.5.1 逻辑回归:估计分子达到要求的概率
前面预测每个分子的具体 logS。初步筛选时,也可能只关心它是否达到某个要求。例如,本章暂定只保留实测 的分子:达到或超过阈值记为 ,否则记为 。
这样,连续性质预测变成了二分类。这里的 -3 只是教学规则,真实阈值应根据实验需求设定。
如果仍用线性模型直接输出结果,可能得到 -0.4 或 1.3,不能直接解释成概率。逻辑回归先算一个线性评分 ,再通过 Sigmoid:
当 ,; 时约为 0.881; 时约为 0.119。 表示模型估计的正类概率。这个模型名称虽然叫“回归”(历史上源于对对数几率做线性回归),实际用于分类。图 10 画出了这条 S 形曲线:评分越大,概率越接近 1;在 附近曲线最陡,评分的小变化就会明显改变概率。
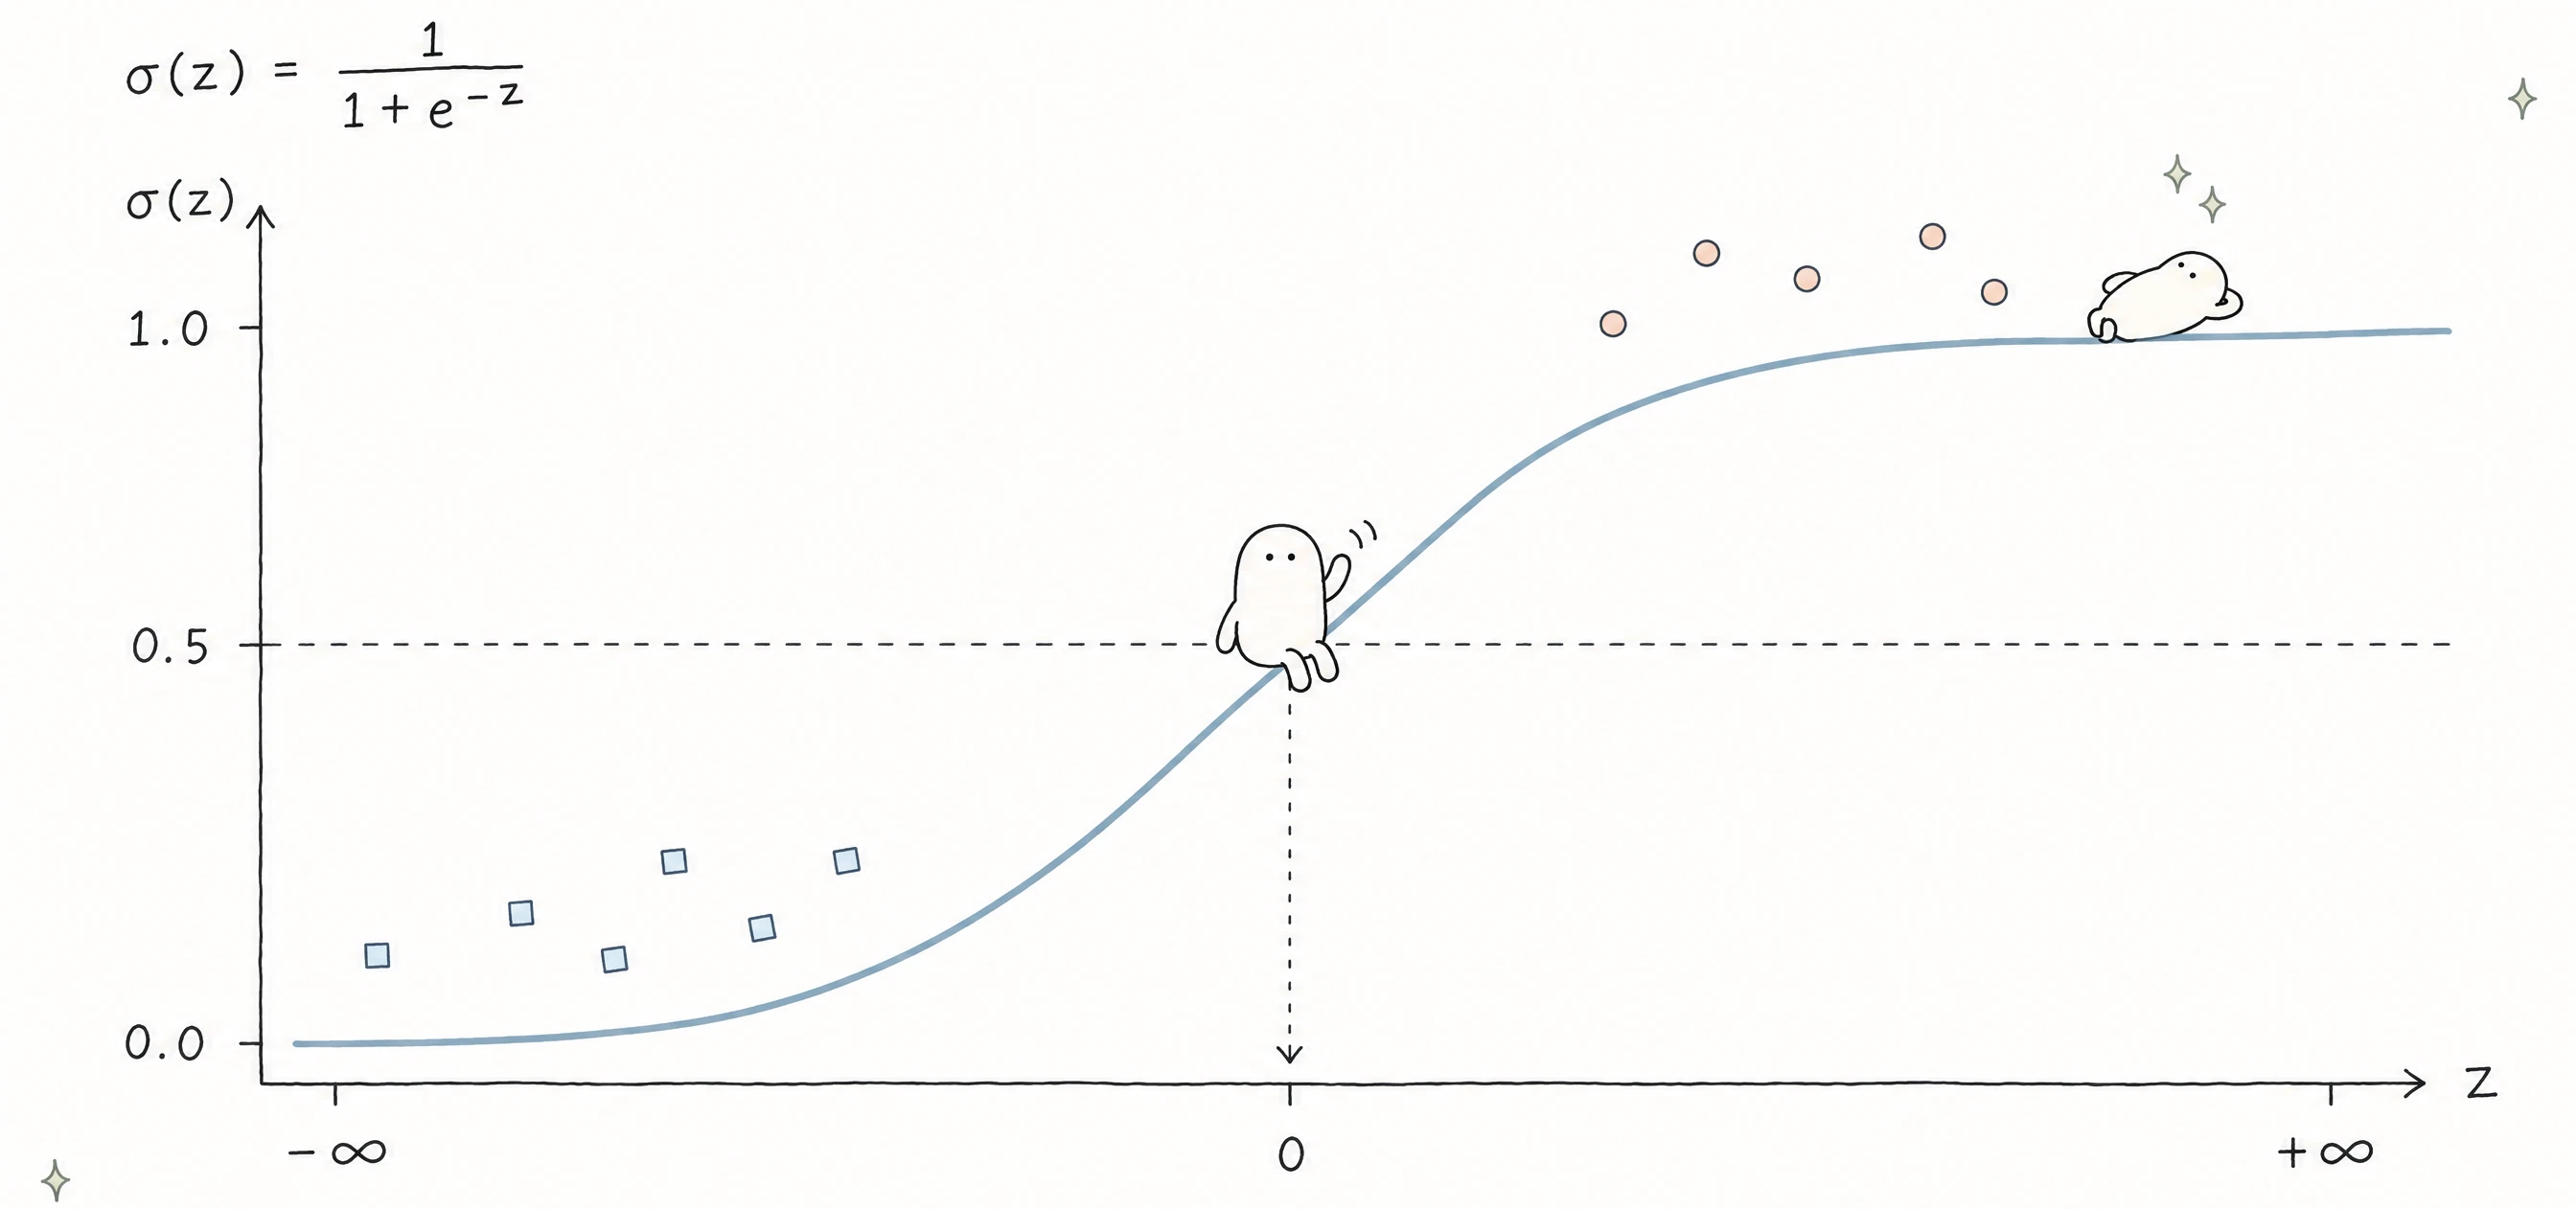
还要区分两个阈值: 用来定义真实标签,而 用来作出预测分类。实际筛选可以改变后者,以平衡漏掉候选物与增加实验验证工作量;选择预测阈值时应使用验证集。
训练分类模型也需要损失函数。前面 MSE 比较的是两个连续数值;这里需要评价模型给真实类别分配了多大的概率。
对于二分类,标签 ,模型输出正类概率 。二元交叉熵是:
当真实标签为 1,损失是 :预测 时约为 0.105,预测 时约为 2.303。模型对错误结果越自信,惩罚越大。刚才的 Sigmoid 已经给出了概率,下面据此更新参数。
用 BCE 训练时,梯度为:
形式与线性回归很接近:把“预测值减实测值”换成“预测概率减真实标签”。下面的 fit_logistic 实现这一过程,并加入 L2 正则项来限制权重大小;其作用与第 0.4 节的权重惩罚相同。
python
def sigmoid(z):
    # clip 只防止 exp 溢出;正常区间中的概率公式不变。
    return 1.0 / (1.0 + np.exp(-np.clip(z, -40, 40)))


def fit_logistic(X, labels, lr=0.1, epochs=3000, lam=0.01):
    w, b = np.zeros(X.shape[1]), 0.0
    for _ in range(epochs):
        p = sigmoid(X @ w + b)
        w = w - lr * (X.T @ (p - labels) / len(labels) + lam * w)
        b = b - lr * np.mean(p - labels)
    return w, b

# 接第 0.2.1 节的数据和训练集标准化输入。
labels = (y >= -3.0).astype(float)
cw, cb = fit_logistic(Xtr, labels[train_idx])
probability = sigmoid(Xdev @ cw + cb)
print(probability.shape)                                   # (115,)
dev_pred = (probability >= 0.5).astype(float)
print(f"验证准确率: {(dev_pred == labels[dev_idx]).mean():.3f}") # 0.870cw、cb 是分类模型的参数;w、b 仍是前面的回归参数。标签阈值固定后,模型只从训练标签学习。训练集中约 51% 的分子满足 ,两类样本大致均衡;在 115 个验证分子上,按 判断的准确率约为 0.87。准确率只是最粗略的概括,下一节用混淆矩阵、精确率和召回率解释这个分类器的筛选效果。
概率落在 内,不代表它已经校准。例如输出 0.8 的一组分子中,真实阳性比例是否接近 80%,需要另行检查。概率也不表示模型已经理解了导致溶解度变化的机理。
第二轮推导:分类损失、梯度与凸性
二分类采用伯努利模型:
取独立样本联合概率的负对数平均,便得到式(28)的 BCE。多分类采用类别分布,得到类别交叉熵。
交叉熵与衡量两个分布差异的 KL 散度有关系。对同一组离散类别,设目标分布为 、模型分布为 :
在 固定时,减小交叉熵也减小 KL 散度。信息熵与统计热力学熵有相似的数学形式,但通常的预测损失不自动等于体系的物理自由能或热力学熵。
几率是 ,对数几率为:
解出 得到 Sigmoid。由 ,结合 BCE 的链式求导,单个样本关于 的导数简化为 ,所以得到式(29)。
把截距并入参数,在 末尾加常数列 1,Hessian 为:
对任意向量 ,
因此损失是凸的,每个存在的局部最小都是全局最小。凸性不保证最优解一定存在或唯一:特征共线时可能不唯一;线性可分且无正则时,权重可以不断增大,使损失趋近于零,却没有有限参数的最小点。设计矩阵满秩时,对有限参数 Hessian 正定;最优解存在后才谈其唯一性。适当正则化可以改善这些问题。
这种凸性结论针对线性评分的逻辑回归。换成深层神经网络后,不能继续据此保证全局最优。
改变权重与偏置,观察 sigmoid 如何把线性得分映射到二分类概率。
sigmoid 概率分类阈值当前输入
x=-4;得分=-4;p=0.018
思考与说明
思考增大权重时,概率过渡区为什么变窄?
单特征、无量纲教学样本;图中概率来自指定模型,不是校准后的实验概率。
0.5.2 推荐了多少,误报和漏报了多少
为了便于对照实验筛选,这里把达到要求的分子称为阳性。模型推荐了多少个,其中多少真正达到要求,多少被漏掉?先数清四种结果。
预测为正类且实际为阳性的为真阳性 TP,预测为正类但实际为阴性的为假阳性 FP(误报);漏掉的真实阳性为假阴性 FN,正确判为阴性的为真阴性 TN。这四个计数排成的 2×2 表称为混淆矩阵。准确率(Accuracy)、精确率(Precision)和召回率(Recall)分别为:
Precision 回答“拿去验证的候选中有多少是真的”,Recall 回答“真实候选找回了多少”。若正类只占 1%,始终预测阴性也有 99% 准确率,说明总体准确率可能不能回答筛选问题。
沿用上一节的分类器,固定标签阈值 -3、预测概率阈值 0.5,在测试集上统计混淆矩阵:
python
test_pred = sigmoid(Xte @ cw + cb) >= 0.5
test_true = labels[test_idx] == 1
TP = np.sum(test_pred & test_true);  FP = np.sum(test_pred & ~test_true)
FN = np.sum(~test_pred & test_true); TN = np.sum(~test_pred & ~test_true)
print(TP, FP, FN, TN)                                      # 61 14 2 35
print(f"Precision={TP / (TP + FP):.3f}, Recall={TP / (TP + FN):.3f}, "
f"Accuracy={(TP + TN) / len(test_idx):.3f}") # 0.813, 0.968, 0.857模型推荐了 75 个“较易溶”分子,其中 14 个是误报:如果把推荐的分子都拿去实验,约 19% 会落空;而 63 个真正较易溶的分子中只漏掉了 2 个。若实验成本很高,可以提高概率阈值,以牺牲部分召回率换取更高的精确率;若漏掉候选物的代价更大,则可以降低阈值。比较或改变概率阈值时,要回到验证集;不能根据这次测试中的错例调整后再宣称测试独立。下一节用 ROC 与 PR 曲线查看不同阈值下的权衡。
上面是固定随机分组、标签阈值 -3、预测概率阈值 0.5 的教学结果。阳性约占训练数据的一半(测试集中为 56%),与许多阳性稀少的筛选任务不同。真实实验预算有限时,还可以看前 个推荐的命中率、相对总体阳性比例的提高程度,以及具体错误类型。
密度视图
精确率 P33.7%R = 72.6%
F10.460FPR = 15.9%
ROC-AUC0.871PR-AUC 0.513
每 1000 个TP 73 · FP 143FN 27 · TN 757
得分分布、ROC 与 PR阈值右侧判为正类
正类 负类 TP FP
0.5.3 阳性很少时,怎样读 ROC 与 PR
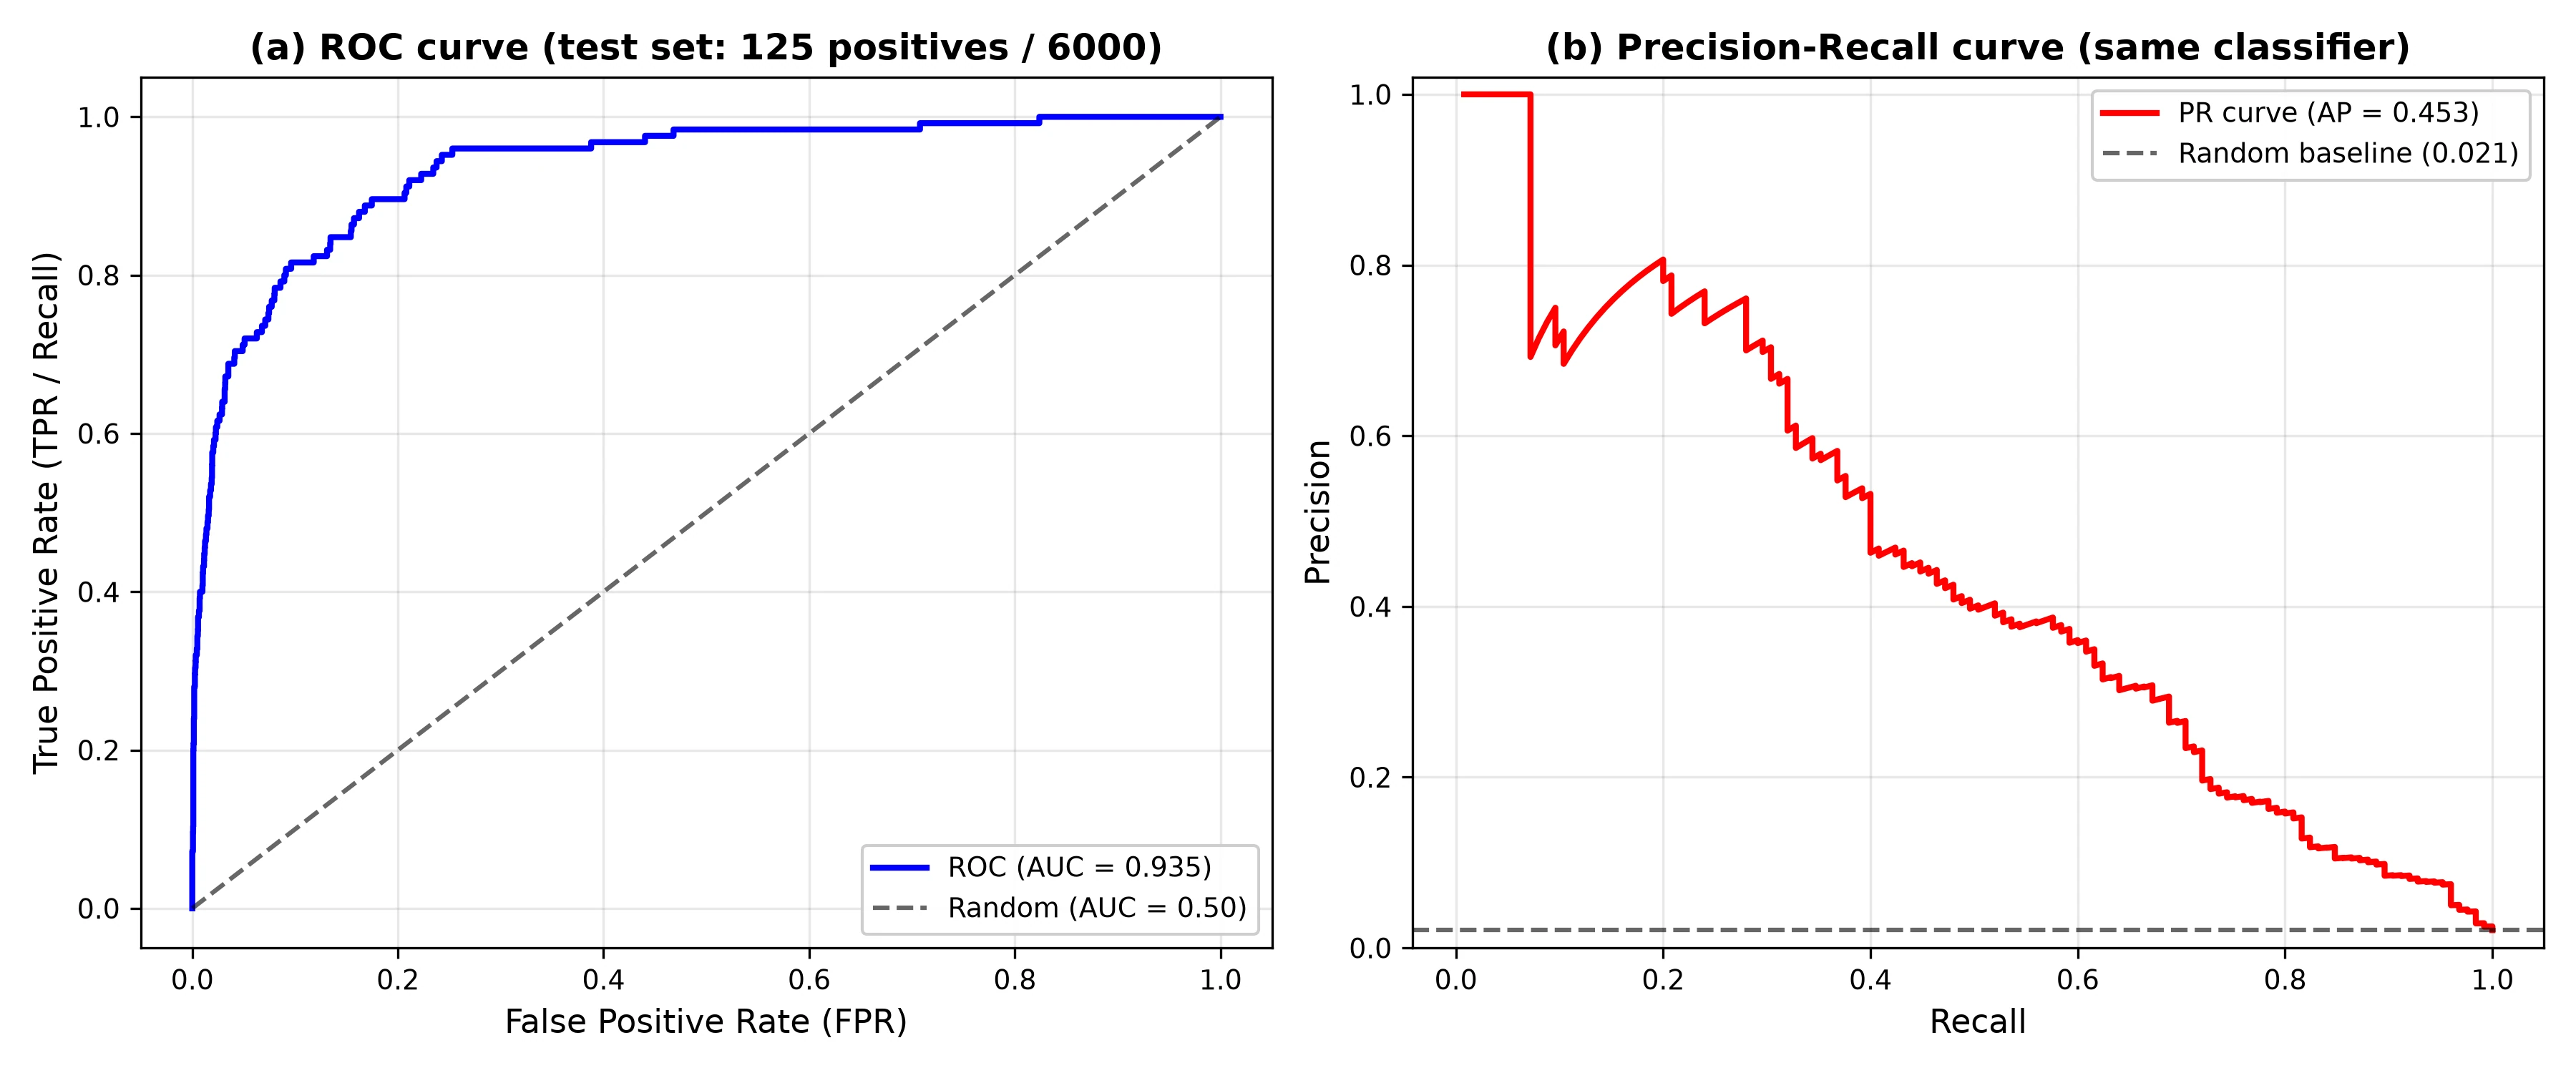
一个概率阈值对应一组误报和漏报。逐步移动阈值,就得到一系列分类结果,可以画成曲线。ROC 曲线用假阳率作横轴、真阳率作纵轴;假阳率为 ,真阳率就是 Recall。PR 曲线用 Recall 作横轴、Precision 作纵轴。阳性很少时,即使假阳率小,推荐列表中也可能有不少误报。因此筛选任务通常需要同时看 PR 与具体阈值下的命中率 [17]。
ROC-AUC 是 ROC 曲线下的面积,用于概括排序能力:它等于随机抽取一个阳性样本和一个阴性样本时,模型给阳性样本打分更高的概率;随机排序时为 0.5,完美排序时为 1。PR 指标对阳性比例敏感,跨测试总体比较时要交代比例。平均精确率 AP 用召回率的增量加权各阈值处的 Precision;随机排序时,AP 约等于测试集的阳性比例。AP 与梯形法计算的 PR 面积不完全相同,报告时应写明定义。
为了看清阳性稀少时两类指标的差别,下面生成一个阳性比例约为 2% 的合成数据集,训练逻辑回归,并在独立生成的测试集上画出两种曲线(图 11)。
第二轮实验:生成稀有阳性数据,计算 ROC 与 PR
python
import numpy as np

def make_imbalanced(n=6000, pos_frac=0.02, d=8, shift=1.2, seed=0):
    """合成"稀有活性"数据:2% 为活性样本,活性样本的特征均值整体平移 shift。"""
    rng = np.random.default_rng(seed)
    y = (rng.random(n) < pos_frac).astype(int)
    X = rng.normal(size=(n, d)) + shift * y[:, None] * (np.arange(d) < 4)  # 只有前 4 维有信息
    return X, y

def fit_logreg(X, y, lr=0.5, epochs=500, l2=1e-3):
    """逻辑回归:全批量梯度下降最小化二元交叉熵 + L2。"""
    mu, sd = X.mean(0), X.std(0)
    sd = np.where(sd == 0, 1.0, sd)
    Xn = (X - mu) / sd
    w, b = np.zeros(X.shape[1]), 0.0
    for _ in range(epochs):
        z = np.clip(Xn @ w + b, -40.0, 40.0)
        p = 1 / (1 + np.exp(-z))
        w -= lr * (Xn.T @ (p - y) / len(y) + l2 * w)
        b -= lr * np.mean(p - y)
    return lambda Z: 1 / (1 + np.exp(-np.clip(((Z - mu) / sd) @ w + b, -40.0, 40.0)))

def roc_pr(y, s):
    """把得分从高到低排序,依次把阈值放到每个样本上,得到 ROC 与 PR 曲线。"""
    order = np.argsort(-s)
    ys = y[order]
    n_pos = ys.sum()
    n_neg = len(ys) - n_pos
    if n_pos == 0 or n_neg == 0:
        raise ValueError("ROC 与 PR 曲线要求测试集中同时包含正类和负类。")
    tp = np.cumsum(ys); fp = np.cumsum(1 - ys)
    tpr = np.r_[0, tp / n_pos]; fpr = np.r_[0, fp / n_neg]
    recall = tp / n_pos; precision = tp / (tp + fp)
    auc = np.sum(np.diff(fpr) * (tpr[1:] + tpr[:-1]) / 2)                                    # ROC 曲线下面积
    ap = np.sum(np.diff(np.r_[0, recall]) * precision)          # 平均精确率 AP:以召回增量加权 Precision
    return fpr, tpr, recall, precision, auc, ap

aucs, aps = [], []
for seed in range(10):
    X, y = make_imbalanced(seed=seed)
    Xte, yte = make_imbalanced(seed=1000 + seed)                # 独立生成的测试集
    f = fit_logreg(X, y)
    fpr, tpr, rec, prec, auc, ap = roc_pr(yte, f(Xte))
    aucs.append(auc); aps.append(ap)
    if seed == 0:
        print(f"seed 0: 测试集正样本 {yte.sum()} / {len(yte)}, ROC-AUC = {auc:.3f}, AP = {ap:.3f}")
print(f"10 个随机种子: ROC-AUC = {np.mean(aucs):.3f} ± {np.std(aucs):.3f}, AP = {np.mean(aps):.3f} ± {np.std(aps):.3f}, 数据生成的阳性概率 = 0.02")argsort(-s) 按预测得分从高到低排序,cumsum 随阈值移动累计 TP 和 FP;ap 用召回增量加权 Precision,采用 AP 定义。此连续随机得分实验通常没有并列;通用指标实现需要把相同得分作为同一阈值处理。只有一个类别的测试集也需要特殊处理。
实际运行输出:
text
seed 0: 测试集正样本 125 / 6000, ROC-AUC = 0.935, AP = 0.453
10 个随机种子: ROC-AUC = 0.947 ± 0.012, AP = 0.520 ± 0.044, 数据生成的阳性概率 = 0.02ROC-AUC 约 0.95,说明排序能力较强;AP 约为 0.5,也远高于阳性比例为 2% 时约 0.02 的随机参照。不过,AP 汇总了不同阈值处的精确率,并不能直接给出某一次推荐列表的命中率。对于逐个合成或测试的筛选任务,还要按实验预算检查具体阈值或前 个候选中的命中情况。
这里的“±”表示十个随机种子对应结果的标准差(np.std 的默认约定),不是置信区间;每次都重新生成训练集和独立测试集。生成时的阳性概率为 0.02,有限测试集中的实际阳性比例会有波动,图中的参考线按该测试集的实际比例绘制。
第二轮重写:从 TP、FP 的累计数独立实现曲线;用小数据手算核对,不只比较一个最终 AUC 数字。
0.5.4 多于两个类别时使用 Softmax
刚才只有“保留”和“不保留”两类。如果研究任务需要多个互斥类别,模型可以输出 个评分 。例如以明确、不重叠的区间把 logS 分成“难溶”()、“中等”()、“易溶”()三档,用来演示多分类。Softmax 把这 个评分转换成概率:
各概率为正且总和为 1。真实类别是 时,交叉熵为 。这些分档只是教学定义;分档会丢掉连续数值信息,实际需要预测精确溶解度时仍优先考虑回归。
计算时先减去最大评分:
python
z = np.array([2.0, 1.0, 0.0])
exp_z = np.exp(z - z.max())
p = exp_z / exp_z.sum()
print(np.round(p, 3)) # [0.665 0.245 0.090]所有评分减去同一个数不改变概率,却能降低指数溢出的风险。处理多行样本时,要对每一行分别做归一化。
第二轮理解:Softmax 与玻尔兹曼分布的形式对应
玻尔兹曼分布 与 Softmax 具有相同的指数归一化形式。把 对应到无量纲的 ,可以借熟悉的数学结构理解“更高评分得到更大概率”。
分类评分通常不是实际能级,Softmax 分母也不自动成为真实体系的物理配分函数。引入温度参数 ,
大 使分布更均匀,小 更偏向最大评分。如果最大值并列, 不会只保留一个类别。温度可以用于概率校准,但不能被解释为样品的实验温度。
现在,连续数值、二分类和多分类三种输出都与相应任务对应起来了。接下来再看模型内部:如果线性关系不够用,怎样增加表达复杂关系的能力?
0.6 从线性模型走向神经网络
0.6.1 增加隐藏层之后,计算发生了什么
线性模型把六个描述符加权相加,适合作为起点。希望表达更复杂的关系时,可以在输入与输出之间增加一组中间计算,称为隐藏层 [18]。
先把输入做一次加权组合,再通过非线性函数,得到一组新的数;最后用这些数预测 logS。以 Tanh 为非线性函数,一个隐藏层的模型写为:
若一批有 个样本、每个样本有 个特征、隐藏层有 个单元,则 是 , 是 , 是 , 可写为 ,预测为 。这里的 就是隐藏层计算出的数,也称激活。每一列对应一个隐藏单元;这些单元是内部计算量,不必对应某个原子或官能团。
怎样确定这些新权重?仍然是计算损失,再调整参数。隐藏层的权重通过后面的计算影响最终损失,求导时需要沿这条依赖关系逐层往回算,这就是反向传播。第 01–03 章会展开计算方法,这里先看网络变深后可能遇到的问题。
例如,连续乘十次 0.5,得到约 0.001;连续乘十次 2,得到 1024。深层网络的梯度传播是矩阵和激活导数的连乘,情况更复杂,但这个例子帮助理解:
- 梯度消失:靠近输入的参数得到很小的梯度,更新缓慢。
- 梯度爆炸:梯度很大,更新不稳定,甚至产生非有限数值(
inf或NaN)。
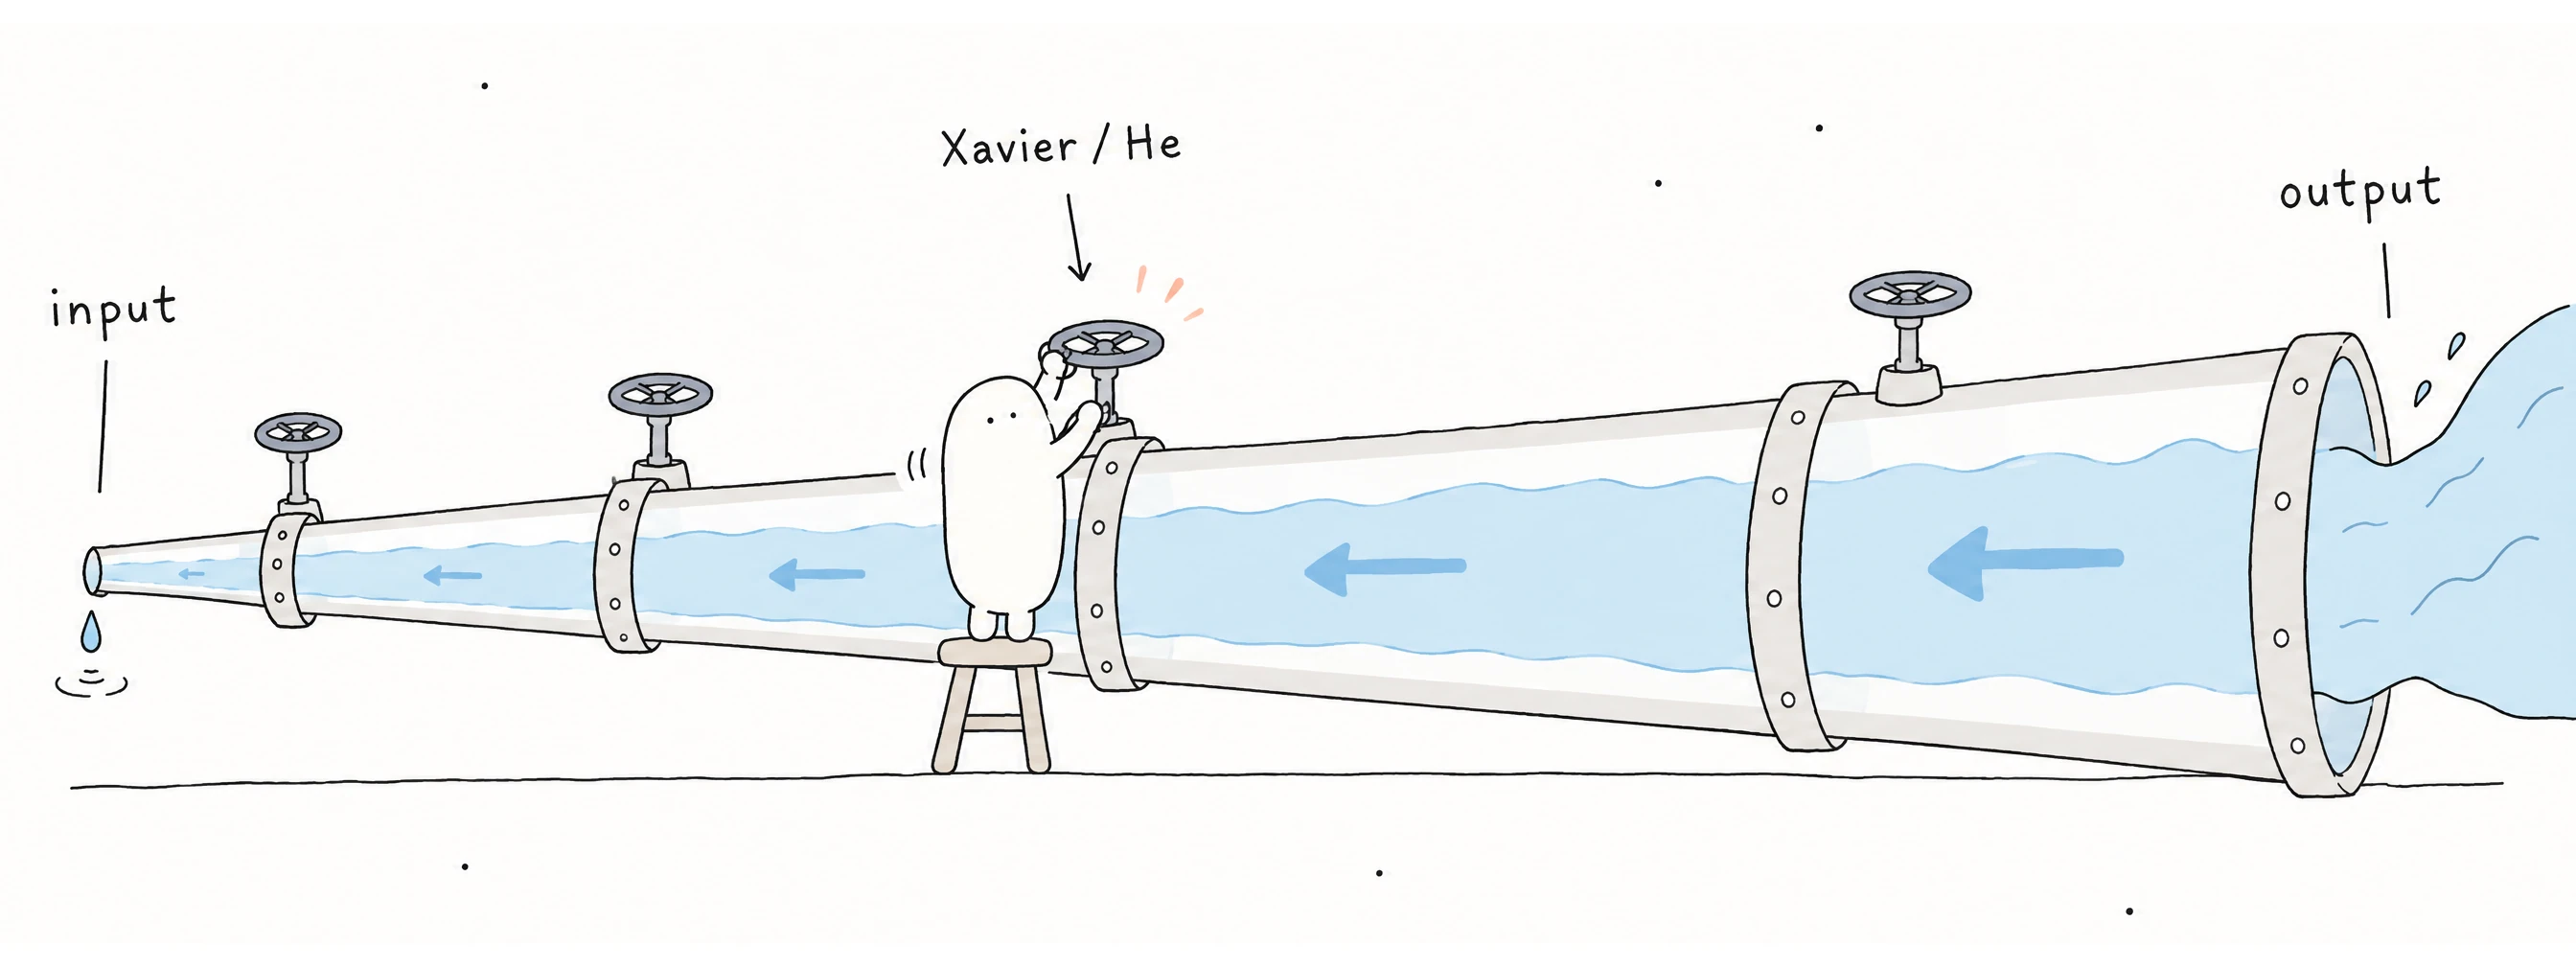
图 12 用管道作类比:梯度从输出层向输入层反向流动,每经过一层就被乘上一个因子,因子持续偏小,管道就越来越细。
NaN 还可能来自除以零、非法对数、损失实现错误等。出现 NaN,先检查输入和第一次出现非有限值的位置。梯度裁剪可以限制过大更新,但不修复根本的数据或公式错误。
第二轮推导:一层的链式求导与小型 MLP
使用行表示样本,,令 。上面的单隐藏层网络有:
是逐元素相乘;。代码中的 np.outer(e, W2) 对应 ,形状为 。所有梯度先用当前参数计算完,再更新参数,不能先修改 后拿新 求 的梯度。
多层网络反复执行这组关系。以列向量约定写第 层的局部 Jacobian:
反向梯度涉及 的连乘,转置与顺序取决于采用行还是列的约定。各层奇异值、激活导数以及它们的方向共同影响传播。不能仅凭每个权重矩阵的谱半径大于 1 就断言实际梯度一定爆炸。
重写任务:先实现单隐藏层 MLP,对几个参数使用有限差分 核对解析梯度,再加多层。检查应使用小输入与双精度,并避开不可导拐点。
0.6.2 激活函数为什么不可少
上一节在加权组合后加了 Tanh,为什么需要这一步?如果每层只有线性变换,连续叠加后仍是一个线性变换:,多层与单层没有区别。激活函数在层间加入非线性,使模型可以表达更多关系。图 13 画出了几种常用激活函数及其导数,表 10 总结了它们的特点。
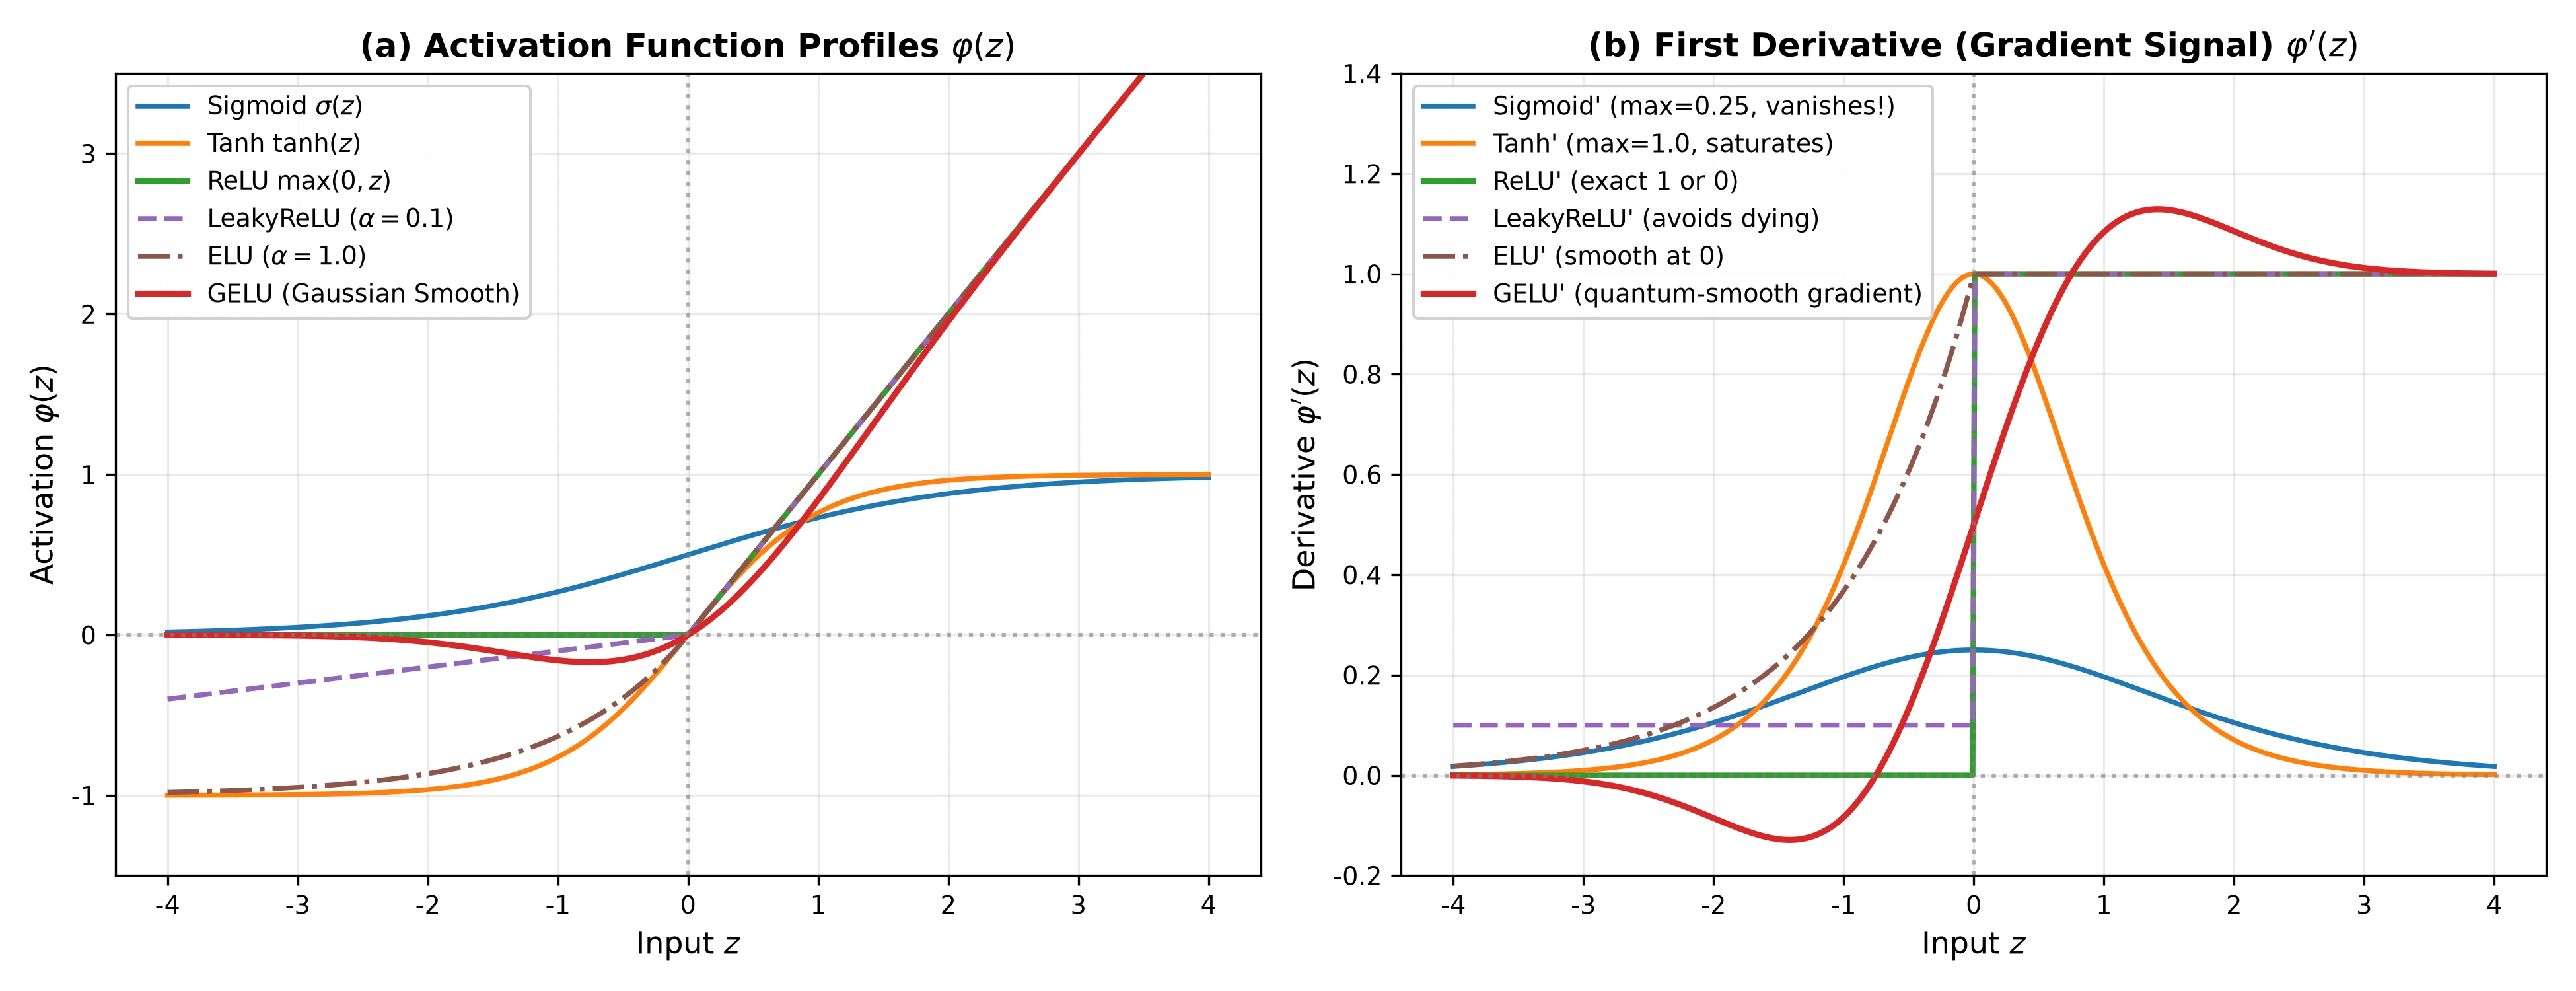
表 10 常用激活函数的定义与使用要点。
| 激活函数 | 定义或直觉 | 使用时要注意 |
|---|---|---|
| Sigmoid | 把数压到 | 适合二分类输出;输入绝对值大时导数很小 |
| Tanh | 把数压到 | 输出可正可负,但也有饱和区 |
| ReLU | 正区间导数为 1;长期处于负区间的单元可能不再学习 | |
| LeakyReLU | 负区间保留小斜率 | 保留负区间梯度,但不是所有任务都更好 |
| GELU、SiLU | 平滑的非线性函数 | 常用于深层架构;需要结合模型测试 |
回归输出层通常保留线性输出;二分类输出层与损失采用 Sigmoid/BCE,多分类采用 Softmax/交叉熵。隐藏层与输出层的职责不同。预测能量和力时,激活的光滑性还可能影响对坐标求导的结果。
0.6.3 初始权重太大或太小会怎样
前面的线性回归从零权重开始就能训练。隐藏层则多了一件事:希望不同单元学到不同的组合。如果同一隐藏层的神经元具有相同的输入权重和偏置,会得到相同的初始输出。如果它们连接到下一层的对应权重也相同,且训练中没有其他打破对称的因素,就会持续得到相同更新,难以学成不同的特征。全部权重置零是典型例子。通常随机初始化权重来打破这种对称,偏置则可以为零。
初始化
激活函数
宽度 n = 64 · 批量 48
末层激活 RMS0.167
首层梯度 RMS0.206
梯度比 g₀/g_L0.205信号稳定
饱和比例 |h|>0.950.0%
逐层信号强度真实前向与反向计算 · 对数纵轴
前向激活 反向梯度
“随机”还不够。权重太小,经过多层后信号可能越来越弱;权重太大,可能放大信号或使 Tanh、Sigmoid 饱和。Xavier 和 He 初始化按连接数量选择尺度 [19,20]:
前者常用于近似对称的激活,后者针对 ReLU 一类激活的信号尺度。它们依赖近似假设,帮助训练开始时保持适当尺度,不保证训练全过程方差严格守恒。
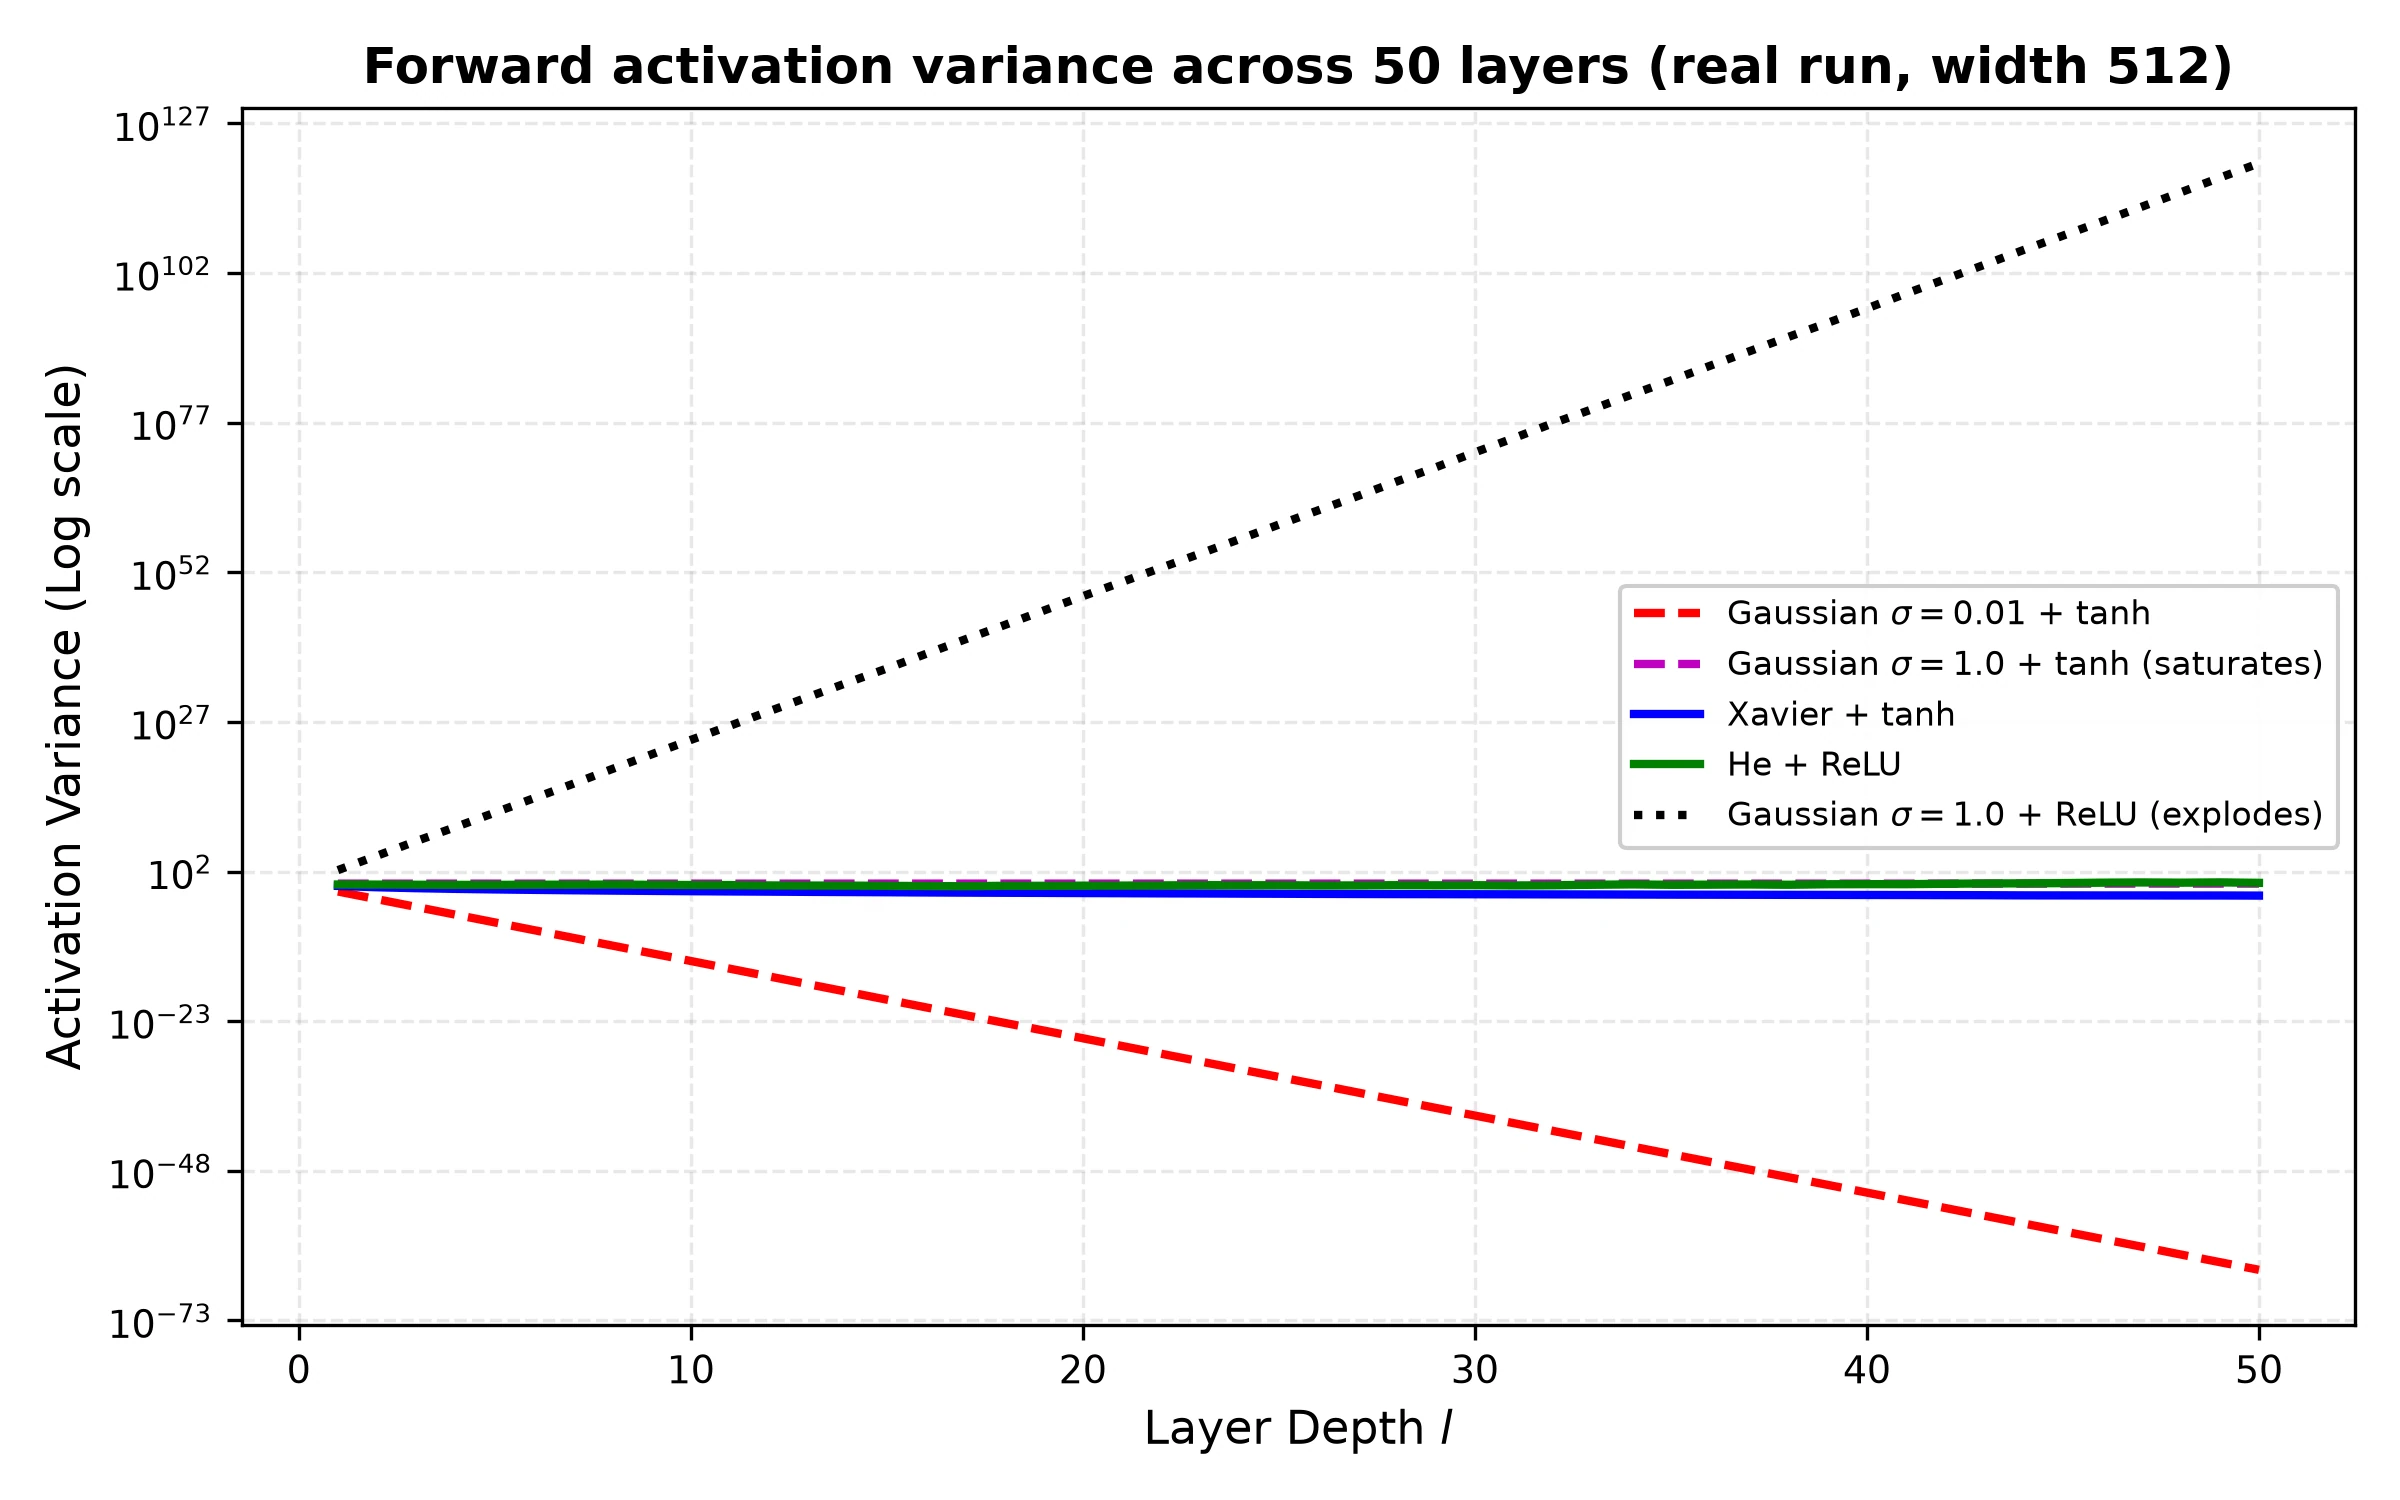
初始化的影响用实验看最直观。下面构造一个 50 层、每层 512 个单元的全连接网络,输入 1000 个随机样本,比较五种“权重尺度 + 激活函数”组合下各层激活方差的变化;图 14 画出了完整曲线。
第二轮实验:记录 50 层网络的激活方差
python
import numpy as np

def variance_by_layer(num_layers=50, dim=512, n=1000, seed=42):
    """50 层全连接网络,逐层记录激活值的方差;比较 5 种"权重分布 + 激活函数"组合。"""
    rng = np.random.default_rng(seed)
    x0 = rng.normal(size=(n, dim))
    tanh, relu = np.tanh, lambda z: np.maximum(z, 0.0)
    schemes = {
        "小高斯 std=0.01 + tanh": (0.01, tanh),
        "大高斯 std=1.0 + tanh": (1.0, tanh),
        "Xavier + tanh": (np.sqrt(2.0 / (dim + dim)), tanh),
        "He + ReLU": (np.sqrt(2.0 / dim), relu),
        "大高斯 std=1.0 + ReLU": (1.0, relu),
    }
    out = {}
    for name, (std, act) in schemes.items():
        a, var = x0, []
        for _ in range(num_layers):
            a = act(a @ rng.normal(0.0, std, (dim, dim)))     # 一层:线性变换 + 激活
            var.append(a.var())
        out[name] = np.array(var)
    return out

res = variance_by_layer()
for name, v in res.items():
print(f"{name:22s} 第1层 {v[0]:.3e} 第25层 {v[24]:.3e} 第50层 {v[49]:.3e}")a 是当前层全部样本的激活,形状为 。a @ W 保持这个形状,随后逐元素执行激活。a.var() 在所有样本与通道上汇总方差,不是逐个神经元分别计算的结果。
实际运行输出:
text
小高斯 std=0.01 + tanh    第1层 4.643e-02  第25层 4.754e-33  第50层 2.825e-65
大高斯 std=1.0 + tanh     第1层 9.648e-01  第25层 9.642e-01  第50层 9.636e-01
Xavier + tanh          第1层 3.939e-01  第25层 1.949e-02  第50层 9.564e-03
He + ReLU              第1层 6.792e-01  第25层 5.226e-01  第50层 1.287e+00
大高斯 std=1.0 + ReLU 第1层 1.740e+02 第25层 9.316e+59 第50层 2.185e+120逐行对照输出:
- 小高斯 + Tanh:方差每层约缩小为原来的 5%(恰为 ),50 层后降到 ,信号实际上已经消失。
- 大高斯 + Tanh:方差稳定在 0.96 左右,看似“健康”,实则几乎所有激活都贴近 ,处在饱和区, 接近 0,反向梯度同样难以通过。只看前向方差会误判这种情况。
- Xavier + Tanh:方差随深度缓慢下降,50 层后约为 0.01。Xavier 的推导基于激活在零点附近近似线性,而 Tanh 离开零点后斜率小于 1,所以仍有缓慢衰减。
- He + ReLU:50 层内一直保持在 0.5–1.3 的量级,没有系统性的消失或爆炸。
- 大高斯 + ReLU:每层约放大 倍,第 50 层达到 ,再深一些就会溢出为
inf。
第二轮重写:先做 3 层的小网络,再增加到 50 层,分别记录二阶矩、方差与梯度,解释它们的区别。运行时间取决于数组库和硬件;先用较小宽度检查代码,再扩大实验。
第二轮推导:Xavier、He 与二阶矩
在权重均值为零、权重与输入独立,相关项可忽略等近似下:
输入也零均值时,。前向尺度要求 ,反向要求约 ,Xavier 使用 作为两者的折中。
若 关于零对称,ReLU 的二阶矩满足:
这给出 He 的补偿系数 2。ReLU 输出均值通常大于零,所以不能把式(43)直接改写成“输出方差严格为输入方差一半”。例如高斯 的 ReLU 方差为 。区分二阶矩与方差,才能正确解释初始化推导和实测曲线。
0.6.4 BatchNorm 与 LayerNorm 在归一化哪些数
初始化处理的是训练开始时的权重尺度。训练过程中,还可以在网络内部对激活做归一化。这里要与第 0.3.2 节的输入标准化区分开:处理对象换成了隐藏层中的数。
两种常见方法是 BatchNorm 和 LayerNorm。读它们的公式前,先问一句:计算均值和方差时,究竟把哪些数放在一起?
归一化方式
数据
统计维度沿批量 N=6
当前组 μ / σ0.46 / 1.38→ 0 / 1
缩放样本 1 后其他样本输出变化0.000样本 1 自身 0.000
BN 均值估计误差0.383∝ 1/√N
激活矩阵 N × C橙框为共享同一组 μ、σ 的元素
正值 负值
对形状 的一个小批量,BatchNorm 为每个特征跨 个样本计算均值和方差:
和 是可以训练的缩放与平移参数。以一列 为例,均值为 2,方差为 1,忽略 后得到 。
训练时通常使用当前批的统计量,并维护移动统计量;推理时通常使用已估计的统计量,不应让待预测的测试数据参与重新拟合。批很小或不同批组成差异很大时,需要检查这种方法是否适合。
LayerNorm 通常对每个样本内部的指定特征维度计算统计量,不跨不同样本,所以不直接依赖批大小。在序列模型中,这种计算也常针对单个 token,即序列中的一个基本单元。Transformer 常用 LayerNorm;处理原子、键等连接关系的图网络还可以采用其他归一化方式,选择时需要结合模型和数据验证。
BatchNorm 原论文用“内部协变量偏移”描述训练过程中各层输入分布的变化,并据此解释归一化的作用 [21]。后续研究还从优化过程的平滑性等角度分析了它为何有帮助 [22]。这些解释各有适用范围。
第一轮先掌握两者的区别:BatchNorm 在一批样本之间统计同一特征,LayerNorm 在单个样本内部统计指定特征。下面的第二轮实验再展开前向计算与反向求导。
第二轮实验与推导:手写 BatchNorm
python
import numpy as np

class BatchNorm1D:
    def __init__(self, dim, momentum=0.9, eps=1e-5):
        self.dim = dim
        self.momentum = momentum
        self.eps = eps

        # 可学习仿射参数
        self.gamma = np.ones(dim)
        self.beta = np.zeros(dim)

        # 推理时使用的全局移动统计量
        self.running_mean = np.zeros(dim)
        self.running_var = np.ones(dim)

        # 缓存中间反向传播变量
        self.cache = None

    def forward(self, x, is_training=True):
        if is_training:
            N, D = x.shape
            mu = np.mean(x, axis=0)
            x_minus_mu = x - mu
            var = np.var(x, axis=0)
            std_inv = 1.0 / np.sqrt(var + self.eps)
            x_hat = x_minus_mu * std_inv
            out = self.gamma * x_hat + self.beta

            # 更新全局移动平均
            self.running_mean = self.momentum * self.running_mean + (1.0 - self.momentum) * mu
            self.running_var = self.momentum * self.running_var + (1.0 - self.momentum) * var

            self.cache = (x, x_minus_mu, var, std_inv, x_hat, N)
            return out
        else:
            # 推理阶段:完全独立于 mini-batch,使用预估的全局统计量
            x_hat = (x - self.running_mean) / np.sqrt(self.running_var + self.eps)
            return self.gamma * x_hat + self.beta

    def backward(self, dout):
        x, x_minus_mu, var, std_inv, x_hat, N = self.cache

        dgamma = np.sum(dout * x_hat, axis=0)
        dbeta = np.sum(dout, axis=0)

        dx_hat = dout * self.gamma
        dvar = np.sum(dx_hat * x_minus_mu * (-0.5) * (std_inv ** 3), axis=0)
        dmu = np.sum(dx_hat * (-std_inv), axis=0) + dvar * np.mean(-2.0 * x_minus_mu, axis=0)

        dx = dx_hat * std_inv + dvar * 2.0 * x_minus_mu / N + dmu / N
        return dx, dgamma, dbeta

if __name__ == "__main__":
    np.random.seed(42)
    bn = BatchNorm1D(dim=4)
    x_train = np.random.randn(32, 4) * 5.0 + 10.0
    out_train = bn.forward(x_train, is_training=True)
    print(f"训练输入均值: {np.round(np.mean(x_train, axis=0), 2)}, 方差: {np.round(np.var(x_train, axis=0), 2)}")
    print(f"BN 后输出均值: {np.round(np.mean(out_train, axis=0), 2)}, 方差: {np.round(np.var(out_train, axis=0), 2)}")

    dout = np.random.randn(32, 4)
    dx, dgamma, dbeta = bn.backward(dout)
    print(f"反向传播梯度 dx 形状: {dx.shape}, dgamma 均值: {np.mean(dgamma):.4f}")
print("前向与反向计算完成;梯度正确性仍需数值检查。")实际运行输出:
text
训练输入均值: [9.45 9.64 9.66 9.94], 方差: [10.74 25.19 27.72 25.23]
BN 后输出均值: [-0. -0.  0.  0.], 方差: [1. 1. 1. 1.]
反向传播梯度 dx 形状: (32, 4), dgamma 均值: 1.0943
前向与反向计算完成;梯度正确性仍需数值检查。代码导读:axis=0 跨样本求每列统计量;std_inv 是标准差的倒数;x_hat 是标准化激活;cache 保存反向计算所需的中间值。running_mean、running_var 用于推理,不能和当前批的 mu、var 混为一谈。随机 dout 只演示反向接口,不是完整模型的训练信号。
输出显示,输入各列的均值约为 10、方差在 10–28 之间,经过 BatchNorm 后各列均值为 0、方差为 1(此时 、)。注意本实现中的 momentum=0.9 表示旧统计量的保留比例;PyTorch 中 momentum=0.1 表示新统计量的权重,两者约定相反。此外,PyTorch 在更新 running_var 时使用无偏方差估计(除以 ),本实现使用有偏估计(除以 )。阅读或移植代码时要先核对这些约定。
对一列特征,设上游梯度 ,则:
令 ,训练模式下输入梯度可写为:
要得到式(46)的结果,必须同时考虑 对批均值和批方差的影响,不能把它们在反向时当作与 无关的常数。代码中的 dvar、dmu 分别沿这两条路径累计梯度。
重写任务:先只实现一列,再扩展到多列;固定上游梯度,令标量目标 ,用有限差分核对输入、、 的梯度。前向均值近零、方差近一,仅能检查前向行为,不能单独证明反向梯度正确。
这些方法处理训练中的数值传播。网络能稳定训练后,仍需要沿用第 0.4 节的办法检查过拟合;下面补充一种针对隐藏层的正则化方法。
0.6.5 Dropout:训练时随机屏蔽部分激活
前面用 L1、L2 限制权重大小。对含有隐藏层的网络,还可以在训练时随机屏蔽部分内部计算。Dropout [23] 将部分隐藏激活置零,使模型不能总依赖同一组内部单元。保留概率为 时,倒置 Dropout 写为:
给定激活 ,由式(47)有 。推理时关闭屏蔽,直接使用完整网络。不要把失活概率 与保留概率 混用。
python
rng = np.random.default_rng(42)
a = np.array([1.0, 2.0, 3.0, 4.0])
q = 0.8
mask = rng.random(a.shape) < q          # True 表示保留
training_a = mask * a / q
inference_a = a
print("mask:  ", mask)                   # [ True  True False  True]
print("训练时:", training_a)              # [1.25 2.5  0.   5.  ]
print("推理时:", inference_a) # [1. 2. 3. 4.]这次随机抽样屏蔽了第 3 个激活,其余激活除以 ,放大为原来的 1.25 倍。放大正是为了让训练时激活的期望与推理时一致:在多次随机屏蔽中平均,每个位置的期望值仍等于原激活。
每次使用了不同子网络,可借集成的直觉理解;一般非线性网络的完整推理不严格等于所有子网络的精确平均。Dropout 不适用于所有层和任务,预测能量、力等量时还需检查随机屏蔽与目标约束是否相容。
有了网络、优化和正则化的基本概念,可以用一个完整的合成实验检查:更灵活的模型在新样本上是否总会更好?
0.6.6 合成实验:复杂模型在新结构上一定更好吗
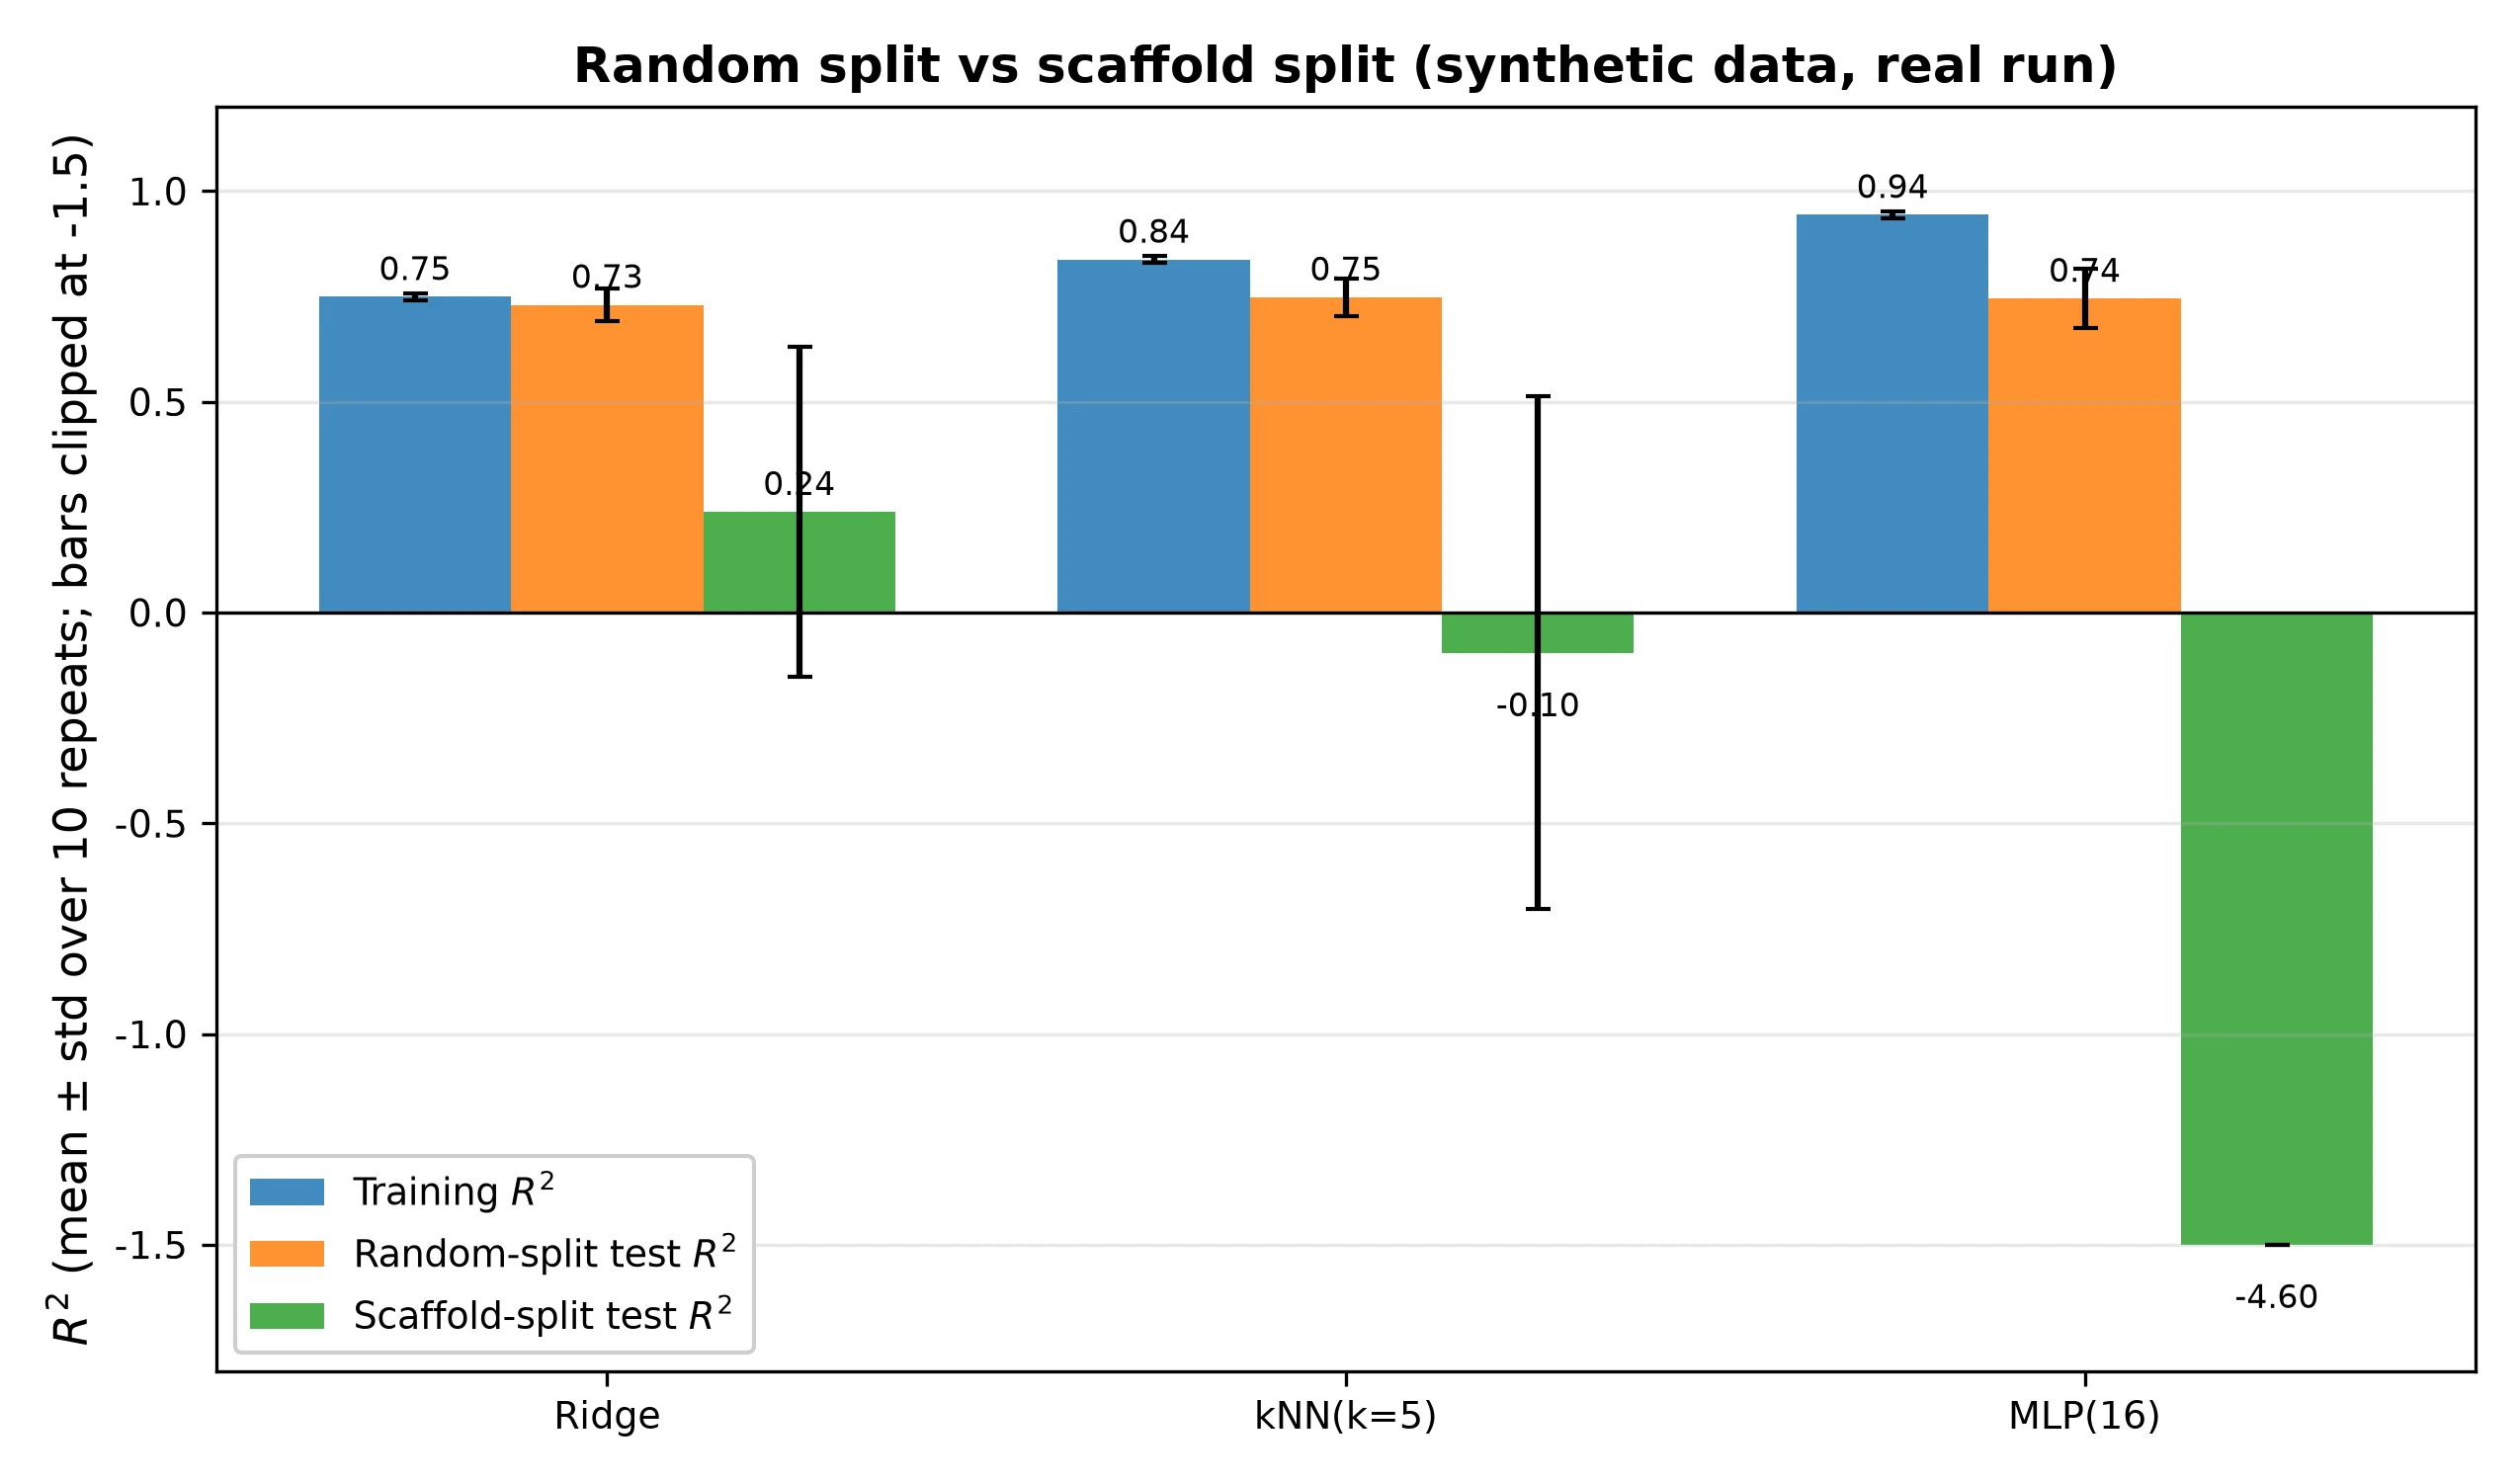
第 0.2.4 节已经比较了真实 ESOL 的两种划分。这里用合成数据固定生成规则,单独观察划分与模型的关系:构造十个样本簇,让同簇样本在特征空间中接近,再比较随机留出和整簇留出。
参与比较的模型有 Ridge、k 近邻(kNN)和单隐藏层多层感知器(MLP)。kNN 用相近训练样本的目标值作预测;MLP 使用第 0.6.1 节介绍的网络结构。
实验借用“骨架簇”作类比,簇编号由人为指定,没有从真实 SMILES 提取。第一轮先看结果与解释;第二轮再在独立会话中运行代码。
第二轮实验:比较随机留出与整簇留出
python
import numpy as np

def make_data(n=600, n_scaf=10, seed=42):
    """合成"骨架簇"数据:同一骨架的分子特征聚在一起(母核 + 小幅侧链扰动)。"""
    rng = np.random.default_rng(seed)
    scaf = np.repeat(np.arange(n_scaf), n // n_scaf)           # 每个样本的骨架编号
    centers = rng.normal(0, 3.0, (n_scaf, 10))                  # 各骨架的"母核"特征
    X = centers[scaf] + rng.normal(0, 0.5, (n, 10))             # 母核 + 侧链扰动
    w = rng.normal(size=10)
    y = np.sin(X @ w) * 2.0 + 0.3 * (X @ w) + rng.normal(0, 0.2, n)  # 非线性、非单调响应
    return X, y, scaf

def r2(y, p):
    return 1.0 - np.sum((y - p) ** 2) / np.sum((y - y.mean()) ** 2)

def fit_ridge(Xtr, ytr, lam=1.0):
    A = np.c_[Xtr, np.ones(len(Xtr))]                           # 加一列常数项
    reg = np.eye(A.shape[1])
    reg[-1, -1] = 0.0                                          # 不惩罚截距
    w = np.linalg.solve(A.T @ A + lam * reg, A.T @ ytr)
    return lambda X: np.c_[X, np.ones(len(X))] @ w

def fit_knn(Xtr, ytr, k=5):
    def predict(X):
        d = ((X[:, None, :] - Xtr[None, :, :]) ** 2).sum(-1)    # 到每个训练样本的距离平方
        idx = np.argsort(d, axis=1)[:, :k]                      # 最近的 k 个邻居
        return ytr[idx].mean(axis=1)
    return predict

def fit_mlp(Xtr, ytr, hidden=16, epochs=800, lr=0.01, seed=0):
    """单隐层 tanh 网络,全批量 Adam,手写反向传播。"""
    rng = np.random.default_rng(seed)
    mu, sd = Xtr.mean(0), Xtr.std(0) + 1e-8
    ym, ys = ytr.mean(), ytr.std()
    Xn, yn = (Xtr - mu) / sd, (ytr - ym) / ys
    W1 = rng.normal(0, np.sqrt(1 / Xn.shape[1]), (Xn.shape[1], hidden)); b1 = np.zeros(hidden)
    W2 = rng.normal(0, np.sqrt(1 / hidden), hidden); b2 = 0.0
    params = [W1, b1, W2, np.array(b2)]
    m = [np.zeros_like(p) for p in params]; v = [np.zeros_like(p) for p in params]
    for t in range(1, epochs + 1):
        H = np.tanh(Xn @ params[0] + params[1])
        pred = H @ params[2] + params[3]
        e = (pred - yn) / len(yn)                               # dL/dpred(L 为 MSE/2)
        gW2 = H.T @ e; gb2 = np.array(e.sum())
        dH = np.outer(e, params[2]) * (1 - H ** 2)
        gW1 = Xn.T @ dH; gb1 = dH.sum(0)
        for i, g in enumerate([gW1, gb1, gW2, gb2]):
            m[i] = 0.9 * m[i] + 0.1 * g
            v[i] = 0.999 * v[i] + 0.001 * g ** 2
            params[i] = params[i] - lr * (m[i] / (1 - 0.9 ** t)) / (np.sqrt(v[i] / (1 - 0.999 ** t)) + 1e-8)
    def predict(X):
        H = np.tanh(((X - mu) / sd) @ params[0] + params[1])
        return (H @ params[2] + params[3]) * ys + ym
    return predict

models = {"Ridge": fit_ridge, "kNN(k=5)": fit_knn, "MLP(16)": fit_mlp}
X, y, scaf = make_data()
n = len(y)
res = {k: {"train": [], "random": [], "scaffold": []} for k in models}
for rep in range(10):
    rng = np.random.default_rng(100 + rep)
    perm = rng.permutation(n)
    tr_r, te_r = perm[:int(0.8 * n)], perm[int(0.8 * n):]            # 随机划分
    held = rng.choice(10, size=2, replace=False)                     # 随机留出 2 个骨架
    te_s = np.where(np.isin(scaf, held))[0]; tr_s = np.where(~np.isin(scaf, held))[0]
    for name, fit in models.items():
        f = fit(X[tr_r], y[tr_r])
        res[name]["train"].append(r2(y[tr_r], f(X[tr_r]))); res[name]["random"].append(r2(y[te_r], f(X[te_r])))
        g = fit(X[tr_s], y[tr_s])
        res[name]["scaffold"].append(r2(y[te_s], g(X[te_s])))
print(f"{'model':10s} {'train R2':>14s} {'random-test R2':>16s} {'scaffold-test R2':>18s}")
for name, d in res.items():
    s = lambda a: f"{np.mean(a):6.3f}±{np.std(a):.3f}"
print(f"{name:10s} {s(d['train']):>14s} {s(d['random']):>16s} {s(d['scaffold']):>18s}")代码导读:scaf 保存人工组号;tr_r、te_r 是随机划分索引;held 指定完全留出的组。fit_knn 根据距离预测,fit_mlp 使用第 0.6.1 节的链式梯度和第 0.3 节的 Adam。MLP 的输入和目标缩放均只从训练数据计算。
实际运行输出,数值为十次划分的均值 ± 标准差(np.std 的默认约定),不是置信区间。train R2 是随机划分对应模型的训练分数;两类测试分数分别来自各自训练集上拟合的模型:
text
model            train R2   random-test R2   scaffold-test R2
Ridge         0.749±0.009      0.730±0.039        0.236±0.392
kNN(k=5)      0.837±0.009      0.748±0.045       -0.096±0.608
MLP(16) 0.943±0.008 0.745±0.071 -4.602±4.817对照输出和图 15:随机划分下,三种模型的测试 都在 0.73–0.75 之间。MLP 的训练 最高(0.94),测试结果却与 Ridge 接近。训练拟合得更好,在这里并没有转化成明显的测试优势。
改为整簇留出后,三种模型都变差了。kNN 需要借用训练近邻,但留出簇距离训练簇较远;MLP 的平均 低至 ,标准差达 4.8,说明某些划分上的预测严重偏离。Ridge 的线性假设与生成目标中的线性项 部分吻合,在这组设置下对新簇的预测相对稳健。
这个玩具比较采用固定设置,不做完整的验证调参。它说明这些设置下模型对新簇可能失败,不能据此断言模型越复杂必然越差。 表示平方误差比使用测试标签均值作为参考更大;可部署的均值基线应使用训练标签均值,而不是事先知道测试均值。
第一轮练习:明确真实 ESOL 结果和人工簇结果各自回答了什么。第二轮练习:重写 MLP,核对梯度;在训练数据内部加入验证集和早停,再比较结果,不能根据测试分数直接调参。
这个实验也把前面的几条线索接了起来:表达能力、训练误差和新结构上的效果,需要分别检查。最后,我们回到输入本身,看看除了六个固定描述符,还能怎样表示分子。
0.7 让模型学习怎样表示分子
0.7.1 从六个描述符到可学习的向量
前面的误差分析提醒我们,模型只能利用输入中提供的信息。六个描述符便于解释,但不同结构可能得到相近的数值。除了手工选择描述符,还可以让模型从原子、键或 SMILES 单元的关系中学习用于预测的表示。
这里的“表示”可以先理解为:用一组数记录某个原子、子结构或分子。后续的分子图与序列模型会详细介绍怎样从结构算出这些数;本节先从最简单的类别编码开始。
把碳、氮、氧编码为独热向量,例如 、、,可以清楚表示类别。“独热”指只有代表当前类别的位置为 1,其余位置为 0。任意两个不同类别的编码距离相同;类别之间的关系可以由后续模型学习。
如果希望表示本身也能调整,就可以给每个类别分配一组可训练的数,称为嵌入向量。把所有类别的向量排成表,就是嵌入矩阵。若 有 行、 列,类别编号为 ,则:
式(48)与独热向量乘矩阵等价。代码中直接按编号取一行,像查表一样;训练时,被使用的行也会接收梯度。
“距离近”究竟意味着结构相似、活性相近还是经常一起出现,取决于训练目标。要赋予向量距离化学含义,需要结合数据、训练目标和独立验证。
因此,定义向量只是第一步,还要规定怎样训练它。下面看两个例子:从共同出现的关系学习,以及直接规定样本之间的相似关系。
0.7.2 从共同出现的子结构学习表示
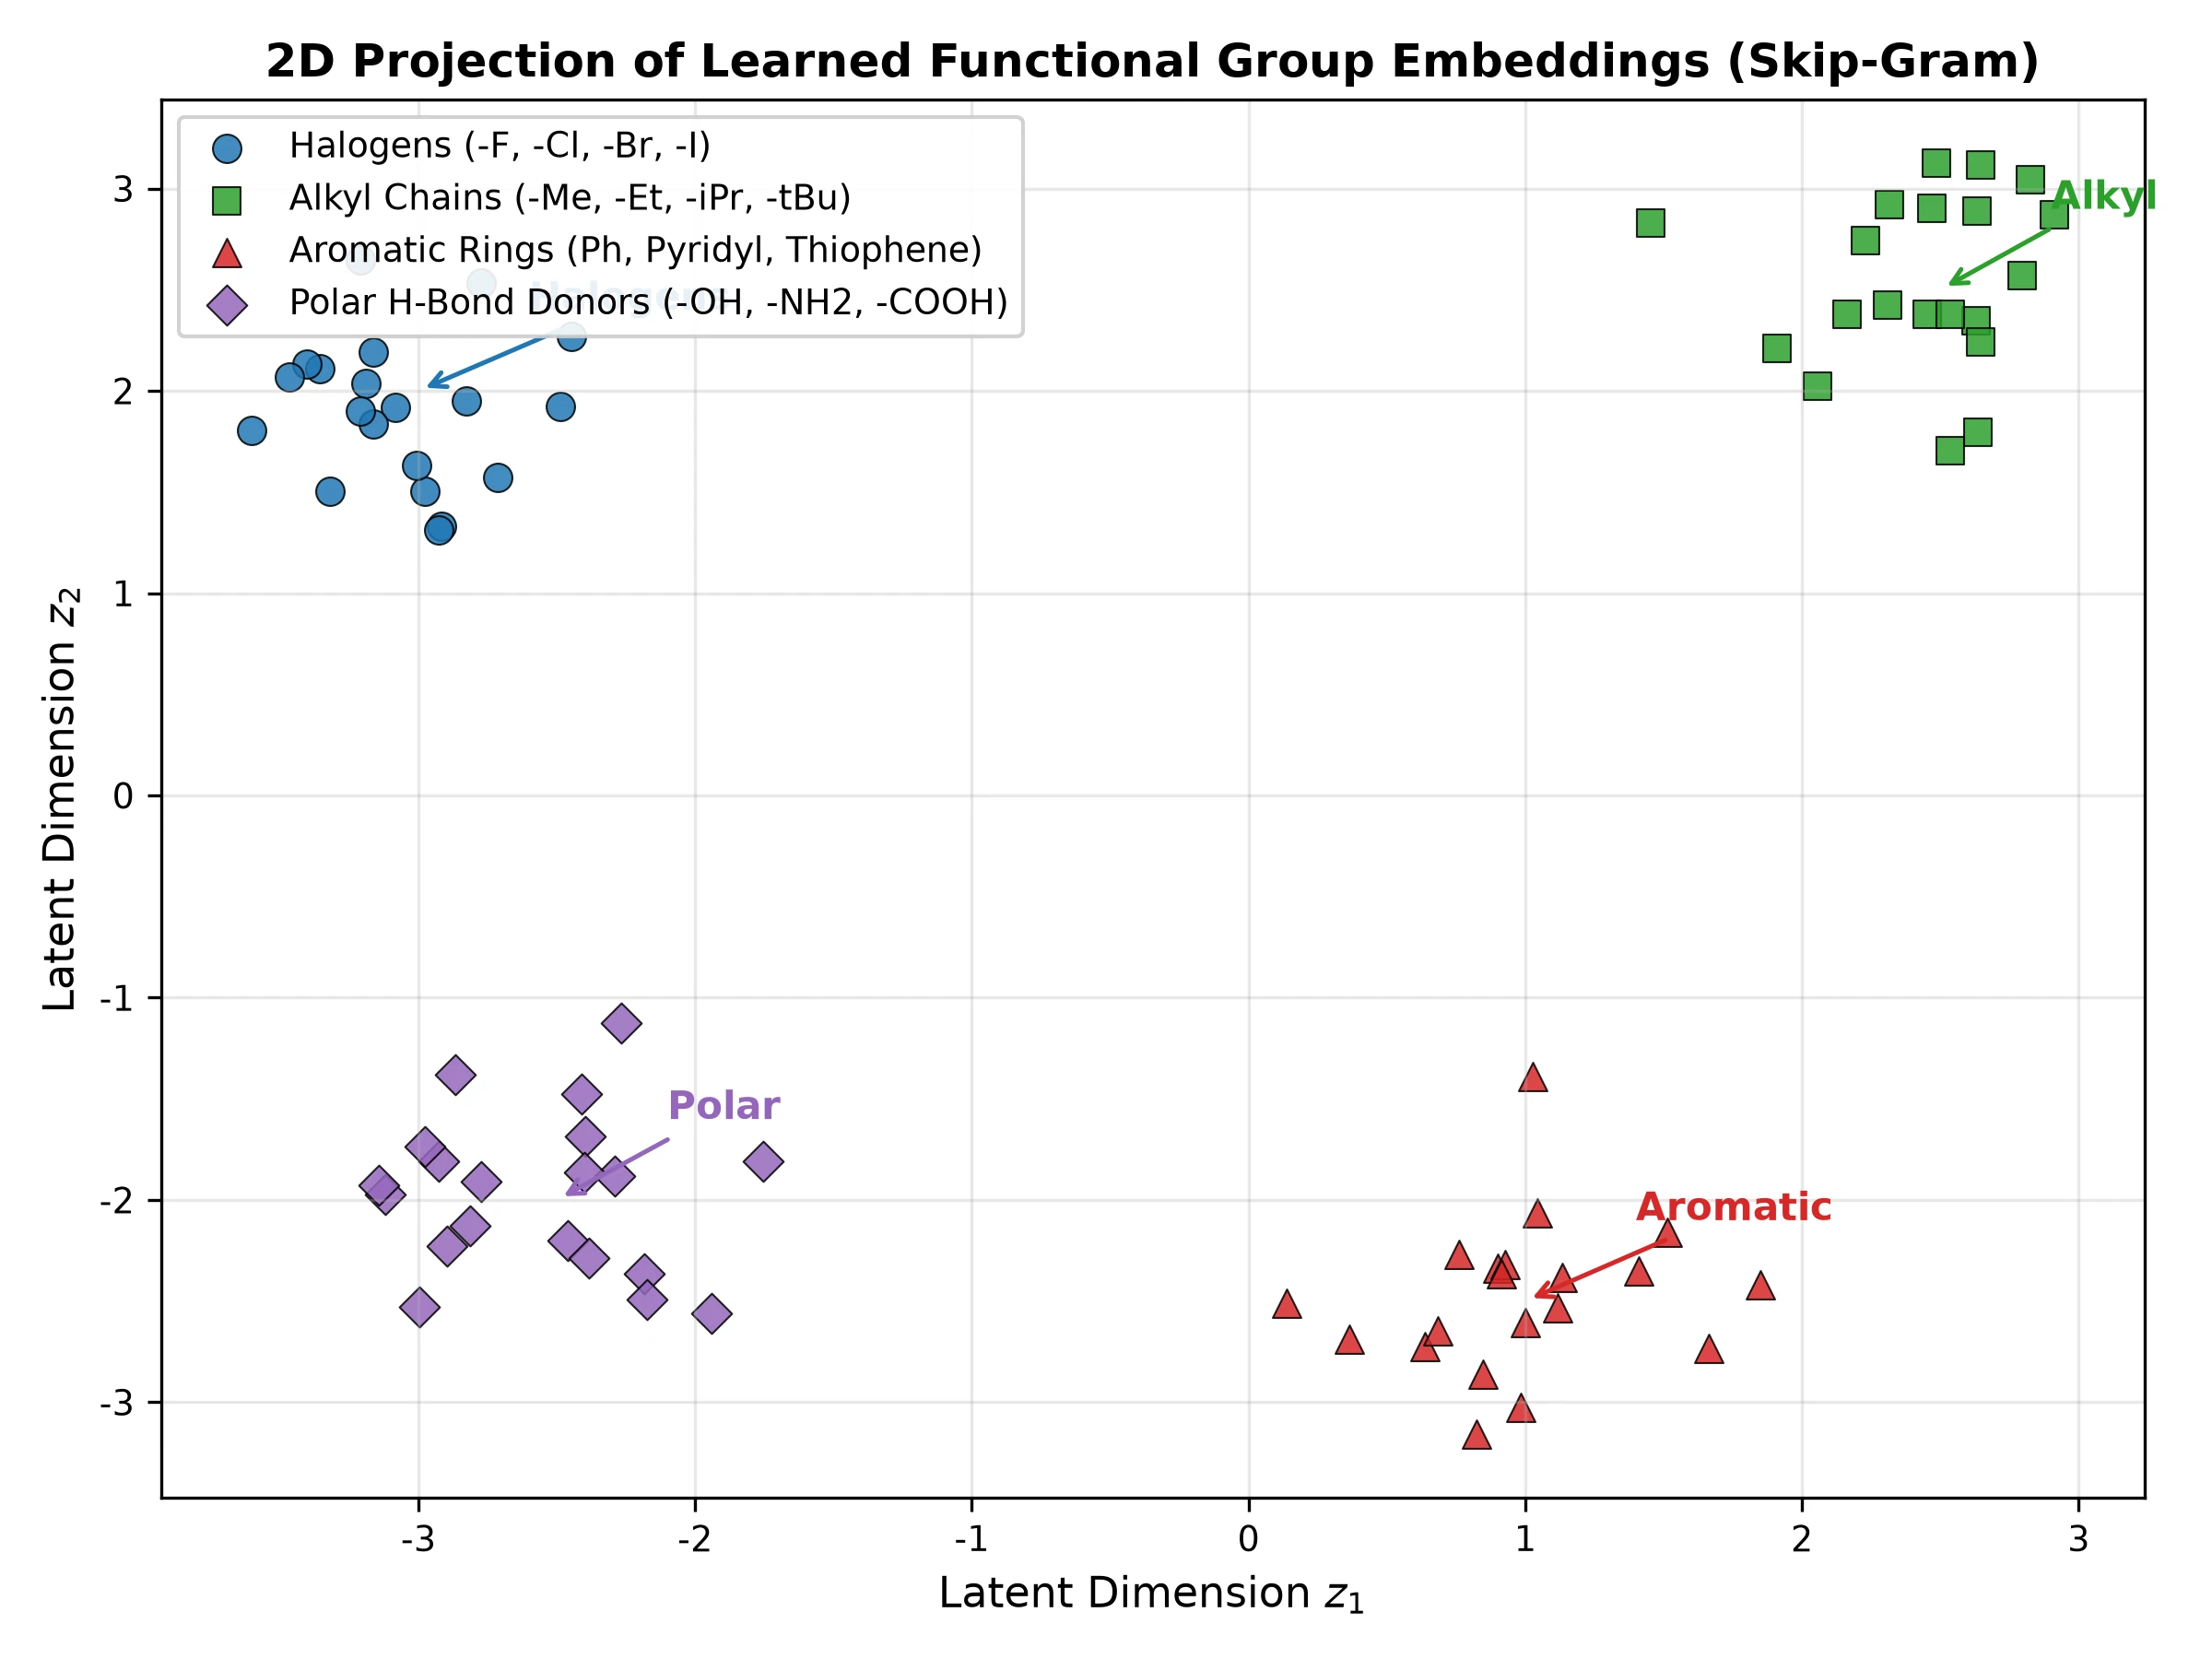
Skip-Gram 最初用于自然语言 [24]:用一个词预测其上下文中的词,从共同出现的关系中学习词向量。Mol2Vec [25] 把这一思路搬到分子上:把 Morgan 算法得到的分子子结构当作“词”、把分子当作“句子”,学习子结构的向量表示。这里“附近”由构造子结构序列及上下文的规则决定。记中心单元的向量为 ,上下文单元的向量为 。
可以把训练问题理解成一个判断题:这两个子结构,是否来自按上下文规则构造的共现样本对?训练时提高这类样本对的得分,同时降低随机抽取的对照样本对的得分。后者称为负采样。
这样就有了调整向量的目标。但“负样本”只表示它由抽样规则选出,并不保证它与中心子结构在化学上不相容;“共同出现”也需要由子结构序列和上下文规则明确规定。
第二轮理解:负采样目标与计算量
遍历全部词汇计算 Softmax 的开销随词汇数量增加。负采样改用一个在数据中共同出现的正样本对,以及 个按指定分布抽取的负样本对(word2vec 中常用词频的 3/4 次方作为抽样分布),优化:
式(49)的第一项鼓励正样本对得分高,第二项鼓励采样得到的负样本对得分低。这是替代完整 Softmax 的训练目标,两者并不严格等价。这里的“负样本”由抽样规则定义,其中也可能包含实际会共同出现的子结构。
每步需要 次 维点积,计算量约为 ;完整 Softmax 则需要与全部 个词计算,约为 。 通常只取 5–20,而词汇量 可达数万,节省十分可观。
训练成功后,我们期望经常出现在相似化学环境中的子结构,其向量也彼此接近。图 16 用一个概念示意说明这种期望。
0.7.3 三元组损失:规定什么应该更接近
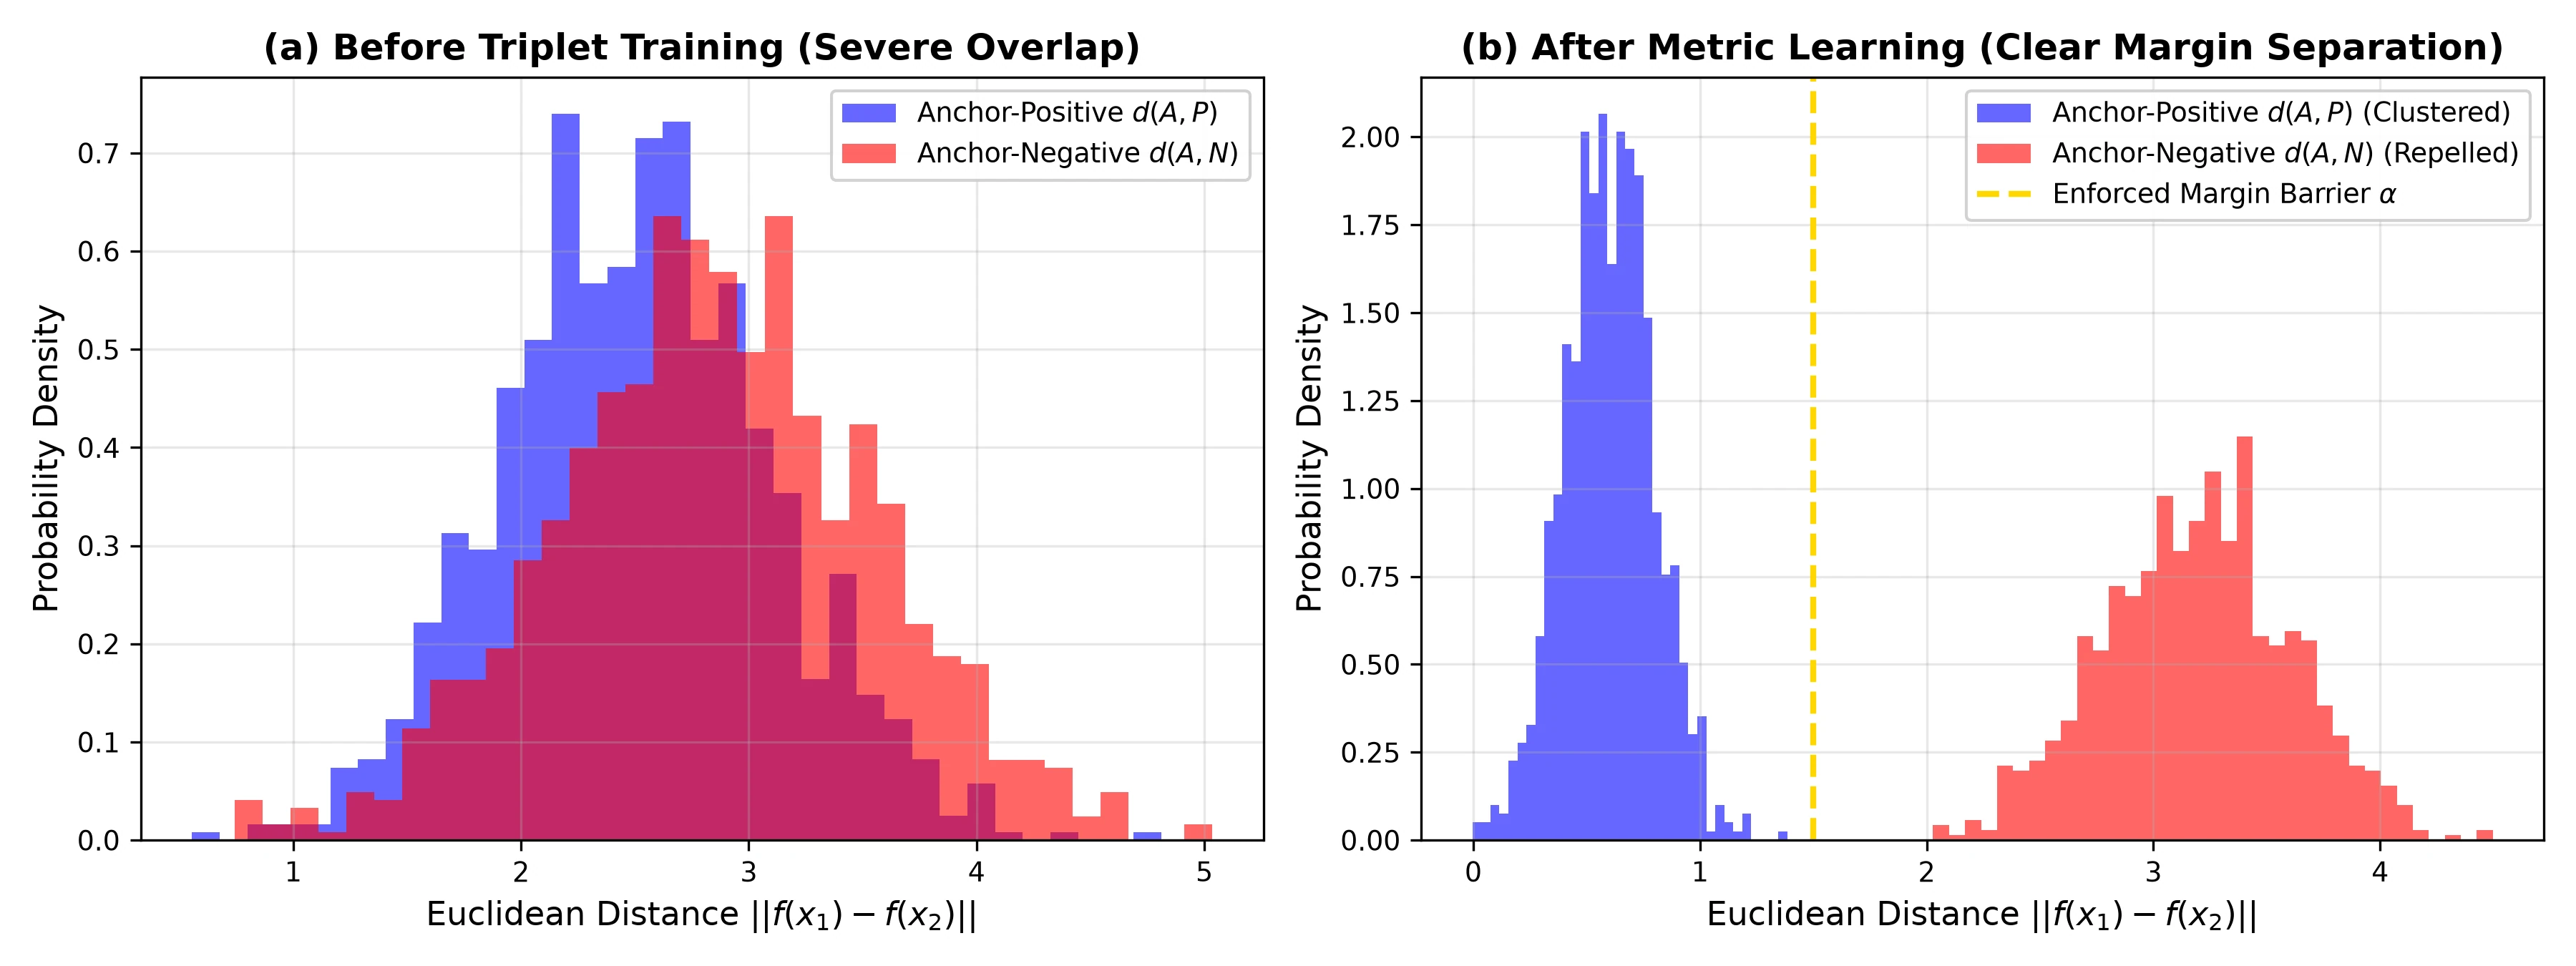
刚才的训练目标利用共现关系。如果任务需要的相似性已经有明确标签,还可以直接把这种关系放进损失函数。如果希望用向量距离检索相似分子,就需要让距离符合任务中的相似性定义,这类方法称为度量学习。取一个参照分子作为锚点 ,另选相似的正样本 和不相似的负样本 ,三元组损失 [26] 要求正样本比负样本更接近锚点:
负样本挖掘
3 类 × 24 个分子 · 6 维特征
三元组损失6.637
违反间隔的三元组47%
1-NN 检索准确率58%
训练步数0/ 300
二维嵌入空间嵌入 f(x)=Wx,‖W‖ 固定
a–p a–n 间隔圈
是三个样本的向量表示, 是间隔。记距离平方为 、,由式(50),损失为零的条件是 。
手算一个例子:、、 时,损失为 。负样本虽然比正样本远,但没有远出间隔 ,所以仍有损失。后面的实验会复现这个数值。
这里“相似”必须先由研究任务定义。同活性不一定代表同结构,异构体也不一定是负样本。可以按目标性质差、结构关系或实验标签构造样本,但要检查定义是否符合检索用途。
图 17 从整体分布的角度示意了度量学习想达到的效果。
下面的实验演示负采样的一次更新,以及两组三元组的损失计算。三元组使用人为指定的二维向量,尚未训练把分子转换成向量的模型,因此这里只观察损失,不观察分子表示的学习效果。
第二轮实验:计算负采样与三元组损失
python
import numpy as np

def sigmoid(x):
    return 1.0 / (1.0 + np.exp(-np.clip(x, -15, 15)))

class SkipGramToy:
    def __init__(self, vocab_size=50, embed_dim=16, lr=0.05):
        self.V = vocab_size
        self.D = embed_dim
        self.lr = lr
        # 中心词矩阵与上下文词矩阵
        self.W_in = np.random.randn(self.V, self.D) * 0.1
        self.W_out = np.random.randn(self.V, self.D) * 0.1

    def train_step(self, center_id, context_id, negative_ids):
        v_c = self.W_in[center_id]

        # 1. 正样本梯度
        u_pos = self.W_out[context_id]
        score_pos = sigmoid(np.dot(u_pos, v_c))
        grad_pos = score_pos - 1.0  # dL / d(u_pos^T v_c)

        # 2. 负样本梯度
        u_negs = self.W_out[negative_ids]
        scores_neg = sigmoid(np.dot(u_negs, v_c))
        grad_negs = scores_neg  # dL / d(u_neg^T v_c)

        # 累积对中心词的梯度
        grad_vc = grad_pos * u_pos + np.sum(grad_negs[:, None] * u_negs, axis=0)

        # 更新上下文词向量
        self.W_out[context_id] -= self.lr * grad_pos * v_c
        np.add.at(self.W_out, negative_ids, -self.lr * grad_negs[:, None] * v_c)

        # 更新中心词向量
        self.W_in[center_id] -= self.lr * grad_vc

        # 返回的是本次更新之前的损失
        loss = -np.log(score_pos + 1e-10) - np.sum(np.log(1.0 - scores_neg + 1e-10))
        return loss

class TripletMetricToy:
    def __init__(self, margin=0.5):
        self.margin = margin

    def compute_loss(self, anchor, positive, negative):
        d_ap = np.sum((anchor - positive)**2, axis=-1)
        d_an = np.sum((anchor - negative)**2, axis=-1)
        loss = np.maximum(0.0, d_ap - d_an + self.margin)
        return loss, d_ap, d_an

if __name__ == "__main__":
    print(">>> 正在测试 Skip-Gram 负采样与三元组度量学习机制...")
    np.random.seed(0)                                  # 固定随机种子,保证输出可复现
    sg = SkipGramToy(vocab_size=20, embed_dim=8)
    loss = sg.train_step(center_id=2, context_id=3, negative_ids=[5, 8, 12, 16])
    print(f"Skip-gram 单步负采样损失: {loss:.4f}")

    triplet = TripletMetricToy(margin=1.0)
    a = np.array([1.0, 0.5])
    p = np.array([0.9, 0.6])  # 人为指定的正样本向量
    n_easy = np.array([5.0, 5.0])  # 易负样本
    n_hard = np.array([1.1, 0.7])  # 与锚点较近、未满足间隔的负样本向量

    loss_easy, dap, dan_easy = triplet.compute_loss(a, p, n_easy)
    loss_hard, dap, dan_hard = triplet.compute_loss(a, p, n_hard)

    print(f"正样本对距离平方 d²(A, P): {dap:.4f}")
    print(f"易负样本对距离平方 d²(A, N_easy): {dan_easy:.4f} -> 损失: {loss_easy:.4f} (已满足间隔)")
print(f"难负样本对距离平方 d²(A, N_hard): {dan_hard:.4f} -> 损失: {loss_hard:.4f} (未满足间隔;本例未执行三元组梯度更新)")W_in、W_out 是两张不同的嵌入表;grad_vc 累计中心向量从正对与负对收到的梯度。示例中负编号不同,真实随机采样可能重复,因此更新用 np.add.at 累加,避免高级索引遗漏重复项。
实际运行输出:
text
>>> 正在测试 Skip-Gram 负采样与三元组度量学习机制...
Skip-gram 单步负采样损失: 3.3993
正样本对距离平方 d²(A, P): 0.0200
易负样本对距离平方 d²(A, N_easy): 36.2500 -> 损失: 0.0000 (已满足间隔)
难负样本对距离平方 d²(A, N_hard): 0.0500 -> 损失: 0.9700 (未满足间隔;本例未执行三元组梯度更新)Skip-Gram 的损失 3.3993 在更新前计算。初始向量很小,点积接近 0,;一个正样本和四个负样本共有 5 项,每项约为 ,合计约 3.47,与输出的 3.40 接近。这个数值对应的是刚初始化、尚未学习的状态。
三元组部分复现了前面的手算:易负样本的距离平方为 36.25,超过 ,损失为 0;另一个负样本的距离平方只有 0.05,仍未满足间隔,损失为 0.97。
第二轮推导:负采样与三元组损失的梯度
正样本对评分 的损失 满足 ;负样本对的损失 满足 。再用 、,得到代码中的更新。
三元组间隔违反时,关于三组向量的梯度为:
间隔满足时,式(51)的梯度为零,边界处不可导,可以选择子梯度。真实模型还要把这些梯度通过编码器回传到共享参数。
重写任务:先在二维向量上实现一次梯度更新,打印更新前后正负样本的距离平方与损失;再增加共享编码器,即用同一个模型把不同样本转换成向量。困难负样本可帮助学习,但也更容易包含标签错误或本应相似的“假负样本”,需要检验采样规则。
这些方法为后续图网络、Transformer 与预训练模型提供基础。学到的表示是否优于人工描述符,仍要按第 0.2 节的评估思路,在同样的任务与合理划分下比较。表示学习也不能自动补回未记录的 pH、温度等实验条件;哪些信息由结构提供,哪些需要额外输入,要根据研究问题判断。
0.8 回看这次预测,再进入后续章节
回看 ESOL 案例,最先决定的是预测目标与输入信息,随后才是模型。我们把结构变成六列描述符,用线性回归建立基线,再结合 MAE、具体错例和骨架划分判断预测能支持什么样的结论。
这条主线也说明,模型误差较大时,下一步可能是核查标签与描述符、补充实验条件、改善训练,或增加模型表达能力。先找出错误发生在哪里,才更容易决定该做哪一种改动。
可以尝试不看正文回答五个问题:特征与标签各是什么?训练误差低为什么仍不够?标准化统计量从哪里来?验证集与测试集分别做什么?模型表现不好时,怎样提出一个可以检验的改进?
后续章节继续展开:
- 第 01–03 章:感知器、线性单元、多层网络与反向传播,补足计算图和链式求导。
- 第 04–07 章:CNN、RNN、LSTM 等结构,讨论谱图、空间数据和轨迹的处理方式。
- 第 08–10 章:GNN、等变网络与 Transformer,学习结构关系、几何约束和注意力。
- 第 11–17 章:自回归、VAE、归一化流、GAN、能量模型、扩散模型与逆向设计。
学过反向传播后,再回到折叠内容中完成独立实现。
表 11 第二轮学习任务。先不看正文完成,再用右列的方法核对。
| 返回位置 | 独立完成的任务 | 怎样核对 |
|---|---|---|
| 0.2.1、0.3.1、0.5.1 | 推导线性与逻辑回归梯度,重写训练 | 有限差分;线性模型再对照最小二乘解 |
| 0.3.4–0.3.5 | 重写 Momentum、RMSprop、Adam、AdamW | 固定起点,比较每一步更新 |
| 0.6.1、0.6.6 | 推导并重写单隐藏层 MLP | 核对数组形状和参数梯度 |
| 0.6.3 | 推导初始化尺度 | 区分方差与二阶矩,检查传播结果 |
| 0.6.4 | 重写 BatchNorm 前向与反向 | 核对输入、缩放和平移的有限差分 |
| 0.4.2–0.4.3 | 推导 Ridge 与软阈值更新 | 确认损失的归一化约定 |
| 0.5.3、0.7.3 | 重写曲线累计、负采样和三元组更新 | 用小样本手算中间值与梯度 |
参考文献
[1] Delaney J S. ESOL: Estimating aqueous solubility directly from molecular structure. Journal of Chemical Information and Computer Sciences 44(3): 1000–1005, 2004. doi:10.1021/ci034243x.
[2] Wu Z, Ramsundar B, Feinberg E N, et al. MoleculeNet: A benchmark for molecular machine learning. Chemical Science 9: 513–530, 2018. 公开全文。
[3] Wolpert D H. The lack of a priori distinctions between learning algorithms. Neural Computation 8(7): 1341–1390, 1996.
[4] Shalev-Shwartz S, Ben-David S. Understanding Machine Learning: From Theory to Algorithms. Cambridge University Press, 2014.
[5] Mohri M, Rostamizadeh A, Talwalkar A. Foundations of Machine Learning. 2nd ed. MIT Press, 2018.
[6] Wildman S A, Crippen G M. Prediction of physicochemical parameters by atomic contributions. Journal of Chemical Information and Computer Sciences 39(5): 868–873, 1999.
[7] Ran Y, Yalkowsky S H. Prediction of drug solubility by the general solubility equation (GSE). Journal of Chemical Information and Computer Sciences 41(2): 354–357, 2001.
[8] Bemis G W, Murcko M A. The properties of known drugs. 1. Molecular frameworks. Journal of Medicinal Chemistry 39(15): 2887–2893, 1996.
[9] Keskar N S, Mudigere D, Nocedal J, et al. On large-batch training for deep learning: Generalization gap and sharp minima. ICLR, 2017. arXiv:1609.04836.
[10] Tieleman T, Hinton G. Lecture 6.5 — RMSprop. Neural Networks for Machine Learning, 2012.
[11] Kingma D P, Ba J. Adam: A method for stochastic optimization. ICLR, 2015. arXiv:1412.6980.
[12] Loshchilov I, Hutter F. Decoupled weight decay regularization. ICLR, 2019. arXiv:1711.05101.
[13] Bergstra J, Bengio Y. Random search for hyper-parameter optimization. JMLR 13: 281–305, 2012.
[14] Belkin M, Hsu D, Ma S, Mandal S. Reconciling modern machine-learning practice and the classical bias–variance trade-off. PNAS 116(32): 15849–15854, 2019. doi:10.1073/pnas.1903070116.
[15] Hoerl A E, Kennard R W. Ridge regression: Biased estimation for nonorthogonal problems. Technometrics 12(1): 55–67, 1970.
[16] Tibshirani R. Regression shrinkage and selection via the lasso. JRSS B 58(1): 267–288, 1996.
[17] Saito T, Rehmsmeier M. The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets. PLoS ONE 10(3): e0118432, 2015. doi:10.1371/journal.pone.0118432.
[18] Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press, 2016.
[19] Glorot X, Bengio Y. Understanding the difficulty of training deep feedforward neural networks. AISTATS, PMLR 9: 249–256, 2010.
[20] He K, Zhang X, Ren S, Sun J. Delving deep into rectifiers: Surpassing human-level performance on ImageNet classification. ICCV, 1026–1034, 2015. doi:10.1109/ICCV.2015.123.
[21] Ioffe S, Szegedy C. Batch normalization: Accelerating deep network training by reducing internal covariate shift. ICML, PMLR 37: 448–456, 2015.
[22] Santurkar S, Tsipras D, Ilyas A, Madry A. How does batch normalization help optimization? NeurIPS 31, 2018. arXiv:1805.11604.
[23] Srivastava N, Hinton G, Krizhevsky A, et al. Dropout: A simple way to prevent neural networks from overfitting. JMLR 15: 1929–1958, 2014.
[24] Mikolov T, Sutskever I, Chen K, et al. Distributed representations of words and phrases and their compositionality. NeurIPS 26, 2013. arXiv:1310.4546.
[25] Jaeger S, Fulle S, Turk S. Mol2vec: Unsupervised machine learning approach with chemical intuition. Journal of Chemical Information and Modeling 58(1): 27–35, 2018.
[26] Schroff F, Kalenichenko D, Philbin J. FaceNet: A unified embedding for face recognition and clustering. CVPR, 815–823, 2015.