Appearance
第 03 章 神经网络与反向传播
3.0 本章导读
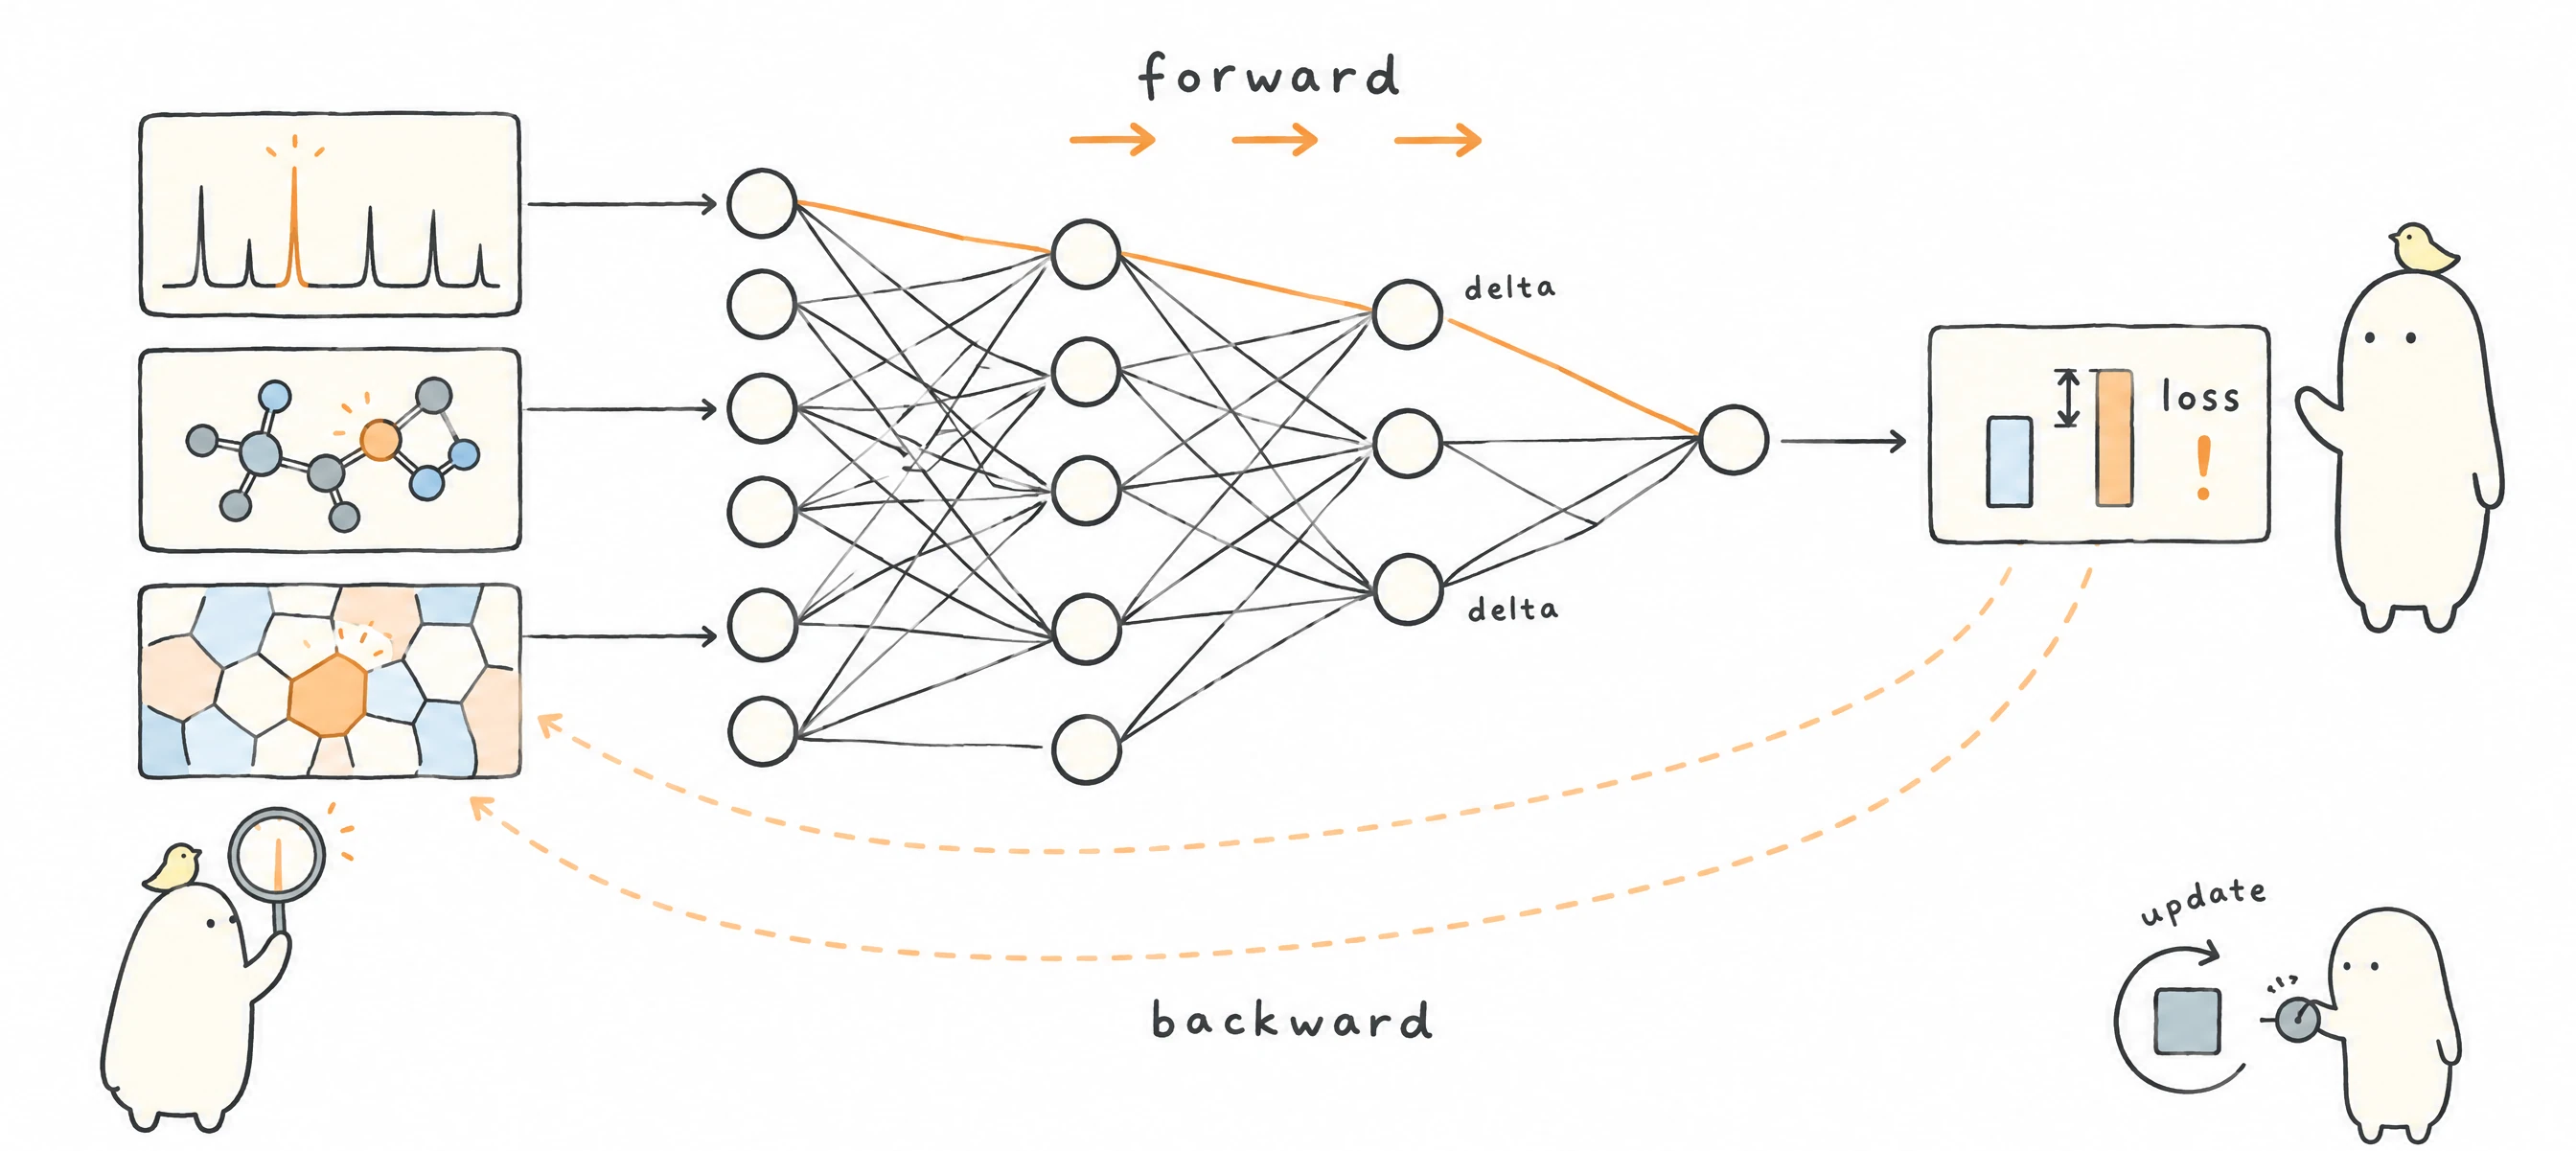
上一章中,我们通过调整权重和偏置,让线性单元尽量贴近数据。遇到弯曲的关系时,还可以先变换变量。例如,Arrhenius 图用 和速率常数的对数,把原来的关系变成近似直线。
这种做法需要我们事先知道该怎样变换。面对多个分子描述符时,哪些变量应该组合、怎样组合,往往没有现成答案。本章介绍的多层神经网络,会在输入与预测之间加入几层可调的计算,让模型在拟合数据的同时学习这些组合。
我们先看这些计算怎样产生一个预测,再讨论预测不准时,各层参数应该怎样调整。上一章的“预测、计算损失、求梯度、更新参数”仍然适用,只是现在要求导的计算步骤更多了。
3.0.1 从一个熟悉的拟合问题出发
假设我们有一组原子间距 和对应的相互作用能 ,想拟合一条能量曲线。如果直接把 输入线性单元,预测只能是
调整 和 ,只能改变直线的斜率和截距。对于 Lennard-Jones 势那样既有短程排斥、又有势阱的曲线,一条直线无法在整个区间内贴合它。这个例子会在第 3.8.2 节真正运行;眼下先用它理解我们希望模型多做什么。
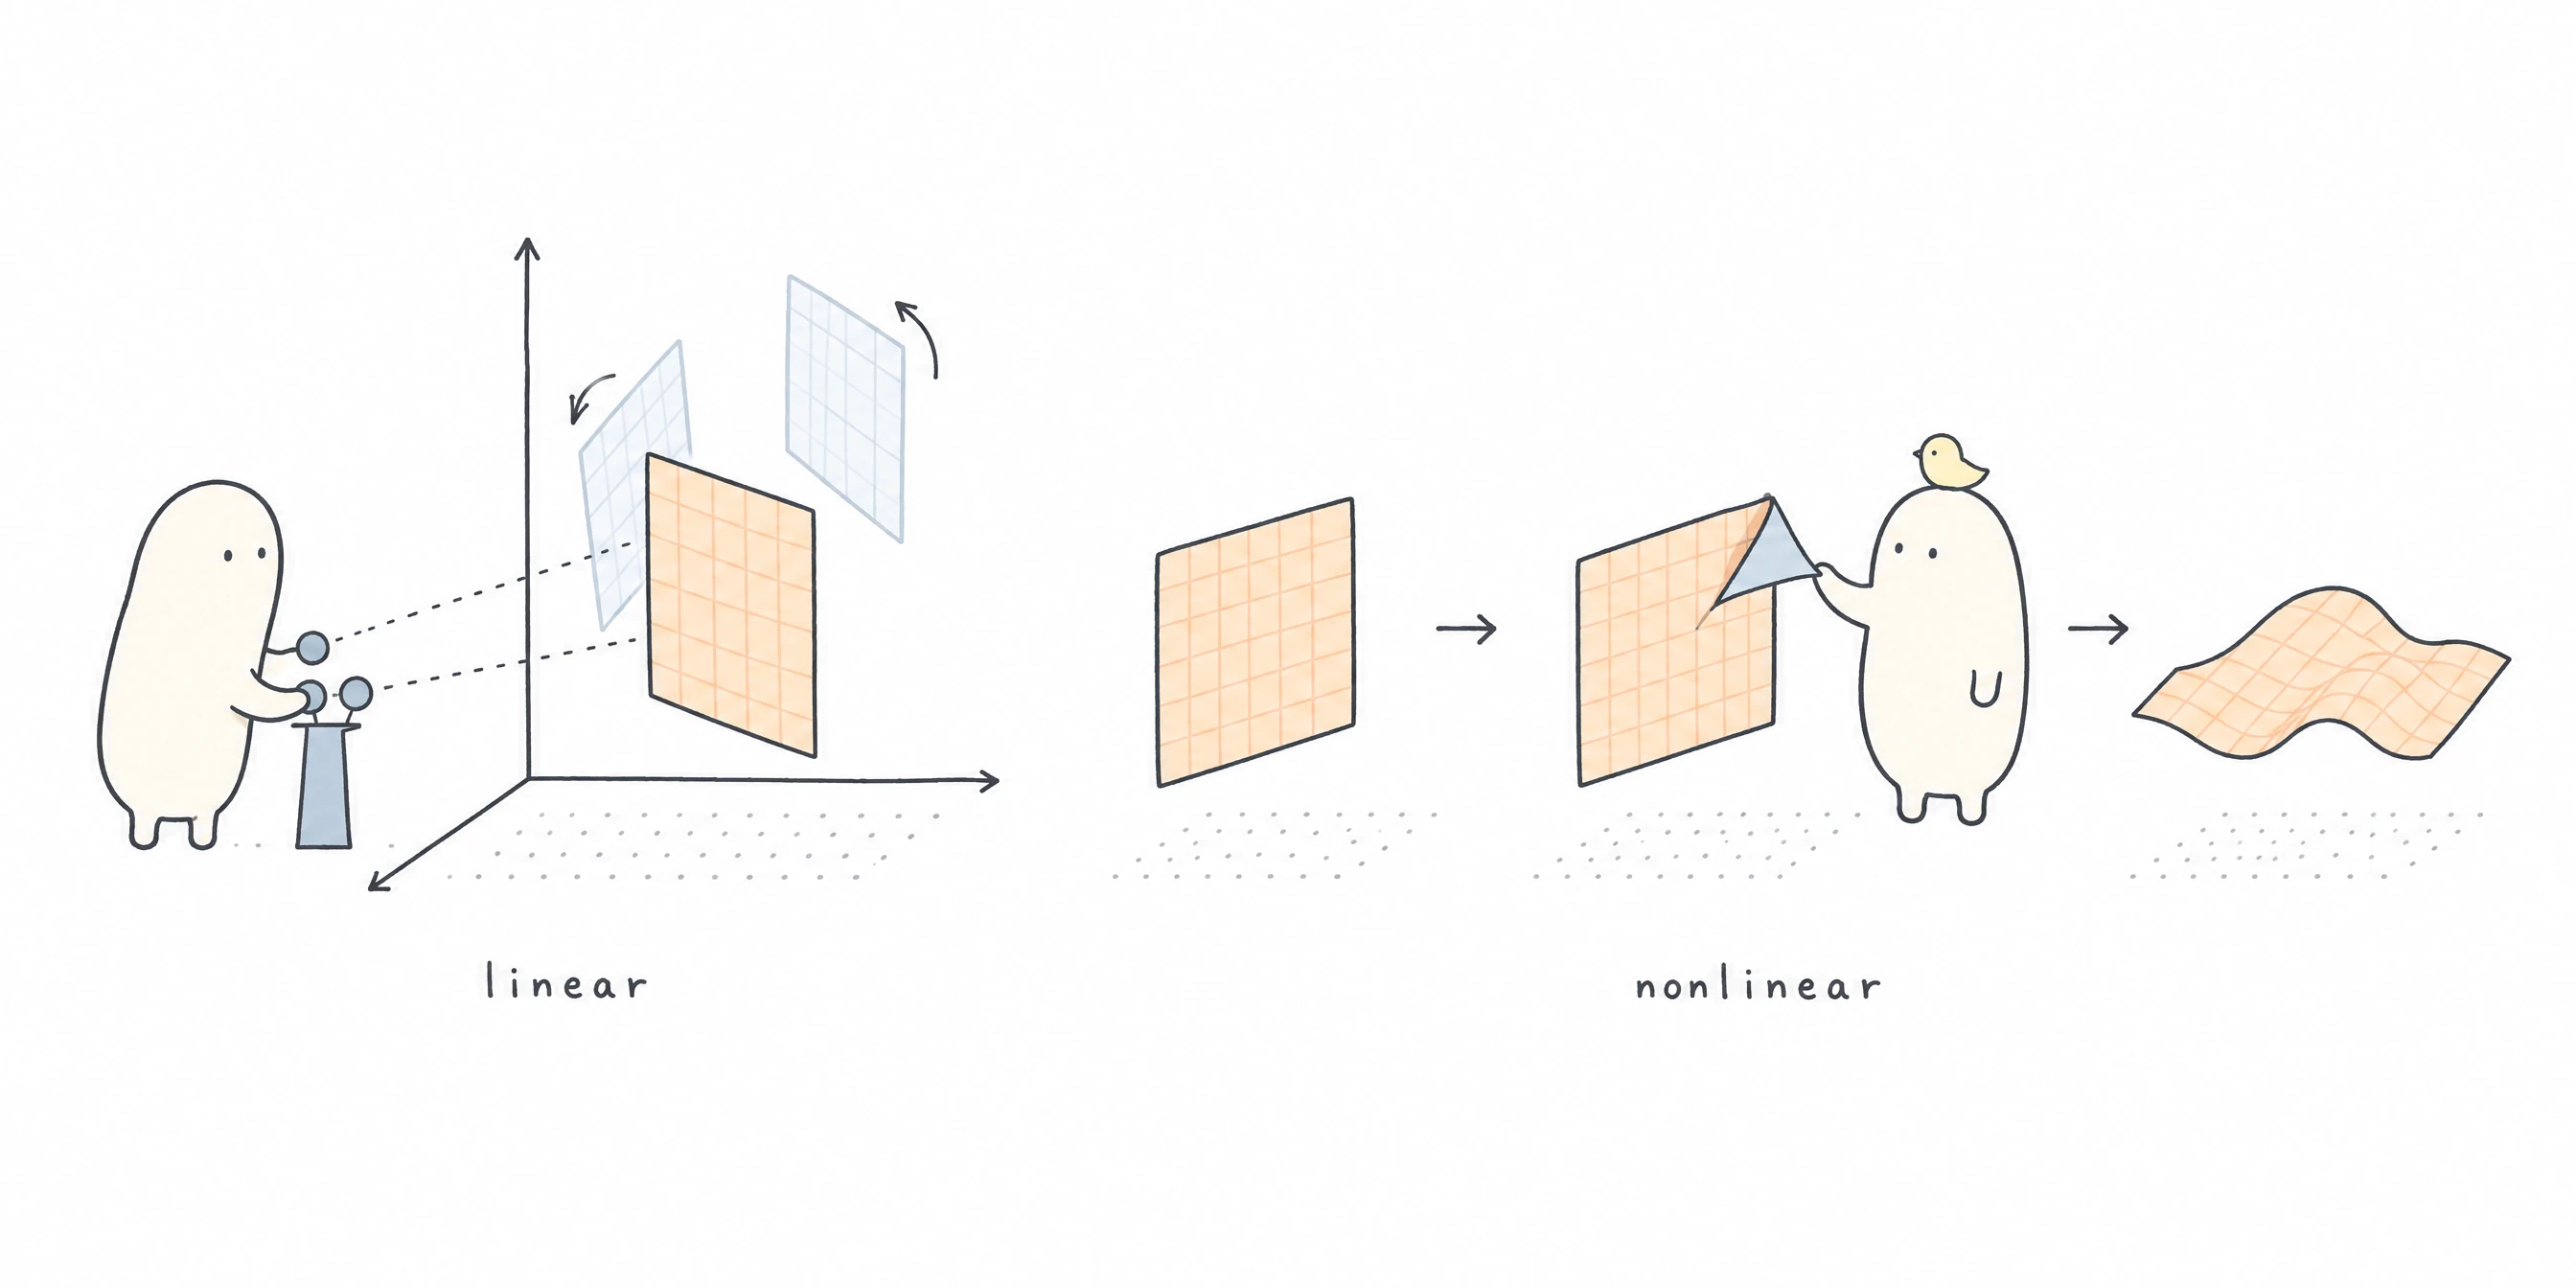
对于已知解析式的问题,直接使用解析式当然更方便。这里拟合已知曲线,是为了能逐点检查网络有没有学对,并观察它在数据范围以外会怎样预测。之后再把同样的方法用于分子溶解度数据。
3.0.2 怎样阅读这一章
第一次阅读,重点是能解释并完成以下四件事:
- 说明隐藏层和非线性函数各自做了什么,跟着一个小网络算出预测值。
- 区分预测残差、损失和梯度,理解隐藏层没有参考答案时怎样求导。
- 用算出的梯度完成一次参数更新,并运行对应的 Python 程序。
- 分别检查训练数据、新样本和训练范围以外的预测,理解能量准确与受力准确是两个要求。
第 3.1—3.5 节先用标量和具体数字讲清一次训练,第 3.6 节再把它写成多层网络通用的矩阵形式。第 3.7 节运行程序,第 3.8 节讨论三个科学案例。严格的数学表述集中在附录 A,数值计算、实现细节和延伸知识放在附录 B。完整程序见配套代码说明。
3.1 从线性单元到神经元
3.1.1 先加权求和,再做一次非线性变换
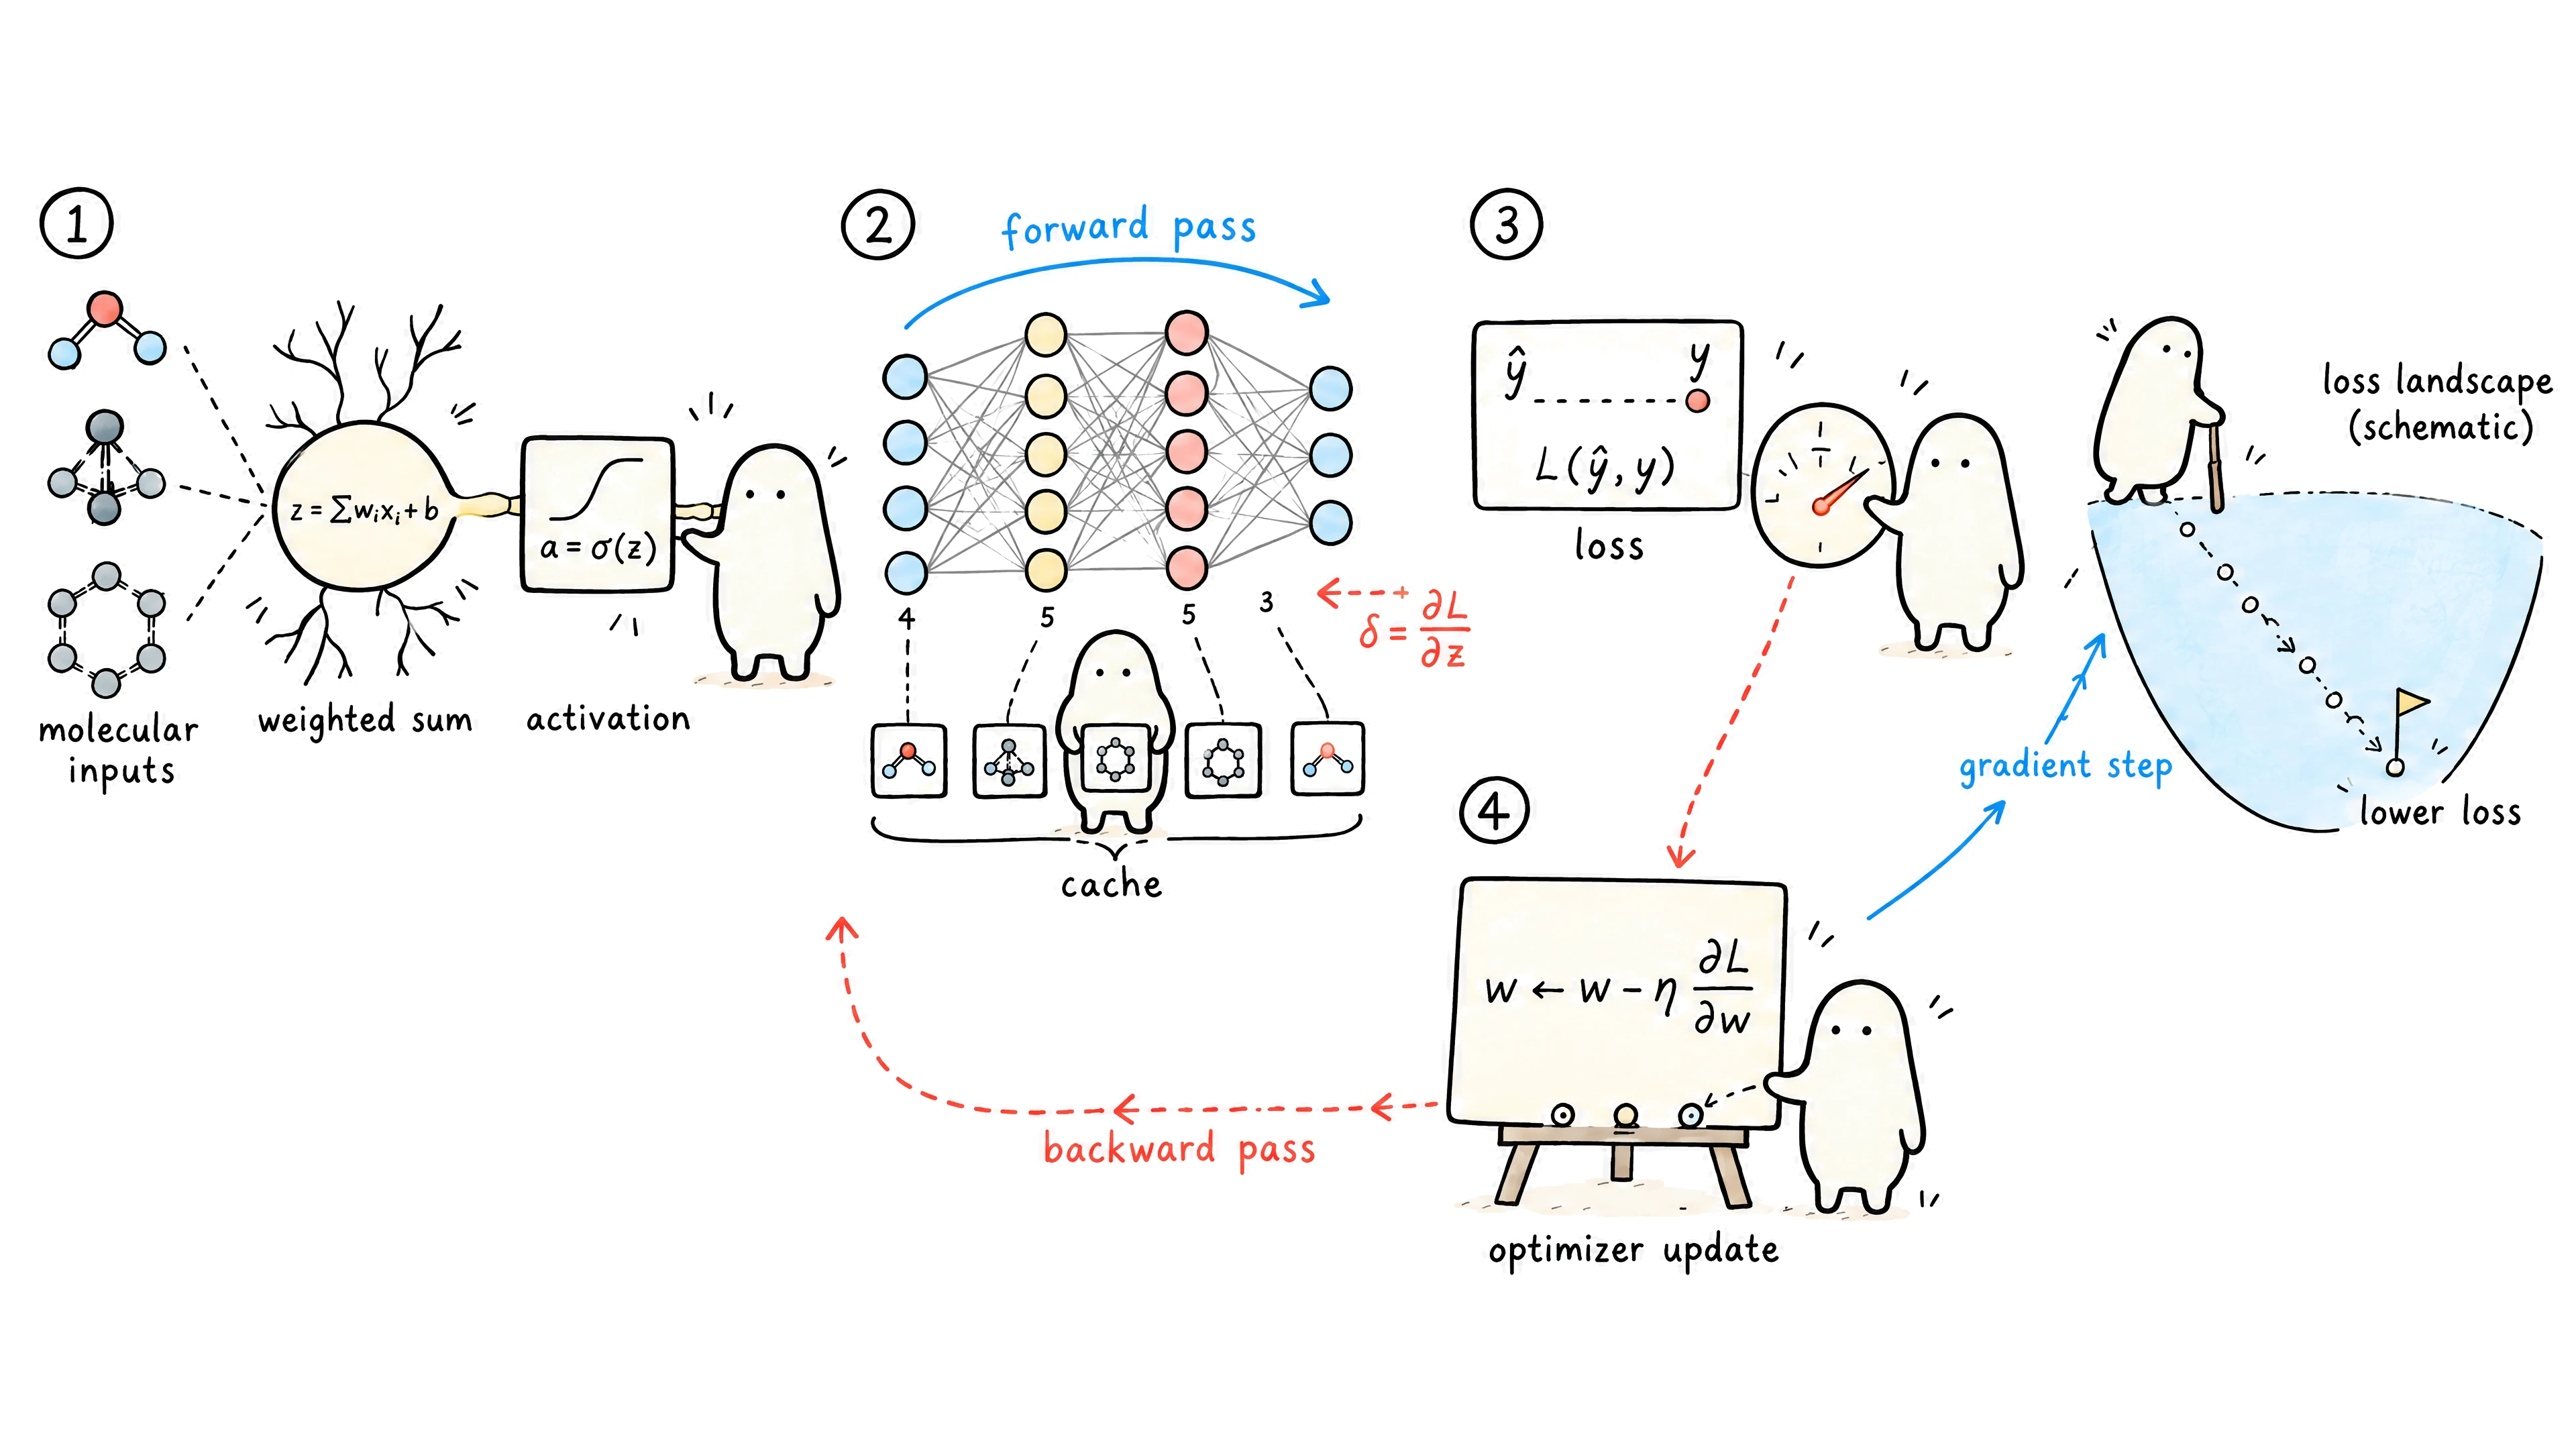
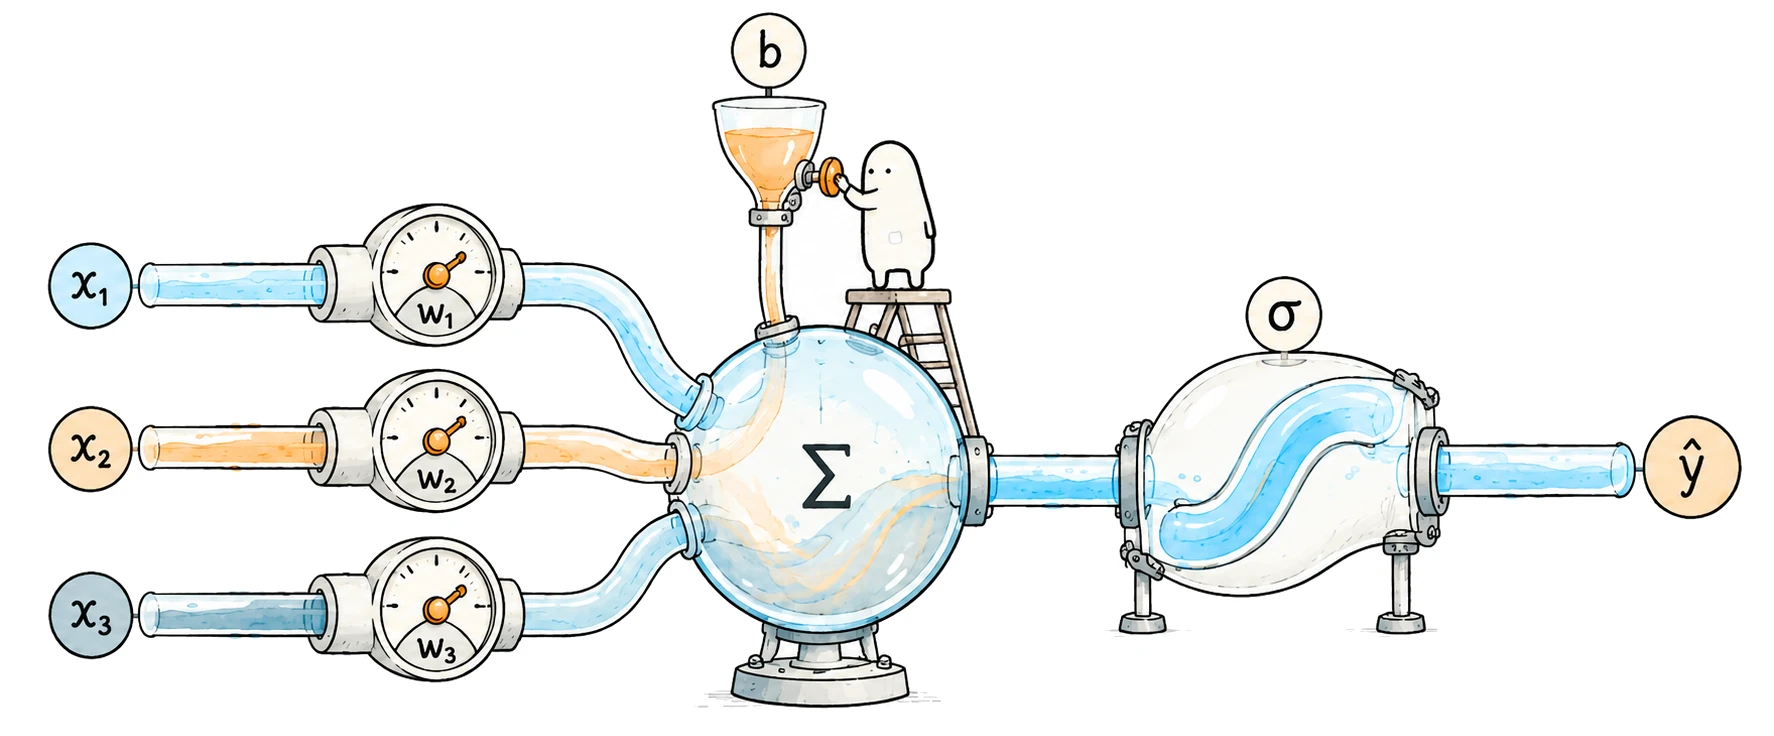
回顾上一章,线性单元把各个输入乘以权重,加起来,再加一个偏置。本章把这个中间结果记为 :
神经元接着把 送进一个非线性函数 ,得到输出 :
这里的 是数据提供的输入, 和 是训练要调整的参数; 和 则是用当前参数算出的中间结果。函数 称为激活函数。这个名称听起来抽象,实际操作就是:先算出一个数,再按选定的函数把它变成另一个数。
例如,以原子间距为输入时,可以先算 ,再算 。 此时只是一个中间计算结果,后面还要把它换成能量预测。不要把这个数直接理解为某种相互作用能,也不要把偏置 当成活化能或化学势。
3.1.2 为什么需要非线性
也许会想到:把几个线性单元接起来,能不能得到更灵活的模型?先看一个输入、连续两步线性计算的情形:
合并后,它仍然是一条直线,只是换了斜率和截距。增加更多线性层也一样。要让不同输入区间有不同的响应方式,需要在层与层之间加入非线性函数。
第一章的阶跃函数也有非线性,但它在阈值以外的导数为零,在阈值处不可导,不适合用这里的梯度下降方法训练。接下来介绍的函数既能提供非线性,也能用于逐步求导;ReLU 在折点处的处理会单独说明。
3.1.3 怎样读激活函数的曲线
先看形状,再看导数。Sigmoid 把输入压到 0 和 1 之间;Tanh 把输入压到 −1 和 1 之间;ReLU 保留正数,把负数变为零。三者都对每个神经元的 单独作用。
表 1 三种激活函数及其导数
| 名称 | 输出 | 导数 | 输出范围 |
|---|---|---|---|
| Sigmoid | |||
| Tanh(双曲正切) | |||
| ReLU | 时为 1, 时为 0 |
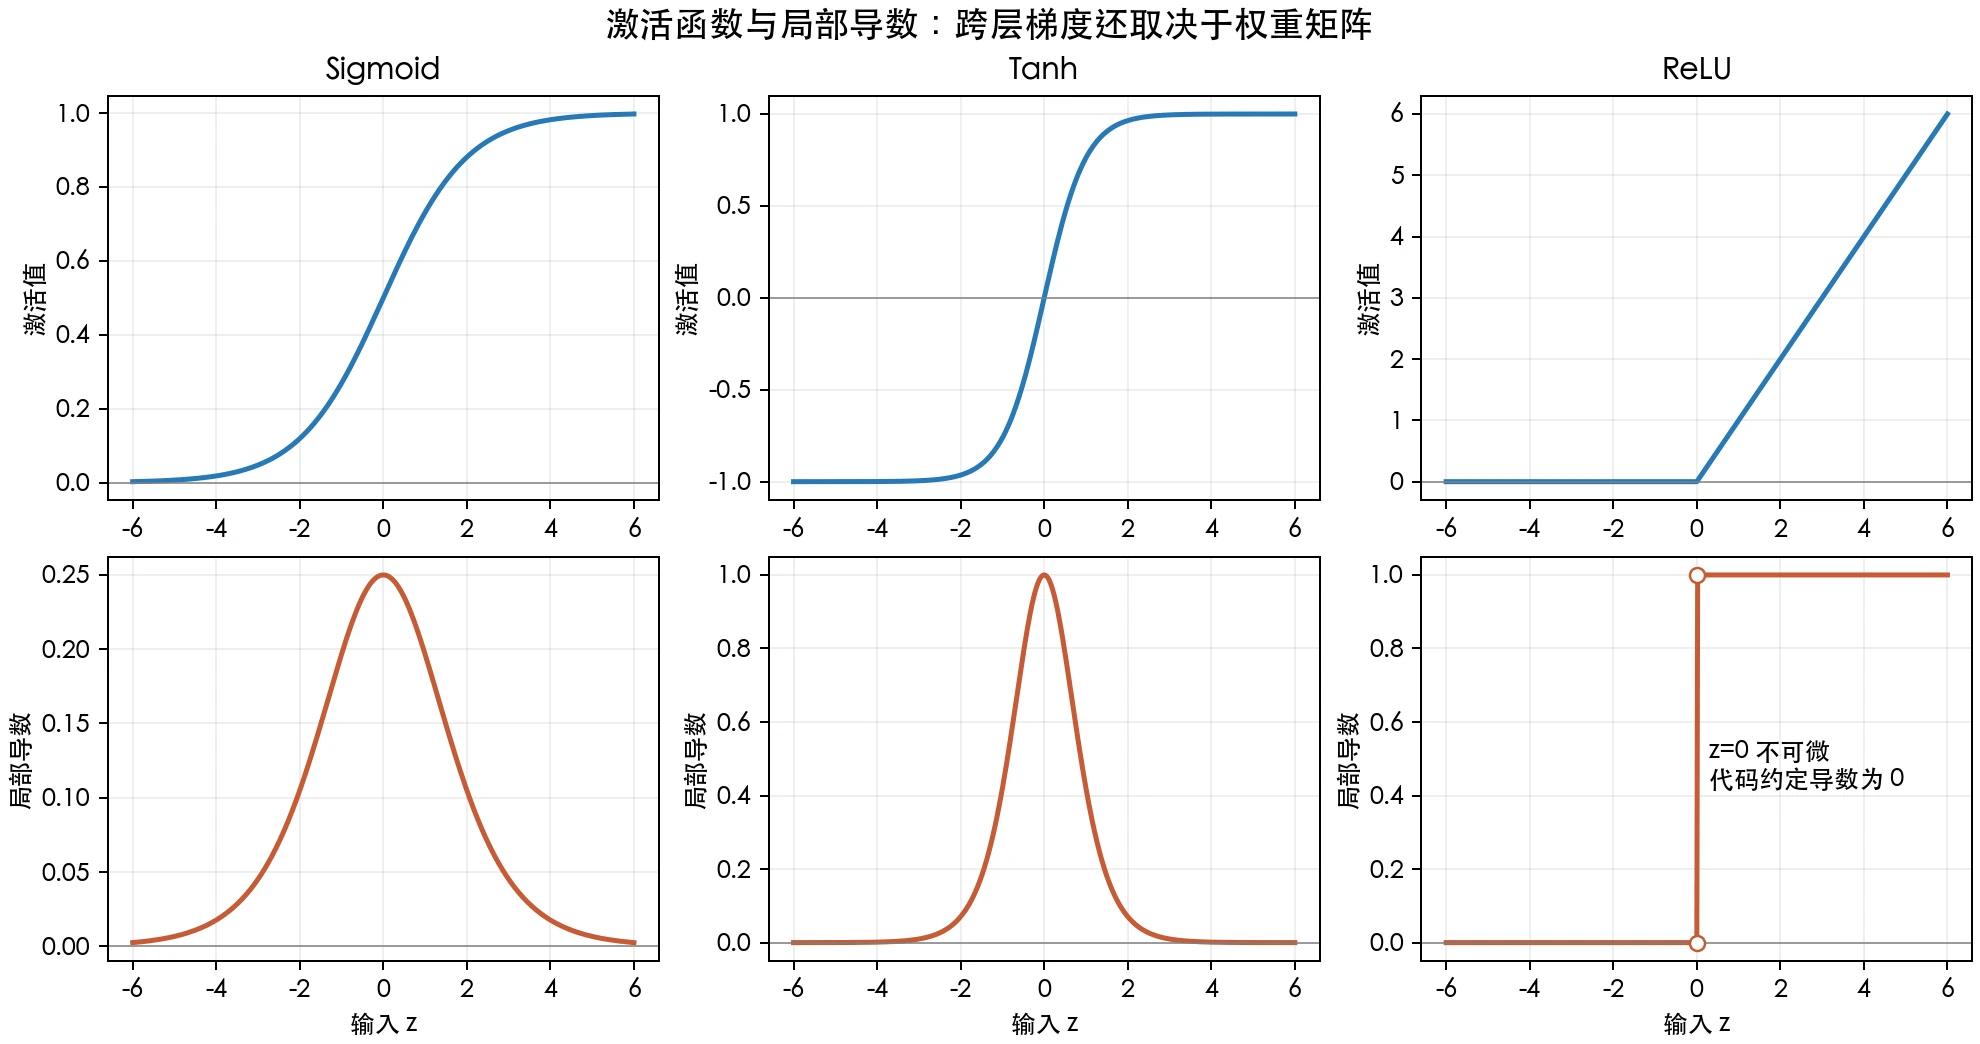
为什么同时列出导数?因为训练时需要知道:改变一个参数以后,神经元的输出会改变多少。曲线很平的地方,输入改变了,输出也可能几乎不变。第 3.4 节会看到,这种影响会继续传递到最终损失。
本章的手算和回归案例使用 Tanh,便于连续地观察输出及其导数。Sigmoid 留给二分类的输出概率。ReLU 的计算简单,正半轴的斜率不会缩小传来的梯度;但如果一个单元对所有训练样本都输出零,其输入权重就收不到直接的梯度更新。各种函数的适用特点和数值细节见附录 B.2。
激活函数
平均导数 E[f′(z)]0.207上限 0.25
饱和比例0%f′ < 5% 峰值
z ≤ 0 的比例50%
10 层后的梯度缩放1.4e-7(E f′)^L
激活函数、导数与输入分布灰色阴影为 z ~ N(μ, σ²)
f(z) f′(z)
一个神经元已经能处理输入。现在让几个神经元同时计算,再把它们的结果交给下一层,就可以得到一个小网络。
3.2 把神经元连成网络
3.2.1 隐藏层是中间的一层计算
先继续考虑由原子间距预测能量。一个最小的示意网络可以写成
前两步构成一个隐藏神经元,最后一步把它的输出变成能量预测。 都需要训练。这里用一个神经元说明计算过程;实际拟合第 3.8.2 节的势能曲线时会使用更多神经元。
“隐藏层”指输入与最终输出之间的一层计算。训练数据提供 和参考能量 ,没有直接给出中间的 应该是多少。我们会根据最终预测的好坏,一起调整中间层和输出层的参数。
让多个隐藏神经元分别处理同一输入,它们就会得到一组中间数值。下一层再组合这些数值,形成新的结果。这组中间数值也称为表征。对于分子描述符,可以把它理解为网络自己算出的一组新特征;这些特征通常没有预先指定的化学名称。
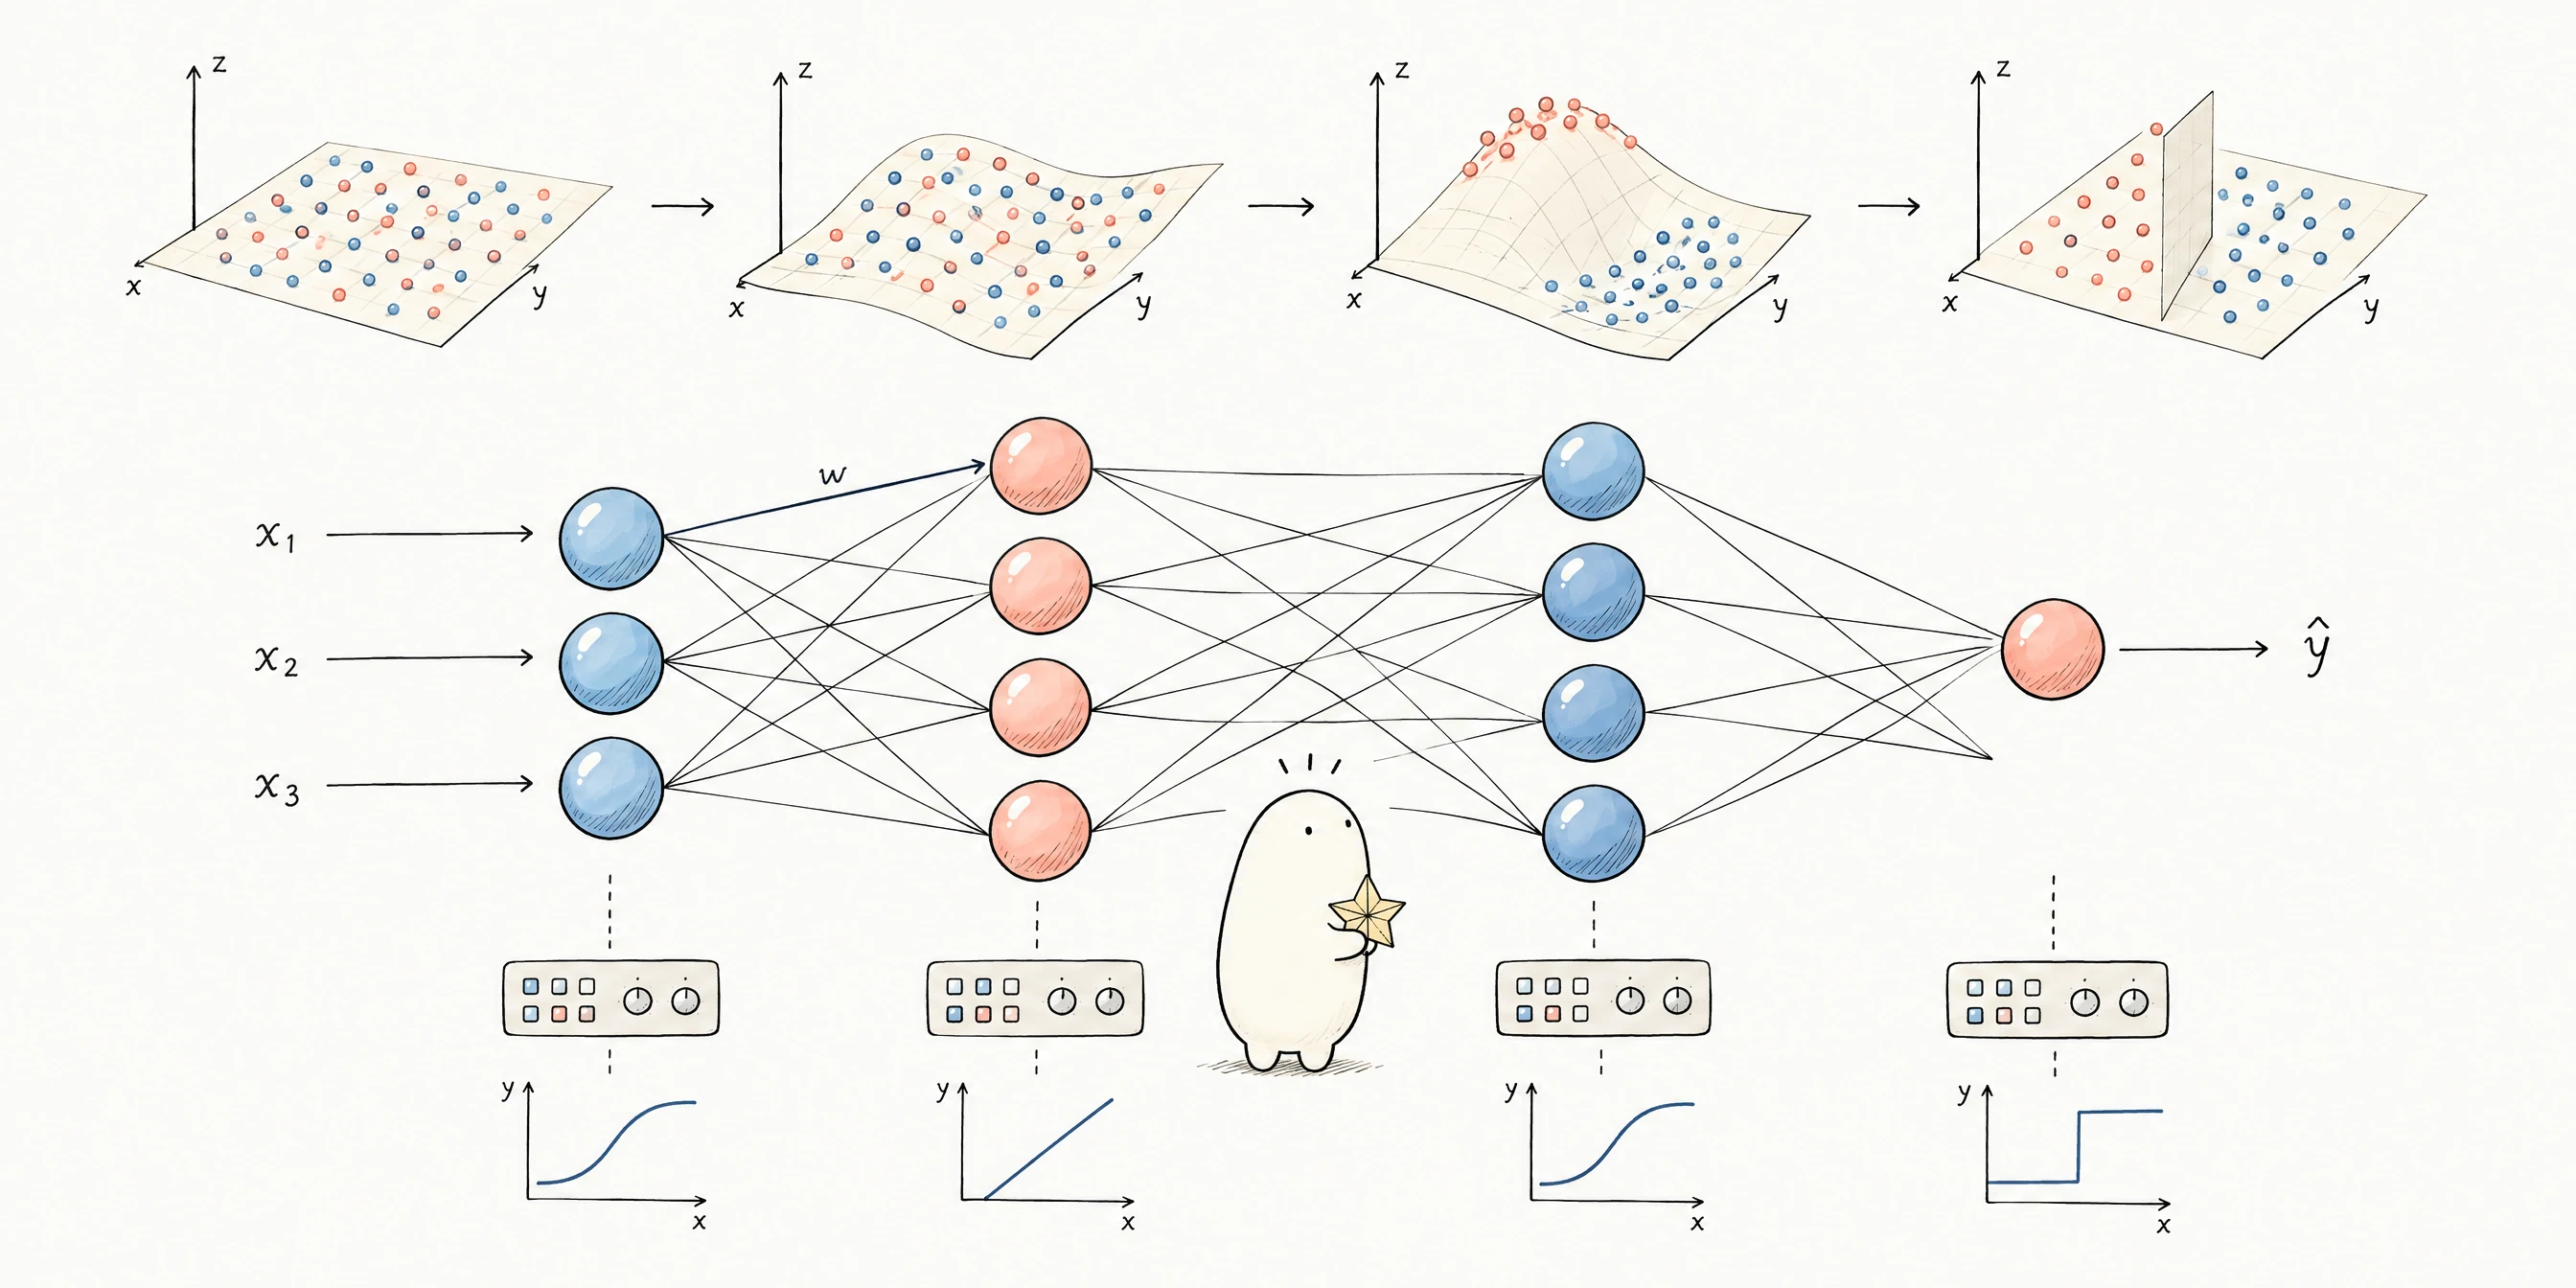
这样的分层网络称为多层感知机(Multilayer Perceptron,MLP)。输入层只接收数据;这里所说的网络层数,按带参数的计算层计数,不把输入层算进去。
3.2.2 跟着一个样本算出预测值
为方便手算,我们用一个 网络:两个输入、两个隐藏神经元、一个输出。下面的数值是教学用的无量纲数值,不对应某个真实分子的测量结果。可以把两个输入想成已经标准化的两个描述符,把输出想成同样经过缩放的目标性质。
给定 、,两个隐藏神经元分别计算
对这两个数分别取 Tanh:
输出层把它们组合起来:
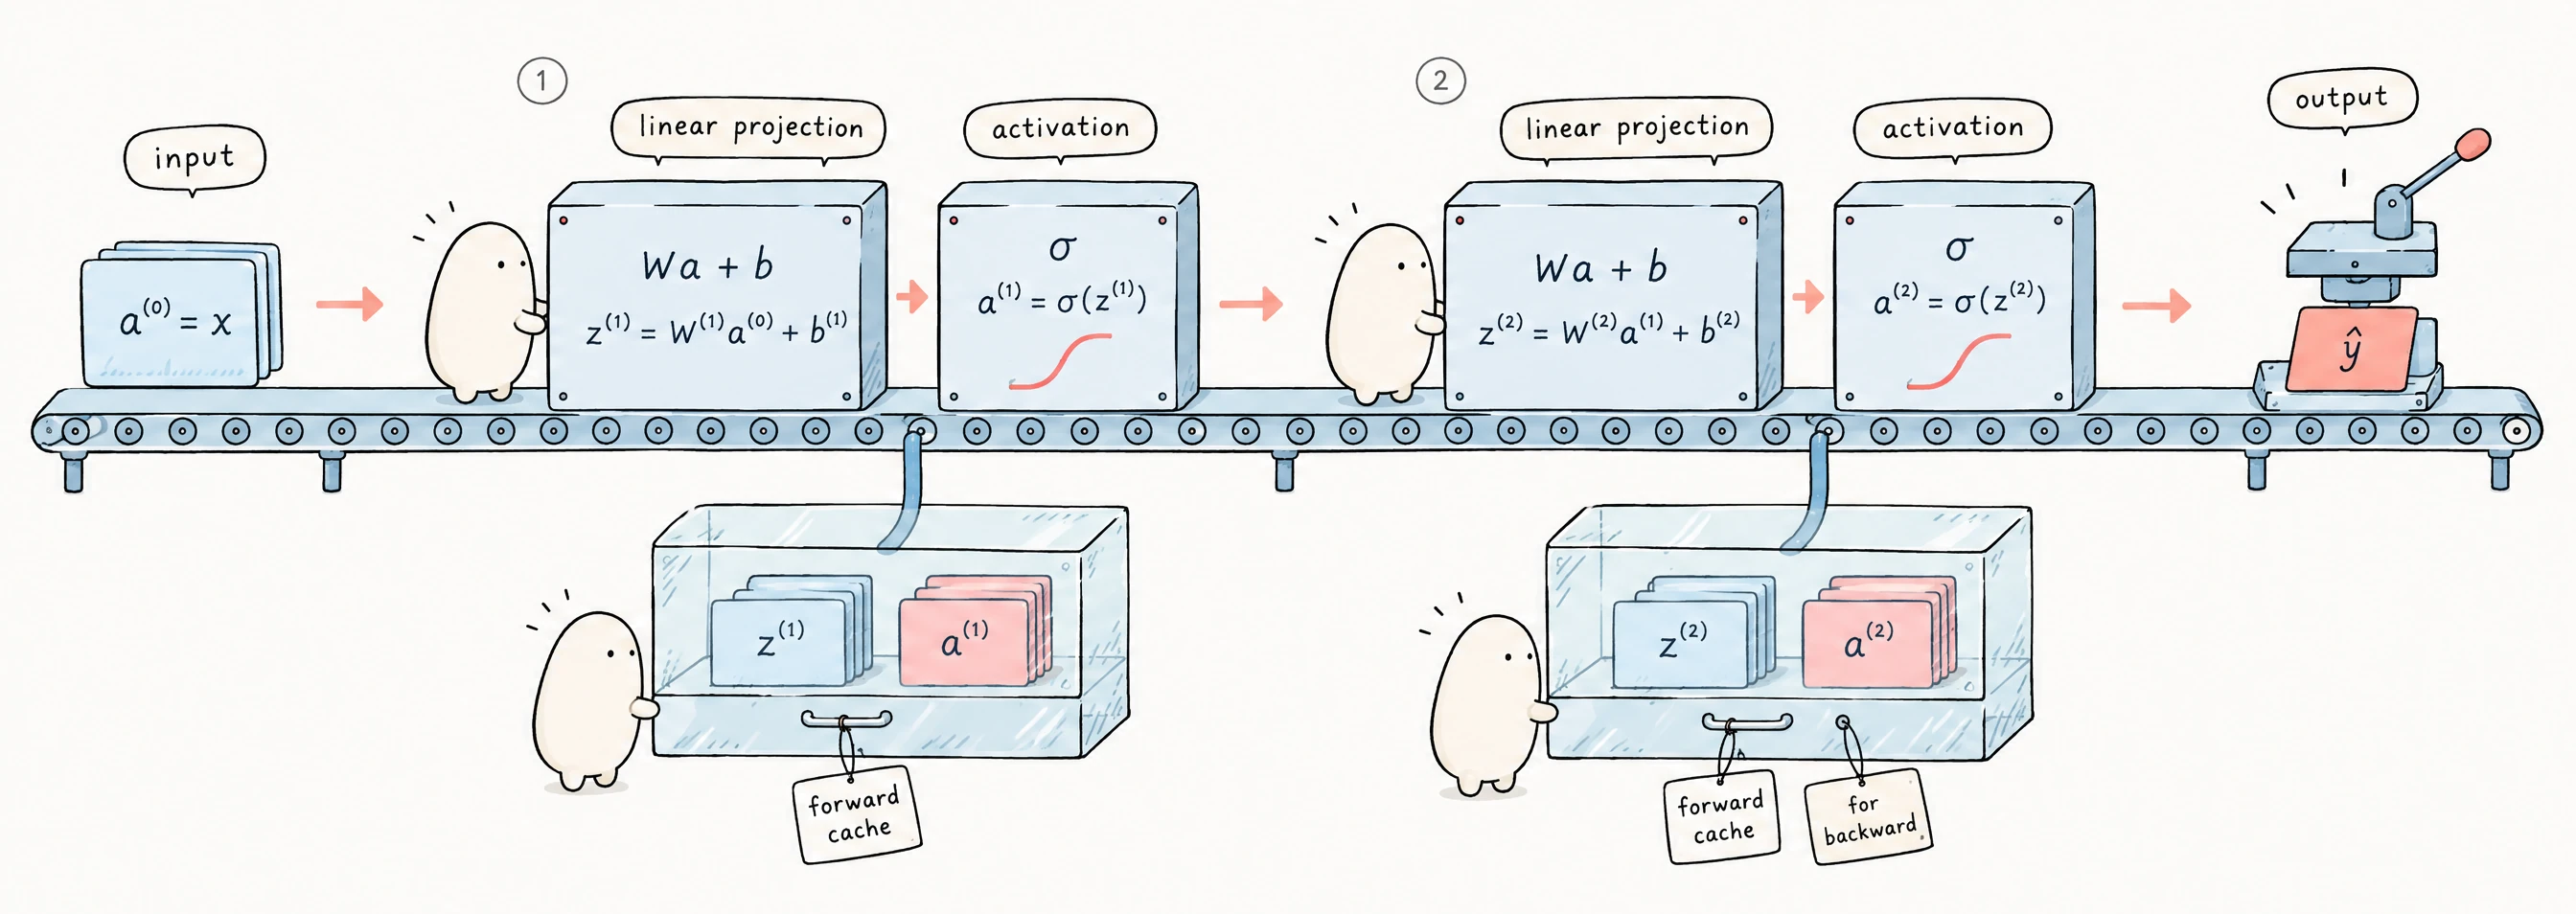
这就是一次前向传播:给定输入和当前参数,按计算顺序从前往后算出预测值。此时参数还没有改变,网络也还没有学习。
回归输出在这里不再经过 Tanh,最后的加权和就是预测值。否则输出会被限制在 ,未必符合目标的范围。隐藏层需要非线性,并不意味着输出层也必须使用相同的激活函数。
沿输入、加权和、激活、输出逐步推进;参数与本章第 3.2.2 节的手算例子一致。
输入 x:0.5, −0.3
思考与说明
思考保持第二个输入不变,改变第一个输入,输出会线性变化吗?
2→2→1 网络,隐藏层 tanh、输出层线性;x₂=−0.3,其他参数固定。
3.2.3 隐藏层到底改变了什么:用四个点说明
前面的数字告诉我们网络怎样计算。再用一个能画在纸上的分类问题,看看中间特征怎样帮助预测。这个问题叫异或(XOR):两个输入不同时输出 1,相同时输出 0。
表 2 XOR 问题的真值表
| 目标标签 | ||
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
可以把它想象成一个人为设定的添加剂实验:只加其中一种时有响应,两种都加或都不加时没有响应。这个设定只用来解释逻辑,不是在陈述某种真实的化学规律。“两种都加才有响应”则是另一种规则,叫“与”(AND)。
把四组输入画在正方形的四个顶点,标签为 1 的两个点在一条对角线上,标签为 0 的两个点在另一条对角线上。无论怎样移动或转动一条直线,都不能把两类点完全分开。
我们可以先构造两个新特征: 表示“至少有一个输入为 1”, 表示“两个输入都为 1”。XOR 要找的就是 且 的情形。用第一章的阶跃函数 ( 时为 1,否则为 0)写出来:
表 3 手工构造的两层网络求解 XOR
| (OR) | (AND) | 目标 | |||
|---|---|---|---|---|---|
| (0, 0) | 0 | 0 | −0.5 | 0 | 0 |
| (0, 1) | 1 | 0 | 0.5 | 1 | 1 |
| (1, 0) | 1 | 0 | 0.5 | 1 | 1 |
| (1, 1) | 1 | 1 | −0.5 | 0 | 0 |
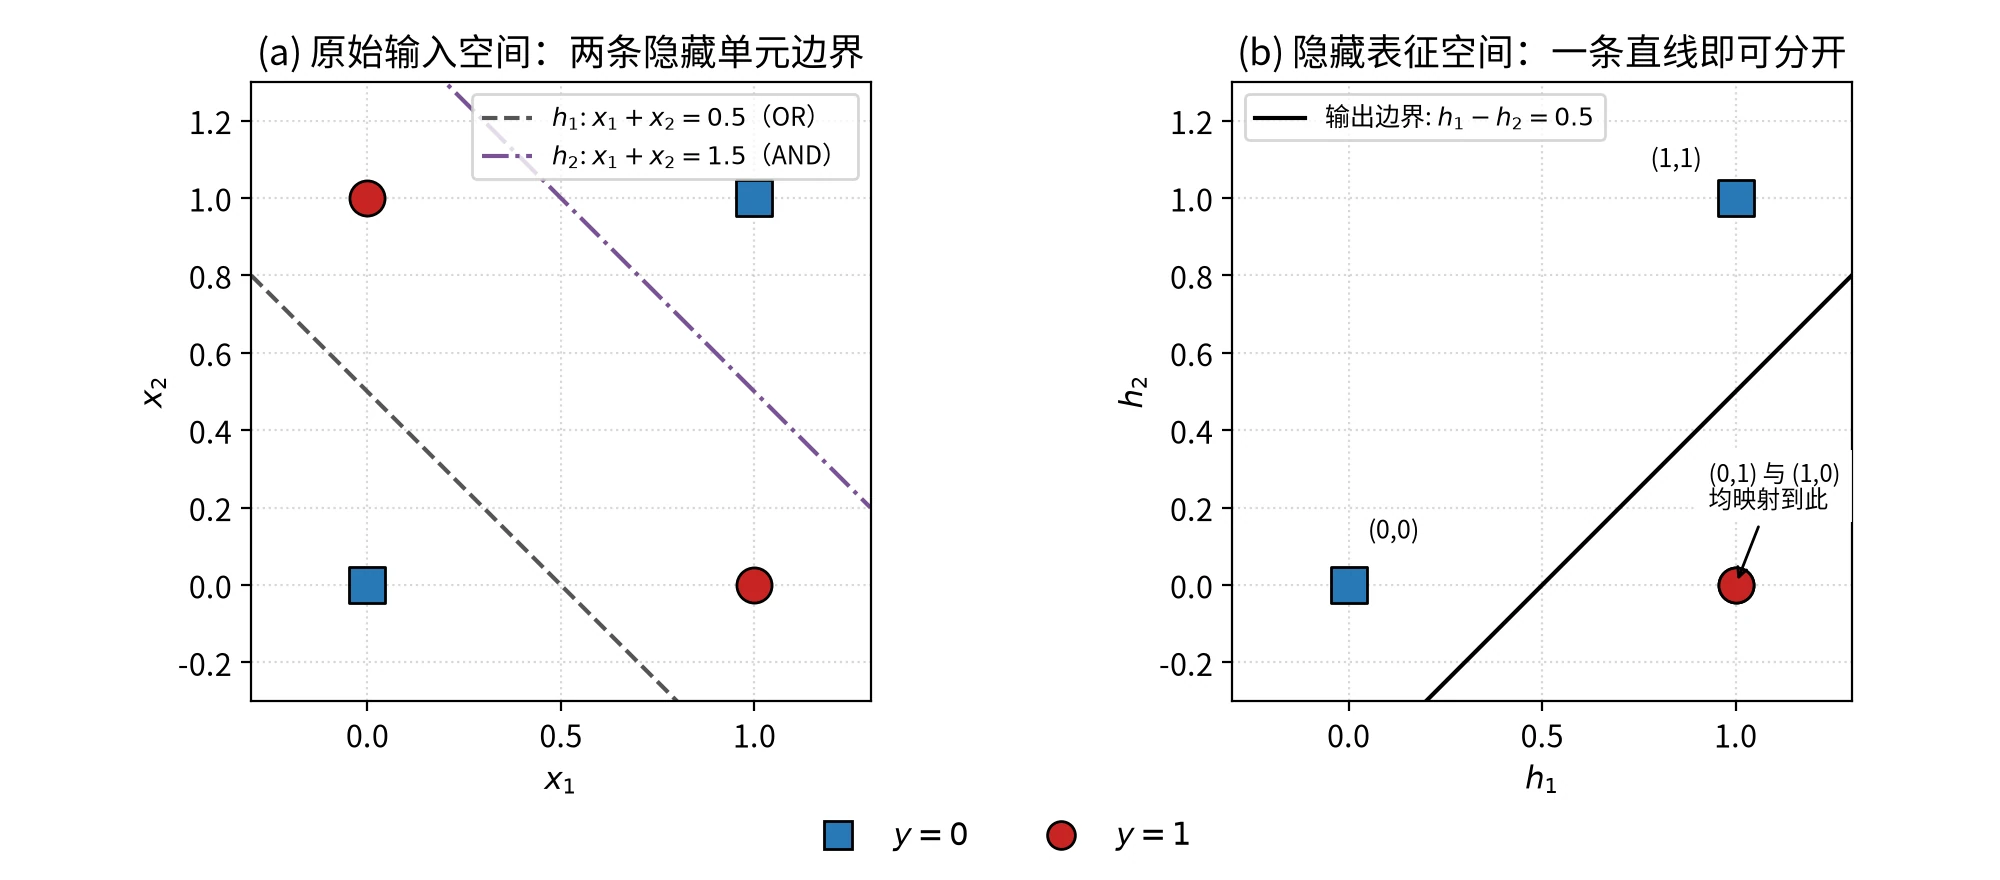
这个例子中,我们知道答案,所以能手工设置权重。实际使用时,会换成适合求导的激活函数,再让训练数据决定权重。第 3.7.3 节将实际训练一个网络学习 XOR;关于无隐藏层模型最优损失的推导放在附录 A.1。
现在网络已经能给出预测,但换一组参数也会得到另一组预测。接下来需要一个标准,判断哪组参数更合适。
3.3 用损失衡量预测偏差
3.3.1 先分清残差和损失
继续第 3.2.2 节的手算。假设这个样本的参考值为 ,当前预测约为 ,那么残差是
正号表示预测偏高,负号表示预测偏低。要比较一组样本的整体拟合情况,不能直接把残差相加,否则正负偏差可能抵消。这里把残差平方,并乘以 ,得到单个样本的损失:
残差保留偏差方向,平方损失则把偏差变成非负的数。损失越小,表示模型在当前采用的评价标准下越贴近参考值。它描述的是这份数据上的拟合,是否能预测新样本还要另外检验。
3.3.2 从一个样本到一批数据
对 个样本,把它们的平方损失取平均:
本章把这种平方误差损失简称为 MSE。系数 只为求导方便;软件中的 MSE 常常不含这个系数,多输出时还可能对输出维度取平均。比较损失或梯度数值前,要核对使用的是哪一种约定。
对单个样本的预测值求导,得到
在手算例子中,这个导数为正,意思是:如果单独把预测值再提高一点,损失会增大。但预测值由许多参数共同决定,要知道某个参数该怎样调,还需要追踪它对预测的影响。
平方误差会较重地惩罚大偏差,遇到异常测量时要留意这一点。它与高斯误差假设的联系,以及 MAE、Huber 损失的用途,放在附录 B.1。
3.3.3 如果预测的是“是或否”
预测能量、带隙或溶解度时,输出是连续数值;判断某种响应是否出现时,输出则可以表示出现该响应的概率。表 4 把这两类任务与多分类放在一起,供后面查阅。
表 4 常见任务的输出层激活函数与损失函数搭配
| 任务类型 | 化学与材料中的例子 | 输出层激活 | 损失函数 |
|---|---|---|---|
| 回归(连续值) | 结合能、带隙、活化能、溶解度 | 恒等映射 | 均方误差(MSE) |
| 二分类 | 分子是否有毒性;晶体结构是否热力学稳定 | Sigmoid | 二元交叉熵(BCE) |
| 多分类 | 晶体所属晶系;反应主产物类型 | Softmax | 多类交叉熵 |
以二分类为例,用 Sigmoid 把输出变成 ,再用二元交叉熵(BCE)评价它:
当 时,损失为 。模型给真实发生的事件分配的概率越小,损失就越大。例如 时,损失约为 4.6。 时则用 ,惩罚过高的正类概率。
先记住这个使用方式即可。为什么分类常用交叉熵,以及怎样稳定地计算它,在附录 B.2 中解释。下面继续用回归和平方误差,把参数求导讲清楚。
损失已经告诉我们整体预测偏差有多大。隐藏层却没有各自的参考答案:我们只知道最终的 ,不知道每个 应该是多少。下一步要追踪这些中间计算对损失的影响。
3.4 反向传播:沿计算过程逐步求导
3.4.1 一个参数怎样影响最终损失
回到式(5)的单隐藏神经元网络。给定参考能量 ,令 。稍微改变隐藏层权重 ,会先改变 ,接着改变 ,再改变预测能量 ,最终改变损失 。
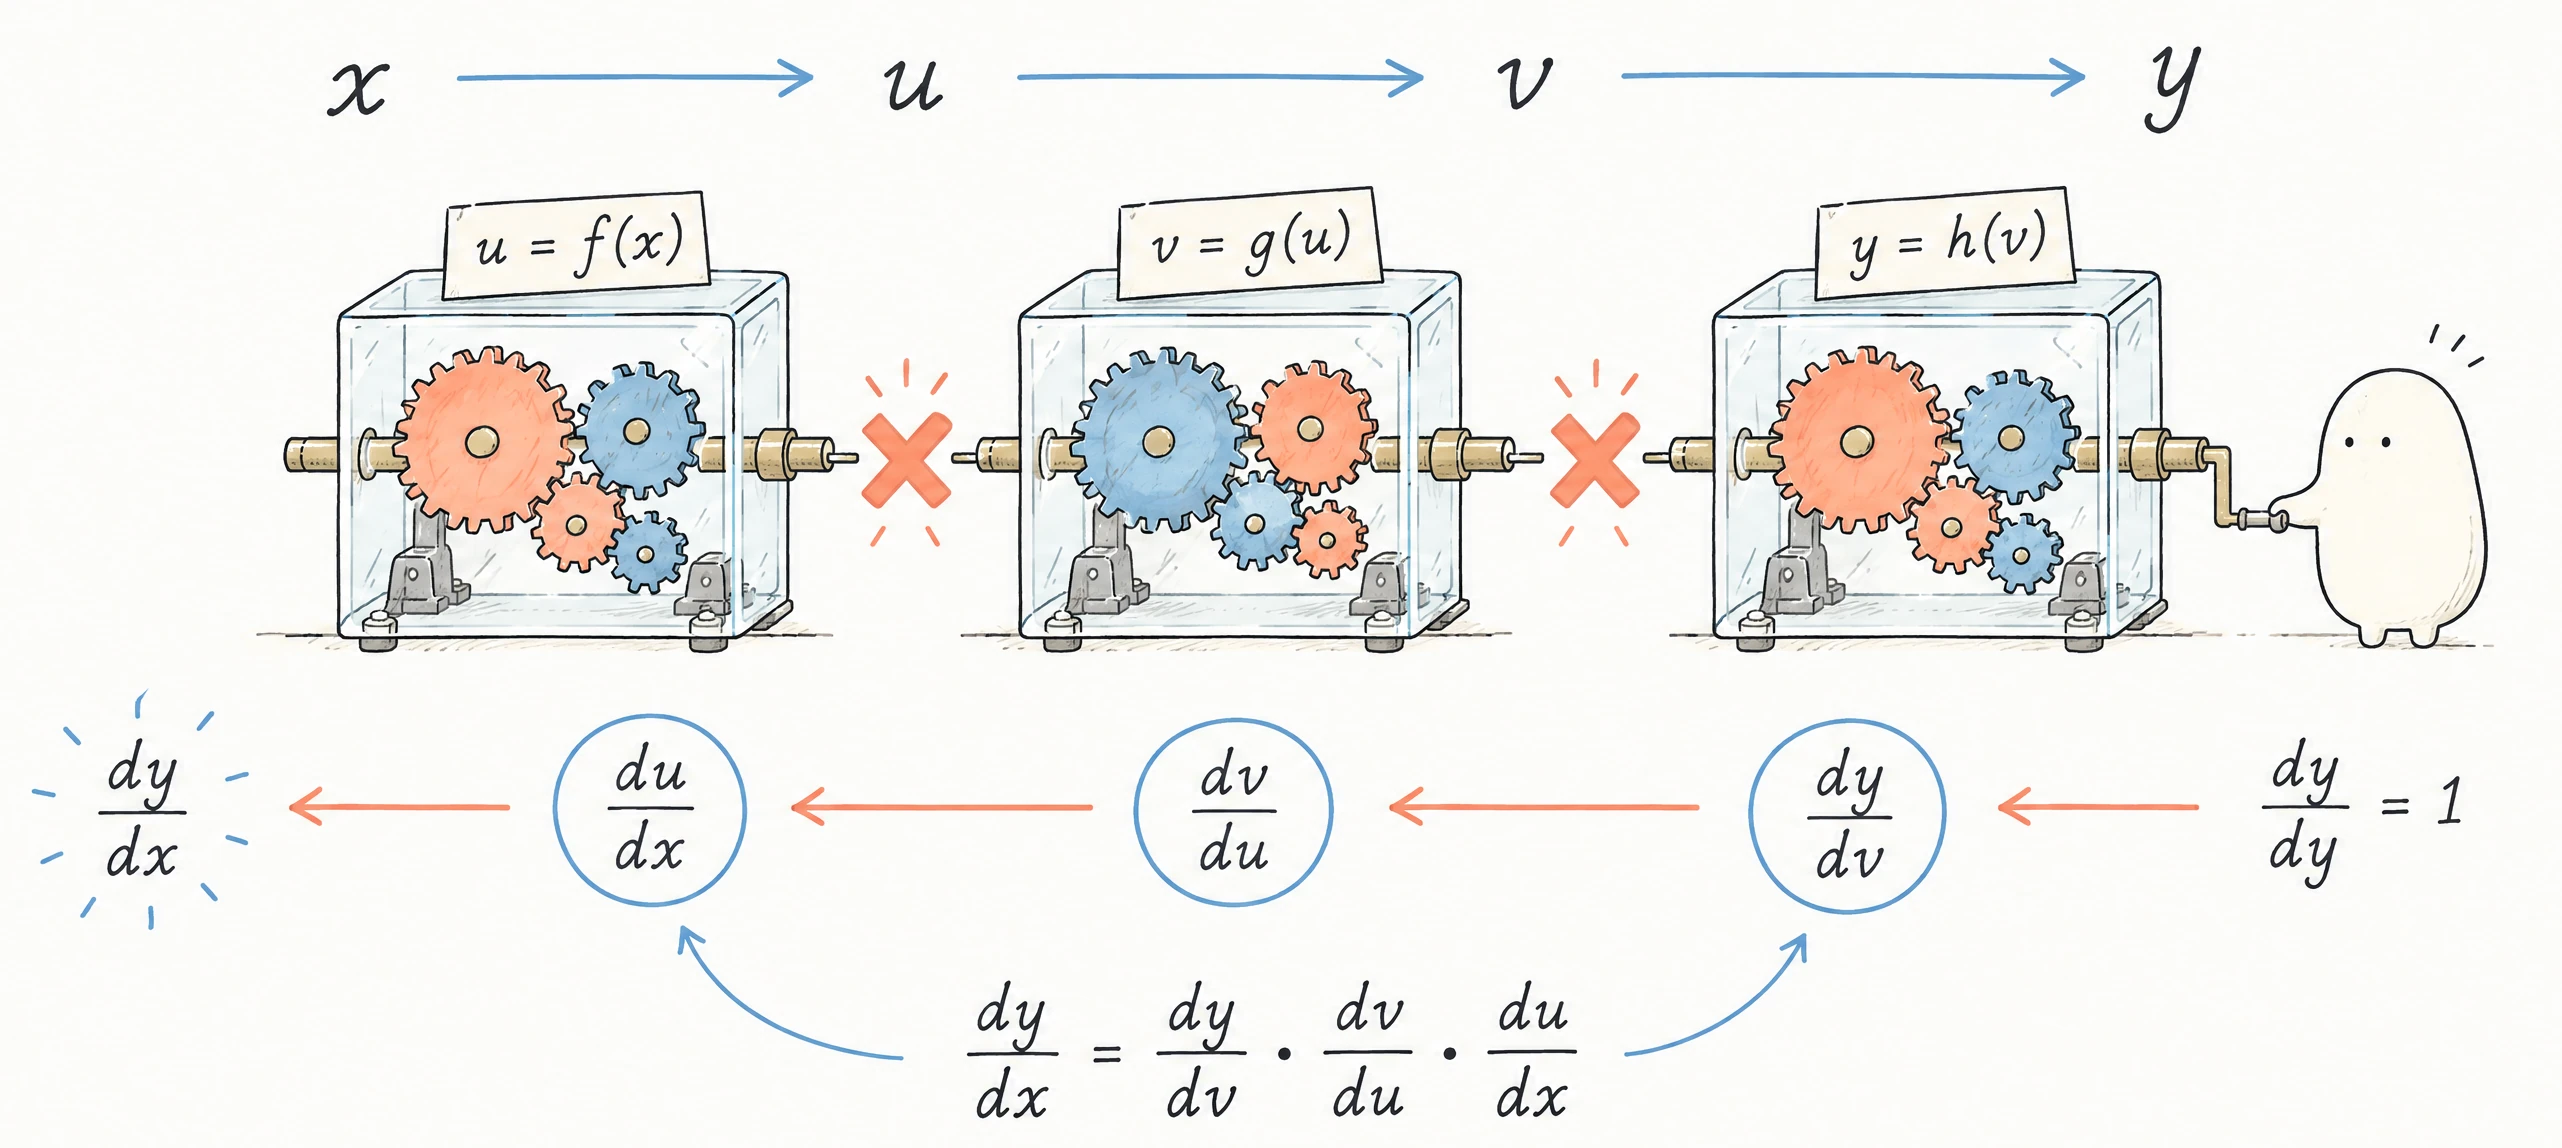
链式法则把这几段影响接起来:
每一项只负责相邻的两步: 改变多少会影响 , 改变多少会影响 ,依此类推。把变化率相乘,就得到 对最终损失的影响。这与已经学过的复合函数求导相同。
因此,即使知道能量预测偏高,也不能直接断定所有权重都应减小。还要看这个权重经过后续计算,会把预测推向哪个方向。
损失 L0.110
∂L/∂w 链式法则-0.221数值微分 -0.221
∂L/∂b 链式法则-0.147数值微分 -0.147
当前阶段尚未计算
计算图:单个 Sigmoid 神经元的平方误差上行为前向值,下行为反向累积的 ∂L/∂·
前向 反向
3.4.2 先求最靠近输出的参数
继续前面的 手算网络,把输出层写成 。当前 、、,残差为 。
输出层最容易求导,因为它与损失之间只隔着一次平方运算:
注意第二个梯度为负。因为 ,稍微增大 ,会让 变小,从而降低当前偏高的预测。这说明参数该怎样调,不能只看残差的符号。
3.4.3 再把影响追溯到隐藏层
第一个隐藏神经元先经过 Tanh,再乘以输出权重 。所以损失对它的加权和 的导数是
为了少写一长串导数,把这个结果记为 。第二个隐藏神经元同理:
常被称为“误差项”,但要记清它的定义:它是损失对神经元加权和的变化率,通常不是预测残差。 表示单独增大 会使当前损失增大; 则表示单独增大 会使当前损失减小。这是局部的求导结果,不能直接用来说明某个物理机制的重要性。
现在看第一个隐藏神经元的权重。由于 ,只需再乘上相应的输入:
第二个神经元也一样。表 5 汇总两层的计算结果;矩阵中每一行对应一个接收输入的神经元,每一列对应一个输入。
表 5 网络手算结果汇总
| 量 | 第 1 层(隐藏层) | 第 2 层(输出层) |
|---|---|---|
| 加权和 | ||
| 激活值 | ||
| 误差项 | ||
| 权重梯度 | ||
| 偏置梯度 |
表中 、 和 把同一层的几个数排在一起,上标 表示层号。完整矩阵记号将在第 3.6 节统一介绍。这里的数值显示到小数点后 6 位,后续更新使用未舍入的数值。
3.4.4 多条路径要相加,相同的中间结果可复用
这个小网络只有一个输出,隐藏神经元到输出只有一条直接路径。网络加宽后,一个中间结果会被下一层多个神经元使用。改变它,就会通过多条路径影响损失;求导时,先沿每条路径相乘,再把各条路径的贡献相加。
再看已经算出的 :求 、 和 的梯度时,都用到了它。没有必要为每个参数重新展开完整的链式法则。更深的网络也一样:从输出开始,逐层算出并复用这些中间导数,就能得到所有参数的梯度。这个有组织的求导过程就是反向传播。
如果改为逐个扰动参数、重新算损失,每个参数都需要额外的前向计算。反向传播则用一次前向计算保存中间结果,再用一次反向计算得到全部梯度。详细的代价比较见附录 A.5。
反向传播到这里就完成了:我们得到了各参数的梯度,参数本身还没有改变。接下来才是梯度下降的工作。
3.5 用梯度完成一次参数更新
3.5.1 把手算的训练过程走完
与上一章相同,对任一参数 ,更新规则是
学习率 控制调整幅度。梯度为正,参数减小;梯度为负,参数增大。这个方向来自当前位置的变化率,是否真的降低损失,还取决于步子是否合适。
在手算例子中取 。第一个输出权重的更新是
第二个输出权重由 增大到约 。用同一次反向传播得到的梯度,更新全部权重和偏置,再让同一个样本通过网络,得到:
表 6 同一样本在一次梯度下降前后的结果
| 量 | 更新前 | 更新后 |
|---|---|---|
| 参考值 | 0.400000 | 0.400000 |
| 预测值 | 0.640796 | 0.588616 |
| 残差 | 0.240796 | 0.188616 |
| 平方损失 | 0.028991 | 0.017788 |
预测向参考值靠近,损失也下降了。这次前向计算、比较、求导和更新,才组成一次完整的训练步骤。 一个样本上的改进还不能说明网络已经学会整个问题;训练时需要用一批样本反复进行,并用未参与训练的数据检验。
计算各层梯度时应使用同一组旧参数。先算完所有梯度,再统一更新,避免计算前层梯度时混入已经修改的后层权重。
3.5.2 学习率与标准化:沿用上一章的经验
学习率太小,参数变化很慢;太大,则可能一步越过合适区域,使损失振荡或增大。损失曲线能帮助判断训练状态,不能仅凭一次更新下降就认定学习率合适。
不同描述符的数值尺度也可能相差很大,例如分子量与氢键给体数。可以沿用上一章的标准化:
和 分别取自训练集的均值和标准差;测试集使用同一组数。回归目标也可以标准化,预测后再变回原来的单位。标准化有助于调整计算尺度,但不等于完成了模型选择。
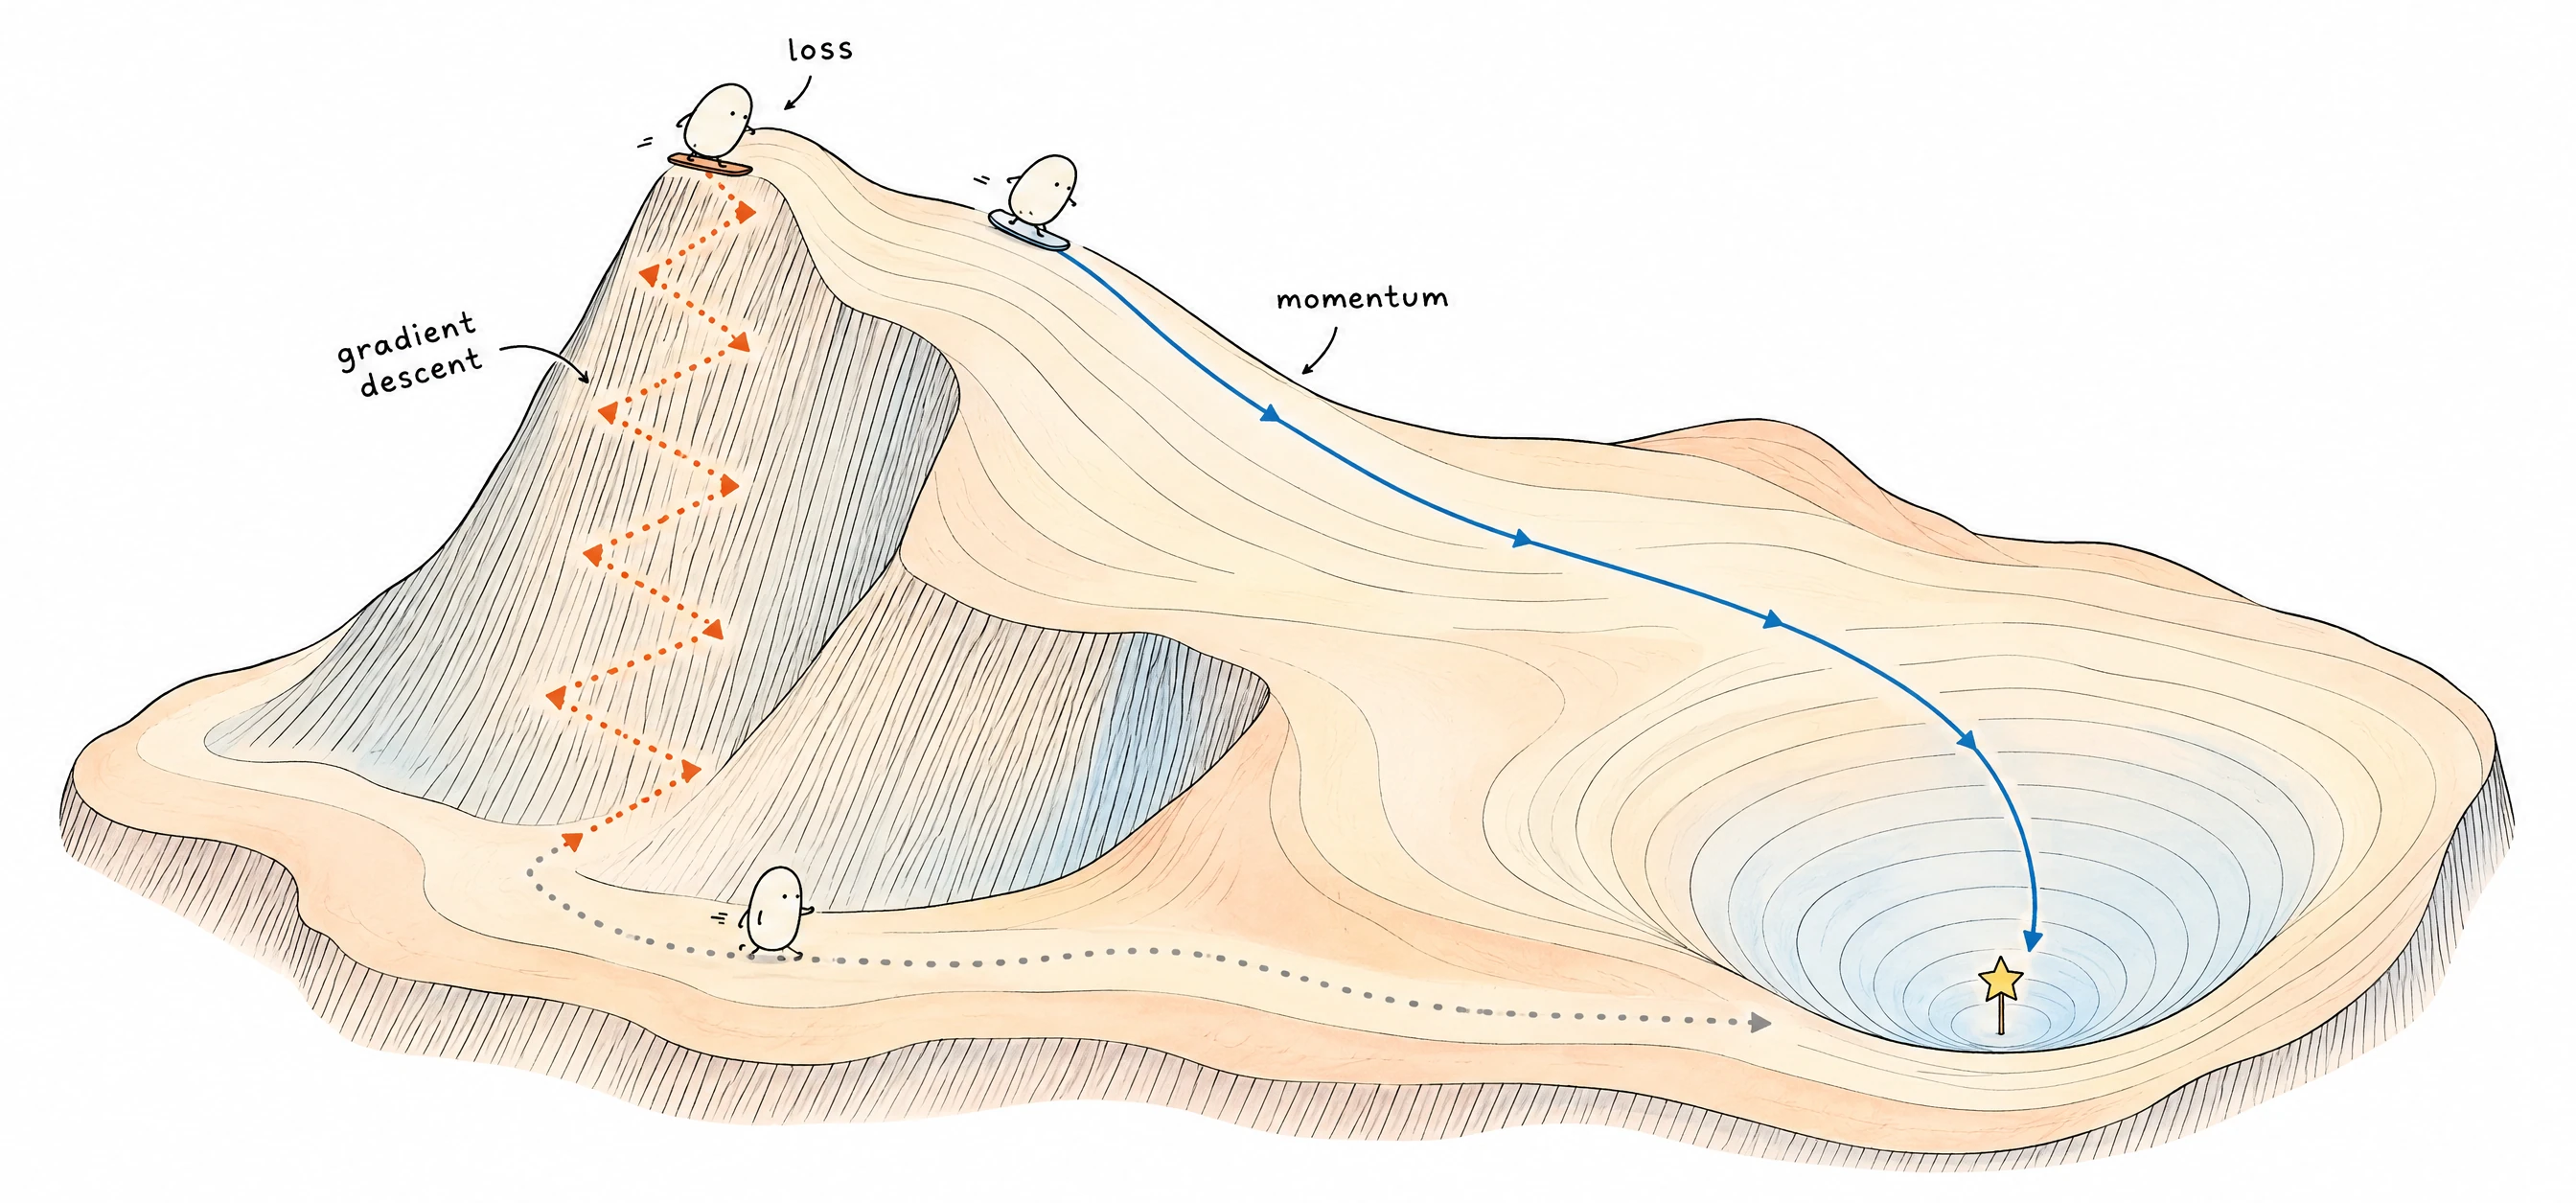
若把训练想成在地形中寻找低处,这片地形的坐标是网络参数,高度是损失。它与分子几何优化的求导过程有相似之处,但移动的变量不同:这里改变权重和偏置,几何优化改变原子坐标。
3.5.3 每次更新使用多少样本
实际训练时,可以先求每个样本的梯度,再取平均。每次使用的数据量有三种常见选择:
- 全批量:使用全部训练样本,得到当前整个训练集的平均梯度。数据多时,一次更新要等较久。
- 随机梯度下降:一次使用一个样本,每步计算少,但不同样本给出的方向可能差别很大。
- 小批量:一次使用一组样本,如 32 个,兼顾每步计算量与梯度波动。文献中的 SGD 也常指这种做法。
把训练集完整使用一遍,称为一个训练轮次(epoch)。一轮通常包含多次参数更新,不能把“训练 300 轮”理解成只更新了 300 次。
本章的势能和蒸气压案例数据少,使用全批量;ESOL 使用大小为 32 的小批量。动量法则在更新时保留一部分过去的方向,减轻来回振荡。它的公式与实现放在附录 B.3,第一次阅读可以先使用普通梯度下降。
到这里,我们已经用具体数字完成了一次训练。接下来把同样的计算写成矩阵形式,使它可以用于任意层数和宽度的网络。
3.6 从一个小网络推广到多层网络
3.6.1 矩阵只是把同一层的计算排在一起
手算中两个隐藏神经元的加权和,可以合写为
它没有增加新的运算,只是把两行相似的式子写在一起。权重矩阵的一行对应一个接收输入的神经元,一列对应前层的一个输出。记住“行是去处,列是来处”,就容易检查形状。
设网络有 层带参数的计算,第 0 层是输入,第 层是输出;第 层有 个神经元。本章向量均按列向量书写:
- , 是第 层的输出;
- 有 行、 列, 连接前层第 个输出和本层第 个神经元;
- 、 都包含 个数,分别为偏置和加权和。
上标 表示层号,不是幂次。隐藏层激活记为 ,输出层激活记为 ;两者可以不同。
3.6.2 每一层重复同样的前向计算
到输出层,换成 。回归例子中 ,二分类中 。对含多个输出的单个样本,本章平方损失的约定为 ;批量训练时再对样本取平均。
形状可以帮助检查计算: 的矩阵乘 维向量,得到 维向量,正好与偏置相加。每层把 和 保存下来,后面求导时复用。
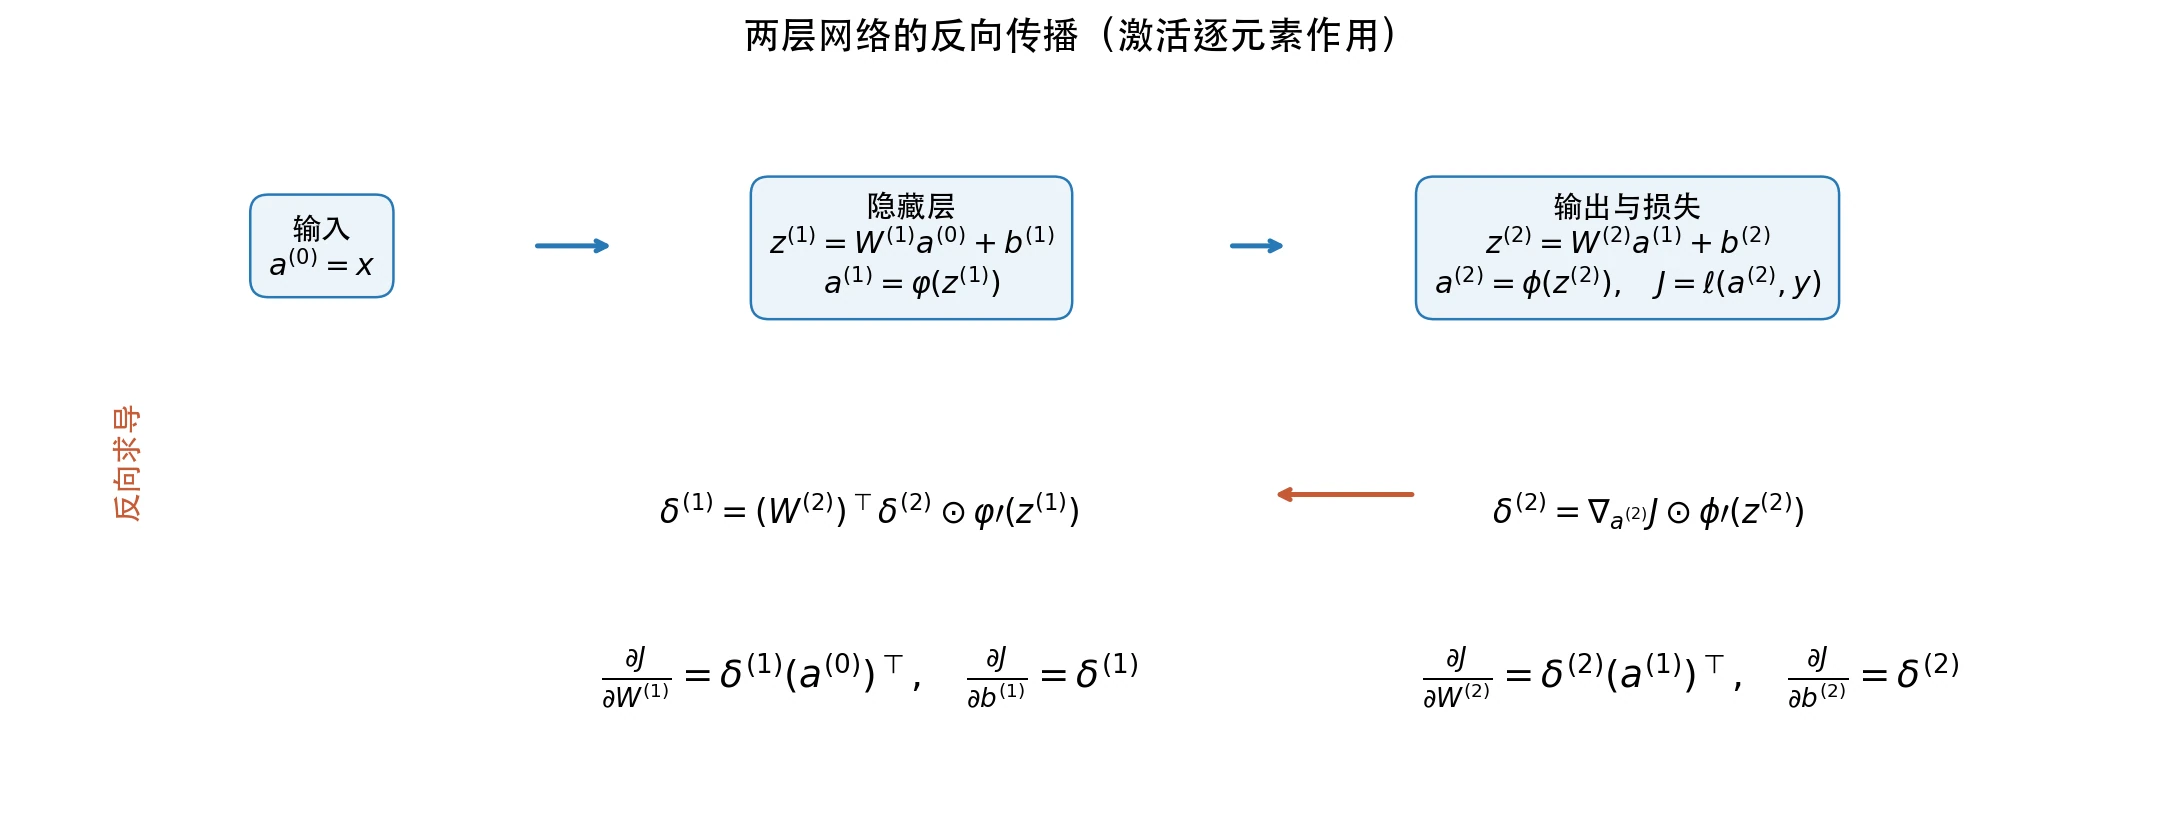
3.6.3 把反向计算写成四个方程
第 3.4 节已经使用过的中间导数,现在按层记为
它与这一层的 含有相同数量的分量。下面四个方程均针对单个样本;使用一批样本时,对参数梯度取平均。
先从输出层开始。 损失对预测值的导数,再乘输出激活的导数:
表示对应位置的数分别相乘,也称 Hadamard 积。对于恒等输出和本章平方损失,直接得到 ,就是手算时用过的残差。对于 Sigmoid 与 BCE 的组合,结果也化简为 ,推导见附录 B.2。
再逐层往前求导。 对一个隐藏神经元,汇总下一层各个神经元传回的影响,再乘自己的激活导数:
为什么有转置?前向时,矩阵的一行把前层的输入汇总给一个后层神经元;反向时,要把一个前层神经元连接到的所有后层贡献加回来。对第 个分量,这一步就是 ,写成矩阵乘法便出现了转置。
最后求权重和偏置的梯度。 每条连接的梯度,等于接收端的 乘发送端的激活:
式(28)称为外积:一个列向量乘一个行向量,得到的矩阵与权重矩阵形状相同。比如手算中的 ,就是其中一个元素。梯度的大小表示当前位置对参数微小变化的敏感程度;实际更新幅度还取决于学习率和采用的优化器。
隐层激活
预测 ŷ0.249
损失 ½(ŷ−y)²0.0316
各层 ‖∇W‖0.229 / 0.382 / 0.285W¹ / W² / W³
显示内容
2–4–3–1 网络:反向误差 δ边粗细 ∝ |w|,节点深浅 ∝ |δ|
正 负
3.6.4 参数变多意味着什么
从 个输入连接到 个神经元,需要 个权重和 个偏置:
势能案例使用的 网络,三层分别有 32、272 和 17 个参数,合计 321 个。Lennard-Jones 解析式只有 和 两个参数。网络用更多可调整的数值获得灵活性,是否值得这样做,要靠具体问题上的比较判断。
通用逼近定理说明,在一定条件下,足够宽的网络能够在指定的有界闭区域上逼近连续函数[8]–[10]。它回答的是合适参数能否存在,没有保证现有数据足够、训练一定找到这些参数,或训练范围外仍然准确。函数值接近也不保证导数接近。严格表述见附录 A.2,后面两个物理案例会分别检验导数和外推。
3.7 Python 实现:先运行一次完整训练步骤
3.7.1 用程序核对刚才的手算
本章的 nn.py 用 Python 列表表示矩阵,只依赖标准库。先把下面的程序与 nn.py 放在同一目录运行;配套目录已经提供了相同的 demo_one_step.py。
python
from nn import MLP

net = MLP([2, 2, 1], hidden_activation="tanh",
          output_activation="linear", loss="mse", seed=0)
net.W = [[[0.8, -0.5], [0.2, 0.9]], [[0.6, -0.7]]]
net.b = [[0.1, -0.2], [0.05]]
x, y = [0.5, -0.3], [0.4]

prediction_before = net.predict(x)[0]
loss_before, dW, db = net.backward(x, y)

# 所有梯度已经用同一组旧参数算好,现在统一更新。
lr = 0.1
for layer in range(len(net.W)):
    for neuron in range(len(net.W[layer])):
        for source in range(len(net.W[layer][neuron])):
            net.W[layer][neuron][source] -= lr * dW[layer][neuron][source]
        net.b[layer][neuron] -= lr * db[layer][neuron]

prediction_after = net.predict(x)[0]
loss_after = net.loss_on(x, y)
print(f"预测:{prediction_before:.6f} -> {prediction_after:.6f}")
print(f"损失:{loss_before:.6f} -> {loss_after:.6f}")运行结果为:
text
预测:0.640796 -> 0.588616
损失:0.028991 -> 0.017788predict 给出当前参数下的预测,backward 计算损失和参数梯度,循环完成参数更新。程序中的 dW、db 与第 3.4 节的手算相对应。先把这一小段读懂,再查看完整类的初始化、批量训练和动量实现。
从损失回到第一层权重,把每段局部导数与最终梯度连起来。
损失 J:0.029
思考与说明
思考当目标值高于预测值时,梯度和权重更新的方向如何改变?
复用本节精确参数;J=(ŷ−y)²/2,展示 ∂J/∂W₁₁,不进行隐式训练。
3.7.2 想看内部实现,从哪里开始
完整模块保留了矩阵运算、激活函数、前向缓存和反向传播的实现。按表 7 的顺序阅读,就能把计算过程与公式对上。
表 7 程序与本章计算步骤的对应
| 阅读位置 | 它在做什么 | 对照内容 |
|---|---|---|
MLP.forward | 逐层计算并保存加权和与激活 | 第 3.6.2 节 |
MLP.loss_and_delta | 计算单样本损失和输出层的 | 第 3.3 节、附录 B.2 |
MLP.backward | 求各层 ,再求权重和偏置梯度 | 第 3.6.3 节 |
MLP.train | 按批次平均梯度,再更新参数 | 第 3.5 节、附录 B.3 |
check_gradient | 用数值差分检查求导结果 | 附录 B.4 |
MLP.__init__ | 创建参数并设置初始值 | 附录 B.5 |
代码下标从 0 开始,self.W[0] 对应公式中的 。activations[0] 保存输入,所以 activations[l] 对应 。把这两个对应关系写在旁边,比同时记住所有下标更容易。
矩阵工具中的 outer 对应式(28)的外积,hadamard 对应逐元素相乘。它们的完整实现、激活函数导数和梯度检查都在 nn.py 中,不需要从正文分段拼接。实际研究可以使用 NumPy、PyTorch 或 JAX;手写矩阵运算有助于理解计算过程,但不是开展研究的前提。
3.7.3 回到 XOR:让参数从数据中学出来
第 3.2.3 节手工指定了一个能够分类 XOR 的网络。现在运行 demo_xor.py,比较没有隐藏层的 模型与含 4 个 Tanh 隐藏单元的 网络。两者都使用 Sigmoid 输出、BCE 损失和全批量梯度下降,训练 8000 轮。
表 8 XOR 问题上两种模型的训练结果(8000 轮)
| 模型 | 参数量 | 最终训练损失 | 四个样本的预测概率 | 分类结果 |
|---|---|---|---|---|
| 无隐藏层 | 3 | 均为 | 无法区分 | |
| 单隐藏层 | 17 | 全部正确 |
无隐藏层的模型给四个样本几乎相同的概率,无法区分两类。加入隐藏层后,这次运行把四个样本全部分对。这与前面的几何解释一致:只在原始输入上调整一条分界线,不足以解决 XOR;隐藏层提供了改变中间特征的能力。
这里展示的是给定随机种子和训练设置下的结果。改变初始化,可能得到不同的训练过程,甚至停在较差的结果上。训练成功不意味着反向传播保证全局最优。
配套的 check_gradients.py 还比较了四种网络配置的反向传播梯度与数值差分;数值检查结果见附录 B.4。手算、梯度检查和 XOR 各检查不同的问题:具体数值是否一致、求导实现是否正确、一次训练是否能解决这个小任务。科学应用还需要检查独立数据上的表现。
3.8 化学与材料中的应用
现在把同一个 MLP 用于三个问题。先看分子溶解度,检查隐藏层是否改善新样本的预测;再回到原子间相互作用,检查能量与受力;最后看水的蒸气压,比较训练范围以外的预测。
这三个案例的数据来源不同:ESOL 使用实测溶解度;势能和蒸气压案例用已知方程生成参考值,便于明确地检验模型偏差。后两者不能当作在真实实验数据上取得的成绩。
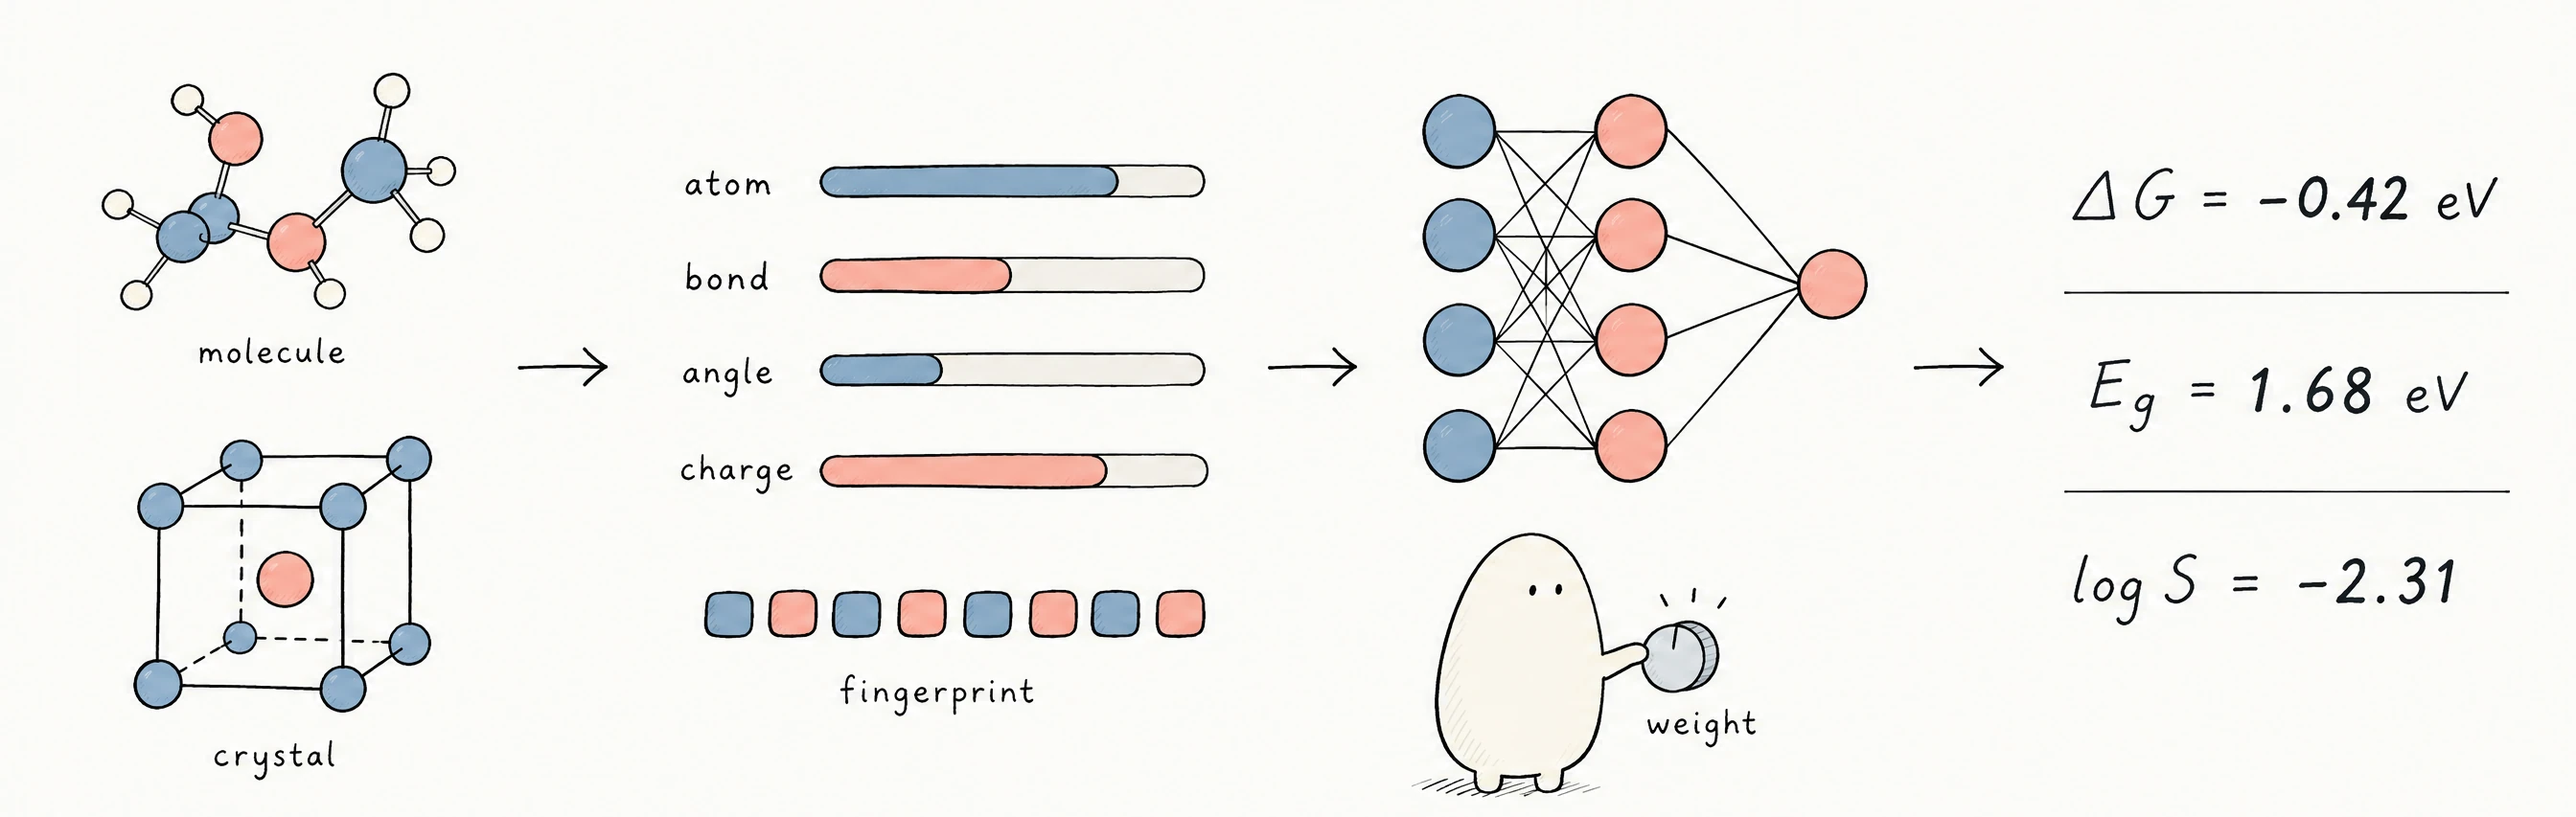
3.8.1 分子水溶解度:隐藏层能否改善新样本预测
3.8.1.1 先固定数据和比较方法
Delaney ESOL 数据集收录了 1128 个有机小分子的实测水溶解度,是 MoleculeNet 基准集的一部分[28][29]。这里先在本案例内建立线性基线,再加入隐藏层,比较两者。
每个分子用五个描述符表示:分子量(MW)、氢键给体数(HBD)、环数(Rings)、可旋转键数(RB)和极性表面积(PSA)。把分子转换成一组数,称为特征化。这里使用的描述符数量固定,可以直接交给 MLP;其他表示方式见附录 B.7。
目标是
它是无量纲量。预测相差 1 个对数单位,意味着原始溶解度相差 10 倍。因此,看到一个 RMSE 数字时,要同时想到它在原始浓度尺度上代表什么。
用随机种子 42 将 902 个分子分入训练集、226 个分子分入测试集。五个描述符用训练集的均值和标准差做标准化,测试集沿用这些统计量。两种模型使用完全相同的数据和输入:
- 线性模型 :直接把五个描述符加权相加;
- MLP :两个 Tanh 隐藏层,分别有 16 和 8 个神经元,恒等输出,共 241 个参数。
两者均使用平方误差、大小为 32 的小批量和 0.9 的动量,训练 300 轮;线性模型学习率为 0.03,MLP 为 0.02。溶解度受到多种因素影响,描述符之间可能存在非线性关联;隐藏层提供了表达这些关联的可能,是否有帮助要看测试结果。
3.8.1.2 先看测试结果,再解释它
表 9 ESOL 数据集上线性模型与 MLP 的预测性能(随机种子 42)
| 评估指标 | 线性模型 | MLP | 变化 |
|---|---|---|---|
| 训练集 | |||
| 训练集 RMSE | |||
| 测试集 | |||
| 测试集 RMSE |
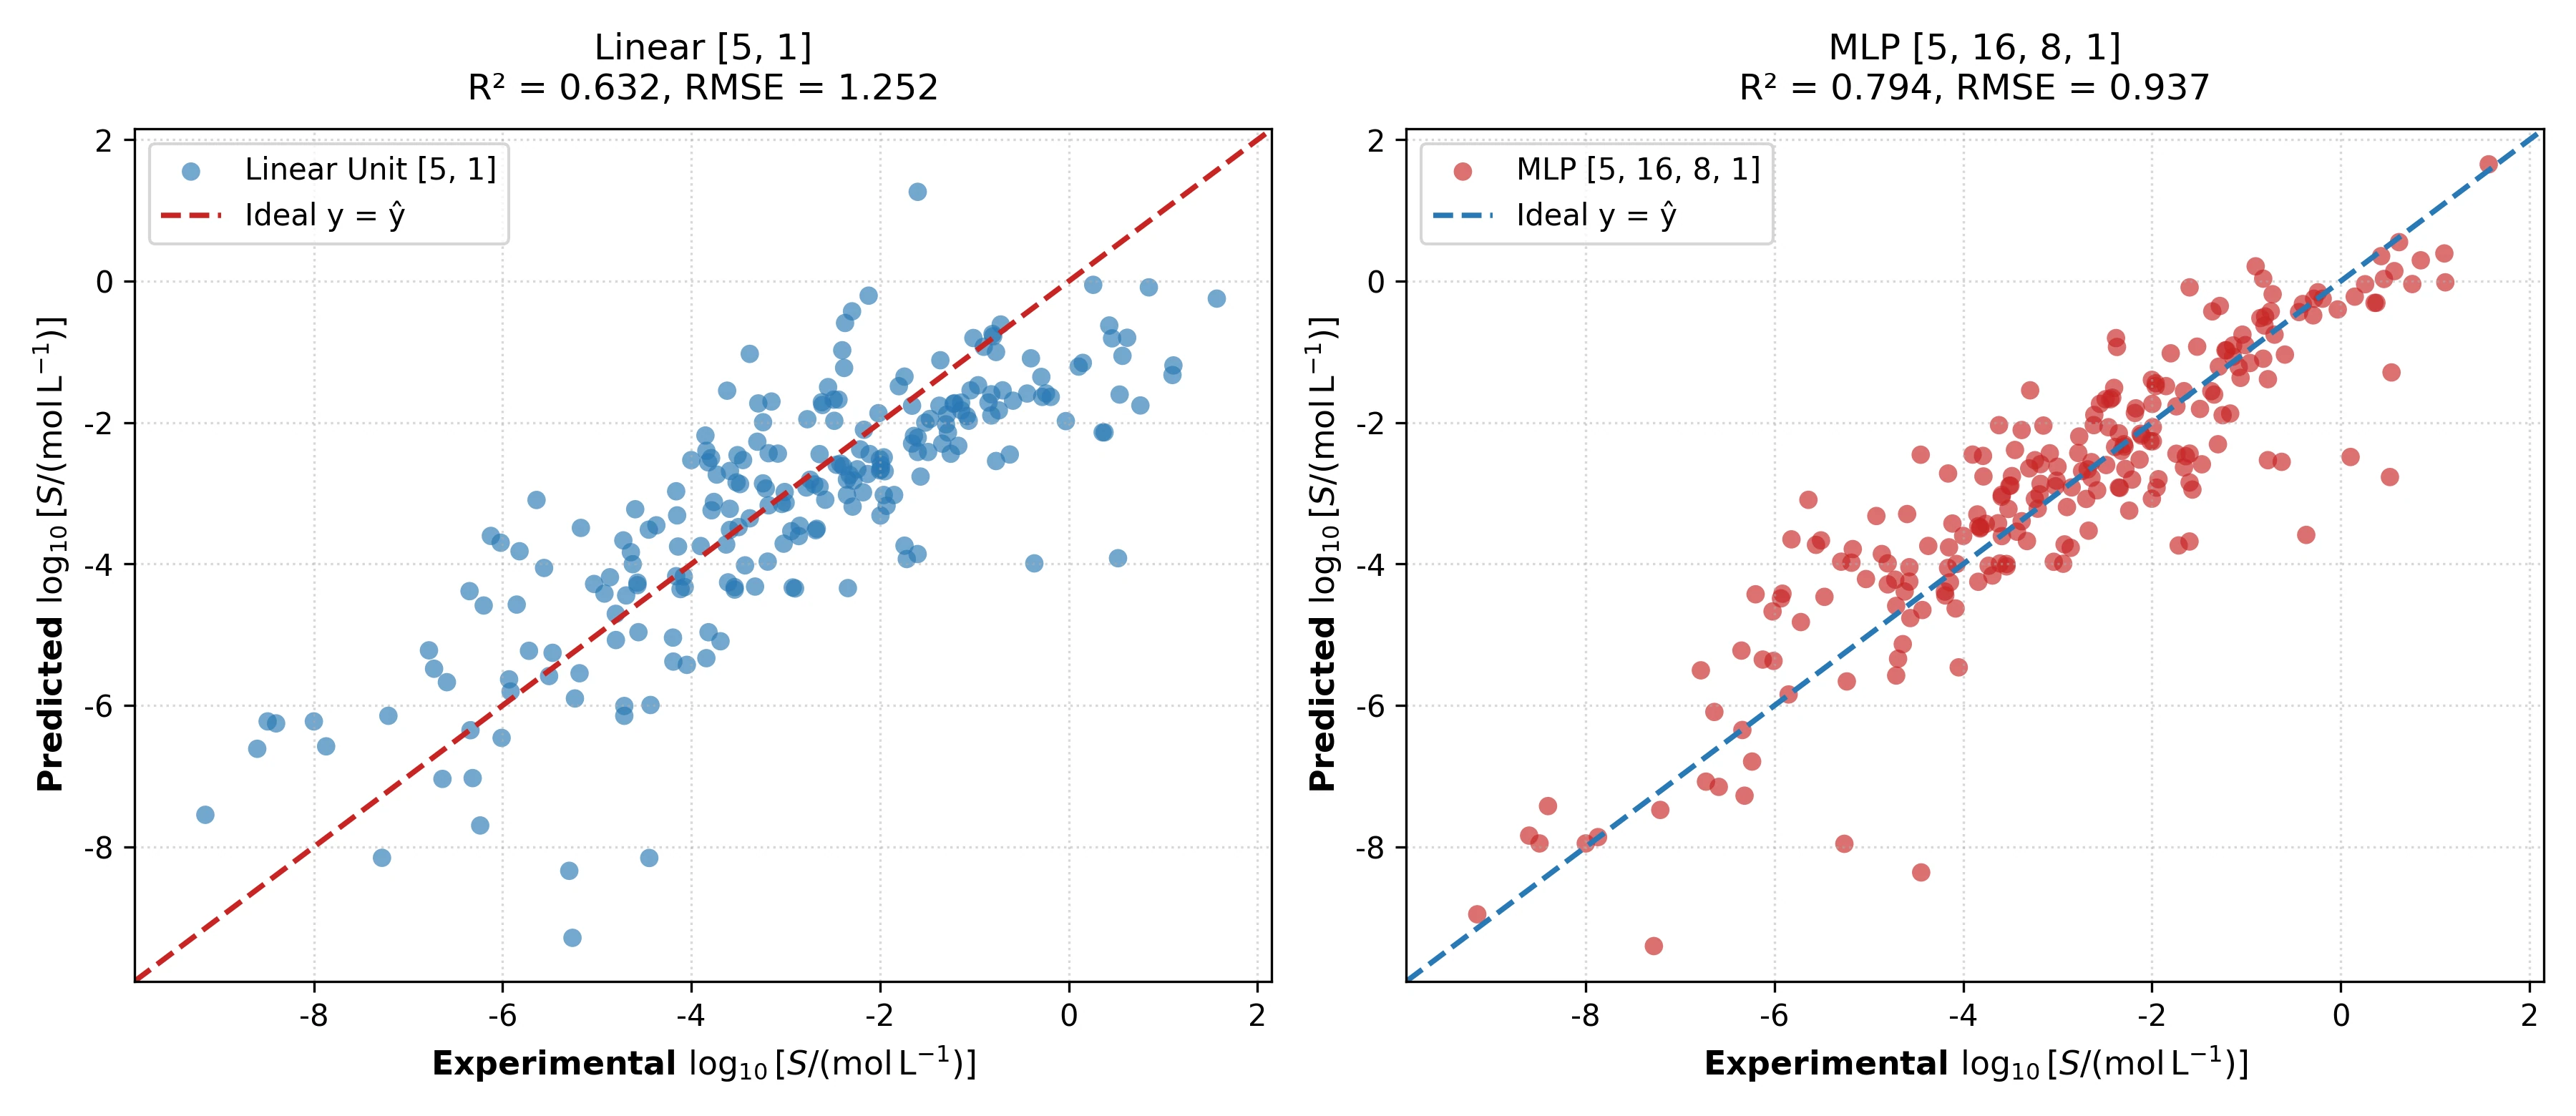
MLP 在这份测试集上的 RMSE 从线性模型的 1.2524 降至 0.9370,约降低 25%。这支持在本次输入、划分和训练设置下,使用非线性模型改善预测。它还不足以证明对所有新分子都有效,更不能说明模型找到了某种溶剂化机制。
再比较训练集和测试集:MLP 在训练集上的 为 0.9035,测试集为 0.7940。这个差距提醒我们关注过拟合,但仅凭差距本身不能判定模型究竟记住了哪些细节。需要结合验证集表现、数据划分和误差分布进一步判断。
3.8.1.3 结果对随机性和基线有多敏感
固定数据划分,只改变网络初始化和训练顺序所用的种子,五次运行的结果如下:
表 10 改变随机种子对 MLP 测试性能的影响(数据划分固定)
| 随机种子 | 0 | 1 | 2 | 3 | 4 | 均值 ± 标准差 |
|---|---|---|---|---|---|---|
| 测试集 | 0.787 | 0.823 | 0.820 | 0.833 | 0.816 | |
| 测试集 RMSE | 0.952 | 0.869 | 0.876 | 0.844 | 0.885 |
同一份数据上, 仍在约 0.79 到 0.83 之间变化。报告模型表现时,应给出多次运行的结果,避免只展示最好的一次。这里改变的是训练随机性,没有改变训练与测试的分组,因此不能用这组波动代替对不同数据划分的评估。
线性基线也需要得到充分优化。本例中用梯度下降训练 300 轮的线性模型尚未完全收敛;直接求最小二乘解时,测试集 为 0.644、RMSE 为 1.231,略好于表 9,但仍低于本例 MLP 的表现。比较模型时,不能把基线训练不足造成的差距算成新结构的优势。
随机划分还可能把结构很相似的分子分到两边。如果研究目标是预测全新骨架,应按骨架分组再比较。当前五个描述符也没有包含 ;输入信息是否足够,是另一个需要检验的问题。可以按骨架或描述符区间检查残差,看看大偏差集中在哪里。
完整程序为 demo_delaney_mlp.py,配套目录含已准备好描述符的 CSV。程序训练两种模型、打印表 9 对应的指标,并在安装 Matplotlib 时绘制预测散点图;多随机种子与最小二乘对照的核验方法见代码说明。
3.8.2 原子间势能:曲线贴近,受力就一定准确吗
3.8.2.1 用已知曲线检查网络
回到本章开头的问题:输入原子间距 ,预测相互作用能 。这里用 Lennard-Jones 势生成数据。在约化单位 下,
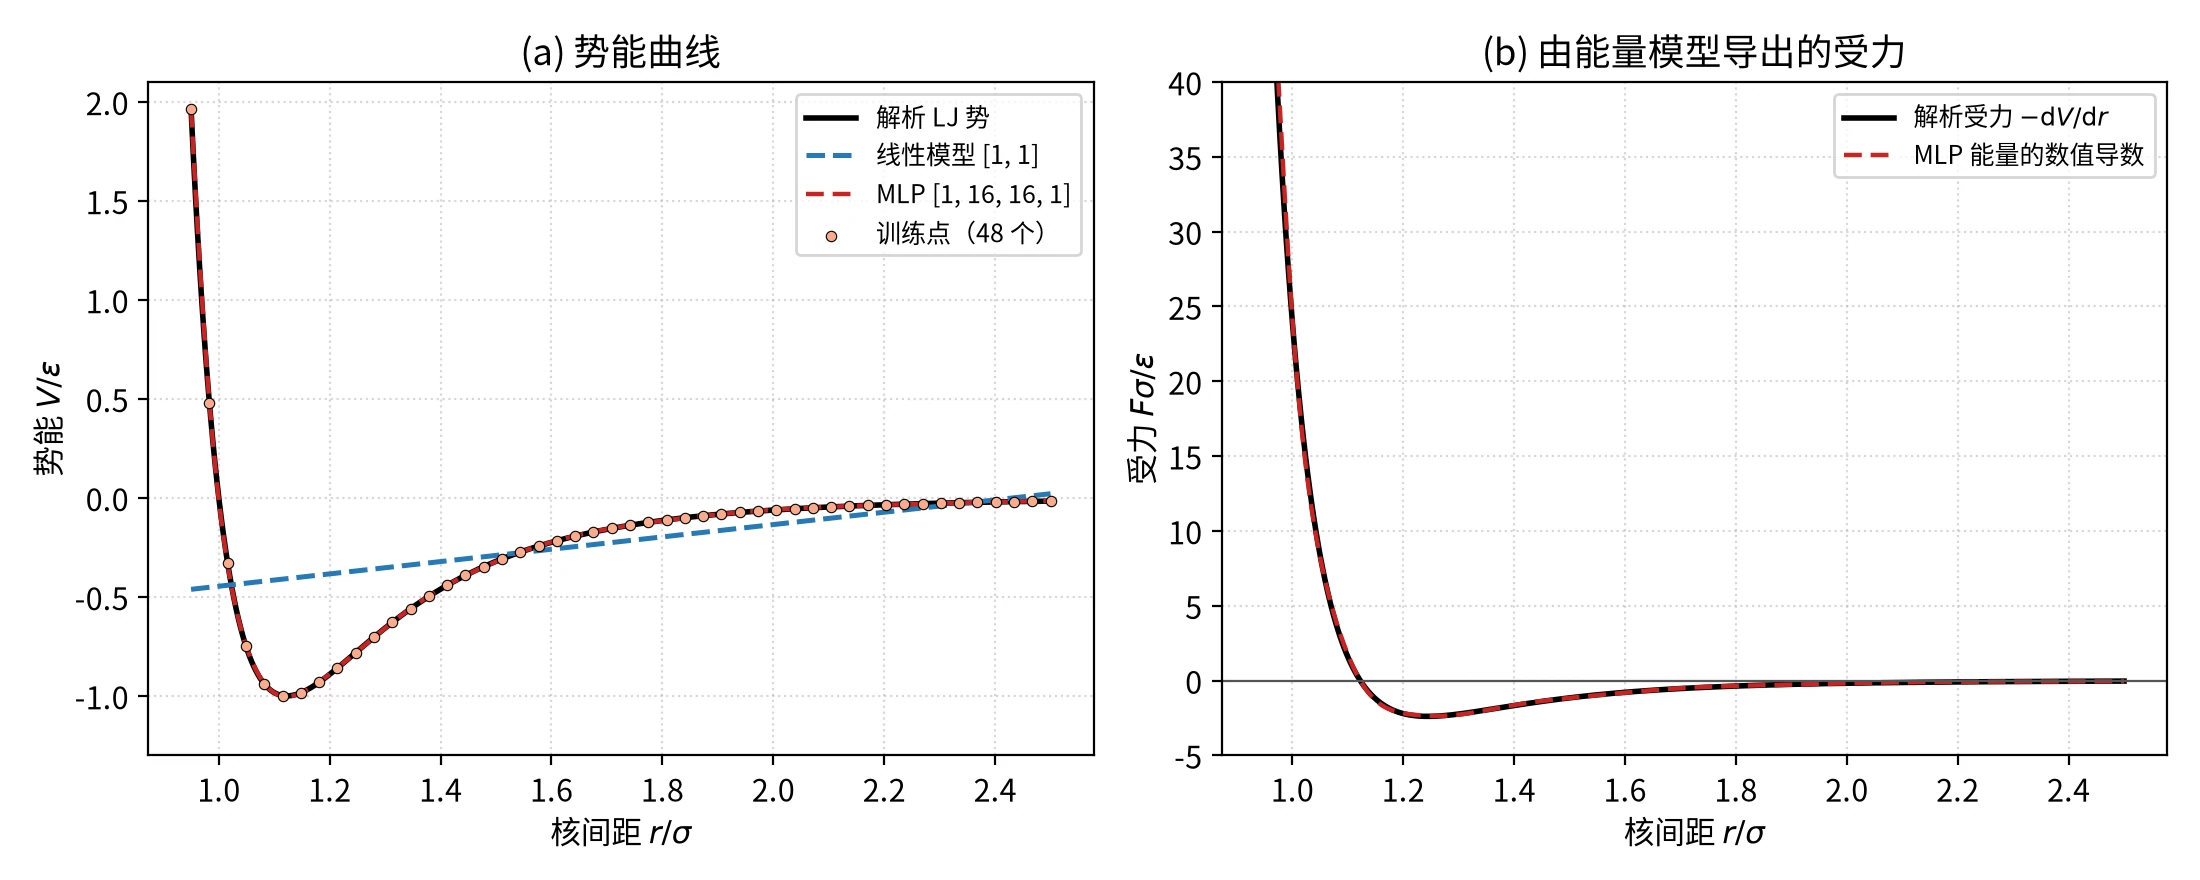
短距离处, 项使能量急剧升高;稍远处出现势阱;距离继续增大时,曲线从负值趋近于零。已知这条解析曲线,我们就能同时检查预测值、极小值位置和斜率。
在 内等间距取 48 个点训练,分别用训练集统计量标准化 和 。比较线性模型 与 Tanh 网络 ,两者都用全批量和 0.9 的动量训练 6000 轮。训练后,在同一区间内用 400 个点组成更密的网格,主要检查训练点之间的插值。
这里是教学用的已知函数拟合。真实神经网络势函数常以电子结构计算的能量和受力作为参考,还要处理多原子环境与对称性;这些区别放在附录 B.6。
3.8.2.2 能量曲线拟合得怎样
表 11 Lennard-Jones 势能曲线的拟合结果(约化单位)
| 物理量 | 解析值 | 线性模型 | MLP |
|---|---|---|---|
| 势阱位置 | 1.12246 | 0.95000(区间端点) | 1.12093 |
| 势阱深度 | −1.00000 | −0.46175 | −1.00270 |
| 400 点网格上的能量 RMSE | — | 0.343075 | 0.004321 |
线性模型只能给出直线,在这个区间内,它的最低点落在端点,无法描述势阱。MLP 复现了势阱的位置和深度:位置相对误差约为 0.14%,深度误差约为 0.3%。位置是在 400 点网格上搜索的,网格间距约为 0.004,结果的有效精度也受它限制。
3.8.2.3 检查斜率与训练范围以外的预测
如果要用势能模型推动原子运动,还需要受力。在这个一维距离模型中,沿径向的力由
得到。能量曲线的高度接近,不代表斜率也接近。本例只用能量训练,再用中心差分对网络预测的能量求导,与解析受力比较。
在 内,受力 RMSE 为 0.077;把区间扩展到包含左端的 后,RMSE 增至 0.51。尤其在 处,解析受力为 59.14,网络得到 51.48,低估约 13%,尽管该处的能量误差不大。
再走出训练区间,能量本身也出现了偏差:
表 12 MLP 在训练区间 之外的能量预测
| 0.85 | 0.90 | 2.80 | 3.20 | |
|---|---|---|---|---|
| 解析值 | 17.515 | 6.636 | −0.0083 | −0.0037 |
| MLP 预测 | 4.741 | 4.015 | 0.0014 | 0.0229 |
在 时,参考排斥能约为 17.5,模型只给出约 4.7;长距离一侧则出现了符号错误。这类有限宽度、Tanh 隐藏层和线性输出的网络,在输入向一端走得足够远时会趋于有限值,无法自动延续 的短程发散。具体某个区间的偏差仍应靠实际预测检查。
如果把低估短程排斥的模型用于分子动力学,训练集未覆盖的近距离构型可能导致不合理的运动或结构。改进时可以加入受力训练、补充短程和高能构型,或显式加入短程排斥项。每种改动之后,都需要重新检验相应的能量、受力和适用区间。
完整程序 demo_lennard_jones.py 包含能量拟合、势阱搜索、受力差分与区间外预测。能量和受力联合训练为什么涉及进一步求导,见附录 B.6。
3.8.3 水的饱和蒸气压:物理变换能否帮助外推
3.8.3.1 给三种模型同一组训练温度
前一个案例已经显示,训练区间内的好成绩不能替代外推检验。现在选择熟悉的水蒸气压,比较“增加模型灵活性”和“利用已知物理关系”两种做法。
参考值由 Wagner–Pruss 饱和蒸气压方程计算[30]。0—80 °C、每隔 10 °C 一个点,共 9 个点用于训练;90 °C 和 100 °C 两个点用于外推测试。这里的数据来自方程,温标与数值约定见附录 B.8。
三种模型分别为:
- A:直接拟合 与摄氏温度 的线性模型,2 个参数;
- B:同样拟合 与 的 网络,321 个参数;
- C:先做物理变换,再用线性模型拟合 与 ,2 个参数。
是以 K 表示的热力学温度, 使对数中的比值无量纲。不能把模型 C 中的 换成摄氏温度。
在蒸气近似理想气体、液体体积可忽略、汽化焓在研究温区内近似不变的条件下,Clausius–Clapeyron 关系给出
因此,原本弯曲的蒸气压关系在这组变量中近似成为直线。模型 C 使用了这种物理信息。方程的推导和近似条件见附录 B.8。
3.8.3.2 把训练表现和外推表现分开看
表 13 三个模型在训练集上的拟合优度与外推误差
| 模型 | 参数个数 | 训练集 (0–80 °C) | 外推 RMSE(90、100 °C)/ kPa |
|---|---|---|---|
| A:线性 | 2 | 0.8277 | 44.279 |
| B:MLP | 321 | 1.0000 | 19.712 |
| C:线性 | 2 | 0.9994 | 4.707 |
表 14 外推温度点上的预测值(单位:kPa)
| 温度 / °C | 参考值 | 模型 A | 模型 B | 模型 C |
|---|---|---|---|---|
| 90 | 70.183 | 40.786 | 63.384 | 72.969 |
| 100 | 101.418 | 46.127 | 74.383 | 107.464 |
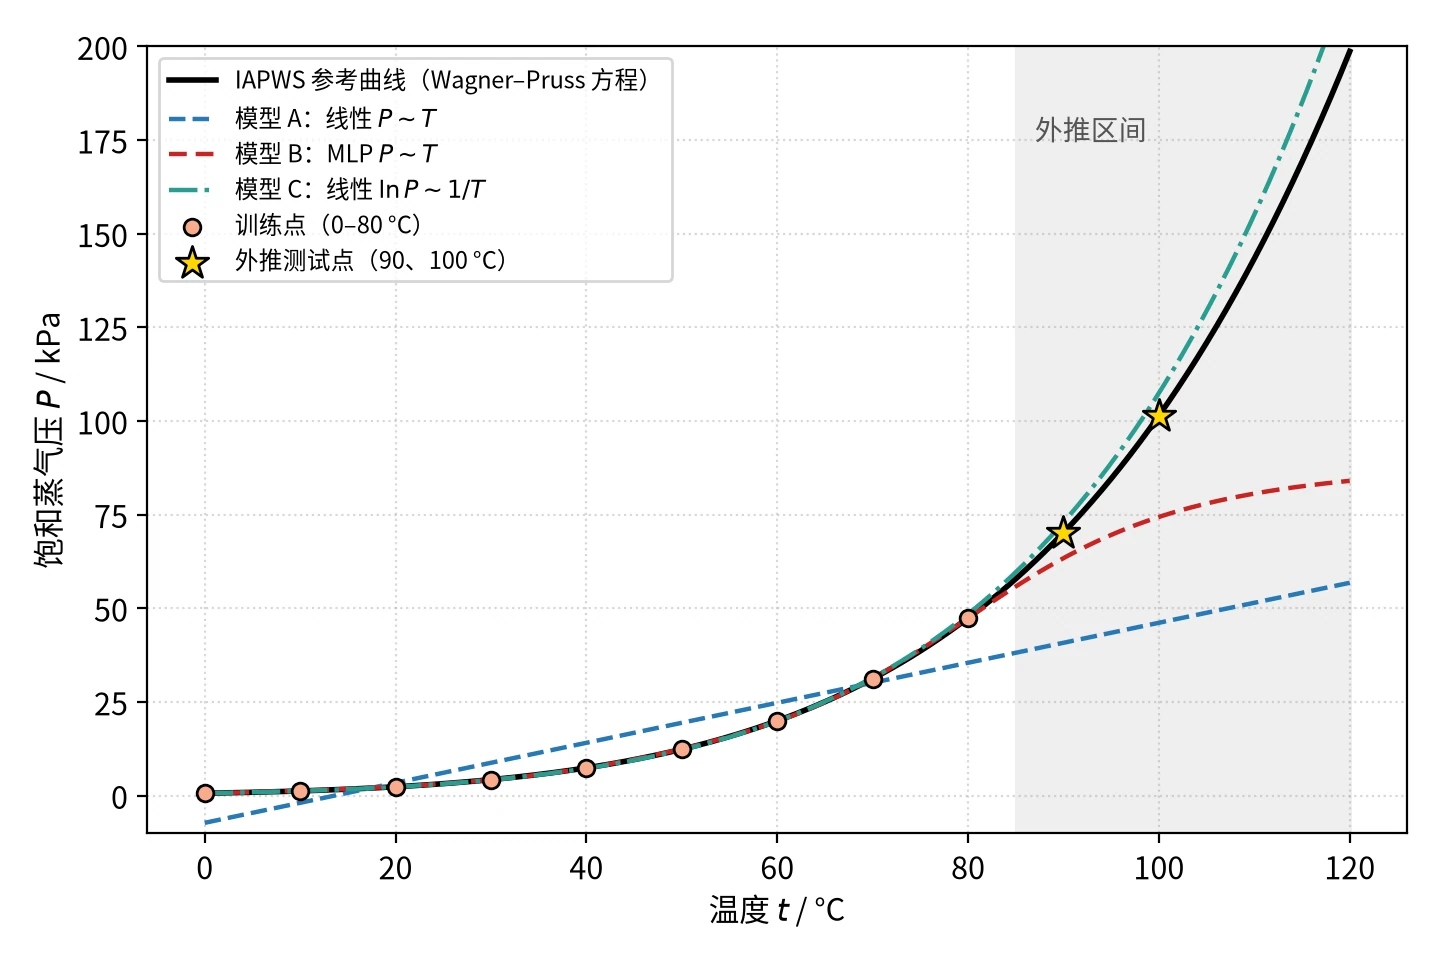
模型 B 的训练集 显示为 1.0000,但在 100 °C 处只预测 74.4 kPa,比参考值低约 27%。这里的 1.0000 是显示精度下的数值,不代表所有训练残差严格等于零。
模型 C 只有两个参数,外推 RMSE 约为模型 B 的四分之一。它在 100 °C 处仍高估约 6%;汽化焓并非在整个温区严格不变,因此这条近似直线也有适用范围。
这个比较支持在本例中使用合适的物理变量变换,但不能单凭结果断定网络外推失败是因为“参数太多”。模型 B 与 C 同时改变了输入、目标变量、参数量和训练设置。进一步的对照是让 MLP 也拟合 与 ,再比较结果。这里只检查了两个外推点,也不足以支持更宽温区的结论。
完整程序为 demo_vapor_pressure.py。到这里,三个案例分别检查了新分子预测、能量导数和温区外推;这些要求需要分别验证。
3.9 怎样判断一个网络是否适合自己的问题
3.9.1 把三种“好”分开
训练损失小,说明网络贴近参与拟合的数据;独立测试误差小,说明它在相应测试条件下能预测未参与训练的样本;对称性、受力和外推检验通过,才为这些额外用途提供支持。
ESOL 案例支持 MLP 在这次随机划分下改善预测;势能案例说明能量误差小仍可能伴随受力偏差;蒸气压案例显示物理变换可以帮助外推。不能用其中一种检查替代另外两种。
3.9.2 灵活性有用途,也需要数据和约束
MLP 能把多个输入逐层组合,不必为每个交互作用手工写出一个特征。反向传播又能高效求出全部参数梯度,这两点使它可以用于复杂关系的拟合。后面的卷积网络、循环网络和图神经网络,也会沿用“计算预测、计算损失、反向求导、更新参数”的过程。
灵活性同时带来模型选择的问题。层数、宽度、学习率、激活函数和训练轮数都可能影响结果;不同初始化也可能得到不同模型。数据没有覆盖的条件,不会因为参数多而自动被学会。高维输入、缺少关键描述符或样本获取昂贵的问题,也不会仅靠增加网络层数解决。
网络加深时,梯度要连续经过多层权重和激活导数。如果沿途反复缩小,前层就几乎收不到更新信号;反复放大则可能使更新不稳定。这分别称为梯度消失和梯度爆炸。不能只凭 Sigmoid 导数不超过 0.25,就断言每层梯度必定缩小为四分之一;权重和计算方向同样有影响。矩阵分析见附录 A.4。
3.9.3 从研究目的决定比较对象
如果已有适用的 Arrhenius、Langmuir 等物理方程,先拟合它们的参数,能得到有物理含义的基线。样本少、输入维度低时,可以把线性回归、高斯过程回归或支持向量机纳入比较,不能预先认为网络一定更好。若要预测远离数据的新温区、新成分或新构型,就单独设计相应测试,并考虑物理约束。
若研究目的是解释机理,预测指标只能提供模型表现的证据,还需要理论计算、实验表征或进一步的分析。若研究目的是筛选候选材料,则可以关注筛选范围内的误差、失败样本和预测不确定性。
用不同随机种子训练多个模型,预测的分散程度可以作为不确定性的粗略线索[18]。它们也可能一起犯错,因此低分散度不保证准确。需要预测区间时,可以比较集成、贝叶斯神经网络或高斯过程,并在独立数据上检查区间是否达到预期覆盖率。
3.10 模型表现不佳时,从哪里查起
先看症状,再选检查方法。同一种现象可能有多种原因,下面的对应关系用于缩小排查范围。
表 15 常见现象与可执行的检查
| 现象 | 先检查什么 | 下一步 |
|---|---|---|
| 小网络连少量样本也拟合不好 | 输入和标签是否对应、形状是否正确、梯度是否一致 | 核对手算例子和数值差分,再调整学习率 |
损失振荡,或出现 NaN、Inf | 学习率、输入尺度、输出与损失的搭配 | 降低步长;检查标准化和稳定的 BCE 实现 |
| 前层梯度很小,训练缓慢 | 加权和是否长期落在饱和区 | 查看各层数值,检查初始化和激活函数 |
| 训练误差小,测试误差大 | 划分是否符合研究用途,模型是否过度贴合训练集 | 用验证集比较复杂度;检查骨架、批次和构型分组 |
| 测试成绩很好,换新体系就失败 | 测试集是否与训练集过于相似,是否参与调参 | 检查重复样本和数据泄漏,补做目标范围的测试 |
| 能量接近,受力却不对 | 求导负号、单位、标准化换算及曲线斜率 | 用已知解析势逐点核对,分别报告能量与受力误差 |
| 旋转、平移或重新编号后能量改变 | 输入和模型是否满足所需对称性 | 改用相应描述符或结构,并实际做变换测试 |
自己实现求导时,先在小网络上做梯度检查;使用已有框架时,也要确认损失、数据和求导路径符合预期。可以再取少量样本,检查网络能否把它们拟合到较低误差,这有助于发现训练流程的问题,但不能作为泛化评估。
划分训练集、验证集和测试集时,职责要明确:训练集用于拟合参数,验证集用于模型选择,测试集留给最终评价。标准化统计量只从训练集计算。要预测什么样的新对象,就应让测试集体现那种差异。
3.11 从全连接网络走向卷积网络
本章把一个样本整理成定长向量,每个后层神经元都接收前层所有输出。对于几个或几十个描述符,这种写法很直接。输入换成显微图像或高分辨率谱图后,就需要进一步考虑数据的排列方式。
例如,一张 像素的灰度图像有 个输入。若第一隐藏层有 1000 个神经元,仅这一层就需要 个权重。图像中同样的缺陷可能出现在不同位置,而普通全连接结构没有内置“在不同位置使用同一组检测权重”的规则。
下一章的卷积网络会让一个计算单元只看局部区域,并在不同位置重复使用同一组权重。这样既减少参数,也利用图像和谱图的局部结构。位置移动后,特征的位置随之移动,称为平移等变;若最后只判断有没有缺陷,还可以进一步追求整体判断对位置不敏感。
3.12 本章小结
回到开头的拟合问题,线性单元只能组合给定特征。加入隐藏层与非线性函数后,网络可以在预测过程中构造中间特征。前向传播依次算出这些特征和最终预测,损失衡量它们与参考值的差距。
隐藏层没有自己的参考答案,但它的参数会通过后续计算影响损失。链式法则让我们逐段计算这种影响;多条路径相加,共用的中间导数复用,就形成了反向传播。梯度下降再用这些梯度更新参数。手算例子和程序把这几步完整连接起来。
三个案例提醒我们,训练完成以后还有不同的检查:分子性质要看未参与训练的分子,势能模型要另查受力,范围外预测要另设外推数据。模型是否值得使用,取决于这些与研究目的相对应的结果。
3.13 思考与练习
3.13.1 先检查是否理解一次训练
- 第 3.2.2 节哪些数来自样本,哪些是参数,哪些是算出的中间结果?前向传播结束时,参数是否已经改变?
- 手算例子的预测偏高,为什么第二个输出权重仍应增大?用 的符号解释,再检查梯度。
- 保持初始参数不变,把参考值改为 ,重算梯度和一次更新。哪些梯度会变号?用程序核对。
- 把
demo_one_step.py中的学习率改大,比较更新前后的损失。沿负梯度方向更新,是否意味着任意步长都能降低损失? - 一个输入 128 维、隐藏层宽度为 64 和 32、输出为 1 维的网络有多少参数?将第一隐藏层加宽到 256 时增加多少?
3.13.2 进一步推导与编程
- 证明 、,并验证 。
- 把 XOR 网络的随机种子改为 0 到 19,统计成功分类的次数,再把隐藏层宽度改为 2,比较结果。
- 对 Sigmoid 输出与 BCE,设 。比较直接由 计算损失和“先算概率,再取对数”的结果,核对梯度是否接近 。
- 推导 Softmax 的 ,再推导交叉熵对 的导数。解释它与逐元素激活有何区别。
- 构造含 10 个隐藏层的网络,分别使用 Sigmoid 和 Tanh,记录各层 的范数。结合权重和激活导数解释结果,避免只用激活函数的最大导数作结论。
3.13.3 把科学问题变成对照实验
- 用 RDKit 计算 ESOL 分子的 Bemis–Murcko 骨架,把相同骨架分在同一组,再比较线性模型与 MLP。该划分检验的用途与随机划分有何不同?
- 将势能训练区间左端扩展到 ,比较 和 的预测。再提出一种加入已知短程排斥项的方案,并分别检查能量和受力。
- 让蒸气压案例中的 MLP 也拟合 与 。保持数据划分一致,比较外推结果,讨论原来的差距有哪些可能来源。
参考文献
希望系统学习深度学习理论的读者,可进一步参阅教材 [32]–[34]。
反向传播与通用逼近理论
[1] Kelley, H. J. Gradient theory of optimal flight paths. ARS Journal, 1960, 30(10): 947–954. DOI: 10.2514/8.5282.
[2] Bryson, A. E. A gradient method for optimizing multi-stage allocation processes. In: Proceedings of the Harvard University Symposium on Digital Computers and Their Applications, 1961.
[3] Linnainmaa, S. The representation of the cumulative rounding error of an algorithm as a Taylor expansion of the local rounding errors. Master's thesis, University of Helsinki, 1970.
[4] Werbos, P. J. Beyond Regression: New Tools for Prediction and Analysis in the Behavioral Sciences. PhD thesis, Harvard University, 1974.
[5] Rumelhart, D. E., Hinton, G. E., Williams, R. J. Learning representations by back-propagating errors. Nature, 1986, 323: 533–536. DOI: 10.1038/323533a0.
[6] Parker, D. B. Learning-Logic. Technical Report TR-47, Center for Computational Research in Economics and Management Science, MIT, 1985.
[7] LeCun, Y. Une procédure d'apprentissage pour réseau à seuil asymétrique. In: Proceedings of Cognitiva 85, Paris, 1985: 599–604.
[8] Cybenko, G. Approximation by superpositions of a sigmoidal function. Mathematics of Control, Signals and Systems, 1989, 2(4): 303–314.
[9] Hornik, K. Approximation capabilities of multilayer feedforward networks. Neural Networks, 1991, 4(2): 251–257.
[10] Leshno, M., Lin, V. Y., Pinkus, A., Schocken, S. Multilayer feedforward networks with a nonpolynomial activation function can approximate any function. Neural Networks, 1993, 6(6): 861–867.
[11] Barron, A. R. Universal approximation bounds for superpositions of a sigmoidal function. IEEE Transactions on Information Theory, 1993, 39(3): 930–945. DOI: 10.1109/18.256500.
初始化、激活函数、优化与正则化
[12] Glorot, X., Bengio, Y. Understanding the difficulty of training deep feedforward neural networks. In: Proceedings of AISTATS, PMLR 9, 2010: 249–256.
[13] Nair, V., Hinton, G. E. Rectified linear units improve restricted Boltzmann machines. In: Proceedings of ICML, 2010: 807–814.
[14] He, K., Zhang, X., Ren, S., Sun, J. Delving deep into rectifiers: Surpassing human-level performance on ImageNet classification. In: Proceedings of ICCV, 2015: 1026–1034.
[15] Srivastava, N., Hinton, G., Krizhevsky, A., Sutskever, I., Salakhutdinov, R. Dropout: A simple way to prevent neural networks from overfitting. Journal of Machine Learning Research, 2014, 15: 1929–1958.
[16] Polyak, B. T. Some methods of speeding up the convergence of iteration methods. USSR Computational Mathematics and Mathematical Physics, 1964, 4(5): 1–17.
[17] Kingma, D. P., Ba, J. Adam: A method for stochastic optimization. In: Proceedings of ICLR, 2015. arXiv:1412.6980.
[18] Lakshminarayanan, B., Pritzel, A., Blundell, C. Simple and scalable predictive uncertainty estimation using deep ensembles. In: Advances in Neural Information Processing Systems 30, 2017. arXiv:1612.08074.
神经网络势函数、分子表示与图神经网络
[19] Behler, J., Parrinello, M. Generalized neural-network representation of high-dimensional potential-energy surfaces. Physical Review Letters, 2007, 98(14): 146401. DOI: 10.1103/PhysRevLett.98.146401.
[20] Bartók, A. P., Kondor, R., Csányi, G. On representing chemical environments. Physical Review B, 2013, 87: 184115. DOI: 10.1103/PhysRevB.87.184115.
[21] Smith, J. S., Isayev, O., Roitberg, A. E. ANI-1: An extensible neural network potential with DFT accuracy at force field computational cost. Chemical Science, 2017, 8(4): 3192–3203.
[22] Schütt, K. T., Sauceda, H. E., Kindermans, P.-J., Tkatchenko, A., Müller, K.-R. SchNet – A deep learning architecture for molecules and materials. The Journal of Chemical Physics, 2018, 148(24): 241722.
[23] Gasteiger, J., Groß, J., Günnemann, S. Directional message passing for molecular graphs. In: Proceedings of ICLR, 2020. arXiv:2003.03123.
[24] Chen, C., Ye, W., Zuo, Y., Zheng, C., Ong, S. P. Graph networks as a universal machine learning framework for molecules and crystals. Chemistry of Materials, 2019, 31(9): 3564–3572.
[25] Batatia, I., Kovács, D. P., Simm, G. N. C., Ortner, C., Csányi, G. MACE: Higher order equivariant message passing neural networks for fast and accurate force fields. In: Advances in Neural Information Processing Systems 35, 2022: 11423–11436.
[26] Wang, H., Zhang, L., Han, J., E, W. DeePMD-kit: A deep learning package for many-body potential energy representation and molecular dynamics. Computer Physics Communications, 2018, 228: 178–184. DOI: 10.1016/j.cpc.2018.03.016.
[27] Butler, K. T., Davies, D. W., Cartwright, H., Isayev, O., Walsh, A. Machine learning for molecular and materials science. Nature, 2018, 559: 547–555.
数据集与物性数据
[28] Delaney, J. S. ESOL: Estimating aqueous solubility directly from molecular structure. Journal of Chemical Information and Computer Sciences, 2004, 44(3): 1000–1005.
[29] Wu, Z., Ramsundar, B., Feinberg, E. N., et al. MoleculeNet: A benchmark for molecular machine learning. Chemical Science, 2018, 9(2): 513–530.
[30] Wagner, W., Pruß, A. The IAPWS formulation 1995 for the thermodynamic properties of ordinary water substance for general and scientific use. Journal of Physical and Chemical Reference Data, 2002, 31(2): 387–535.
[31] Chithrananda, S., Grand, G., Ramsundar, B. ChemBERTa: Large-scale self-supervised pretraining for molecular property prediction. arXiv:2010.09885, 2020.
教材与专著
[32] Goodfellow, I., Bengio, Y., Courville, A. Deep Learning. MIT Press, 2016.(第 6 章“深度前馈网络”、第 8 章“深度模型中的优化”)
[33] Nielsen, M. A. Neural Networks and Deep Learning. Determination Press, 2015.(在线教材,对反向传播四个方程有直观的讲解)
[34] Bishop, C. M. Pattern Recognition and Machine Learning. Springer, 2006.(第 5 章“神经网络”)
附录 A 数学补充
这里补充正文暂时略过的推导。第一次阅读可以在完成手算和案例后再回来查阅。
A.1 XOR 的线性模型为什么停在一半一半
没有隐藏层、使用 Sigmoid 输出的模型为 ,也就是逻辑回归。对四个等权 XOR 样本,令参数全为零,预测都为 0.5,残差依次为 。
平均 BCE 对偏置的梯度为残差平均值,等于零;对 的梯度为残差与 乘积的平均值,也等于零; 同理。逻辑回归的 BCE 关于这些参数是凸函数,因此这个驻点是全局最小值,最优平均损失为
这个结论用到了四个样本的对称布局、等权损失和当前模型形式,不能推广为“所有线性不可分数据的最佳预测都是 0.5”。第 3.7.3 节的结果验证的是这里的特定问题。
A.2 通用逼近定理回答了哪个问题
一种经典表述是:设 为有界闭集, 在 上连续。对任意 ,存在隐藏单元数 及参数,使单隐藏层 Sigmoid 网络满足[8][9]
上确界符号 表示考察整个 上的最大偏差;不等式说,在这个区域的各处,误差都能小于指定的 。相关结果可以推广到满足相应条件的非多项式激活函数,包括 Tanh 和 ReLU[10]。
这里的 是预先指定的区域,不能把有限训练点直接等同于对整个区域的保证。定理没有给出训练样本量,没有保证优化算法找到所需参数,也没有保证 之外或导数的精度。
Barron 的结果进一步讨论了某类满足特定正则条件的函数随隐藏单元数增加的逼近误差[11]。在相应条件下,平方积分误差有 的界,对应的均方根量级为 。这不是所有科学数据或所有训练网络都满足的误差规律。
A.3 四个方程的分量形式
先看输出层。按多元链式法则,
恒等、Sigmoid、Tanh 和 ReLU 都逐元素作用: 只依赖同一位置的 ,所以 的项为零。这就得到正文式(26)的逐元素相乘。Softmax 的各输出彼此相关,需要完整的求和,见附录 B.2。
对隐藏层,第 层第 个激活会进入下一层各神经元的加权和,因此
把最后一个因子提到求和外,剩下的正是 的第 个分量。
最后考察权重 。它只出现在本层第 个神经元的加权和中。令 为克罗内克符号: 时为 1,否则为 0,则
克罗内克符号 与反向传播中的 是两种记号,前者只有两个下标,后者带层号。把所有 排成矩阵,就得到外积式(28)。偏置对自己的加权和的导数为 1,因此得到式(29)。
若把激活函数的导数排成对角矩阵,还能看出逐元素相乘的来源:
代码直接逐元素相乘,就不必构造和存储这个含有大量零的矩阵。
A.4 雅可比矩阵与梯度的逐层变化
雅可比矩阵把“各输出对各输入的偏导数”排在一起。令 ,相邻两层加权和之间的雅可比矩阵为
它有 行、 列。用它的转置乘下一层的 ,就得到
反复应用,便得到
计算从最右侧开始,每次是矩阵乘向量。程序不必先构造所有雅可比矩阵的乘积。在自动微分中,这类计算称为向量–雅可比积;按正文的列向量约定,写作雅可比转置乘向量。反向传播是反向模式自动微分在网络上的应用。
再令 ,用矩阵范数可得
是最大奇异值,描述这个矩阵最多能把向量放大多少。如果各层都满足 ,前层梯度至多按 衰减。若某些因子很大,则可能出现放大;但这个式子只是上界,各层最大奇异值都大于 1 也不保证实际梯度一定增长,方向同样重要。
激活函数、初始化、归一化层和残差连接都会影响这种传递。理解这一点后,再阅读后续深层模型,比只记“某种激活会消失、另一种不会”更准确。
A.5 为什么求全部梯度不必逐个重算预测
设网络有 个参数,一次前向计算的代价为 。中心差分需要为每个参数分别做正、负扰动,约需 的计算。反向传播用一次前向加一次反向,代价为 的常数倍,具体倍数取决于运算和实现。
对单样本的全连接网络, 大致与 成正比,逐参数差分的代价随 增长,而反向传播随 增长。因此参数达到百万量级时,二者的代价可能相差约百万的量级。这里比较的是增长方式,不是某个硬件上的实测加速比。
效率来自共享中间导数:一个神经元的 可以被它的全部输入权重和偏置使用,也用于继续求前层的导数。前向时保存中间量,正是为了避免在这些步骤中反复计算。
附录 B 实现细节与延伸阅读
B.1 损失函数的统计含义
在观测误差独立、服从相同方差的高斯分布等假设下,最小化平方误差对应最大似然估计。平方项对大残差惩罚较重,也使结果对离群值敏感;若数据中存在异常测量,可以比较平均绝对误差(MAE)或 Huber 损失,并结合误差来源选择。
二分类的 BCE 则是伯努利观测模型的负对数似然。它评价模型给真实标签分配的概率,不只是检查概率超过阈值以后类别是否正确。
对单输出平方损失,一个常用的求导模式是
残差告诉我们预测偏向哪边,第二项告诉我们这个参数怎样影响预测。两者结合,才能判断参数的局部调整方向。
B.2 激活函数、交叉熵与数值稳定性
先看隐藏层激活。 Sigmoid 和 Tanh 在两端趋于平坦,导数接近零。Tanh 的输出可正可负,原点处斜率为 1;Sigmoid 输出为正,原点处斜率为 。二者满足
计算导数时,可直接使用前向保存的 :Sigmoid 用 ,Tanh 用 ,不必再次计算指数函数。ReLU 则用 的符号判断导数。
ReLU 在正半轴导数为 1,在负半轴为 0。若某个单元对全部训练样本都处于负半轴,它的输入权重得到的梯度会为零,常称为“神经元死亡”。但上游参数变化仍可能让它重新进入正半轴,所以不必把这一现象理解为绝对不可逆。需要对能量求导得到平滑受力时,还应考虑激活函数的光滑性。
饱和与浮点舍入是相关但不同的问题。 双精度下, 本身能够表示,但在计算 时,这个很小的增量可能被舍掉,于是 得到恰好为 1 的浮点结果。再用 ,便得到 0。这是加法舍入,不是 已经下溢为零。
对隐藏层,标准化和合理初始化可以减少长期饱和。对分类输出,还可以利用损失与激活联合求导的化简。若 Sigmoid 搭配平方误差,
当预测接近错误的一端时,残差很大,但 很小,参数可能调整得很慢。若搭配 BCE,
这个约分应在写代码前完成。程序若先分别计算两个因子,在 被舍入为 0 或 1 时就可能出问题。
损失也可以直接由加权和 (分类时也称 logit)计算:
指数中的数始终非正,避免了大正指数溢出。例如 时,损失约为 100,梯度约为 ,错误的高置信度预测仍得到修正信号。nn.py 使用这个形式;框架中的融合损失如 BCEWithLogitsLoss 也用于处理这种计算。
Softmax 需要区分对待。 它把多个打分变成和为 1 的概率:
每个 都依赖所有 ,其雅可比矩阵为 ,不能直接套用逐元素激活的求导形式。与多类交叉熵 联合求导,在 时仍得到 。实现时通常使用 log-sum-exp 稳定计算。本章模块只支持逐元素激活,没有实现 Softmax。
B.3 动量、小批量与训练记录
动量法[16]保存一个与参数同形状的速度变量:
控制过去方向保留多少,取零就回到普通梯度下降。在来回振荡的方向上,相邻梯度可能抵消;在持续下降的方向上,更新则可以积累。它与学习率需要一起选择,不能保证每一步损失都下降。
本章程序每轮先打乱样本,再按批次计算单样本梯度、累加并取平均。train 返回的损失历史是各批次更新前损失的平均,不是这一轮结束后用最终参数重新计算的训练集损失。若要报告最终训练指标,应重新计算一次。
反向传播只提供梯度,更新方法还可以采用 Adam[17]或其他优化器。更换优化器不改变链式法则,也不保证非凸损失一定达到全局最低点。
B.4 用数值差分检查梯度
对一个参数做正、负扰动,重新计算损失,可以近似得到偏导数:
其余参数保持不变。中心差分在光滑条件下的截断误差为 。它不适合用于大网络的逐参数训练,却适合检查一个小网络的反向传播实现。
比较解析梯度与数值梯度时,可以使用相对误差
程序给分母设置 的下限,避免两者都接近零时除零。此时还要同时看绝对误差。 太大,近似误差增大;太小,相近浮点数相减会损失有效数字。双精度的小型光滑网络可以从 左右开始,并改变步长检查结果是否稳定。
差分格式
在反向传播中注入错误
激活 / 样本
整体相对误差1.1e-11通过
最佳 ε1e-4.9误差 1.4e-11
各层 W 相对误差2.8e-10 / 3.6e-11 / 2.7e-12
各层 b 相对误差3.6e-10 / 8.8e-12 / 2.7e-12
相对误差 vs 扰动步长(双对数)2–4–3–1 网络,共 35 个参数逐一扰动
实测 10⁻⁷ / 10⁻⁴ 判据
配套脚本在四种配置上分别生成 5 个样本,比较两种求导结果。本次核验得到:
表 16 四种配置的梯度检查()
| 隐藏激活与损失 | 网络结构 | 参数量 | 最大相对误差 |
|---|---|---|---|
| Tanh + MSE | 26 | ||
| ReLU + MSE | 21 | ||
| Sigmoid + BCE | 13 | ||
| Tanh + MSE | 35 |
差分涉及浮点相减,运行环境变化时末位和相对误差可能变化;这里关心的是它们在这些测试点上保持很小。该检查提供数值一致性的证据,不代替数学证明,也不覆盖所有输入。
对 ReLU,扰动若跨过零点,两种梯度可能不一致而实现仍然正确。对接近零的梯度,相对误差可能偏大。对 BCE,还应检查 这类极端情形,不能只测试零点附近。
B.5 参数初始化与代码的边界
初始权重太大,Sigmoid 或 Tanh 可能很快饱和;太小,多层信号可能逐渐缩小。初始化方案依据输入和输出宽度调整随机权重尺度:
- 本章对 ReLU 隐藏层采用 He 初始化,方差为 [14];
- 其余层采用 LeCun 初始化,方差为 ;
- 常见的 Glorot(Xavier)初始化取方差 [12]。
这里的 是该层输入数量,也称 fan-in。上述选择基于信号方差的近似分析,目的是让训练初始阶段的尺度较合适,不保证整个训练过程中都稳定。偏置初始化为零。
教学模块用嵌套列表表示矩阵,没有对所有输入形状逐项检查,调用时需要保证输入长度、输出长度与网络结构相符。get_params 和 set_params 把参数展平或恢复,供数值差分逐参数扰动。activation_prime 同时接收 和 ,分别满足 ReLU 与 Sigmoid/Tanh 的导数计算需要。
完整实现与正文的短程序见配套代码目录。矩阵工具、激活函数和网络主体都保留在一个模块里,方便直接打印中间结果。
B.6 从一维曲线到真正的神经网络势函数
对多原子体系,能量是原子坐标 的函数,力为
经典力场如 OPLS、CHARMM 的常见形式使用固定成键拓扑;反应力场另有描述成键变化的形式和适用范围。从头算分子动力学在每一步进行电子结构计算,计算成本限制了可覆盖的体系和时间尺度。神经网络势函数则用参考计算数据学习构型到能量的关系,希望在所检验的范围内兼顾精度和速度。
这里要区分两层误差:网络对参考数据的拟合误差,以及参考方法本身相对于目标物理量的误差。把第一层误差降低,不能直接证明已经消除了第二层误差。
Behler–Parrinello 势把总能量写成各原子贡献之和,并使用原子中心对称函数描述局部环境[19]。ANI[21]、DeePMD-kit[26]、SchNet[22]、DimeNet[23]和 MACE[25]分别展示了不同的模型与工具路线。它们在输入表示和网络结构上远比本章一维 MLP 丰富,不能把一条双原子曲线拟合成功等同于通用势函数已经可用。
先明确模型应该满足的变换规律。 对没有外场的孤立体系,整体平移或旋转分子,能量应保持不变:
若能量模型满足这些不变性,并由它求导得到受力,那么受力会随旋转一起转动;平移不变性对应合力为零,旋转不变性对应合力矩为零。还应满足同种原子重新编号后能量不变。
直接把笛卡尔坐标排成向量输入普通 MLP,并不会自动满足这些条件。原子间距离虽不随整体平移和旋转改变,但距离矩阵在重新编号后行列会重排,直接展平仍未解决置换问题。实际方法可使用 ACSF、SOAP[20]等不变描述符并汇总原子贡献,或在网络结构中保证需要的变换规律。
能量是标量,受力和偶极矩是向量,极化率是二阶张量,要求并不相同。本章的双原子案例只使用距离 ,自然避开了许多原子排列问题,因而适合先专注于拟合和求导。
能量与受力联合训练需要再求一次导数。 一种损失形式为
先对坐标求导得到受力,再对参数求损失梯度,会出现 这样的混合二阶导数。本章模块只实现对参数的一阶反向传播,因此案例用能量训练、用数值差分检查受力,没有实现联合训练。支持高阶自动微分的框架可用于这类计算。
B.7 分子表示和其他应用
本章使用固定长度描述符,但输入表示可以有多种选择:
表 17 常见的分子与材料表示方式
| 表示方式 | 典型预测目标 | 代表性方法 |
|---|---|---|
| 物理化学描述符(分子量、极性表面积、氢键给体数等) | 沸点、油水分配系数 、溶解度、毒性 | 经典 QSPR/QSAR 模型 |
| 分子指纹(ECFP、MACCS 等二进制结构片段编码) | 生物活性分类、高通量虚拟筛选 | 药物化学中的常规筛选流程 |
| 分子图或晶体图(原子为节点,化学键或空间近邻为边) | 能量、偶极矩、HOMO 能级、形成能 | SchNet[22]、DimeNet[23]、MEGNet[24] 等图神经网络 |
| SMILES 字符串 | 性质预测、逆合成规划 | 序列模型、化学语言模型(如 ChemBERTa[31]) |
分子图以原子为节点,以化学键或近邻关系为边,用消息传递组织信息交换;其中也可以包含矩阵乘法和 MLP,并同样通过反向传播训练。第 8 章将展开讨论。固定长度描述符便于本章计算,却可能遗漏任务需要的结构信息。
在反应性能预测中,底物、催化剂、配体、溶剂和实验条件可以编码为输入,产率或对映选择性作为输出。困难常来自样本少、骨架集中、记录不完整和批次偏差;应按实际预测目标设计分组,而不只看随机测试成绩。
谱图可离散化为强度数组,用于预测官能团、配位环境或结构参数。局部峰形与位置关系为卷积网络提供了可利用的信息,下一章会讨论这种结构。
逆向设计则把目标性质作为改进候选结构的依据。一种做法是固定训练好的性质网络,对连续输入或隐变量求梯度,再调整这些变量并解码回候选分子。此时求导对象是输入,训练时求导对象则是参数。离散的分子连接关系不能直接按连续变量求导,所以采用这条梯度优化路线时,需要合适的连续表示;这不是所有逆向设计方法都必须采用的路线。VAE、GAN 和扩散模型将在后续章节介绍。
B.8 蒸气压案例的物理近似与数值约定
液–气共存线满足 Clapeyron 方程:
将蒸气近似为理想气体、忽略液体摩尔体积,可取 ,从而有
再把汽化焓视为研究温区内的常数,积分就得到正文式(34)。接近临界点、气体明显偏离理想行为,或温区宽到汽化焓变化不能忽略时,应重新检查这些近似。
案例使用 Wagner–Pruss 参考方程[30],摄氏温度按 ITS-90 处理。按该约定,101.325 kPa 下的正常沸点约为 99.974 °C,100 °C 时饱和蒸气压约为 101.418 kPa。正文直接沿用同一方程生成的参考值,避免把不同温标或近似数值混用于误差比较。
B.9 反向传播的来源与相关概念
反向传播有多个历史来源。20 世纪 60 年代初,Kelley 和 Bryson 在最优控制中研究目标函数对控制变量的灵敏度,用到了沿逆向计算的伴随思想[1][2]。Linnainmaa 在 1970 年提出了反向模式自动微分的通用方法[3];Werbos 在 1974 年讨论了将相关思想用于可学习系统[4]。Parker 和 LeCun 在 20 世纪 80 年代也分别研究了多层网络的训练[6][7]。
Rumelhart、Hinton 和 Williams 在 1986 年的工作展示了反向传播训练多层网络、学习内部表征的效果[5],推动了这一方法的传播。后来,计算硬件、数据规模以及 ReLU[13]、Dropout[15]等方法扩展了可训练模型的规模;链式法则仍是其中的求导基础。
本章所用的函数与物理化学中熟悉的函数关系相通,例如 、 或依赖浓度的速率关系。作为术语补充,函数 接收有限维坐标;密度泛函理论中的 接收整个电子密度函数。本章不需要先学习泛函分析,便可以理解这里的 MLP 与反向传播。更系统的背景可参考文献[27]及教材[32]—[34]。