Appearance
前言:人工智能与生成式模型驱动的材料化学新进展
“宇宙中最不可理解的事情,就是它是可以被理解的。”
—— 阿尔伯特·爱因斯坦(Albert Einstein)
序曲:第四范式与物质设计思路的转变
物质科学的突破一直影响着人类社会:青铜与生铁改变了农具和城邦,硅基高纯半导体推动了现代微电子与信息技术;合成氨工业化支撑了全球粮食生产,高分子材料、靶向抗肿瘤小分子与锂离子动力电池也改变了当代社会的能源与生命科学图景。
物质科学的研究范式也在持续演变:
- 第一范式:实验唯象学——古代炼金术与早期近代化学,依赖经验盲试与偶然发现;
- 第二范式:理论推演与经典热力学——麦克斯韦方程组、吉布斯自由能定律与热力学四大基本定律的建立;
- 第三范式:计算与从头算模拟——随着薛定谔波动方程(Schrödinger Equation)与狄拉克相对论量子力学的确立,以及 20 世纪下半叶密度泛函理论(Density Functional Theory, DFT) 的成熟,科学计算使得研究人员得以在计算机中“求解”多电子体系的基态能量;
- 第四范式:数据密集型与人工智能驱动发现(AI for Science)——面对高维离散的庞大物质空间,现代机器学习(尤其是深度学习与生成式模型)正将人类从漫无目的的“正向筛选”解放出来,转入目标导向的“按需逆向设计(Inverse Design)”。
当前的关键交汇点是:以连续微积分、群论对称性与薛定谔方程为代表的微观物理定律,正与现代人工智能的离散表示、概率图模型和生成流形结合起来。
一、 未探明的化学空间
可观测宇宙中大约有 个星系、约 颗恒星。分子的化学空间(Chemical Space)同样庞大(如图 1 所示)。
根据理论化学与图论组合学的经典统计估算(如瑞士伯尔尼大学 Reymond 团队建立的 GDB-17 数据库及相关理论推导),仅在分子量小于 500 Da、由常见元素(C、H、N、O、S、P、卤素等)构成且满足基本化学价键规则与成药几何规律的类药有机小分子空间中,理论上可能稳定存在的化学实体总量高达
如果进一步迈入无机固态物理与晶体材料领域,结合元素周期表中 118 种元素的不同化学计量比、230 个无机空间群(Space Groups)的几何对称性、格点取代固溶度以及晶胞体积与原子配位多面体的连续自由度,潜在的亚稳态无机化合物与固态相图更是趋于无穷大。
相比之下,自现代有机合成发展以来的两百余年间,全球公开数据库(如《化学文摘》CAS Registry、PubChem、剑桥晶体结构数据库 CSD 以及无机晶体数据库 ICSD/Materials Project)中记录并确认合成的化合物总量约为
这意味着
(左端取空间估计的上限 ,右端取下限 ,只是数量级估算。)两者相差悬殊,说明绝大部分化学空间仍未被探索。其中可能包括具有更高超导临界温度()的材料、电导率更高的固态电解质、兼具高活性与高稳定性的析氧反应(OER)电催化剂,以及能够准确降解致癌蛋白的分子胶水。
传统试错与高通量筛选(HTS)的算力天花板
在很长一段时间里,科学界探索这片尚未探明的化学空间的主要手段依赖于:
- 经验试错与先导化合物衍生:化学家基于天然产物母核或偶然发现的母体结构,通过人工取代反应合成同系物;
- 高通量实验与虚拟筛选(High-Throughput Screening, HTS):构建包含数百万甚至数千万分子的数字虚拟库,利用基于物理经验的分子对接(Docking)或基于量子力学的第一性原理从头算(DFT)进行穷举计算。
然而,这种正向“大海捞针”的筛选范式正遭遇严峻的物理与算法瓶颈:
- 物理计算复杂度的增长:求解非相对论多体薛定谔方程面临维数灾难。即使采用局域密度近似(LDA)或广义梯度近似(GGA)的密度泛函理论,自洽场(SCF)迭代的计算复杂度通常仍为 ;若采用更高精度的杂化泛函、随机相近似(RPA)或耦合簇理论(CCSD(T)),计算开销大幅上升至 。面对数千万级的候选,即使是大型超算集群,算力也会很快不够用;
- 组合图空间的离散断崖(Activity & Stability Cliffs):化学分子与晶胞在拓扑上是高度非线性的离散实体。在分子图上哪怕置换一个杂原子或改变一个甲基手性,或者在晶格中轻微移动几分之一埃的原子坐标,都可能由于泡利排斥力、立体位阻或配位电荷突变,导致目标物理性质(如半导体直接带隙、受体抑制亲和力、热力学形成能)发生断崖式跃迁。
传统的枚举筛选既无法穷尽广袤的空间,也难以预测未曾收录的全新化学骨架。要穿透这片庞大的未知化学空间,需要新的方法。
二、 范式转变:从正向“大海捞针”到按需“逆向设计”
传统计算材料与计算化学致力于解决的是正向性质预测(Forward Property Prediction):
其中, 为微观结构输入(如分子图、晶格常数与原子坐标), 为可观测的宏观或微观物理化学性质(如形成焓 、能带隙 、结合自由能 、热容 等)。近十年来,基于图神经网络的预测器(如 SchNet$^{[8]}^{[9]}^{[10]}$)在若干基准体系上以远低于 DFT 的计算成本给出了接近 DFT 的预测(具体加速倍数取决于体系与硬件)。
然而,在研发的一线,更常遇到的是逆向命题(Inverse Design):
“给定一组目标物理性质 (例如:带隙处于 、基态热力学能量凸包距 、载流子迁移率 且不含重金属元素),满足这一性能指标的所有可能的三维晶体结构集合是什么?”
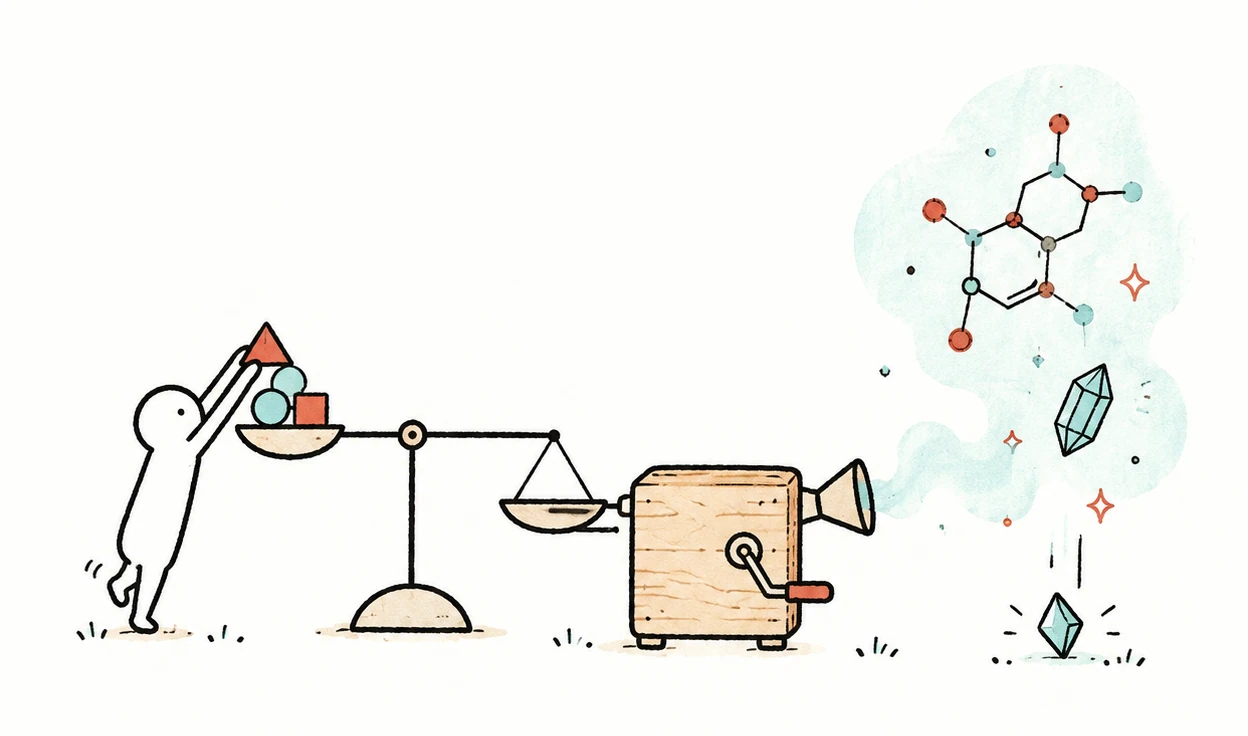
逆向设计与性质天平的对偶映射机制如图 2 所示:
逆向设计的内在数学挑战
在数学与计算科学视角下,逆向设计通常被视为较难求解的病态问题(Ill-posed Problem),其症结在于:
- 高维到低维的病态一对多映射(Ill-posed One-to-Many Mapping):微观结构 处于一个具有数百个离散节点和三维连续自由度的高维构型空间,而目标性质 通常仅为低维标量或张量。无限多种截然不同的原子空间排列可能表现出相近的宏观物理性质;
- 离散图空间的非凸与不可导性:图论结构(节点类型、边连接性)由离散整数索引与邻接矩阵构成。传统优化算法无法直接对离散结构计算关于性质损失函数的连续梯度:
- 真实物理定律的约束:随机生成的原子集合通常并不是稳定材料。它必须同时满足量子力学的费米子反称性、原子核之间没有不合理的近距离重叠、热力学吉布斯自由能极小化、晶体周期性对称性以及实验室中的合成可行性。
连续潜在流形的破局之道
2018 年,Gómez-Bombarelli、Aspuru-Guzik 等人在 ACS Central Science 上发表的论文中,提出了用变分自编码器把分子映射到连续隐空间、再在隐空间中做优化的逆向设计思路:
通过构建编码器神经网络 将离散结构映射至低维连续隐空间 ,并借助生成解码器 建立可微的重构映射,逆向设计就可以转写为一个在平滑连续流形上的连续数学优化问题:
- 在连续空间 上,性质预测函数 变得光滑可微;
- 科学家可以通过梯度上升法、高斯过程贝叶斯优化 或条件生成引导寻找满足目标性能的潜编码 ;
- 最后由解码器把 还原为候选的晶格或分子结构(解码结果是否有效、能否合成,仍需要检验)。
这一转变把“逐个枚举”改成了“在隐空间中按目标搜索”,但生成结果仍需要用计算和实验来验证。
【逆向设计】
在数学物理视角下,材料与分子的逆向设计可以形式化为第一类弗雷德霍姆积分方程(Fredholm Integral Equation of the First Kind)的求逆问题:
其中 是待反演的目标分子/晶体分布,核算子 代表微观结构到物理宏观性质的确定性量子力学前向映射。
哈达玛病态性(Hadamard Ill-Posedness):由于从微观全自由度空间 (具有高达数十至数百个原子坐标维度)到性质标量空间 的投影算子存在巨大的非平庸零空间(Null Space),积分逆算子 是无界的,微小的性质扰动 会使反演得到的 变化很大;
吉洪诺夫正则化与潜在流形几何(Tikhonov Regularization & Latent Geometry):变分自编码器(VAE)与生成扩散流形通过向优化目标引入先验光滑度与曲率能量惩罚,施加了广义吉洪诺夫几何正则化:
通过低维光滑黎曼流形 的参数化约束,算法将高维离散图空间中处处不可导、含有尖锐奇异点的非凸空间,平滑投影为梯度良态的连续赋范向量空间,这是 AI4Science 中逆向搜索常用的数学思路之一。
三、 几何深度学习:让算法洞悉微观物质的对称性密码
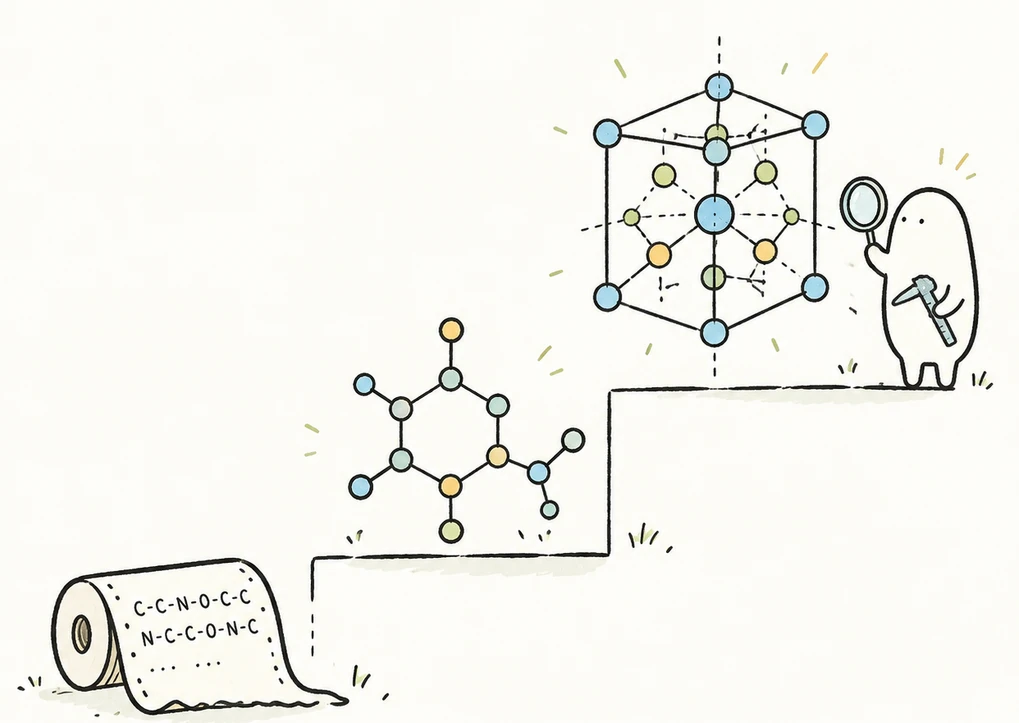
要让深度学习真正理解物理世界,必须从源头上解决一个根本问题:神经网络究竟该如何表示一个分子或一块晶体? 物质表征从一维到三维的几个层次如图 3 所示。
1. 物质表征的几何升维阶梯
纵观 AI 在化学与材料科学中的表征演化史,经历了四个代表性的台阶:
- 人工专家特征(Handcrafted Descriptors & Fingerprints):如 ECFP4/摩根指纹、MACCS 结构键、库仑矩阵(Coulomb Matrix)、径向分布函数(PRDF)。这类特征虽然在传统机器学习(SVM、随机森林)中行之有效,但割裂了原子内部的立体几何信息,无法用于结构重构与反向生成;
- 一维符号序列(1D Sequence & Strings):
- SMILES(Simplified Molecular Input Line Entry System):通过深度优先遍历将分子图展开为字符序列(如
c1ccccc1代表苯环)。其最大优势在于能够直接复用自然语言处理领域的强大架构(如 LSTM、GPT Transformer)。然而,SMILES 语法很脆弱,改动一个括号就可能得到无效的分子; - SELFIES(Self-Referencing Embedded Strings):Krenn 等人于 2020 年提出的自引用嵌入字符串,通过形式文法使任意 SELFIES 字符串都能解码为化学上有效(Valid)的分子,从而避免了语法错误;
- 晶体的文本表示:在固态无机领域,也有研究把晶体写成文本(例如 CIF 文件中的晶格参数、空间群与原子坐标)后交给语言模型处理,但连续的晶格参数与坐标很难用离散 Token 精确表示。需要说明的是,Robocrystallographer$^{[46]}$ 是把晶体结构自动转写成文字描述的分析工具,主要用于“读懂”已有晶体,并不是用于生成晶体的序列格式。
- SMILES(Simplified Molecular Input Line Entry System):通过深度优先遍历将分子图展开为字符序列(如
- 二维拓扑图(2D Molecular Graphs): 分子天然是一张拓扑图 ,其中节点 对应原子(携带原子序数、杂化类型等特征 ),边 对应化学共价键(携带键长、键级特征 )。二维图自然保持了分子的拓扑置换不变性(Permutation Invariance)。
- 三维几何点云与周期性晶体(3D Point Clouds & Periodic Crystals): 真实的物理相互作用(范德华力、静电引力、金属键堆积、晶体场劈裂)发生在连续的三维欧几里得空间中。尤其对于固态晶体材料,其结构由两个部分耦合决定:
- 晶胞矩阵:,定义了无限延伸的布拉菲格子(Bravais Lattice);
- 原子分数坐标:(或笛卡尔坐标 ),在无限周期性边界条件(Periodic Boundary Conditions, PBC)下遵循特定空间群对称性。
2. 消息传递图神经网络的数理统一
2017 年,Gilmer 等人在 ICML 上发表了论文 Neural Message Passing for Quantum Chemistry,将此前分散的各种分子图模型统一到了**消息传递神经网络(Message Passing Neural Network, MPNN)**的形式化框架下(局部信息聚合机制如图 4 所示):
在标准的 MPNN 框架中,信息迭代演进分为两个核心阶段:
消息传递(Message Phase):每个节点 聚合其邻域 发送过来的神经消息 :
状态更新(Update Phase):基于聚合的所有外来消息,更新自身隐藏状态:
读出映射(Readout Phase):通过置换不变的池化算子生成全图全局性质:
随后,Xie & Grossman 提出的晶体图卷积神经网络(CGCNN) 与 Schütt 等人提出的连续滤波卷积网络(SchNet) 将这一框架成功推广至具有连续三维欧氏距离与无限周期性格子边界的固态晶体体系。
传统 MPNN 的理论局限性
在追求更高性能的探索中,理论计算机科学家指出了传统 MPNN 固有的三大数理瓶颈:
- 表达能力上限(1-WL 限制):Morris 等人与 Xu 等人证明,标准单节点聚合的 MPNN 表达能力受制于 1 阶 Weisfeiler-Lehman (1-WL) 图同构测试,无法区分某些局部结构相同但全局拓扑不同的图(例如无法区分两个孤立的三角形与一个六元环);
- 过度平滑(Over-smoothing):随着消息传递层数 的增加,全图所有节点的特征表示会趋向于彼此相近,丢失原子之间的差异;
- 过度挤压(Over-squashing):当远程相互作用信息跨越 跳图直径时,指数级增长的邻域节点信息被迫压缩到固定维度的隐藏向量中,造成长程相互作用(如晶体中的长程静电库仑作用)的信息丢失。
3. 几何对称性的数学守护: 与 等变性
在物理学中,诺特定理(Noether's Theorem)揭示了对称性与物理守恒律的联系。对于多原子体系而言,无论研究者如何平移或旋转整个分子,其势能标量必然保持不变,而作用在原子上的三维受力矢量与偶极矩矢量则必须与坐标系同步旋转(几何等变性示意如图 5 所示)。
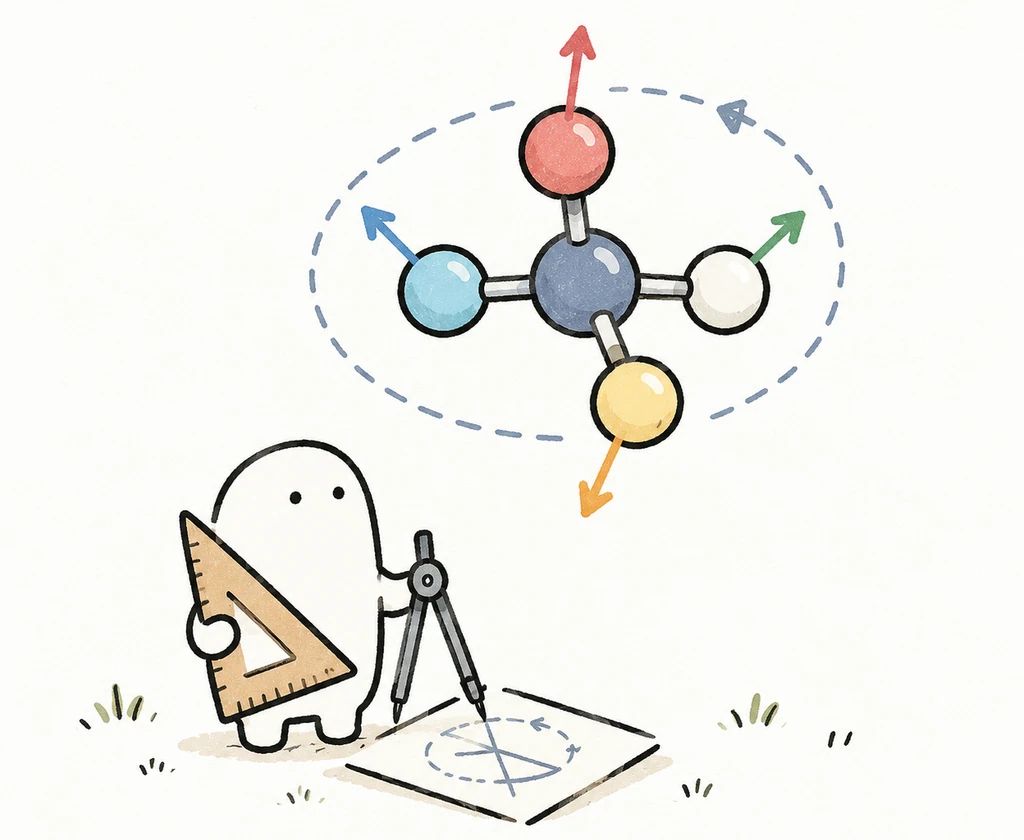
形式化地,设变换操作群为三维欧几里得群 (包含三维旋转 、平移 与空间反演/反射),若函数 满足:
群不变性(Invariance):对于任意群元素 ,
(例如:体系总能量 、形成焓 、带隙 )
群等变性(Equivariance):对于任意群元素 ,
(例如:原子受力矢量 、偶极矩矢量 、磁化率张量 )
如果模型缺乏严格的等变归纳偏置,它就必须耗费海量的数据去“硬背”同一个分子在空间所有旋转角度下的状态,导致样本效率很低。
从 Satorras 等人提出的简单轻量的 EGNN( Equivariant GNN),到基于 Wigner- 矩阵、球谐函数(Spherical Harmonics )和 Clebsch-Gordan 张量积的不可约表示网络(如 NequIP$^{[10]}^{[23]}$ 以及 MACE$^{[24]}$),显著提高了机器学习势函数的精度和数据效率。在若干基准体系上,这类 AI 力场能以远低于 DFT 的计算成本给出接近 DFT 的能量与力,从而使更长时间、更大体系的分子动力学模拟成为可能;具体的加速倍数取决于体系规模、精度要求和硬件,应以相关论文的报告为准。
【群等变性的物理边界与空间手性】
虽然在神经网络中硬编码 (含平移、旋转与空间反演)对称性能提高样本效率,但在凝聚态物理与药物化学中,需要注意“过度对称化”可能带来的偏差:
- 空间反演破缺与手性生物活性(Parity Inversion Breaking & Chirality):真实自然界的生命分子(如 L-氨基酸、D-核糖)与对映异构体药物(如沙利度胺的两个对映体;该药在体内会发生外消旋,这里仅用来说明两种手性构型可以有不同的生物学行为)不具备空间反演对称性。若模型强制采用包含宇称反转的不变标量算子(即完全 对称),将导致模型无法区分左手性与右手性构象,在受体结合力等预测中出现明显错误;
- 姜-泰勒效应与自发对称破缺(Jahn-Teller Distortion & Spontaneous Symmetry Breaking):在高对称性晶体(如八面体配位的 铜氧化物或锰钙钛矿)中,电子轨道的强简并性会诱发晶格自发发生四方轴向伸长或压缩(Jahn-Teller 畸变),使晶格转变为对称性更低的空间群,从而降低基态总能量。若生成模型过早、过于刚性地约束空间群高阶对称性,算法将无法自然落入真正热力学稳定的微观低能畸变态;
- 工程应对方案:在涉及手性与极化体系时,应采用特殊欧几里得群 等变性而非全 等变,显式保留赝标量(Pseudoscalar)与赝矢量通道,并在几何弛豫阶段放开对称性锁定,允许结构自发破缺。
四、 深度生成模型全景谱系
当几何与物理对称性赋予了神经网络理解物质微观结构的强大能力,下一步就是深度生成模型(Deep Generative Models)。
在现代机器学习中,六类生成范式各自建立在不同维度的概率论与统计物理根基之上。了解它们的数学思路与各自在分子材料设计中的取舍,有助于理解现代逆向设计。
1. 自回归模型
自回归模型**(Autoregressive Models)**将多维联合分布 严格依据概率乘法法则分解为条件概率链的乘积:
在小分子设计中,自回归模型通常与 SMILES/SELFIES 序列或因果图遍历相结合。输入历史 Token ,利用 Transformer 的因果掩码注意力机制预测下一位置的元素或连接类型。
- 核心优势:数学结构清晰,易于接入前缀提示词(Prefix Prompting)实现基于化学骨架的先导物优化;
- 物理瓶颈:自回归按固定顺序逐个生成,而分子和晶体本身没有天然的生成顺序,需要额外设计;推断阶段的自回归逐步采样会导致误差逐级累积,难以直接保证三维构型在全局物理势能面上的稳定性。
2. 变分自编码器
变分自编码器**(Variational Autoencoders, VAE)**基于统计推断与贝叶斯理论,旨在建立真实数据 与潜变量 之间的连续平滑对应关系。由于边缘似然 在数学上无法解析求解,VAE 引入变分后验分布 ,通过最大化证据下界(Evidence Lower Bound, ELBO)实现联合优化(VAE 连续隐流形如图 6 所示):
在材料设计中的含义: ELBO 的两项可以这样理解:重构项促使隐向量 保留分子的原子与配位信息;KL 散度项则使各分子的隐变量分布靠近标准高斯分布,让隐空间比较连续、便于插值。 在材料逆向设计中,可以在隐空间里对两个已知结构 、 的编码做插值。最简单的是线性插值:
当先验是高维高斯分布时,随机样本的长度几乎相同,线性插值的中点会落在长度偏小、不太像先验样本的位置,因此常改用球面线性插值(Spherical Linear Interpolation, Slerp):
解码器沿这条路径输出一系列介于 与 之间的中间结构(它们只是模型的输出,不一定是真实存在或可合成的物质)。
前沿代表:JT-VAE(基于树分解的连接图 VAE) 解决了环状结构的合法拼接;而在材料领域,Noh 等人的工作 用连续表示做无机固体材料的逆向设计,Gómez-Bombarelli 等人的工作 则在隐空间中联合训练性质预测器并做优化。
3. 生成对抗网络
由 Ian Goodfellow 等人提出的生成对抗网络 (Generative Adversarial Networks, GAN) ,放弃了显式的概率密度函数建模,转而将生成过程定义为生成器 与判别器 之间的二人零和博弈(Two-Player Minimax Game,机制如图 7 所示):
离散断崖与梯度阻断: 在图像生成中,像素属于连续实数空间,判别器的梯度能够直接反向传播至生成器:
然而在分子与晶体图中,由于离散化学键(单键、双键、芳香键)与离散原子序数的存在,离散采样的 Argmax 操作导数处处为零,导致对抗梯度链条瞬间断裂。
破局方案:为了在化学图上训练 GAN,研究者引入了强化学习策略梯度(Policy Gradient, 如 ORGAN$^{[29]}$)或连续松弛技术(Gumbel-Softmax 弛豫)。在固态晶体领域,GAN 也被用于直接生成三维电子云密度网格(Voxel Density),再通过拓扑电荷逆投影恢复原子构型。
4. 归一化流
变分自编码器只能给出似然的下界,而归一化流 (Normalizing Flows) 则通过一系列双射(Bijective)且可微(Diffeomorphic)的可逆变换 ,在复杂数据分布 与简单高斯先验分布 之间建立直接的桥梁(可逆映射如图 8 所示)。
依据多元随机变量变换定理(Change of Variables Theorem),数据的真实精确对数似然可直接解析计算:
- 在物质设计中的优势与瓶颈:
- 优势:生成过程即正向推断,正向采样与逆向映射都只需一次网络计算;可以精确计算任意样本的对数似然,通常也不会出现 GAN 那样的模式崩溃(但这不保证样本质量);
- 挑战:为了让雅可比行列式 的计算开销保持在可接受范围(如三角阵),网络层的形式受到限制(如 RealNVP 中的仿射耦合层)。处理节点数可变、拓扑离散的分子图时,需要专门设计的可逆层(如 GraphAF$^{[31]}^{[32]}$)。另外,也已有满足 等变性的流模型。
5. 能量模型
能量模型 (Energy-Based Models, EBM) 与统计物理的联系最为直接:它沿用了统计物理中的玻尔兹曼(吉布斯)分布(势能面与能量盆地映射如图 9 所示):
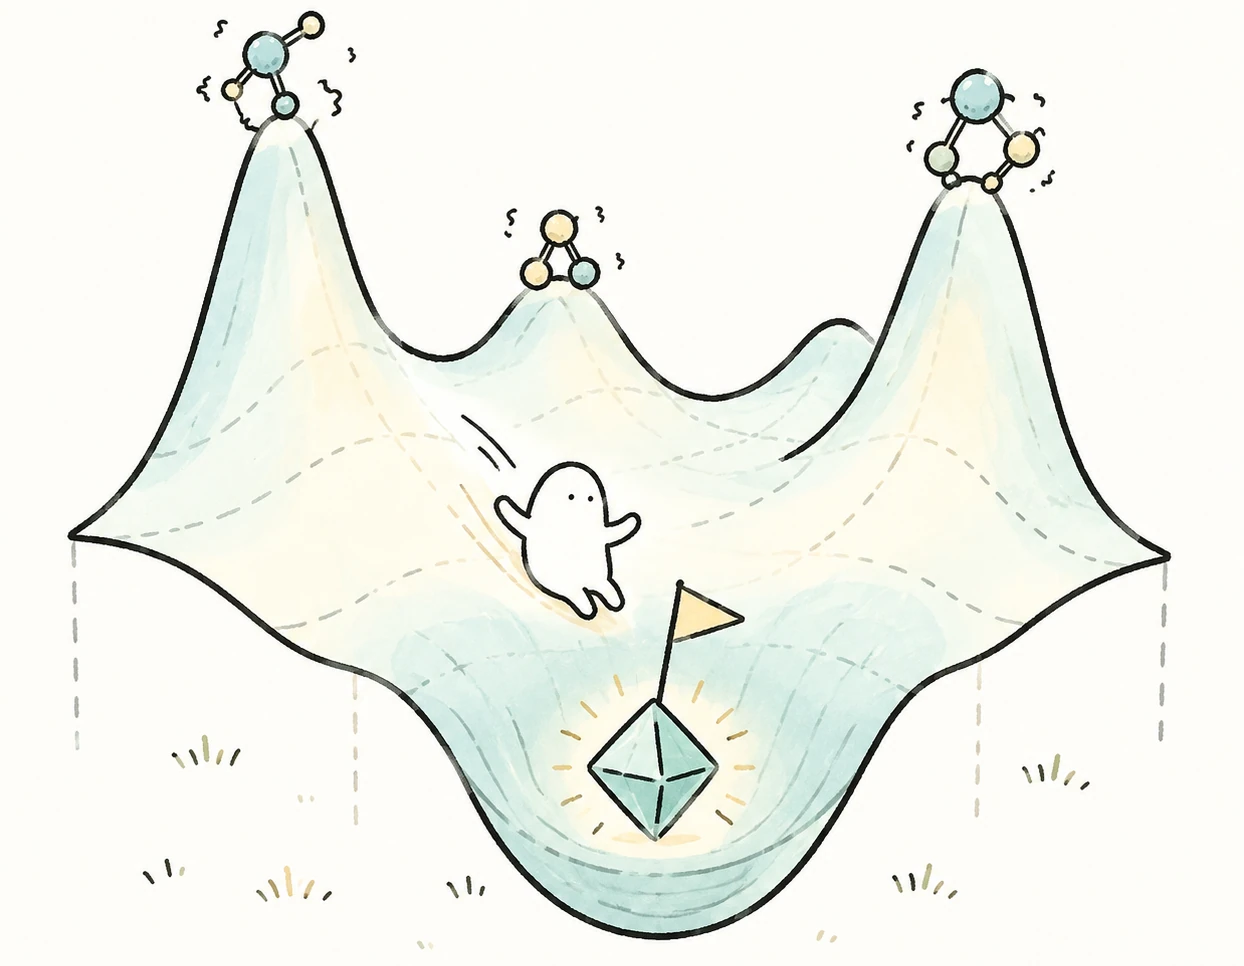
势能面(PES)与自由能盆地的天然映射: 在统计热力学中,体系处于某一微观构型 的概率服从玻尔兹曼分布 ,即概率随能量升高呈指数下降(这里的 是构型的能量;自由能则是对许多微观态求和后得到的量,二者需要区分)。自然界中稳定存在的晶体与化合物,通常处在其多维势能面(PES)的极小值或亚稳态附近。神经网络 直接扮演了参数化势能面或哈密顿量(Hamiltonian)的角色。
采样与推断机制: 由于高维空间中的配分函数 存在无法解析求解的多重积分,能量模型通过计算**得分函数(Score Function)**避开配分函数:
利用未校正朗之万动力学(Unadjusted Langevin Algorithm, ULA)进行随机微观采样:
这相当于让随机初始的粒子沿能量下降的方向移动,同时叠加随机扰动;达到平稳后,样本服从上述玻尔兹曼分布,低能构型出现的概率更大。这并不保证得到真实可合成的晶体。
6. 扩散生成模型
近年来,基于非平衡热力学扩散过程的去噪扩散概率模型 (Diffusion Models & Score-based SDE)(DDPM) 与分数随机微分方程(Score-based SDE) 在生成式 AI 领域得到了广泛应用,在 3D 分子构象生成、蛋白质设计及无机晶体生成等任务上取得了很好的结果。
扩散模型将生成过程巧妙地分解为两阶段的物理时间演化:
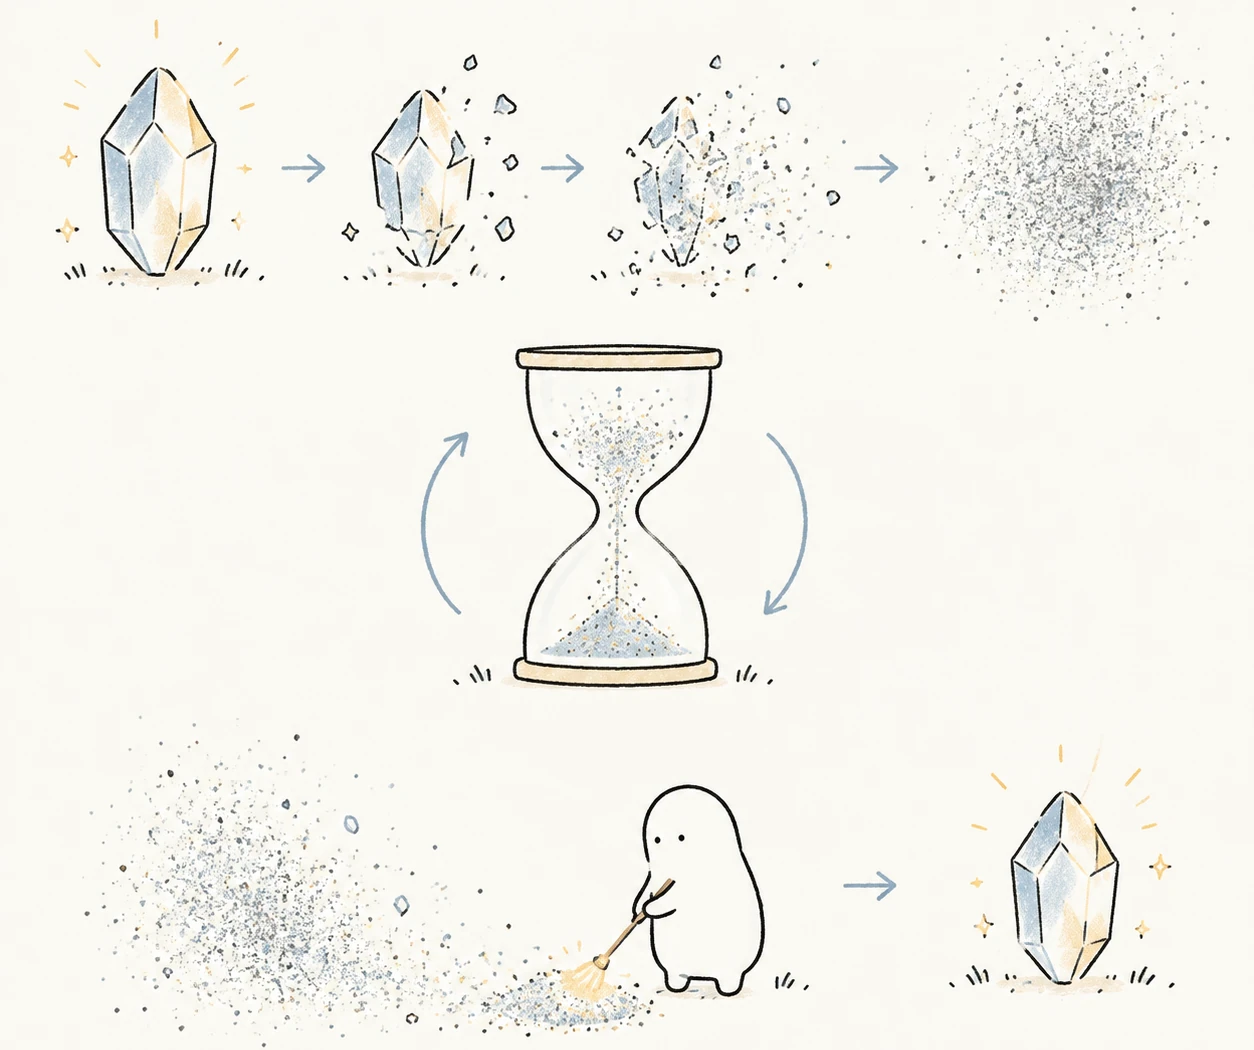
前向加噪过程(Forward Diffusion):通过朗之万随机微分方程(SDE),在微观结构中逐步注入高斯噪声,直至所有原子坐标与格点退化为一团杂乱无章的各向同性白噪声:
逆向时间去噪过程(Reverse-Time SDE):根据 Anderson 逆时理论,逆向生成过程由逆向 SDE 唯一定义(微观去噪轨迹如图 10 所示):
- 在物质生成中的代表性工作:
- CDVAE(晶体扩散变分自编码器):由 MIT 的 Xie、Fu、Ganea、Barzilay 与 Jaakkola 提出(ICLR 2022)。它把 VAE 与扩散过程结合起来:编码器把晶体编码为隐变量,由隐变量预测晶胞的晶格参数、原子数与组成,再用基于得分的解码器对原子坐标(及原子类型)逐步去噪,并显式考虑晶体的周期性;
- GNoME 与 MatterGen:DeepMind 的 GNoME 工作 用图网络与主动学习,报告预测了约 220 万个相对已有结果稳定的晶体结构(其中约 38 万个位于更新后的能量凸包上);这些主要是计算预测,并非都经过实验合成。微软团队的 MatterGen$^{[36]}$ 是基于扩散的无机材料生成模型,经过微调后可以按化学组成、对称性以及部分力学、电子和磁性质的条件进行生成;论文还合成了一个生成的结构,测得的性质与目标值相差约 20%;
- 蛋白质设计与分子对接:基于扩散的 RFdiffusion$^{[37]}$ 用于蛋白质设计,DiffDock$^{[38]}$ 用于分子对接,这里仅作为扩散模型应用范围的例子。
六类经典生成架构对比
表 1 六类经典生成架构的定性比较
| 架构范式 | 代表数学核心 | 表达能力 | 似然可算性 | 采样速度 | 对称性融入 | 核心优势 | 关键物理瓶颈 |
|---|---|---|---|---|---|---|---|
| 自回归模型 (Autoregressive) | 强 | 精确 | 较慢 () | 需额外设计 | 序列语法成熟,自然融合前缀结构约束 | 误差累积;破坏物理空间全向对称性 | |
| 变分自编码器 (VAE) | 强 | 下界近似 | 快 () | 视架构而定 | 隐空间连续,便于贝叶斯优化与插值 | 重构与正则平衡难;高维易后验坍塌 | |
| 生成对抗网络 (GAN) | 强 | 无隐式似然 | 快 () | 视架构而定 | 样本通常较清晰,无需后验推断 | 离散梯度阻断;训练不稳定,易发生模式崩溃(Mode Collapse) | |
| 归一化流 (Flow) | 中等 | 精确 | 快(一次前向) | 已有等变流工作 | 可逆;可精确计算似然 | 网络层须可逆且雅可比行列式易算,表达受限;一般不保持体积不变 | |
| 能量模型 (EBM) | 强 | 未归一化 | 较慢 (MCMC) | 可通过等变能量函数实现 | 与势能面、玻尔兹曼分布联系直接 | 配分函数无法解析求解;朗之万动力学采样收敛慢 | |
| 扩散模型 (Diffusion) | 强 | 可经概率流 ODE 计算(需数值积分) | 较慢 (多步数值解) | 常与 等变网络结合 | 在许多任务上生成质量较高;适合连续坐标去噪 | 采样推理耗时较长;晶胞连续性约束较复杂 |
五、 可合成性、多目标博弈与物理可达性
算法在虚拟空间中可以随意探索,但现实世界的物理化学规律并不会因此放宽。初涉 AI4Science 的读者容易产生一个误解:只要模型的损失函数收敛、生成的分子在预测器中得分很高,或者新晶体的预测带隙符合目标,工作就完成了。
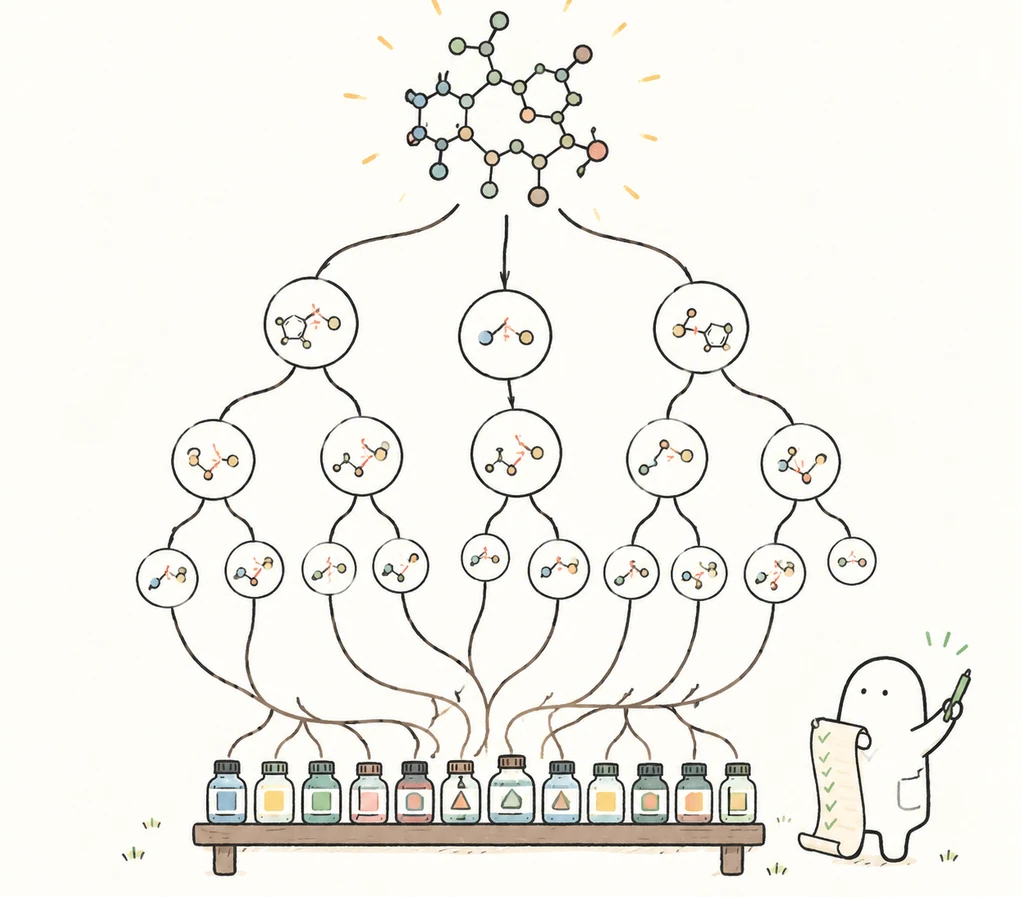
然而,一旦将生成的候选结构交给湿法合成化学家或固态物理学家,往往会发现:屏幕上生成的很多结构,不过是算法基于统计假象拼凑出来的“科学怪人(Frankenstein Molecules)”——要么包含高度扭曲的高应变环,要么含有不稳定的过氧键与多叠氮基团,很难在现实中稳定存在(逆合成决策树如图 11 所示)。
要将生成模型转化为真实的物质生产力,需要面对下面三个现实问题:
1. 合成可行性(Synthesizability)的量化
- 分子可达性评估(SAScore 与 SYBA): Ertl & Schuffenhauer 于 2009 年提出的合成可达性评分(Synthetic Accessibility Score, SAScore),通过结合大型化学库(PubChem)中常见化学片段的出现频次与分子的环复杂度、手性中心数等拓扑惩罚项,给出了 1(容易合成)到 10(很难合成)的评分;后续学者提出的 SYBA(基于贝叶斯分类)与 SCScore(基于反应网络前向复杂性排序) 也可用于可合成性筛选;
- 计算机辅助逆合成规划(CASP): 仅靠经验打分依然无法提供制造配方。2018 年,Segler 等人在 Nature 上发表了结合深度神经网络与蒙特卡洛树搜索(MCTS)的逆合成规划工作,用于自动设计有机化合物的合成路线。模型在数万条经过历史验证的反应模板库中反向航行,将复杂的目标结构层层拆解,直至还原到实验台货架上现成易得的廉价市售原料。
- 固态无机晶体的热力学与动力学准则: 在晶体材料中,“可合成性”有着更为严格的物理学定义:
- 能量凸包距(Energy Above Convex Hull, ):候选晶相不仅必须形成能为负,还应当落在凸包上或非常接近凸包(通常要求 ),否则在热力学上会自发分解为其他更稳定的二元或多元相;
- 动力学稳定性(Phonon Dispersion):必须通过密度泛函微扰理论(DFPT)计算全布里渊区的声子色散谱,检查是否不存在虚频(),以排除晶格的软模失稳。
2. 多目标帕累托博弈
在实际应用中,新材料或新药物往往需要同时满足多个指标:
- 在药物开发中:候选分子不仅需要对特定靶点酶具有高活性(),还必须拥有良好的微粒体代谢稳定性()、适度的血浆蛋白结合率、高水溶性、低细胞毒性,并且不能阻断心脏 hERG 钾离子通道(以避免心律失常风险);
- 在全固态电池电解质中:不仅需要较高的室温离子电导率(),还需要较宽的电化学稳定窗口( vs. )、对金属锂的抗还原性、足够高剪切模量以阻挡锂枝晶刺穿,以及抗潮解与低成本特性。
这要求我们将**显式多目标优化(Scalarization / 帕累托非支配前沿筛选)与结构引导优化(骨架跃迁 Scaffold Hopping / 侧链精修)**结合到生成模型中,在相互冲突的多个约束之间寻找合理的折中点。
六、 从生成算法到自动化实验室的闭环
长期以来,计算材料学与实验材料学之间横亘着一条较大的差距:理论计算可以预测出大量候选材料,而实验室里的合成与表征仍依赖人工,两者之间常常脱节。随着生成式人工智能与**自动化实验室(Self-Driving Autonomous Laboratories / A-Lab / SDLs)**的结合,“计算预测—自动合成—自动表征—反馈”的闭环正在被一些团队尝试(从代码生成到物理原子的闭环验证通道如图 12 所示)。
主动学习与人在回路的双闭环
这类系统通常被组织成一个主动学习(Active Learning)双闭环体系(如图 13 所示):
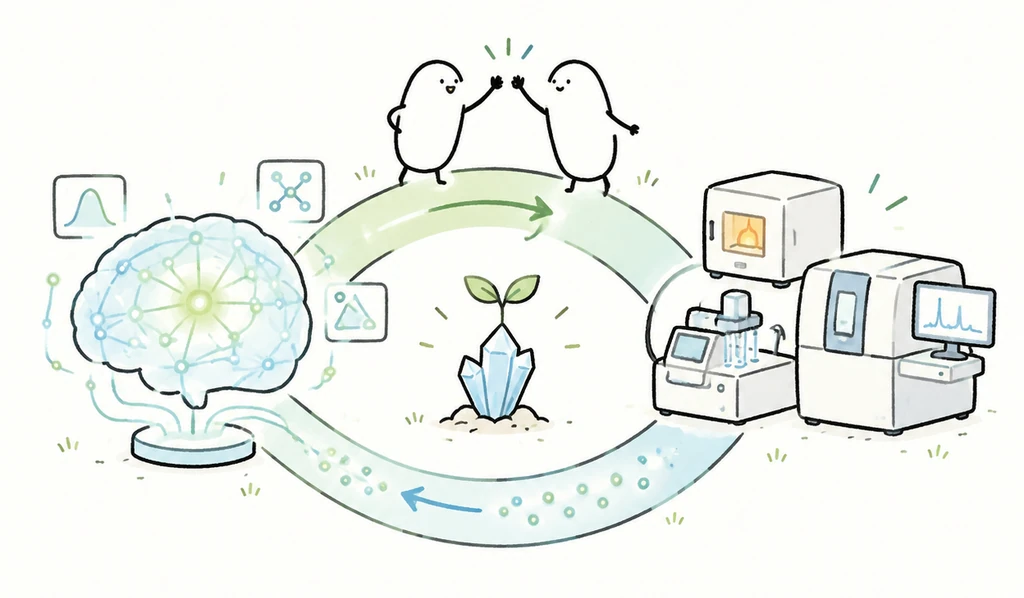
- 内环:数字空间的自反思与生成设计(In-Silico Loop)
- 生成式 AI 大脑(扩散模型 / VAE)根据目标性能,生成候选晶体与分子;
- 不确定性量化器(Uncertainty Quantification, UQ):评估当前代理模型预测的认知不确定度(Epistemic Uncertainty)。算法在“利用已知高价值区域(Exploitation)”与“探索高不确定性盲区(Exploration)”之间进行贝叶斯平衡;
- 自动化计算过滤:通过等变神经网络力场与高精度 DFT 自动化工作流,完成能量凸包与热力学稳定性初筛。
- 外环:物理世界的原子级自主合成与表征(Wet-Lab Physical Loop)
- 自动化配方与工艺生成:大语言模型(LLM)与逆合成引擎自动读取上万篇文献,将候选材料转化为精确的机械臂加料配方与烧结升温曲线;
- 无人机器人硬件平台:机械臂自动称量金属固体粉末、自动分液滴定、送入高温马弗炉烧结或高压反应釜中反应;
- 在线自动化表征与物相识别:机械臂将烧结产物自动压片并传送至在线粉末 X 射线衍射仪(PXRD)、拉曼光谱仪(Raman)或质谱仪中采集数据,计算机视觉算法自动解析 Rietveld 精修结果,判定目标晶相是否成功合成。
- 闭环反馈与先验修正: 实验成功与失败的数据(尤其是失败数据)被回传给模型,模型据此更新性质预测与候选分布,再进入下一轮生成。
2023 年,伯克利实验室等机构在 Nature 上报告了自动化实验室 A-Lab :它在 17 天的连续运行中,对 58 个目标化合物尝试合成,获得其中 41 个(约 71%)。需要注意几点:这些目标主要来自 Materials Project 与 Google DeepMind 的稳定性预测,并非全部来自 GNoME;此外,Leeman、Palgrave、Schoop 等人 随后重新审视了其中的物相分析,认为相当一部分产物可能是已知的、成分无序的化合物,而不是全新材料,同时指出自动化的 Rietveld 精修还不够可靠。这说明自动化实验室的结论仍需要人类专家复核。
从代码到真实的晶体,这条链路还在发展之中;自动化系统更适合作为科学家的助手,帮助完成重复、耗时的实验与分析。
沿着本节的闭环走一遍:性质目标如何经过模型、候选、实验,再回到数据。
定义目标:性质与约束。
思考与说明
思考如果实验失败,这条记录应当在哪一步回到模型?
流程演示;不连接真实实验设备,不代表自动验证了材料性质。
七、 全书知识图谱、研读路线与代码哲学
本书共 18 篇(第 00–17 章):第 00 章是机器学习基础(预备),其后分为 5 个模块;第 17 章(模块五)又包含 9 个子章节。内容从感知器与反向传播开始,经过图神经网络与等变网络,到各类生成模型,最后讨论逆向设计与自动化实验室,大致由浅入深:
读者背景、知识储备与研读路线
为了让全书的研读过程既严密又高效,我们假定读者已经掌握工科与物理化学专业通行的大学基础数学与编程工具。这包括高等微积分中的多元微积分、复合函数链式求导法则与二次配方法;线性代数中的矩阵乘法、特征分解与对称正定矩阵性质;初等概率论中的条件概率、贝叶斯定理、数学期望与方差运算,以及经典高斯分布的代数性质。在编程方面,读者只需熟悉 Python 语言的基本控制流与面向对象概念,本书的代码以纯 Python/NumPy 为主,没有接触过 PyTorch 或 TensorFlow 也可以阅读大部分章节。全书后续各章节将不再机械重复此通用要求,而是仅标注与本章直接相关的承接章节。
致材料化学与物质科学专业读者
本书涉及第一性原理计算、凝聚态物理与现代生成式深度学习。许多初读本书的材料、化学与化工专业学生和青年学者往往会被密集的群表示论、测度微积分、Fokker–Planck 偏微分方程和随机微分方程(SDE)所震慑,甚至产生畏难情绪。
需要说明的是:书中的物理与数学内容是为材料与分子的设计服务的;读懂它们并不要求先拥有理论物理的学位背景。并且作者的智商是不高的,相信大家都能学会 😄
1. 概念对照:用化学直觉理解数理概念
材料化学读者通常对结构、能带与轨道、反应动力学与热力学有较好的直觉。在研读全书时,请随时查阅下表,把不熟悉的理论物理词汇对应到熟悉的化学概念:
表 2 化学直觉与数理概念对照
| 理论物理 / 应用数学抽象表述 | 材料化学读者熟悉的本底概念 | 直观物理化学图像 |
|---|---|---|
| 不可约表示 / 球谐函数基底 (第 09 章 等变网络) | 原子轨道角度波函数 ( 轨道) | 是球形各向同性的 轨道(标量,如电荷/能量); 是三维哑铃形 轨道(矢量,如受力/偶极矩); 是五重花瓣形 轨道(二阶张量,如极化率/应力)。 |
| Clebsch–Gordan 张量积分解 (第 09 章 等变网络) | 原子轨道重叠成键与光谱项偶合 | 两个矢量相互作用():点积对应 成键标量,叉积对应空间取向赝矢量,无迹对称张量对应偏振多极特征。 |
| 能量模型 (EBM) 标量曲面 (第 15 章 能量模型) | 波恩-奥本海默势能面 (PES) 与自由能地形 | 神经网络学习的就是材料构象的势能面;能量极小值深盆对应基态稳定结构,一阶鞍点对应化学反应过渡态。 |
| 朗之万动力学 (Langevin) 采样 (第 15、16 章) | 分子动力学 (MD) 模拟与恒温构象搜索 | 原子顺着受力负梯度滚向低能盆地,同时经受热涨落随机碰撞,在有限温度下遍历热力学稳定平衡态。 |
| 扩散模型的前向加噪过程 (第 16 章 扩散模型) | 晶格的高温熔化 / 非晶化 (Amorphization) | 温度不断升高,热扰动逐步抹去微观对称性与近邻配位,最终晶体退化为完全混乱的无序原子气。 |
| 扩散逆向去噪与得分函数 (Score) (第 16 章 扩散模型) | 过冷熔体受控成核结晶与定向退火 | 得分函数本质上就是驱动原子回到稳定晶格配位格点的“物理受力场”;去噪过程就是原子沿力场逐级重结晶。 |
| 连续潜在流形与潜空间优化 (第 12、17 章) | 固溶体多元相图的连续成分演化与骨架跃迁 | 在平滑流形上移动潜编码,如同在相图上连续微调合金元素配比或有机分子侧链,平滑探索目标物性极值。 |
| 1-WL 图同构测试瓶颈 (第 08 章 图网络) | 二维拓扑图分不清立体顺反异构与对映异构 | 纯二维图只看原子连通度,如同看不出顺铂(抗癌药物)与反铂(无活性)的空间立体排布差异。 |
分专业定制研读路径
- 路径 A:计算机科学 / 人工智能算法背景的读者
- 核心痛点:精通 PyTorch、损失函数调优与 Transformer 注意力机制,但缺乏对凝聚态物理、群论对称性、配合物配位场与晶胞坐标的直观理解,容易在设计网络时违背基本物理守恒;
- 建议研读重点:
- 快速通读 模块 I 与 II,建立起算法概念向分子/材料数据结构映射的桥梁;
- 认真阅读 模块 III(图神经网络与等变神经网络),重点了解 群的不可约表示、球谐函数展开与晶体周期性边界条件(PBC)的处理;
- 研读 模块 IV 与 V 时,跳出单纯的 FID/BLEU 评估指标,重点理解化学有效性掩码、声子谱检验与能量凸包稳定性对模型设计与评价的意义。
- 路径 B:材料科学 / 化学工程 / 固体物理背景的读者
- 核心痛点:熟悉能带理论、晶体空间群与有机反应机理,但可能把深度学习当作“黑盒”,面对高维张量求导与变分推导感到陌生;
- 建议研读重点:
- 从 模块 I(感知器、梯度下降与反向传播) 开始,亲手用纯 Python 写一遍链式法则,弄清神经网络的基本计算;
- 研读 模块 II 与 III(重点在第 08、09 章),借助原子轨道与配位场直觉掌握图网络与等变网络,掌握晶体周期性边界与原子受力计算;
- 重点阅读 模块 IV(第 15 章能量模型与第 16 章扩散模型),借助“势能面弛豫”与“晶体退火成核”图像理解现代生成式 AI;
- 深入 模块 V(逆向设计与材料实战前沿),重点掌握形成能凸包、声子谱检验、主动学习循环与无人自主实验室,应用到自己的材料研究课题中。
本书的代码做法
本书的原则是“公式尽量配推导,方法尽量配可运行的代码”。具体做法如下:
- 代码直接写在正文里。 各章把可运行的代码块放在对应小节中,读者不必另外翻找文件;各章配套的代码目录只是同一份代码的整理版,方便整体运行和测试。
- 以纯 Python / NumPy 为主。 核心算法(如感知器、反向传播、卷积、循环网络等)尽量用纯 Python 或 NumPy 从底层写出,使矩阵乘法和链式法则都看得见;NumPy 代码块都在本书环境中实际运行过,文中的数字来自这些运行结果。
- 部分章节给出 PyTorch 版。 对于较复杂的模型(如图网络、等变网络、扩散模型),个别章节会在 NumPy 版之外再给出 PyTorch 版,并在代码块前标注“(PyTorch 版,未在本书环境运行)”。这类代码仅供参考,读者需要自行搭建环境验证。
- 配有单元测试。 一些章节附带单元测试,用来检查核心实现是否与预期一致(例如用数值梯度校验反向传播)。测试通过只说明实现与预期相符,不说明模型在真实数据上一定有效。
- 与化学软件的关系。 书中会提到
RDKit、Pymatgen、ASE等常用工具,但除个别章节另有说明外,本书的代码并不依赖它们;本书也没有提供与这些工具的完整对接流程。
【运行环境提示】
NumPy 版代码在普通笔记本的 CPU 上即可运行。若要运行 PyTorch 版代码,需要自行安装 PyTorch;如果使用 GPU,还需要让 PyTorch 与 CUDA 版本相匹配。PyTorch Geometric、e3nn 等扩展库对 PyTorch 与 CUDA 的版本也比较敏感,建议在安装前查阅各自的官方说明。涉及 DFT 计算(如 VASP、Quantum ESPRESSO)的流程需要读者根据自己的算力另行准备,本书不提供。
八、 致未来的科学探险家
20 世纪著名的英国统计学家乔治·博克斯(George E. P. Box)曾留下一句流传甚广的学术格言:
“All models are wrong, but some are useful.”
(所有的模型都是错的,但有些模型是有用的。)
这句话提醒我们:从简单的线性拟合到经验力场,物理模型总要做出假设与近似。生成式模型也不例外,它们只是对真实世界的一种近似,可以帮助我们缩小搜索范围、提出候选,但结论仍需要计算和实验来检验。
本书从最简单的感知器讲到等变网络与扩散模型,也从高维张量计算延伸到无人实验室中的材料制备。希望大家在理解公式与代码的同时,始终记得模型只是工具,最终目标仍是提出可以验证的科学问题,并找到有用的新物质。
参考文献
- Hohenberg, P., & Kohn, W. (1964). Inhomogeneous electron gas. Physical Review, 136(3B), B864.
- Kohn, W., & Sham, L. J. (1965). Self-consistent equations including exchange and correlation effects. Physical Review, 140(4A), A1133.
- Hey, T., Tansley, S., & Tolle, K. (Eds.). (2009). The fourth paradigm: data-intensive scientific discovery. Microsoft Research.
- Bohacek, R. S., McMartin, C., & Guida, W. C. (1996). The art and practice of structure-based drug design: a molecular modeling perspective. Medicinal Research Reviews, 16(1), 3-50.
- Ruddigkeit, L., van Deursen, R., Blum, L. C., & Reymond, J. L. (2012). Enumeration of 166 billion organic small molecules in the chemical universe database GDB-17. Journal of Chemical Information and Modeling, 52(11), 2864-2875.
- Merchant, A., Batzner, S., Schoenholz, S. S., Aykol, M., Cheon, G., & Cubuk, E. D. (2023). Scaling deep learning for materials discovery. Nature, 624(7990), 80-85.
- Curtarolo, S., Setyawan, W., Wang, S., Xue, J., Yang, K., Taylor, R. H., ... & Sanvito, S. (2012). AFLOWLIB. ORG: A distributed materials properties repository from high-throughput ab initio calculations. Computational Materials Science, 58, 227-235.
- Schütt, K. T., Sauceda, H. E., Kindermans, P. J., Tkatchenko, A., & Müller, K. R. (2018). SchNet–A deep learning architecture for molecules and materials. The Journal of Chemical Physics, 148(24), 241722.
- Xie, T., & Grossman, J. C. (2018). Crystal graph convolutional neural networks for an accurate and interpretable prediction of material properties. Physical Review Letters, 120(14), 145301.
- Batzner, S., Musaelian, A., Sun, L., Geiger, M., Mailoa, J. P., Kornbluth, M., Molinari, N., Smidt, T. E., & Kozinsky, B. (2022). E(3)-equivariant graph neural networks for data-efficient and accurate interatomic potentials. Nature Communications, 13(1), 2453.
- Sanchez-Lengeling, B., & Aspuru-Guzik, A. (2018). Inverse molecular design using machine learning: Generative models for matter engineering. Science, 361(6400), 360-365.
- Noh, J., Kim, J., Stein, H. S., Sanchez-Lengeling, B., Gregoire, J. M., Aspuru-Guzik, A., & Jung, Y. (2019). Inverse design of solid-state materials via a continuous representation. Matter, 1(5), 1370-1384.
- Gómez-Bombarelli, R., Wei, J. N., Duvenaud, D., Hernández-Lobato, J. M., Sánchez-Lengeling, B., Sheberla, D., ... & Aspuru-Guzik, A. (2018). Automatic chemical design using a data-driven continuous representation of molecules. ACS Central Science, 4(2), 268-276.
- Griffiths, R. R., & Hernández-Lobato, J. M. (2020). Constrained Bayesian optimization for automatic chemical design using variational autoencoders. Chemical Science, 11(2), 577-586.
- Segler, M. H., Kogej, T., Tyrchan, C., & Waller, M. P. (2018). Generating focused molecule libraries for drug discovery with recurrent neural networks. ACS Central Science, 4(1), 120-131.
- Krenn, M., Häse, F., Nigam, A., Friederich, P., & Aspuru-Guzik, A. (2020). Self-referencing embedded strings (SELFIES): A 100% robust molecular string representation. Machine Learning: Science and Technology, 1(4), 045024.
- Gilmer, J., Schoenholz, S. S., Riley, P. F., Vinyals, O., & Dahl, G. E. (2017). Neural message passing for quantum chemistry. International Conference on Machine Learning (ICML), 1263-1272.
- Morris, C., Ritzert, M., Fey, M., Hamilton, W. L., Lenssen, J. E., Rattan, G., & Grohe, M. (2019). Weisfeiler and leman go neural: Higher-order graph neural networks. Proceedings of the AAAI Conference on Artificial Intelligence, 33(01), 4602-4609.
- Xu, K., Hu, W., Leskovec, J., & Jegelka, S. (2019). How powerful are graph neural networks? International Conference on Learning Representations (ICLR).
- Oono, K., & Suzuki, T. (2020). Graph neural networks exponentially lose expressive power for node classification. International Conference on Learning Representations (ICLR).
- Alon, U., & Yahav, E. (2021). On the bottleneck of graph neural networks and its practical implications. International Conference on Learning Representations (ICLR).
- Satorras, V. G., Hoogeboom, E., & Welling, M. (2021). E(n) equivariant graph neural networks. International Conference on Machine Learning (ICML), 9323-9332.
- Musaelian, A., Batzner, S., Becker, A., Xie, T., Smidt, T., & Kozinsky, B. (2023). Learning local equivariant representations for large-scale atomistic dynamics. Nature Communications, 14(1), 579.
- Batatia, I., Kovacs, D. P., Simm, G. N., Ortner, C., & Csányi, G. (2022). MACE: Higher order equivariant message passing neural networks for materials. Advances in Neural Information Processing Systems (NeurIPS), 35, 11423-11436.
- Bagal, V., Aggarwal, R., Vinod, P. K., & Priyakumar, U. D. (2022). MolGPT: molecular generation using a transformer-decoder model. Journal of Chemical Information and Modeling, 62(9), 2064-2076.
- Kingma, D. P., & Welling, M. (2014). Auto-encoding variational Bayes. International Conference on Learning Representations (ICLR). (arXiv:1312.6114, 2013)
- Jin, W., Barzilay, R., & Jaakkola, T. (2018). Junction tree variational autoencoder for molecular graph generation. International Conference on Machine Learning (ICML), 2323-2332.
- Goodfellow, I., Pouget-Abadie, J., Mirza, M., Xu, B., Warde-Farley, D., Ozair, S., ... & Bengio, Y. (2014). Generative adversarial nets. Advances in Neural Information Processing Systems (NeurIPS), 27, 2672-2680.
- Guimaraes, G. L., Sanchez-Lengeling, B., Outeiral, C., Farias, P. L., & Aspuru-Guzik, A. (2017). Objective-reinforced generative adversarial networks (ORGAN) for sequence generation models. arXiv preprint arXiv:1705.10843.
- Dinh, L., Sohl-Dickstein, J., & Bengio, S. (2017). Density estimation using Real NVP. International Conference on Learning Representations (ICLR). (arXiv:1605.08803, 2016)
- Shi, C., Xu, M., Zhu, Z., Zhang, M., Tang, J., & Zeng, H. (2020). GraphAF: a flow-based autoregressive model for molecular graph generation. International Conference on Learning Representations (ICLR).
- Zang, C., & Wang, F. (2020). MoFlow: an invertible flow model for generating molecular graphs. ACM SIGKDD Conference on Knowledge Discovery and Data Mining, 617-626.
- Ho, J., Jain, A., & Abbeel, P. (2020). Denoising diffusion probabilistic models. Advances in Neural Information Processing Systems (NeurIPS), 33, 6840-6851.
- Song, Y., Sohl-Dickstein, J., Kingma, D. P., Kumar, A., Ermon, S., & Poole, B. (2021). Score-based generative modeling through stochastic differential equations. International Conference on Learning Representations (ICLR).
- Xie, T., Fu, X., Ganea, O.-E., Barzilay, R., & Jaakkola, T. (2022). Crystal diffusion variational autoencoder for periodic material generation. International Conference on Learning Representations (ICLR).
- Zeni, C., Pinsler, R., Zügner, D., Fowler, A., Horton, M., Fu, X., ... & Xie, T. (2025). A generative model for inorganic materials design. Nature, 639, 624-632. (预印本:arXiv:2312.03687, 题为 MatterGen: a generative model for inorganic materials design)
- Watson, J. L., Juergens, D., Bennett, N. R., Trippe, B. L., Yim, J., Eisenach, H. E., ... & Baker, D. (2023). De novo design of protein structure and function with RFdiffusion. Nature, 620(7976), 1089-1100.
- Corso, G., Stärk, H., Jing, B., Barzilay, R., & Jaakkola, T. (2023). DiffDock: Diffusion steps, twists, and turns for molecular docking. International Conference on Learning Representations (ICLR).
- Ertl, P., & Schuffenhauer, A. (2009). Estimation of synthetic accessibility score of drug-like molecules based on molecular complexity and fragment contributions. Journal of Cheminformatics, 1(1), 8.
- Coley, C. W., Rogers, L., Green, W. H., & Jensen, K. F. (2018). SCScore: synthetic complexity learned from a reaction corpus. Journal of Chemical Information and Modeling, 58(2), 252-261.
- Segler, M. H., Preuss, M., & Waller, M. P. (2018). Planning chemical syntheses with deep neural networks and symbolic AI. Nature, 555(7698), 604-610.
- Sun, W., Bartel, C. J., Artrith, N., & Ceder, G. (2019). The thermodynamic scale of inorganic crystalline metastability. Science Advances, 5(11), eaax1584.
- Szymanski, N. J., Rendy, B., Fei, Y., Kumar, R. E., He, T., Milsted, D., ... & Ceder, G. (2023). An autonomous laboratory for the accelerated synthesis of novel materials. Nature, 624(7990), 86-91.
- Coley, C. W., Thomas, D. A., Lummiss, J. A., Leahy, J. N., Cons, S. C., ... & Jensen, K. F. (2019). A robotic platform for flow synthesis of organic compounds informed by AI planning. Science, 365(6453), eaax1566.
- MacLeod, B. P., Parlane, F. G., Morrissey, T. D., Häse, F., Roch, L. M., Dettelbach, K. E., ... & Berlinguette, C. P. (2020). Self-driving laboratory for accelerated discovery of thin-film materials. Science Advances, 6(20), eaaz8867.
- Ganose, A. M., & Jain, A. (2019). Robocrystallographer: automated crystal structure text descriptions and analysis. MRS Communications, 9(3), 874-881.
- White, T. (2016). Sampling generative networks. arXiv preprint arXiv:1609.04468.
- Satorras, V. G., Hoogeboom, E., Fuchs, F. B., Posner, I., & Welling, M. (2021). E(n) equivariant normalizing flows. Advances in Neural Information Processing Systems (NeurIPS), 34, 4181-4192.
- Leeman, J., Liu, Y., Stiles, J., Lee, S. B., Bhatt, P., Schoop, L. M., & Palgrave, R. G. (2024). Challenges in high-throughput inorganic materials prediction and autonomous synthesis. PRX Energy, 3, 011002.