Appearance
第 01 章 感知器
1.0 写在前面
1.0.1 为什么从感知器学起
第 00 章我们建立了机器学习的基本框架:用训练数据拟合模型、用独立的数据评估模型,并讨论了化学数据中常见的外推风险。从本章开始,我们逐个学习具体模型,第一个就是 1958 年 Frank Rosenblatt 提出的感知器(Perceptron)[1]。它是最早能够根据训练样本的错误自动调整参数的线性二分类算法之一。
今天几乎没有人直接拿原始感知器去发论文,但它值得我们花时间弄懂。原因有三:
- 它把“线性模型”讲得最清楚。 做过物理有机的同学用过 Hammett 方程,做药化的同学算过 Hansch 构效关系。把这些方程里的描述符排成一列、各乘一个系数再加上常数项,得到的就是感知器的判别函数 ,两者的数学形式完全相同。学完本章,你会知道权重的符号和大小什么时候可以解读、什么时候不能(例如特征没有标准化、特征彼此相关,或者模型的解本身不唯一)。
- 它给出了最直观的几何图像。 感知器用一个超平面把特征空间切成两半;支持向量机(SVM)、神经网络中的线性层以及核方法,都可以在这个图像上继续理解。
- 它是检验数据的第一个基线。 拿到一批 DFT 计算或实验数据后,可以先用线性分类器看看两类样本能否被一个超平面大致分开。如果线性模型已经分得不错,复杂模型多出来的那点收益就得认真论证;如果线性模型明显失败,要么是特征与类别之间存在非线性关系,要么是现有特征缺了关键信息。到底是哪一种(电子关联、位阻突变,还是数据噪声),线性模型自己回答不了,要靠化学知识去判断。
1.0.2 学习目标
读完本章,大家应当能够:
- 写出感知器的判别函数、更新规则,并用几何图像解释每一次更新在做什么;
- 叙述
Novikoff收敛定理的条件与结论,并说明数据线性不可分时感知器为什么会持续振荡; - 解释口袋算法、核感知器、一对多多分类以及多层感知器分别解决了感知器的哪个局限;
1.1 背景:感知器的起源与化学中的线性模型
1.1.1 历史脉络
表 1 列出了与本章内容相关的几个关键节点。
表 1 感知器及相关方法的发展简表。只列出与本章内容直接相关的事件;年份以通常引用的论文或著作出版年为准。
| 年份 | 关键事件 | 与本章的关系 |
|---|---|---|
| 1943 | McCulloch 与 Pitts 提出阈值神经元模型 [28] | 证明用简化的阈值单元组成的网络可以实现逻辑运算 |
| 1949 | Hebb 提出突触可塑性假说 | 提出“共同激活的神经元之间连接增强”的学习思想 |
| 1958 | Rosenblatt 提出感知器及其学习规则 [1] | 第一个能从数据中自动调整权重的分类模型(本章第 1.2–1.3 节) |
| 1960 | Widrow 与 Hoff 提出 Adaline 与 LMS 算法 [6] | 用连续误差和梯度下降训练线性单元(下一章的主题) |
| 1962 | Novikoff 发表感知器收敛定理的证明 [2] | 线性可分时更新次数有上界(本章 1.3.5 节) |
| 1964 | Aizerman 等提出势函数方法 [29] | 核感知器思想的来源之一(本章 1.3.8 节) |
| 1969 | Minsky 与 Papert 出版《Perceptrons》[3] | 系统分析单层感知器能够表示和不能表示的判别规则(本章 1.3.10 节) |
| 1986 | Rumelhart、Hinton 与 Williams 推广反向传播算法 [30] | 使多层网络可以被有效训练(本章 1.3.10 节、1.4.8 节) |
| 1989–1991 | Cybenko、Hornik 证明通用逼近定理 [4, 7] | 说明单隐层网络在理论上的表示能力(本章 1.3.10 节) |
| 1990 | Gallant 提出口袋算法 [5] | 处理线性不可分数据(本章 1.3.6 节、1.4.5 节) |
| 1990 年代 | 支持向量机与统计学习理论兴起 | 最大间隔与核技巧(本章 1.3.8 节、附录 A) |
图 1 把这些事件画在同一条时间线上,便于看出感知器研究从兴起、受质疑到在多层网络中复兴的过程。
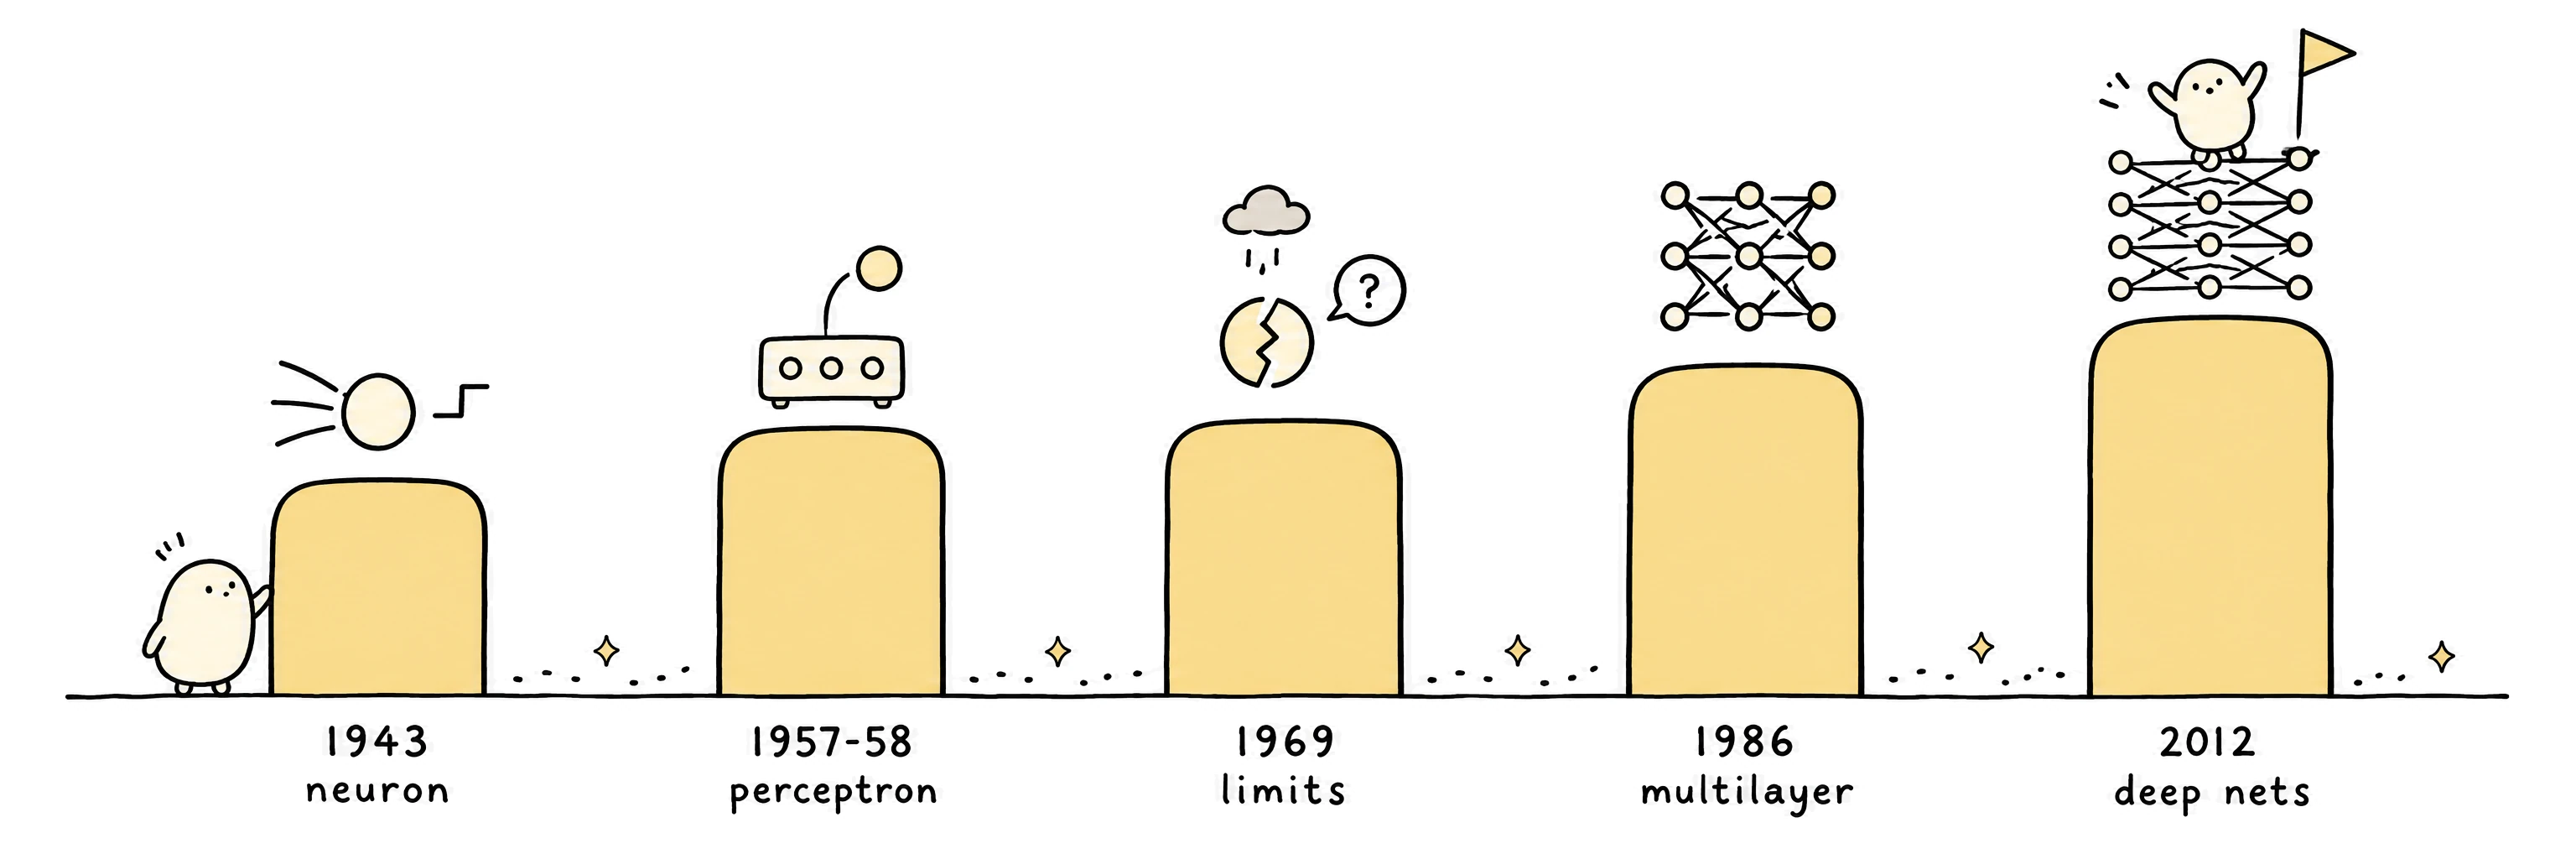
关于 1969 年的《Perceptrons》一书,常见的说法是“它证明了感知器不能解决 XOR 问题”。这句话不够准确:XOR 的四个点不能被一条直线分开,这是一个很容易验证的事实(见 1.3.10 节);Minsky 与 Papert [3] 的主要贡献,是系统分析了单层感知器在识别奇偶性(parity)、图形连通性等判别规则时所受的限制。他们的分析针对的是单层结构,并不否定多层网络。至于这本书对此后神经网络研究热度有多大影响,科学史界仍有不同看法,本书不作断言。
对化学研究者来说,这类似于认识 Langmuir 单分子层吸附模型的适用范围:该模型无法描述多分子层吸附,需要改用 BET 等模型。清楚一个模型在哪里失效,是正确使用它的前提。
1.1.2 感知器与 Hammett 方程
线性模型在化学中有很长的应用历史。1937 年,Louis Hammett 提出了线性自由能关系(LFER)[8]:
其中 与 分别是取代苯衍生物与未取代母体的反应速率常数或平衡常数,取代基常数 描述取代基的电子效应,反应常数 描述该反应对电子效应的敏感程度。
1964 年,Corwin Hansch 与 Toshio Fujita 把这一思路推广到药物化学,建立了 Hansch 定量构效关系(QSAR)方程 [15, 16]:
式中 是产生某一生物效应所需的浓度, 是脂水分配系数, 是电性参数, 是 Taft 立体参数, 由多元线性回归确定。如果把这些描述符排成特征向量 ,把系数排成权重向量 ,就得到:
这正是感知器内部计算的量。图 2 把两种写法并排放在一起。
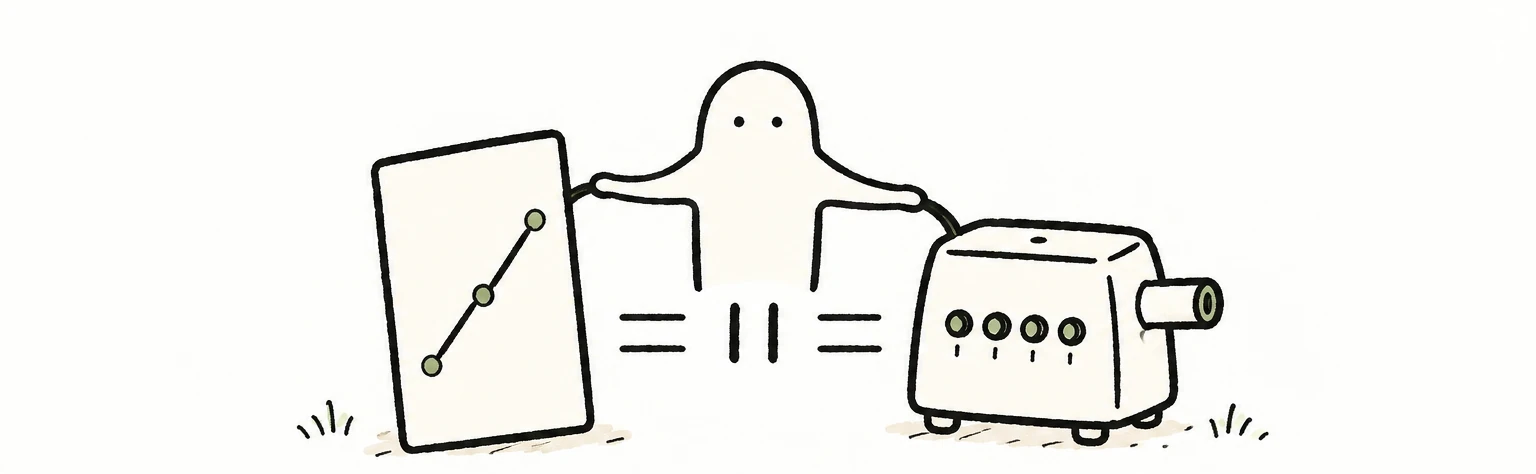
两者的区别在于用途和求解方式。Hansch 方程预测的是连续的活性数值,系数通常用最小二乘法拟合;感知器在 之后还要取符号,输出离散的类别,参数由“分错一个样本就修正一次”的规则逐步调整。
在 Hansch 方程中,系数 通常可以结合疏水作用、电子效应和位阻效应来讨论,但这依赖于描述符本身有明确含义、彼此相关性不强,并且回归解是唯一的。感知器的权重则需要更谨慎地解读:后面会看到,同一批数据可以有无数组都能把训练集分对的权重(1.3.6 节),因此通常只有在特征标准化之后,权重的符号和相对大小才有参考价值(1.5.5 节)。
1.1.3 线性单元在现代模型中的位置
原始感知器使用阶跃函数输出类别,现代神经网络中已经很少直接使用它;但“加权求和再加偏置”的线性单元无处不在:
- 图神经网络(GNN)的读出层。 GNN 把分子看作由原子(节点)和化学键(边)组成的图,经过若干轮信息传递后得到整张图的向量表示,最后通常用一个线性层或小型多层感知器把这个向量映射为带隙、结合能等目标性质。这个线性层与感知器的 是同一种运算,只是不再取阶跃函数。GNN 将在后续章节专门介绍。
- Transformer 中的线性投影。 Transformer 先用线性层把每个输入向量投影成查询、键和值,再用 softmax 计算注意力权重,并对值向量加权求和。其中的线性投影与感知器的加权求和同类;注意力权重本身则由
softmax给出,与感知器的学习规则无关。 - 高通量筛选中的快速初筛。 面对数十万个候选化合物时,可以先用计算代价很低的线性模型排除明显不合适的结构,再把剩下的候选送去做 DFT 计算或实验合成。
1.2 模型:从人工神经元到决策超平面
1.2.1 生物原型与数学抽象
感知器的设计受到生物神经元的启发。图 3 把生物神经元与人工神经元的各部分对应起来,图 4 则放大了其中“加权求和、超过阈值才输出”这一步。
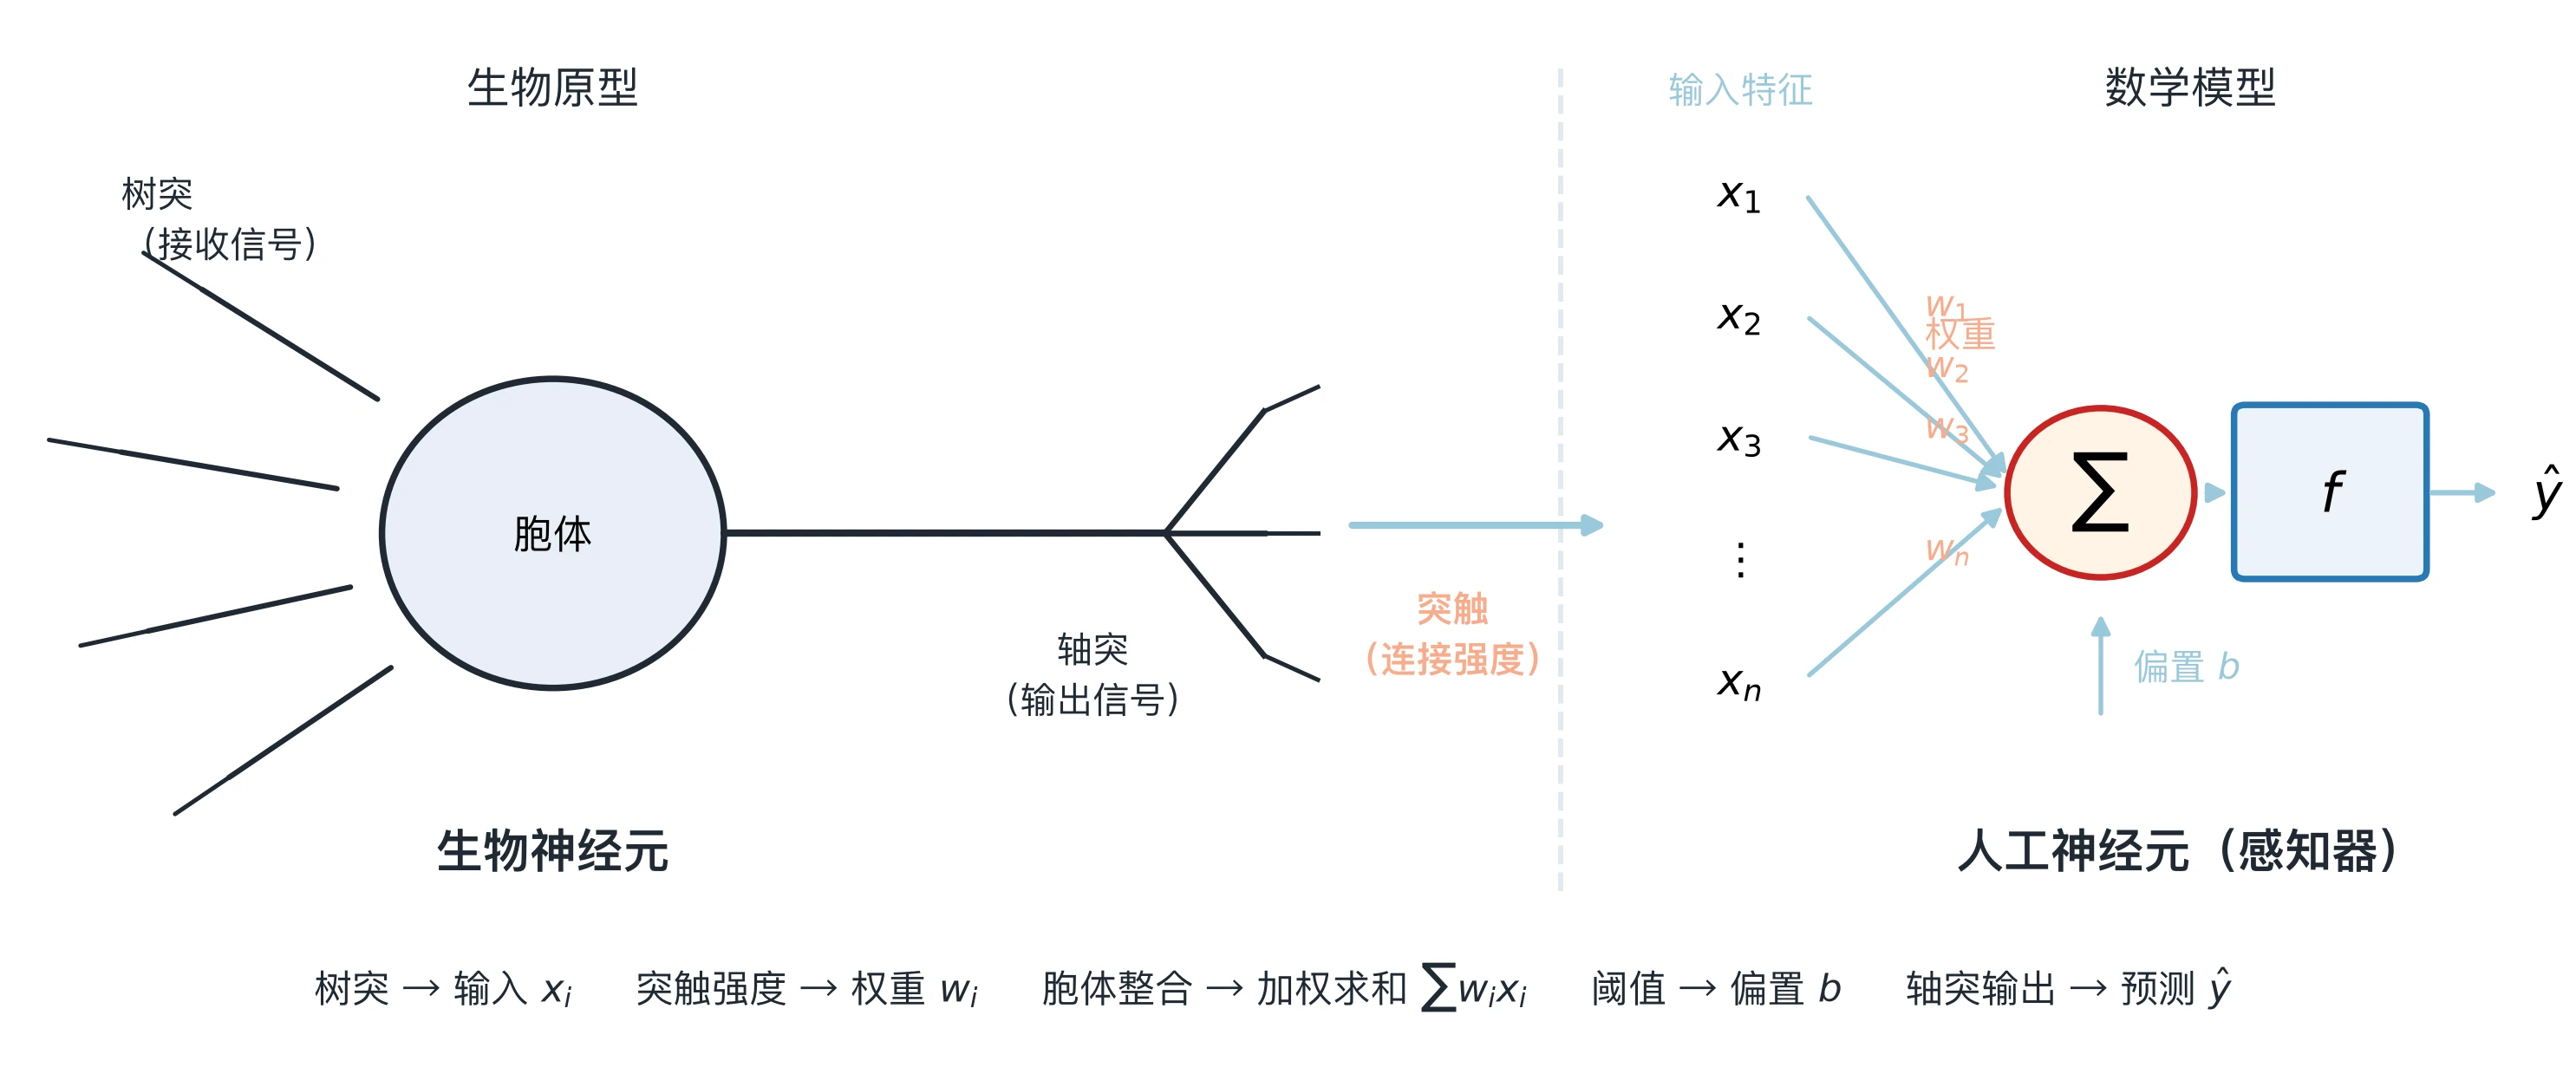
两张图对应的关系可以概括为:
- 树突收集的输入信号,对应输入特征 (例如电负性差、相对分子质量、分子指纹的某一位);
- 突触连接强度,对应权重 ,其正负表示该输入促进还是抑制输出;
- 胞体对信号的整合,对应加权求和 ;
- 发放动作电位的阈值 ,对应偏置:判据 等价于 ,其中 ;
- 是否发放动作电位,对应二元输出 。
这只是一个启发性的类比。真实神经元的行为远比这复杂,后文不再依赖生物学解释。
1.2.2 数学定义
设表征化学体系的 维特征向量为 ,对应的权重向量为 ,标量偏置为 。感知器的判定过程分为两步:
第一步计算输入特征的线性组合,称为净输入(net input),也叫判别得分:
第二步把 送入阶跃激活函数,输出离散的类别:
按照式 (5), 恰好等于 0 的样本被判为负类;训练时则把 的样本当作“没有分对”处理(见 1.3.3 节和 1.4.2 节)。
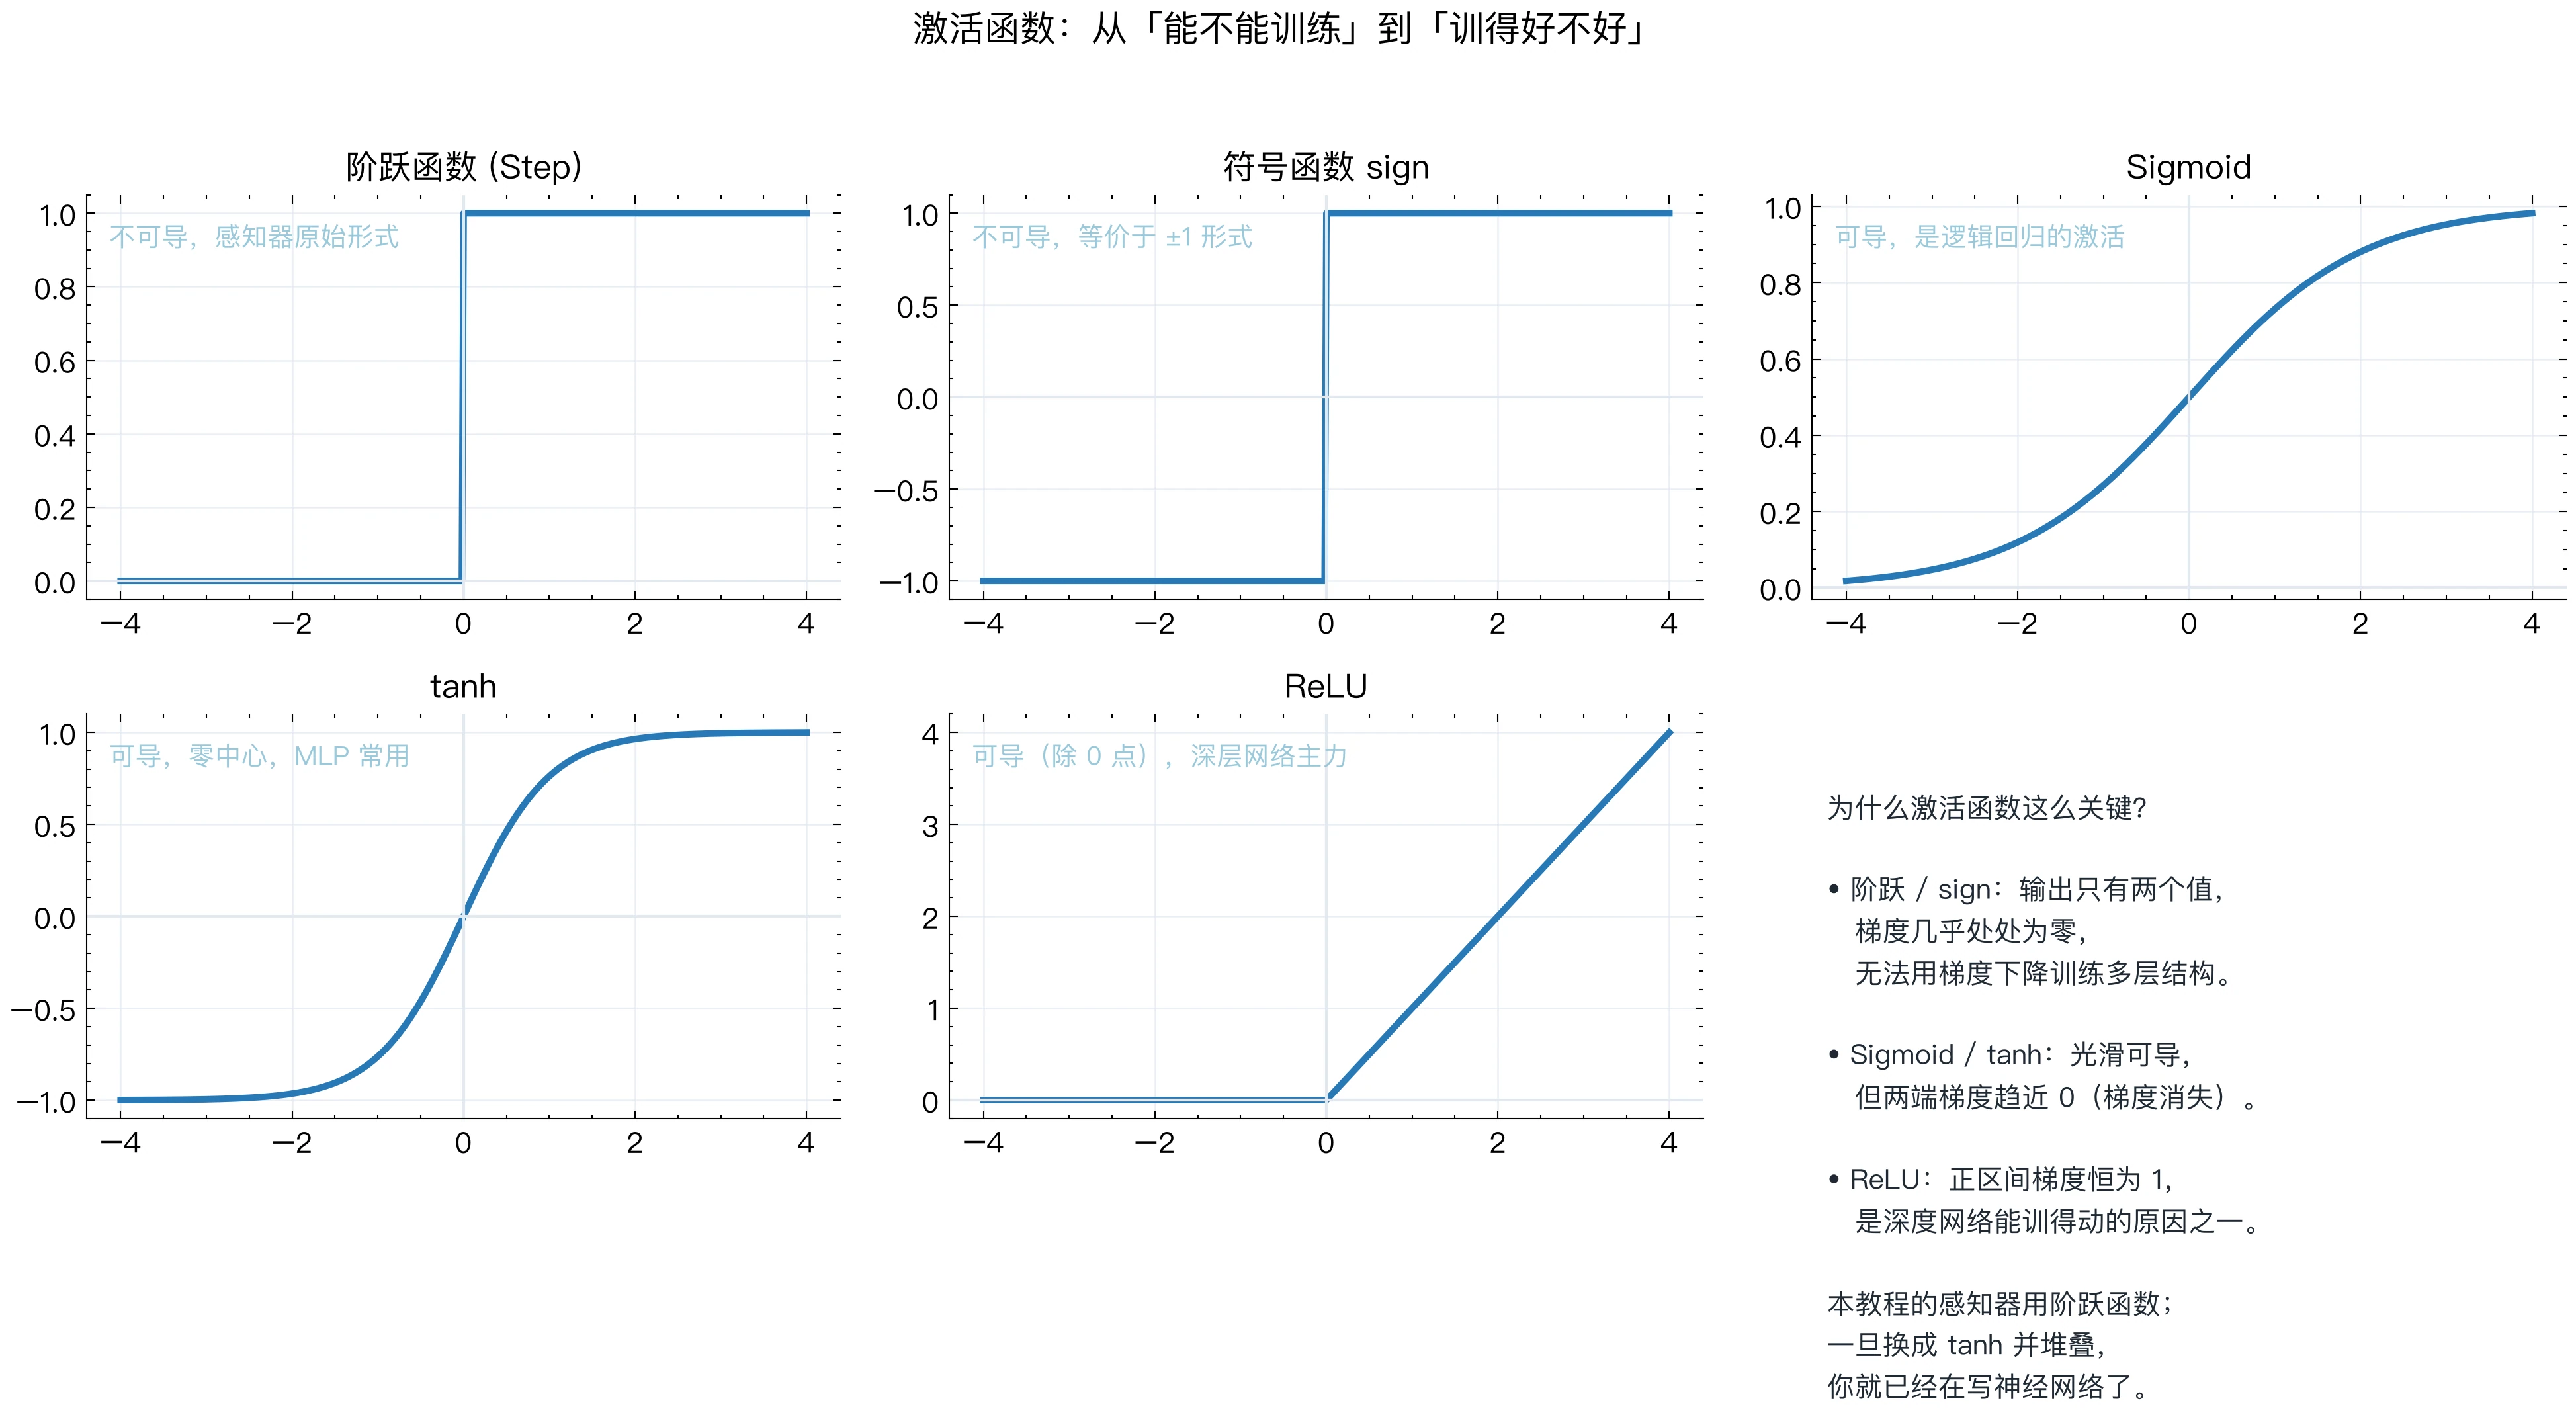
阶跃函数在 处跳变,在其他地方是常数。图 5 把它与后面章节会用到的两种光滑激活函数放在一起比较。
推导时采用对称标签 最方便(代码中允许任意两种标签,内部再映射为 )。在这种记号下,样本被正确分类的充要条件是:
当真实类别为正类()时,模型要求 ,乘积为正;当真实类别为负类()时,模型要求 ,负负得正后乘积同样为正。这样一来,我们不必分正类、负类两种情况讨论:只看乘积的符号,大于零就是分对了,小于等于零就是分错了,或者恰好压在分界面上。这个乘积不只告诉我们对错,它的大小还反映模型判断得有多“笃定”,称为样本 的函数间隔(functional margin),后文会反复用到。
许多文献使用增广向量,把偏置并入权重:令 、,则 。本章正文和代码保留单独的偏置 ,便于区分“特征的权重”和“整体的平移”;1.3.5 节证明收敛定理时为了书写简洁改用增广向量。
1.2.3 几何图像:决策超平面与几何间隔
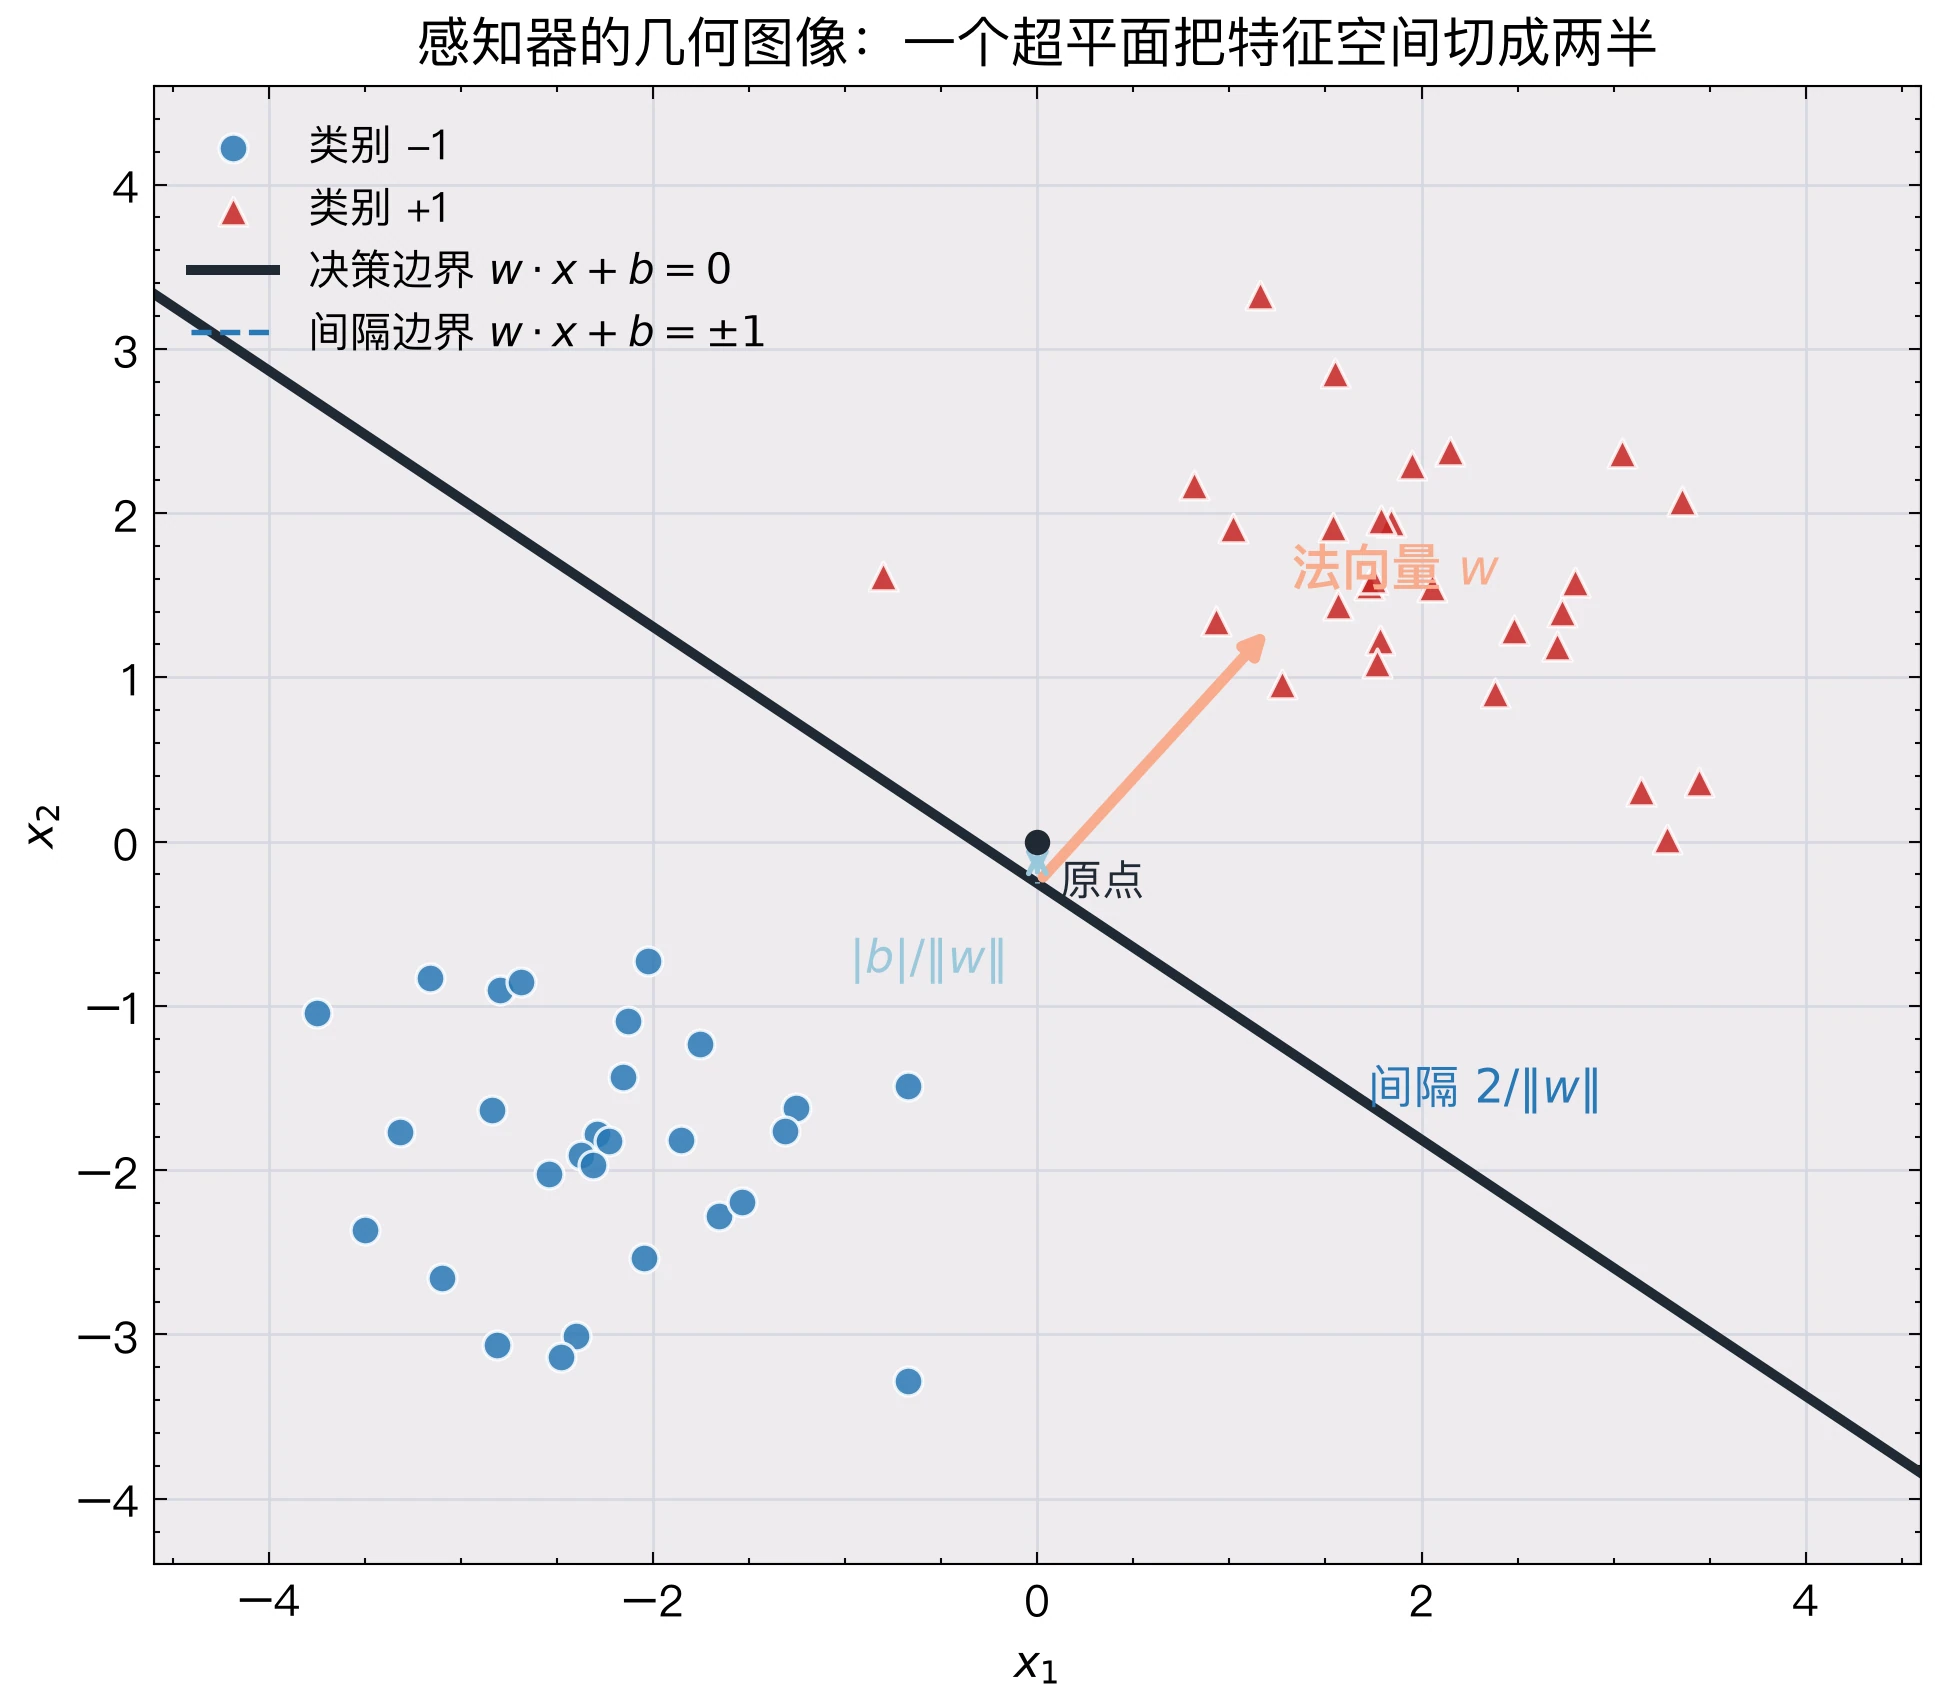
在特征空间中,方程 定义了一个超平面(hyperplane):二维时是一条直线,三维时是一个平面。它把特征空间分成两个半空间, 的一侧判为正类,另一侧判为负类(图 6)。
那么这个超平面朝哪里、离原点多远、样本离它多远?下面逐个推导,结果汇总在图 7 中。
超平面的空间朝向由法向量 唯一确定。在超平面上任取两点 ,由于两点均满足超平面方程,两者作差并与权重向量求点积:
内积为零说明超平面内的任何方向都与 垂直,即 是超平面的法向量,并且指向正类一侧。偏置 则决定超平面离原点有多远:由下面的式 (8) 令 ,可得原点到超平面的带符号距离为 ;换一种说法,超平面位于原点沿 方向 处。
空间中任意样本点 到超平面的带符号垂直几何距离为:
分子 就是判别得分 。直接用 衡量远近有个漏洞:把 和 同时放大 10 倍,分界面在图上纹丝不动, 却变成了原来的 10 倍。除以 就消掉了这种缩放,剩下的才是样本到分界面的真实垂直距离。
对于给定的 ,训练集中所有样本带符号距离的最小值称为这个超平面在该训练集上的几何间隔(geometric margin):
表示所有样本都被分对,而且离分界面最近的样本也有 的距离; 越大,分界面两侧留出的“空白带”越宽。1.3.5 节的收敛定理会用到一个相关但不同的量:在所有可能的分离超平面中能达到的最大几何间隔,它刻画的是数据本身有多容易分开,而不是某一次训练得到的超平面。
1.2.4 线性可分性与化学数据中的不可分现象
感知器的本质是在特征空间里画一个平面当分界线。于是有一个很现实的问题:我们手头的化学和材料数据,真能用一个平面一刀切开吗?先给出定义:如果存在一组参数 ,使训练集中所有样本都满足 ,就称该数据集线性可分(linearly separable)。
真实的材料化学数据常常不是线性可分的,常见原因包括:
- 所选特征不足以区分样本。 例如本章数据集中,CuO 与 SiO₂ 的 Pauling 电负性差都是 1.54,但带隙分别约为 1.4 eV 与 9 eV(教学数据集中的取值,见 1.5.2 节)。只看电负性差,这两个化合物落在同一个位置,任何超平面都无法把它们分到两侧;要区分它们,需要加入反映 d 电子、晶体结构等信息的其他特征。
- 性质随组成发生突变。 掺杂浓度越过某个临界值时,体系可能发生金属–绝缘体转变或逾渗,类别在很窄的组成范围内突然改变,难以用一个平面描述。
- 描述符过于粗糙。 分子量、元素组成等简单描述符无法区分手性异构体或不同的晶格堆垛方式,不同类别的样本在低维特征空间中重叠。
- 标签本身有噪声。 不同来源的实验数据在测试条件、样品纯度上存在差异,个别样本的标签可能就是错的。
第 1.3.5 节会看到,线性可分与否直接决定感知器能否停下来。
1.3 学习算法:参数更新与收敛理论
1.3.1 优化目标与感知器损失
第 1.2 节定义了模型,本节回答“参数从哪里来”。对二分类问题,最直接的目标是让分错的样本数最少,即最小化 0-1 损失:
其中 为指示函数,条件成立时取 1,否则取 0。问题在于:参数稍微变化时,分错的样本数通常不变,只有在某个样本跨过分界面时才突然跳变。因此 0-1 损失对参数的导数几乎处处为零,在跳变处又不存在。这像是做滴定时只看指示剂变没变色:到终点之前,无论滴多少,颜色都没反应,我们也就不知道该往哪个方向继续滴。
感知器换用了一个分段线性的替代损失:不再只数分错了几个,而是看分错的样本“错得有多深”,用它们的函数间隔(取负号)作为惩罚:
集合 是当前被分错(或落在分界面上)的样本。感知器损失有三个特点:
- 已被正确分类的样本()损失为 0,不参与更新;
- 分错的样本离分界面越远, 越大。这个量与样本到分界面的距离成正比(相差因子 ),但它是函数间隔,不是几何距离。损失对参数是连续、分段线性的,在不可导的折点处可以用次梯度(subgradient)代替梯度;
- 时所有样本的函数间隔都是 0,损失也是 0。也就是说,单纯最小化式 (11) 会得到一个毫无用处的平凡解。感知器避开它的办法在算法本身:把函数间隔“”的样本都算作分错并触发更新(见 1.3.3 节、1.4.2 节),所以零向量不会被当作终点。
1.3.2 损失函数梯度与更新规则
对误分类集合 中的单个样本点 ,损失项 关于权重 与偏置 的偏导数分别为:
按照梯度下降的思路,参数沿负梯度方向移动。每遇到一个分错的样本就更新一次,更新规则为:
其中 为学习率。这就是 Rosenblatt 感知器的学习规则 [1]。换一个角度看,它等价于对感知器损失做批大小为 1 的随机梯度下降(SGD):每次只看一个样本,分错了就沿这个样本的负梯度走一步,分对了就不动。
实现时有两种做法:一是批量更新,先找出当前所有分错的样本,再一次性更新 ;二是在线更新,逐个检查样本,遇到分错的就立即修正,再用新参数检查下一个样本。经典感知器采用在线更新,本章代码也是如此。
1.3.3 纠错更新的代数性质
更新规则为什么有效?先看一次更新对触发它的那个样本有什么影响。设样本 在当前参数下被误分类,即满足 。
当真实类别为正类()时,意味着当前判别得分 。执行单步更新 与 后,重新计算该样本在新参数下的判别得分:
由于向量欧氏范数平方与常数项之和 ,只要学习率 ,更新后的判别得分必然严格大于更新前的初始得分:
同理,对于被误判为正类的负样本(),更新后其判别得分严格降低。可见每一次更新都让触发它的样本朝“被分对”的方向移动了 。需要注意两点:一次更新不一定能把这个样本完全纠正过来;而且更新可能让其他原本分对的样本变错。所以单看一步,我们无法判断算法最终能否停下来:为迁就一个样本而转动分界面,说不定会把刚才分对的样本又扫到错误的一侧,如此拆东墙补西墙,会不会永远停不下来?这正是 1.3.5 节收敛定理要回答的问题。
1.3.4 更新的几何图像
交互图表 感知器纠错更新与决策超平面。 选择可分、重叠或 XOR 数据,点击“训练”或“单步”观察纠错更新如何改变决策边界。选择要添加的样本类别后,可点击图中空白处添加样本,悬停在样本上查看信息;调整学习率可比较更新幅度,点击“重置”重新开始训练。
数据情景
点击添加
速度
准确率0%32 误分
几何间隔
累计纠错0epoch 0
参数
决策边界点击空白处添加样本 · 悬停查看
间隔带
1.3.3 节从代数上说明了更新的效果,下面换成几何语言。图 6 和图 7 中,超平面由法向量 和偏置 决定;一次更新同时改变这两个量,于是超平面既转动又平移(图 8)。
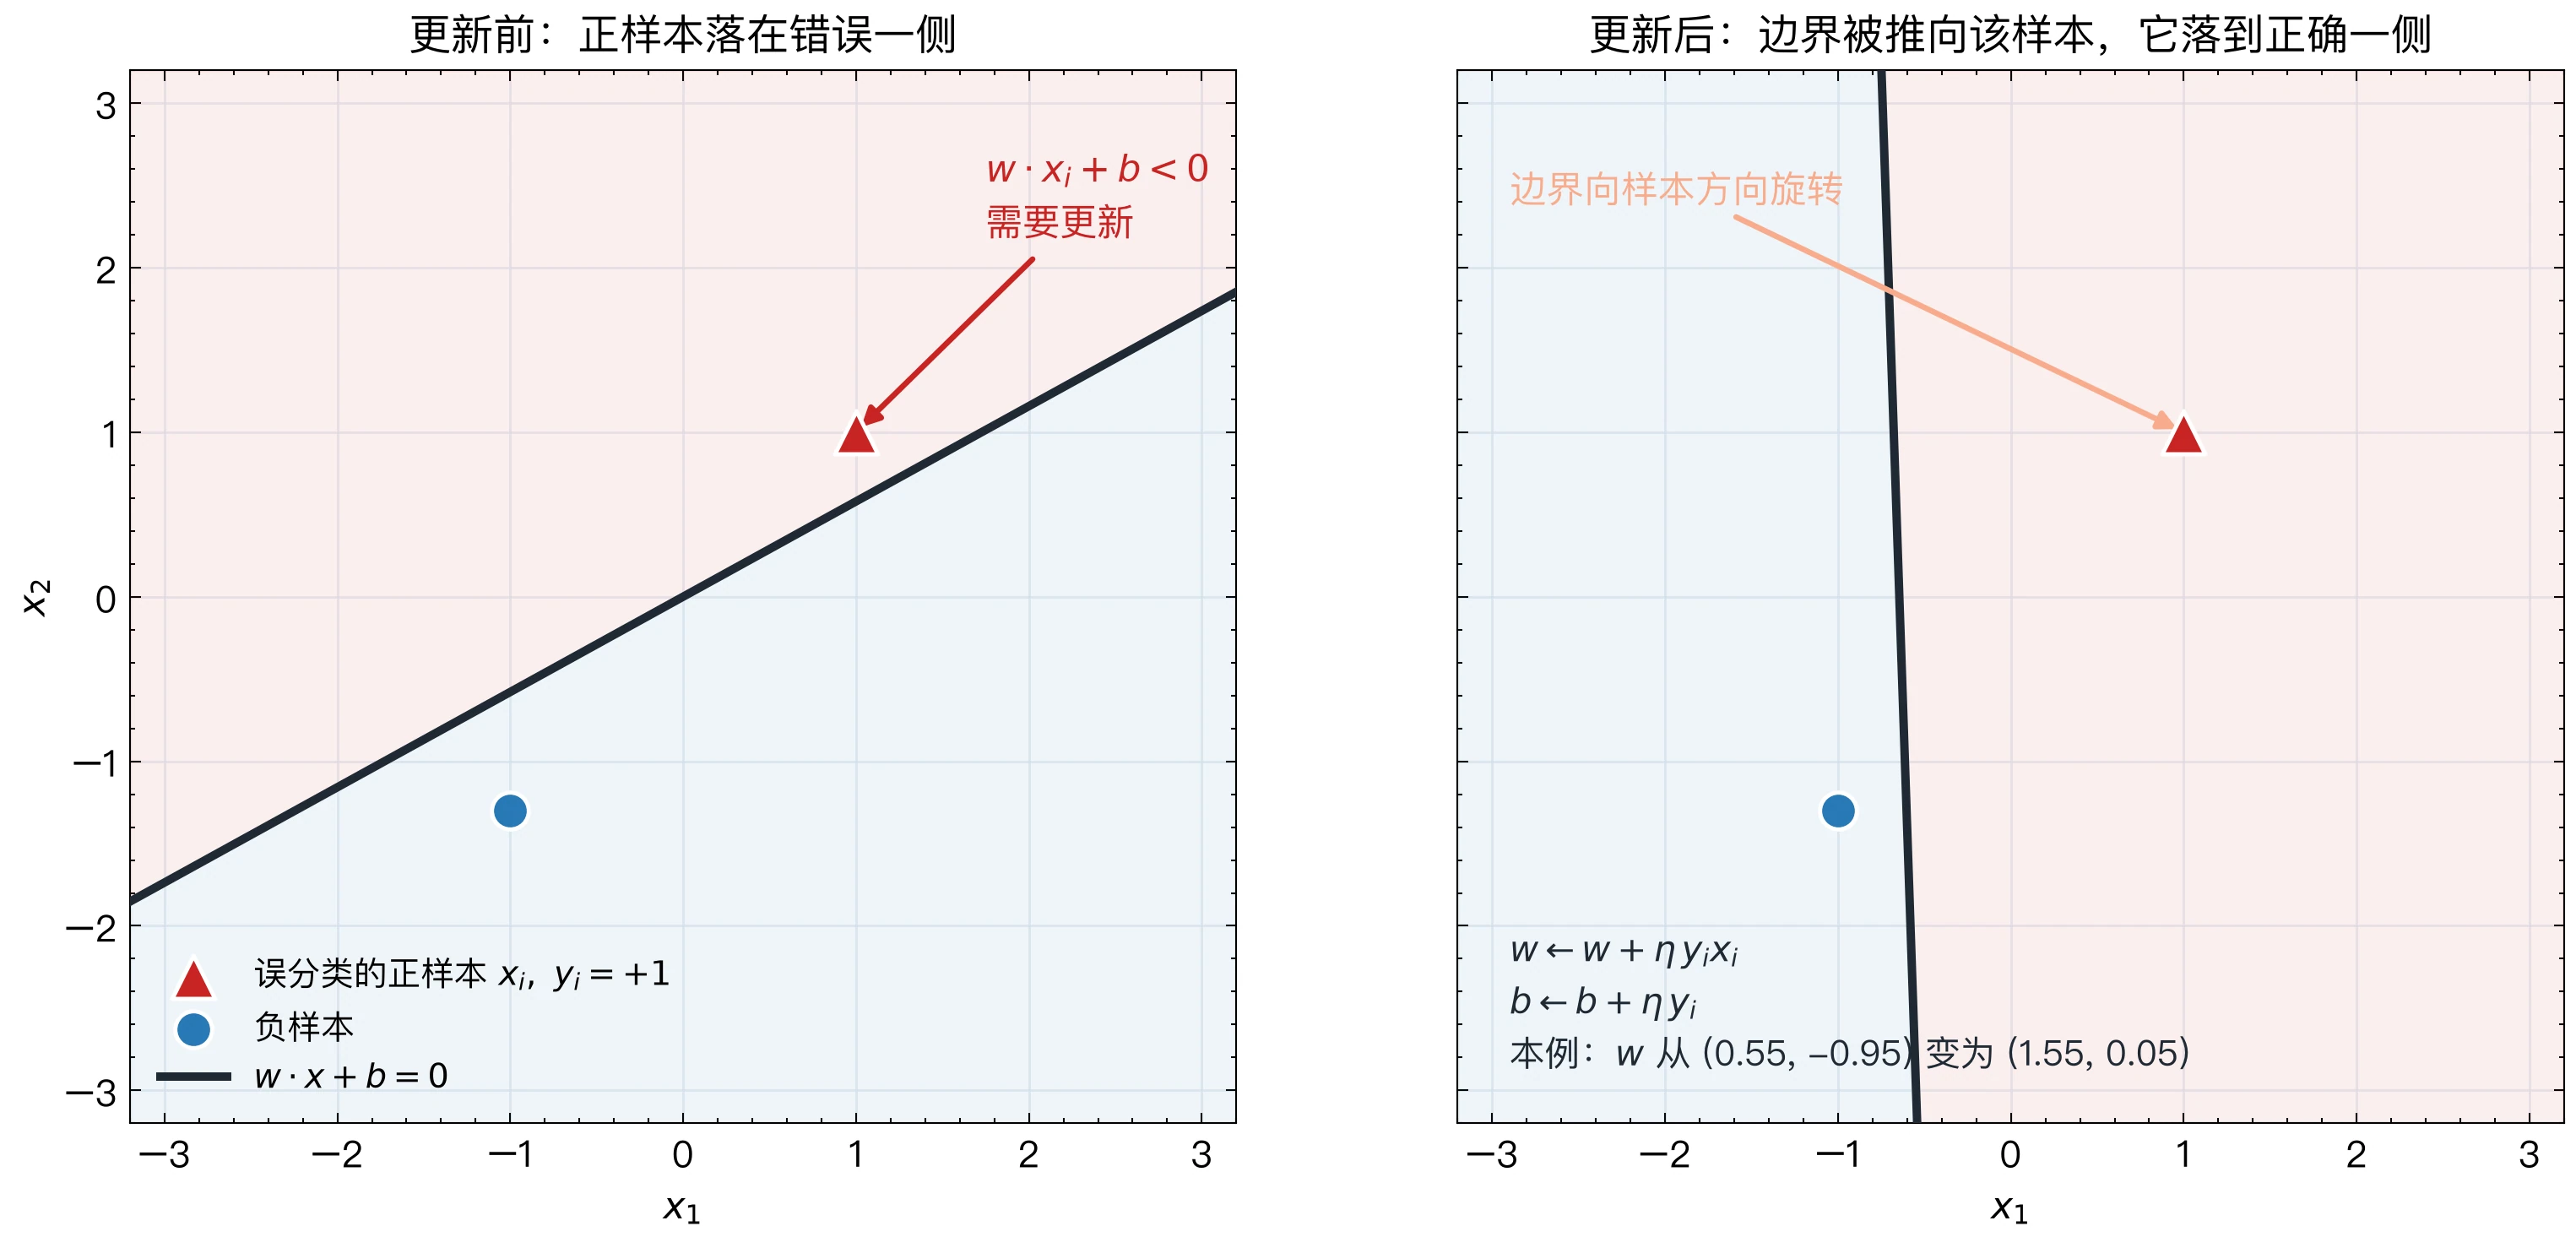
具体来说:
- 转动: 加上了 。对正类样本(),法向量向 偏转;对负类样本,法向量背离 偏转。超平面始终与法向量垂直,所以跟着转动。
- 平移: 变为 ,超平面沿法向平移,这一步相当于调整判别阈值。
- 在参数空间中看: 向能把该样本分对的参数区域移动了一步。
逐个读取二维样本,只在 y(w·x+b)≤0 时进行纠错更新。
类别 −1类别 +1w·x+b=0正在检查
w=(-0.5, 0.2),b=0;当前有 5 个非正间隔样本。下一步更新参数。
思考与说明
思考观察当前样本与下一步边界:误分类点的得分朝哪个方向改变?
固定、线性可分的合成数据;边界上的点按需要纠错处理。
1.3.5 Novikoff 收敛定理
上一节留下的隐患是:每次更新都可能把别的样本弄错,算法会不会无休止地改来改去?Albert Novikoff 在 1962 年给出的收敛定理 [2] 给出了答案:只要数据线性可分,更新次数就有一个有限的上界。
样本顺序
数据:60 个线性可分样本
过原点的齐次形式
半径 R2.00
实际间隔 γ0.205
实际纠错次数 k1
上界 (R/γ)²95k 占 1.1%
间隔、半径与纠错次数灰带为间隔区域,其中没有样本
真实分界 w* 学到的 w 上界
为了书写简洁,本节使用 1.2.2 节介绍的增广向量 、,并把波浪号省略,直接写作 与 。读证明时请记住:此时 的末尾多了一个常数 1, 的末尾多了偏置 ,所以偏置没有消失,只是藏进了向量里。于是判别得分写成 ,更新规则写成 。
定理:设训练集 线性可分,。也就是说,存在一个单位向量 ()和一个正数 ,使所有样本满足:
再设所有(增广后的)样本满足 。注意增广后 ,所以 也包含了常数分量的贡献。那么感知器从 出发,无论样本以什么顺序出现,总的更新次数 都满足:
这里的 与 只是分析工具,代表“某一个”能以间隔 分开数据的理想超平面,算法并不需要知道它们;取能达到的最大 时上界最紧。 也不是 1.2.3 节中某次训练得到的超平面的几何间隔。下面的证明取 ;对零初始化的感知器, 取其他正值只会把所有权重乘以同一个常数,不改变哪些样本被分错,因此结论对任意 都成立。
证明:设初始权重 , 表示第 次更新后的权重向量。设第 次更新由样本 触发,满足 。根据规则,。
证明的思路是比较两个量的增长速度。第一个量是 与理想方向 的内积,它衡量 在理想方向上走了多远:
其中不等号用到了式 (17)。从 出发逐次累加,可知 次更新后 ,即内积至少线性增长。
第二个量是 的长度。展开平方:
由于更新是由误分类样本触发,交叉项满足 。同时 ,因此:
结合 Cauchy-Schwarz 不等式:
也就是说,内积至少按 增长,而长度最多按 增长。打个比方:一个人沿正北方向前进的距离,不可能超过他实际走过的总路程。内积不能超过长度,这正是 Cauchy–Schwarz 不等式;一个涨得快、一个涨得慢,更新次数 迟早被卡住,不可能无限增大。两端平方并除以 :
证毕。
图 10 用示意图概括了这个证明。
从这个定理可以得到三点认识:
- 线性可分则有限步停机。 只要数据线性可分,无论学习率取多少(正值)、样本以什么顺序出现,感知器都会在有限次更新后把训练集全部分对。
- 决定上界的大小。 上界只依赖比值 :把所有特征同时乘以一个常数, 和 同比例变化,上界不变。真正影响上界的是各特征之间的相对尺度。如果某个特征的数值远大于其他特征(例如相对分子质量为数百,而电负性差不到 1), 主要由这个特征决定,而两类样本的分离可能主要依赖数值较小的特征,这时 往往很大。标准化(1.4.4 节)把各特征调到相近的尺度,通常能减小 ,但并不保证一定减小。另外,式 (18) 只是上界,实际更新次数往往少得多。
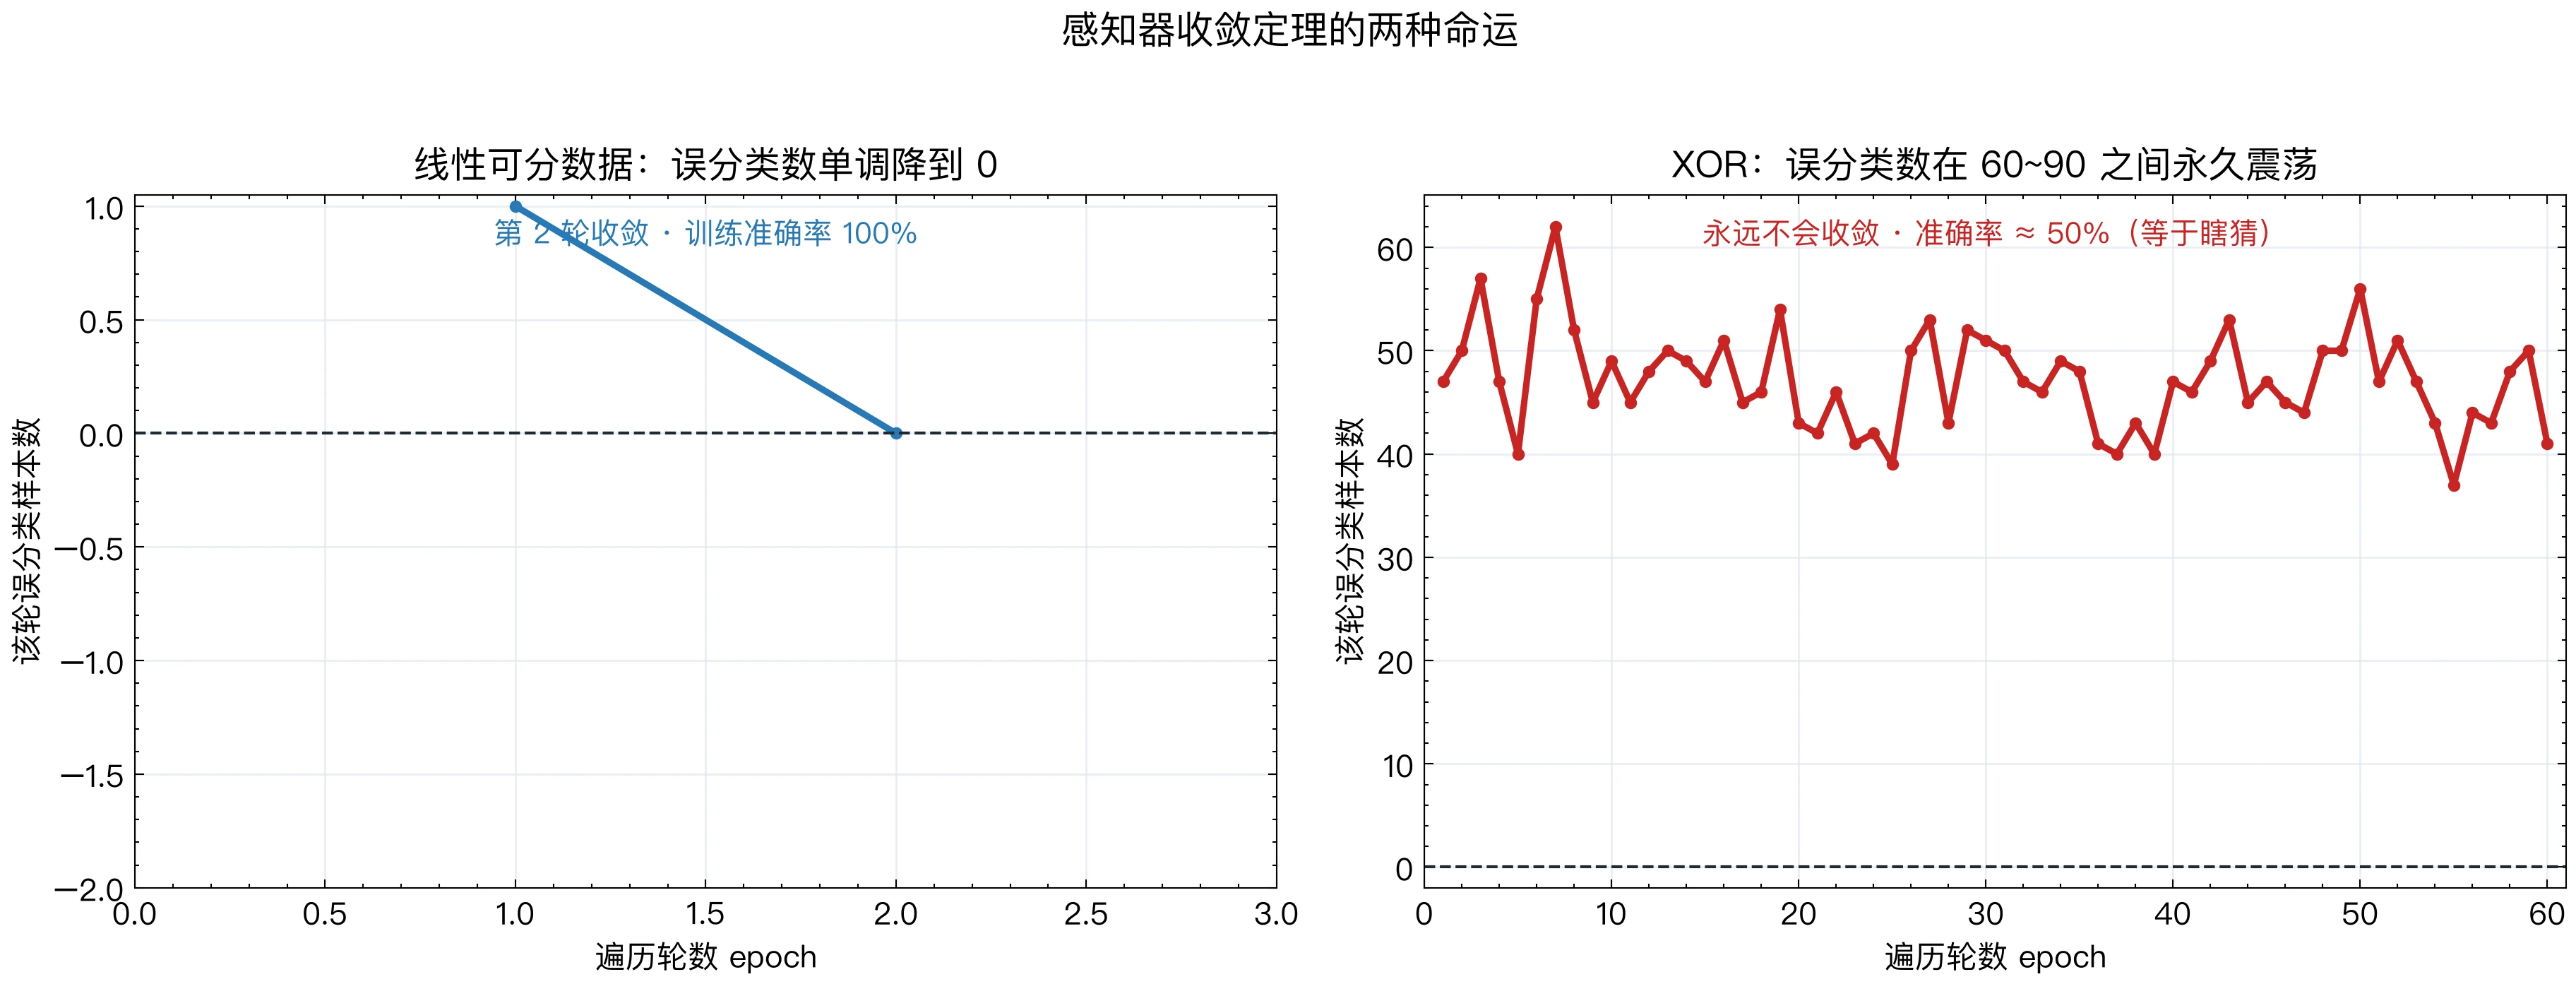
- 线性不可分时不会停机。 如果数据线性不可分,就不存在满足式 (17) 的 和 ,定理不再适用。此时每一轮总有样本被分错,感知器会一直更新下去,权重在若干个状态之间来回振荡,训练误差不会稳定下来。图 11 给出了两种情形的实测对比。
【收敛界与核方法】
式 (18) 的上界中没有出现特征维数 ,只出现了 。这意味着,即使把样本映射到维数很高的特征空间,只要映射后的数据仍以较大的间隔可分,感知器仍能较快收敛。这是 1.3.8 节核感知器能够工作的原因之一。
回顾更新过程可以发现,从零出发的权重向量总是训练样本的线性组合:
其中 是样本 触发更新的次数。如果先用映射 把样本变换到新的特征空间,再在新空间中运行感知器,那么所有计算都只涉及内积 ,收敛界相应地变为
其中 是新空间中的间隔。例如高斯径向基核(RBF 核)满足 ,所以 (为简洁起见,这里忽略偏置项的贡献)。感知器只要求找到“某一个”分离超平面;支持向量机则进一步要求找到间隔最大的那一个(附录 A.1)。
1.3.6 解的非唯一性与口袋算法
Novikoff 定理很漂亮,但有两个前提:数据必须线性可分,而且它只保证“能停下来”,没说停在哪里。真实的化学数据里,只要混进一个带隙测错的过渡金属氧化物,前提就不成立了。先看停在哪里的问题。线性可分时,能把训练集全部分对的超平面通常有无穷多个;感知器停在哪一个,取决于样本的遍历顺序和初始参数。而且感知器一旦把所有样本分对就立即停止,得到的超平面可能紧贴着某些样本,几何间隔很小。这样的分界面对测量噪声很敏感:样本稍有扰动就可能被分到另一侧。附录 A.1 介绍的支持向量机通过最大化间隔来解决这个问题。
数据
当前 w 误差55.7%
口袋 w 误差17.1%于第 27 次更新
数据不可分普通感知器不收敛
误差差距38.6 pp
普通感知器与口袋算法圈出的样本触发了本次更新
当前 w 口袋 w
再看线性不可分的情形。图 11 已经显示,这时感知器会一直振荡,训练结束时的权重只是振荡过程中的某一个状态,好坏全凭运气。既然停不下来,能不能至少把折腾过程中表现最好的那一刻留下?Stephen Gallant 在 1990 年提出的口袋算法(pocket algorithm)[5] 给出了一个简单的补救办法(图 12):在正常运行感知器的同时,用一个“口袋”保存迄今为止表现最好的权重,训练结束时返回口袋里的权重,而不是最后一步的权重。
“表现最好”有两种常见的判断方式。Gallant 的原始版本记录的是“连续分对样本数最多”的权重;改进的“带棘轮的口袋算法”(pocket algorithm with ratchet)则在替换口袋内容之前,先确认新权重在整个训练集上的误分类数确实更少。本章 1.4.5 节实现的是后一种思路:每次更新后都在整个训练集上计算误分类数,比口袋里的更少就替换。
口袋算法并不能消除振荡,感知器本身照样来回摆动;它只是保证我们最终拿到的是振荡过程中训练误差最小的那组权重。代价是每次更新后都要在全训练集上评估一次,计算量明显增加(1.4.5 节)。
1.3.7 影响训练过程的三个因素
前几节的分析可以归结为实践中的三条要点(图 13):
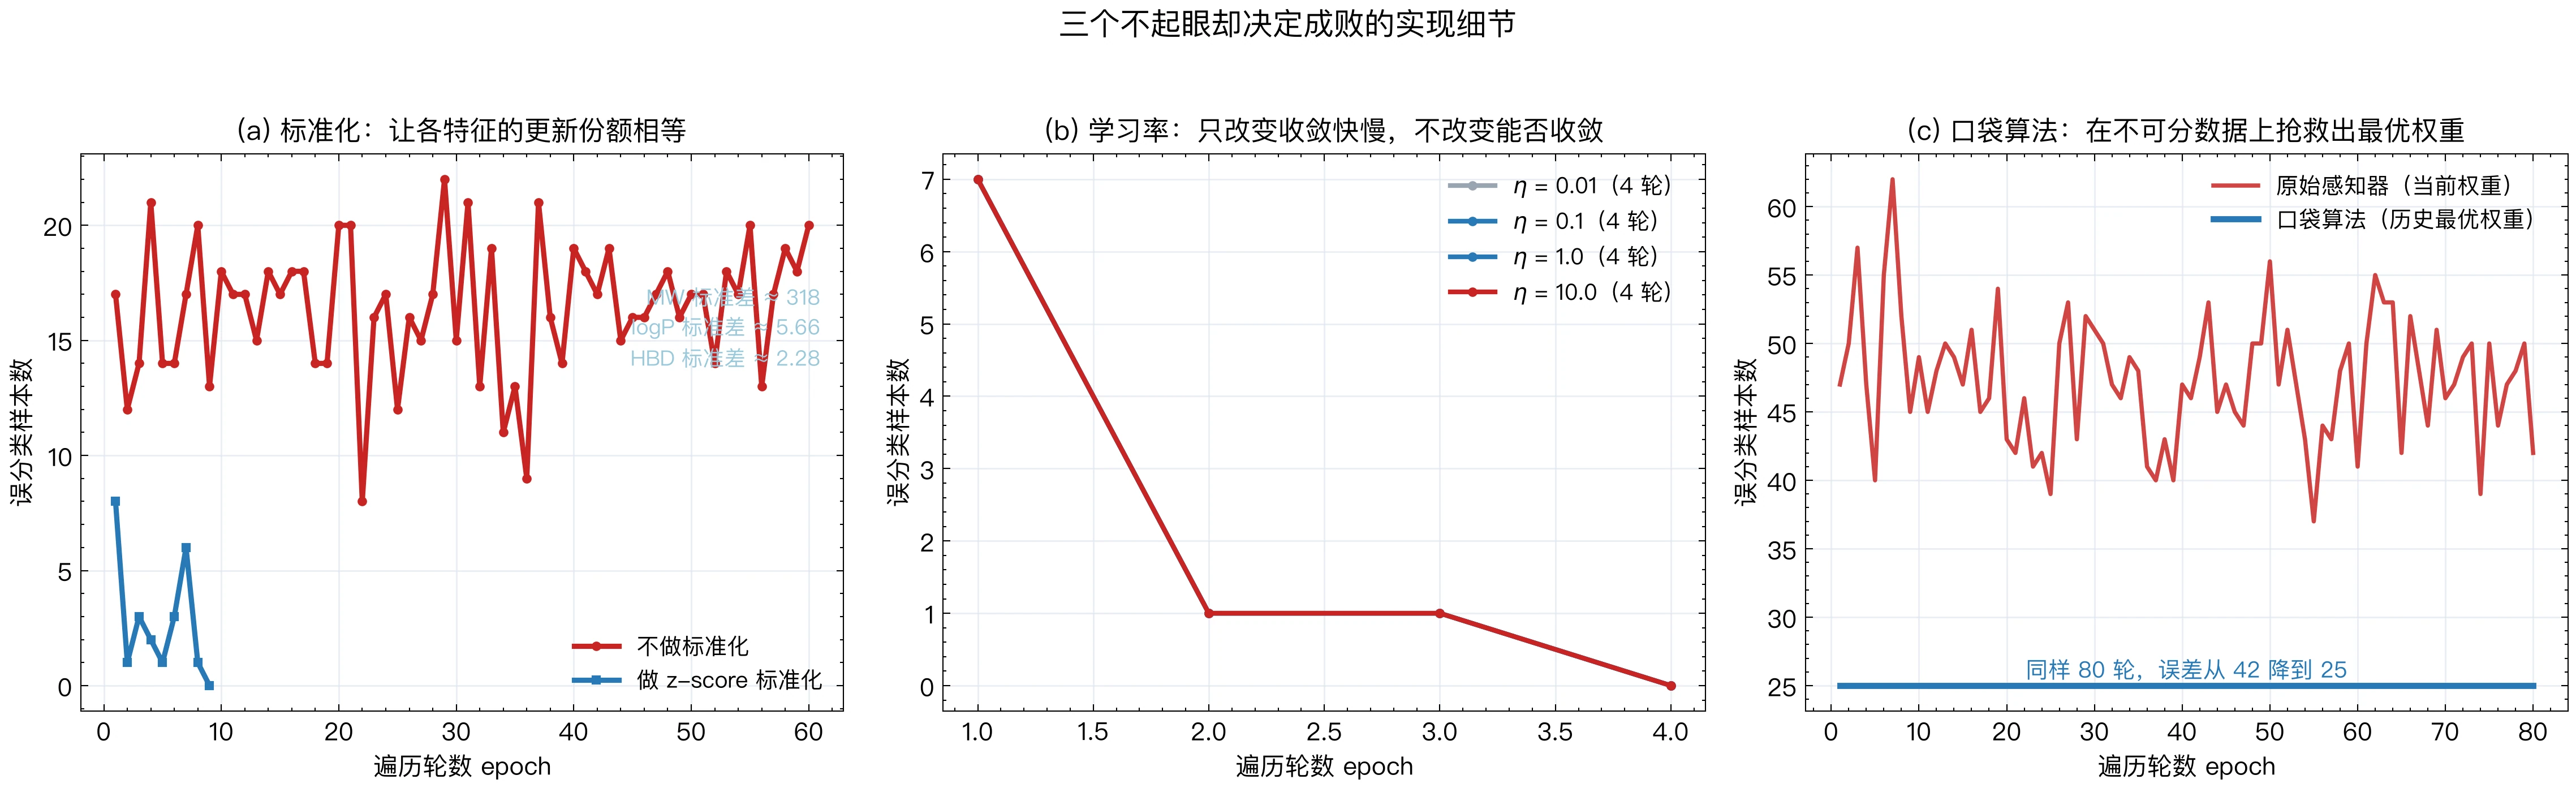
- 特征标准化。 对每个特征做变换 ,使其均值为 0、标准差为 1。感知器每次更新的增量是 ,数值大的特征对应的权重分量变化也大;如果不标准化,更新方向几乎完全由数值最大的特征决定。标准化还有一个好处:权重的相对大小变得可以比较(1.5.5 节)。注意 和 只能用训练集计算(1.4.4 节)。
- 学习率 。 对零初始化的感知器,把 换成 (),每一步的权重和偏置都恰好变为原来的 倍,判别得分的符号不变,所以分错哪些样本、何时停止、最终的决策边界都完全相同。因此 通常直接取 1.0,本章代码的默认值也是 1.0;个别示例中取 0.1,只是改变了权重的数值尺度。若初始权重不为零, 才会影响结果。
- 每轮打乱样本顺序。 在每一轮(epoch)开始前随机打乱样本顺序。如果数据按某种规律排列(例如所有绝缘体排在前面),固定顺序可能让权重先被一类样本“拉”向一边,再被另一类拉回来,在不可分数据上形成固定的循环。打乱顺序可以避免这种由排列方式造成的偏差。
1.3.8 对偶形式与核感知器
当数据线性不可分时,一个自然的想法是把特征变换到新的空间,使数据在新空间中变得线性可分(1.4.9 节的 XOR 实验会具体演示)。但特征一多,把所有高阶交叉项都显式算出来,计算和内存开销会迅速膨胀。核感知器提供了一种不必显式写出新特征的做法。它的出发点是:从零出发的感知器,权重向量始终是训练样本的线性组合(1.3.5 节的式 (24)):
数据集
核函数
数据
训练准确率0.0%
α 非零样本0/ 80
本轮纠错—
轮次0/ 25
对偶形式的决策函数底色为 f(x) 的符号与大小,橙圈大小≈αᵢ
f>0 f<0
其中 , 是样本 触发更新的次数。代入判别函数:
可见判别函数只通过训练样本与待测样本之间的内积依赖于数据。这种用 而不是 表示模型的方式称为对偶形式。如果先用映射 把样本变到新的特征空间,内积就变成 ;只要能直接计算这个内积,就不必显式构造 。这样的函数 称为核函数,用它替换内积的做法称为核技巧(kernel trick):
这一思想最早可以追溯到 Aizerman 等人的势函数方法 [29],Freund 与 Schapire 后来对核感知器做了系统分析 [31]。图 14 给出了它的几何直觉。
常用的核函数有:
- 多项式核:,其中 为阶数(代码参数
degree), 为常数项(代码参数coef0)。它对应于包含不超过 次的特征乘积项的特征空间,例如 时包含 这样的交叉项(附录 A.2)。 - 高斯径向基核(RBF 核):,其中 控制核的宽度(代码参数
gamma;这里改用 ,以免与 1.3.5 节的间隔 混淆)。它对应的特征空间是无穷维的。 - Tanimoto 核:对二值分子指纹 ,记 、 分别为两个指纹中取值为 1 的位数, 为两者共同为 1 的位数,则 ,即化学信息学中常用的 Tanimoto 相似度(也称 Jaccard 相似度)。可以证明它在二值向量上是合法的核函数,因此能直接用于核感知器做分子分类。
并不是任何“相似度”都能当作核函数使用。核函数必须保证对任意一组样本,由 组成的矩阵(Gram 矩阵)都是半正定的(附录 A.2)。例如,由两个构象之间的 RMSD 构造的相似度一般不满足这一条件,直接使用前需要检验或修正。
训练时,每当样本 被分错,就执行 (以及 )。训练结束后, 的样本就是至少触发过一次更新的样本,模型只依赖这些样本。它们在作用上类似支持向量机中的“支持向量”,但并不相同:支持向量机的支持向量恰好位于间隔边界上,而核感知器中 的样本只是训练过程中被分错过的样本,与样本顺序有关。
1.3.9 多分类扩展
感知器本身只做二分类。面对 个类别(例如把材料分成窄带隙、中等带隙和宽带隙三类),常用以下三种扩展方式(图 15):
一对多(One-vs-Rest, OvR):训练 个二分类器,第 个负责区分“类别 ”与“其余类别”。预测时比较各分类器的判别得分,取最大者:
如果只看每个分类器输出的正负号,可能出现几个分类器同时判为“是”或全部判为“否”的样本,它们无法归类;按式 (29) 取得分最大者,则每个样本都有确定的预测。但要注意, 个分类器是分别训练的,各自权重的尺度并不统一,它们的得分不一定可以直接比较(1.4.7 节)。
一对一(One-vs-One, OvO):每两个类别之间训练一个二分类器,共 个,预测时投票,得票最多的类别胜出。票数相同时需要额外规定如何取舍。
多类感知器:为每个类别维护一个权重向量 ,所有类别联合训练。预测时取 ;若预测类别 不等于真实类别 ,就执行 、,即提高正确类别的得分、降低错误类别的得分。如果把这里的 换成 softmax 概率并用交叉熵训练,就得到多项逻辑回归,也就是现代神经网络多分类输出层的标准做法。
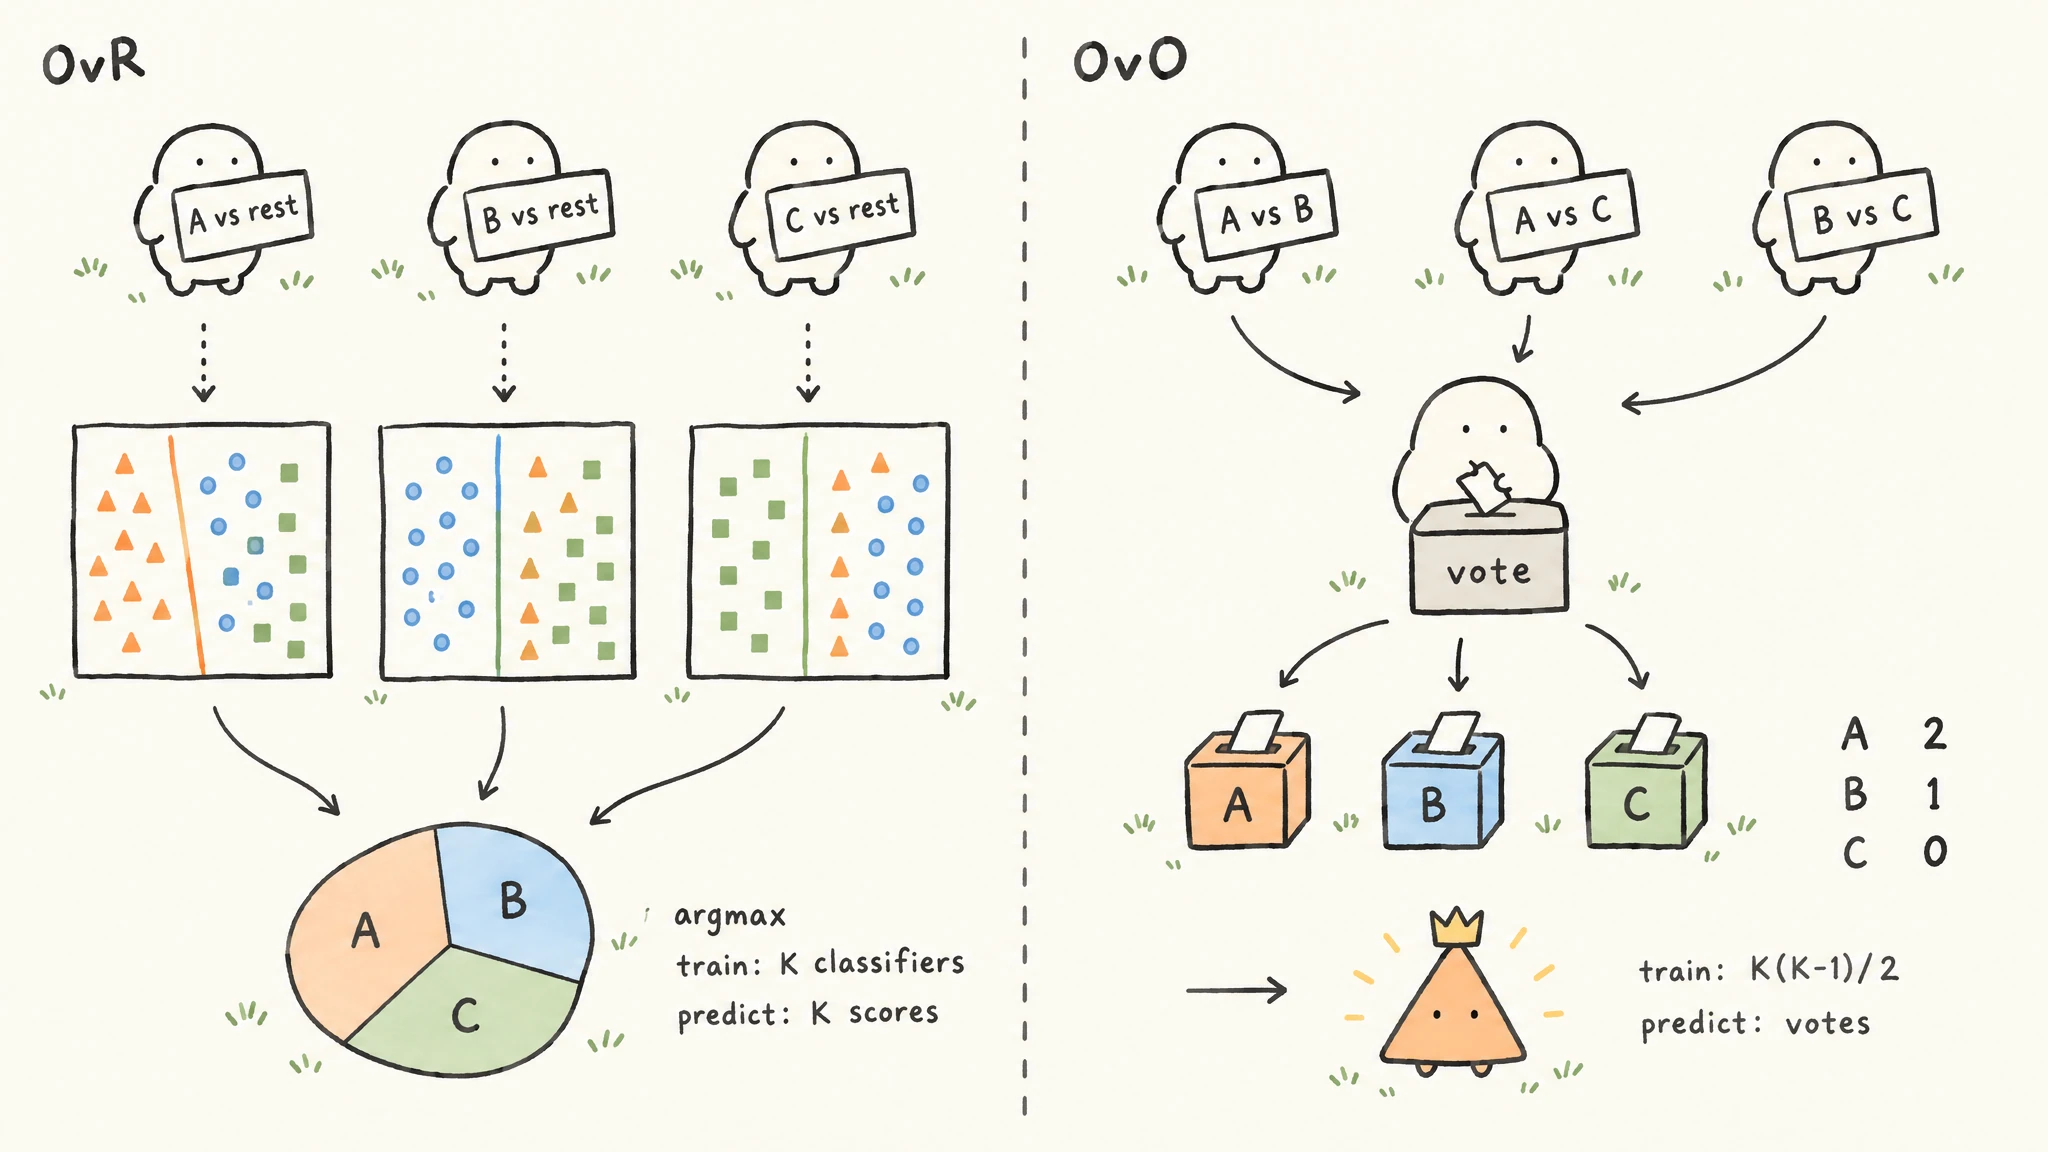
本章 1.4.7 节实现了一对多包装器,1.5.4 节在带隙三分类案例中比较了一对多与一对一两种做法。
1.3.10 XOR 问题与多层感知器
交互图表 XOR 线性不可分与隐层空间折叠。 点击节点锁定关键算子,拖动参数滑块检验公式中的定量权衡。
隐层激活 φ
网络 2–2–1
全批量梯度下降 · 交叉熵
0 / 4000 epoch
损失0.840
准确率48%
隐层空间是否线性可分否
输出权重 v(-1.76, 0.82)
输入空间 → 隐层空间虚线为两个隐单元的零点线
y=1 y=0 输出分界
回顾一下:口袋算法让我们扛住了噪声,核方法让我们换个相似度绕开非线性,多分类包装器让我们处理多个类别。但这些扩展都没有改变一个事实:单层感知器的决策边界是一个超平面。能不能让模型自己学会把空间“拧直”?这就引出了多层网络。最简单的反例是**异或(XOR)**问题。在二维平面上取四个点: 与 属于类别 0, 与 属于类别 1。同类的两个点位于正方形的对角,任何一条直线都无法把两条对角线分到两侧(图 16 左)。
可以用反证法验证。设存在 把类别 1 判为正、类别 0 判为负,则 、、、。后两式相加得 ,而前两式相加得 ,矛盾。
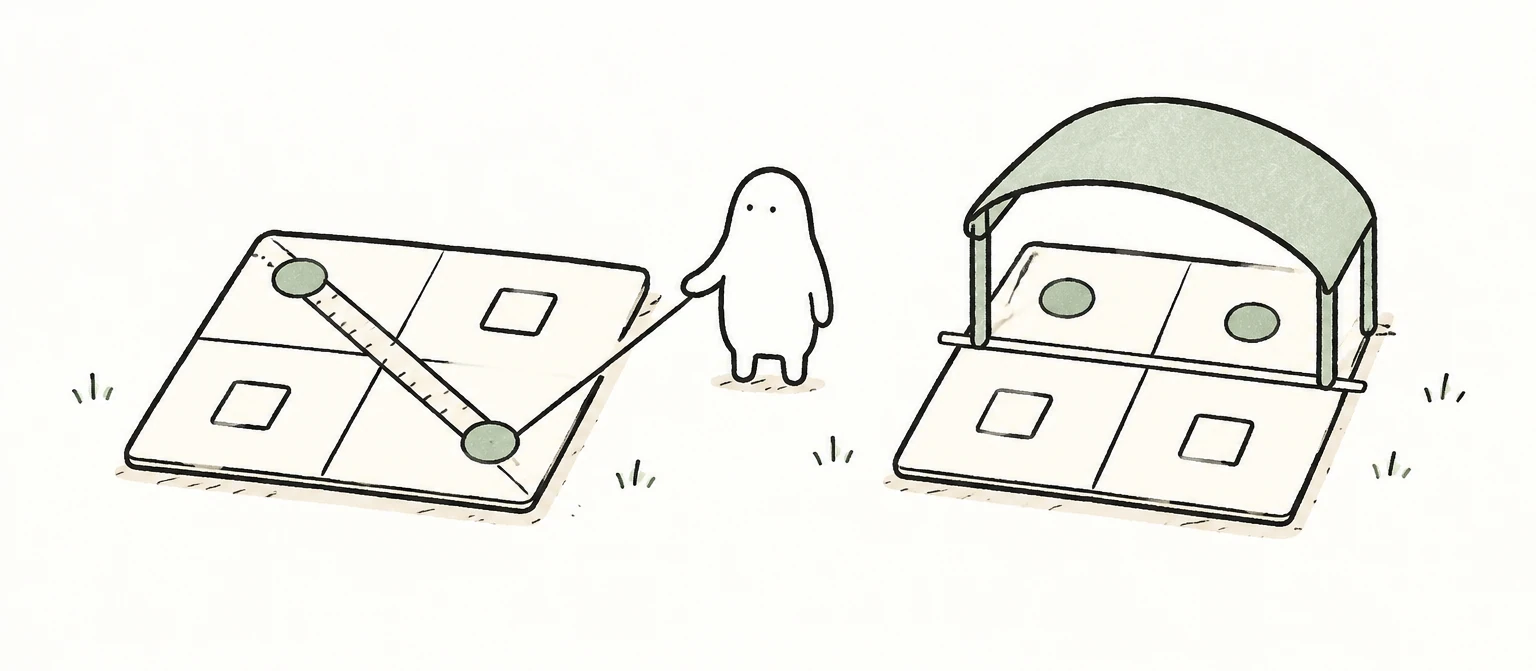
图 16 提示了解决办法:在输入和输出之间加入隐藏层(hidden layer),先把原始特征变换到新的空间,再在新空间中做线性划分。以两个隐藏单元为例:
这里的激活函数必须是非线性的:如果隐藏层也是线性的,多层线性变换的复合仍然是线性变换,决策边界仍然是一个超平面。这种网络称为多层感知器(multilayer perceptron, MLP)。注意它的隐藏单元使用 tanh 等光滑函数,而不是感知器的阶跃函数,这样才能用梯度下降训练(图 5)。
关于多层网络的表示能力,Cybenko(1989)[4] 与 Hornik(1991)[7] 证明了通用逼近定理(universal approximation theorem):只要隐藏单元足够多,单隐层前馈网络可以在紧集上以任意精度逼近任意连续函数。这个定理只说明“存在”这样一组参数,并没有告诉我们需要多少隐藏单元,也不保证梯度下降一定能找到这组参数,更不保证在新样本上表现良好。
训练多层网络需要计算损失对每一层参数的导数,这依靠多元函数的链式法则,即反向传播算法(backpropagation)[30]:
1.4.8 节会手写一个单隐层 MLP 及其反向传播,1.4.9 节在带噪声的 XOR 数据上比较原始感知器、手工特征、核感知器和 MLP 四种做法;多层网络的系统讲解留到第 3 章。
1.4 Python 实现
1.4.1 代码组织与设计原则
本节把第 1.3 节的算法逐一写成代码。为了让代码与公式一一对应,实现遵循三条原则:
- 只用标准库。 核心代码只依赖 Python 3 自带的
math和random,用显式循环写出点积、误差判断和参数更新,不调用NumPy、scikit-learn或PyTorch。本章的模型和数据都很小,纯 Python 足够快。 - 结果可复现。 所有涉及随机打乱或随机初始化的地方都可以用参数
random_state固定随机种子,同一种子在不同机器上给出相同的结果。 - 接口与 scikit-learn 一致。 各个类都提供
fit、predict、score方法,参数名也尽量与scikit-learn相同,以后换用scikit-learn时可以直接迁移。
1.4.2 节先给出一个约 30 行的最小实现,帮助理解算法本身;1.4.3–1.4.8 节给出完整的类,它们共同组成后面所有实验使用的模块。使用方法:新建一个名为 perceptron.py 的文件,在文件开头写一行 import math, random,然后把 1.4.3–1.4.8 节的代码块按顺序复制进去。1.4.9 节和第 1.5 节的实验脚本放在与它相同的文件夹中运行,用 from perceptron import ... 导入需要的类和函数。第 1.5 节各案例的代码块需要在同一个 Python 会话中按顺序运行(例如依次粘贴到同一个 Jupyter Notebook 中),后面的代码块会用到前面定义的变量。
表 2 汇总了这个模块中的主要类和函数,可以在阅读后续各小节时随时对照。
表 2 perceptron 模块中的主要类与函数。“输入”一列中的 为样本数、 为特征数;二分类模型接受任意两种标签(如 0/1 或 −1/+1),内部统一映射为 。
| 所在小节 | 类 / 函数 | 输入 | 核心计算 | 调用示例 |
|---|---|---|---|---|
| 4.3 | Perceptron | :;:两类标签 | 判别 ;分错时 | Perceptron().fit(X, y) |
| 4.4 | StandardScaler | : | , 只用训练集计算 | StandardScaler().fit(X_train) |
| 4.4 | train_test_split 等 | 、 | 分层随机划分;准确率、混淆矩阵、精确率、召回率、F1 | train_test_split(X, y, test_size=0.3) |
| 4.5 | PocketPerceptron | 同 Perceptron | 每次更新后在全训练集上计数误分类,保留误分类最少的权重 | PocketPerceptron(n_epochs=200).fit(X, y) |
| 4.6 | KernelPerceptron | 同 Perceptron | 对偶形式 ;核函数可选 linear、poly、rbf | KernelPerceptron(kernel="rbf", gamma=0.5).fit(X, y) |
| 4.7 | OneVsRestClassifier | ;: 类标签 | 每类训练一个二分类器,预测取 | OneVsRestClassifier().fit(X, y) |
| 4.8 | MLPClassifier | 同 Perceptron | ,反向传播 + 小批量梯度下降 | MLPClassifier(hidden_size=8).fit(X, y) |
| 4.9 | 测试脚本 | — | 20 项单元测试,包括有限差分梯度校验(相对误差 ) | 与 perceptron.py 放在同一文件夹后运行 |
1.4.2 最小实现
在写完整的类之前,先用约 30 行代码实现感知器的核心逻辑。这段代码不依赖本章的模块,可以单独运行:
python
import random

def dot(a, b):
    """向量点积:对应数学上的 w·x = sum_i w_i x_i"""
    return sum(ai * bi for ai, bi in zip(a, b))

def fit_perceptron(X, y, eta=1.0, epochs=50, seed=0):
    """X: 特征列表 [[x1, x2, ...], ...];y: 标签列表,取值 +1 / -1"""
    rng = random.Random(seed)
    n_samples, n_features = len(X), len(X[0])
    w = [0.0] * n_features      # 权重向量,初始化为全 0
    b = 0.0                     # 偏置标量

    for _ in range(epochs):
        order = list(range(n_samples))
        rng.shuffle(order)                      # 每一轮充分打乱样本喂入次序
        n_errors = 0
        for i in order:
            # 核心判定条件:y_i * (w·x_i + b) <= 0
            if y[i] * (dot(w, X[i]) + b) <= 0.0:
                # 纠偏更新:w <- w + eta * y_i * x_i ;b <- b + eta * y_i
                w = [wj + eta * y[i] * xij for wj, xij in zip(w, X[i])]
                b += eta * y[i]
                n_errors += 1
        if n_errors == 0:                       # 这一轮没有分错的样本:训练集已全部分对,提前停止
            break
    return w, b

def predict(X, w, b):
    """符号判决:sign(w·x + b),+1 为正类,-1 为负类"""
return [1 if dot(w, x) + b > 0 else -1 for x in X]注意判断条件 if y[i] * (dot(w, X[i]) + b) <= 0.0 用的是 <= 而不是 <。样本恰好落在超平面上()时,它既没有被分到正类一侧,也没有被分到负类一侧,应当算作分错并触发更新。如果写成 <,初始参数全为零时每个样本的函数间隔都是 0,没有任何样本会触发更新,算法会停在 、 这个平凡解上(1.3.1 节)。
1.4.3 完整实现
1.4.2 节的函数只能训练和预测。实际做实验时,我们还需要记录训练过程、比较不同模型、在新数据上评估,所以下面把它改写成遵循 scikit-learn 接口(fit / predict / score)的 Perceptron 类。核心的训练循环与 1.4.2 节完全一致,新增的只是接口、训练记录和 margin 等分析方法,阅读时重点看这几处即可。
首先是几个基础的向量运算与统计函数(perceptron.py 的开头需要有 import math, random,见 1.4.1 节):
python
# ---------------------------------------------------------------------------
# 0. 基础工具函数
# ---------------------------------------------------------------------------

def dot(a, b):
    """向量点积 w·x,对应数学式 sum_i w_i x_i。"""
    return sum(wi * xi for wi, xi in zip(a, b))


def axpy(alpha, x, y):
    """返回 alpha*x + y,即 "a times x plus y",BLAS 的一级操作。"""
    return [alpha * xi + yi for xi, yi in zip(x, y)]


def zeros(n):
    """长度为 n 的全零向量。"""
    return [0.0] * n


def mean(values):
    values = list(values)
    return sum(values) / len(values)


def stdev(values):
    """总体标准差(分母为 n)。"""
    values = list(values)
    m = mean(values)
return math.sqrt(sum((v - m) ** 2 for v in values) / len(values))Perceptron 类可以设置学习率、最大轮数、是否打乱样本以及随机种子。训练完成后,权重向量 保存在 coef_ 中,偏置 保存在 intercept_ 中,history_ 记录每一轮中触发更新(即被分错)的样本数,n_iter_ 是实际运行的轮数:

python
# ---------------------------------------------------------------------------
# 1. Rosenblatt 感知器核心类
# ---------------------------------------------------------------------------

class Perceptron:
    """
    经典感知器(Rosenblatt, 1958)。

    模型:      y_hat = sign(w·x + b)
    损失:      L(w) = max(0, -y_i (w·x_i + b))    对误分类点求和
    更新:      w <- w + eta * y_i * x_i ,  b <- b + eta * y_i

    参数
    ----
    learning_rate : float  学习率 eta,默认 1.0(感知器对 eta 不敏感,只影响步长尺度)
    n_epochs      : int    最大遍历次数
    shuffle       : bool   每个 epoch 前是否打乱样本顺序
    random_state  : int    随机种子,保证结果可复现
    verbose       : bool   打印每个 epoch 的误分类数
    """

    def __init__(self, learning_rate=1.0, n_epochs=50, shuffle=True,
                 random_state=0, verbose=False, track_updates=False):
        self.learning_rate = learning_rate
        self.n_epochs = n_epochs
        self.shuffle = shuffle
        self.random_state = random_state
        self.verbose = verbose
        self.track_updates = track_updates      # 记录每次更新后的 (w, b),用于画图

    # -- 内部:把标签映射为 +1 / -1 -------------------------------------
    def _encode(self, y):
        self.classes_ = sorted(set(y))
        if len(self.classes_) != 2:
            raise ValueError("Perceptron 只处理二分类,多分类请用 OneVsRestClassifier")
        return [1.0 if label == self.classes_[1] else -1.0 for label in y]

    # -- 前向计算 --------------------------------------------------------
    def decision_function(self, X):
        """返回 w·x + b,即样本到超平面的"带符号距离乘以 ||w||"。"""
        return [dot(self.coef_, x) + self.intercept_ for x in X]

    def predict(self, X):
        return [self.classes_[1] if s > 0 else self.classes_[0]
                for s in self.decision_function(X)]

    def score(self, X, y):
        return accuracy_score(y, self.predict(X))

    # -- 训练 ------------------------------------------------------------
    def fit(self, X, y):
        y_signed = self._encode(y)
        n_samples, n_features = len(X), len(X[0])
        rng = random.Random(self.random_state)

        self.coef_ = zeros(n_features)     # 权重向量 w
        self.intercept_ = 0.0              # 偏置 b
        self.history_ = []                 # 每个 epoch 结束时的误分类数
        self.updates_ = []                 # 每次更新后的 (w, b)

        for epoch in range(self.n_epochs):
            order = list(range(n_samples))
            if self.shuffle:
                rng.shuffle(order)

            n_errors = 0
            for i in order:
                # 判定条件:y_i (w·x_i + b) <= 0 说明被误分类或被判在边界上
                if y_signed[i] * (dot(self.coef_, X[i]) + self.intercept_) <= 0.0:
                    # 用最朴素的循环写更新,方便与公式逐一对照
                    for j in range(n_features):
                        self.coef_[j] += self.learning_rate * y_signed[i] * X[i][j]
                    self.intercept_ += self.learning_rate * y_signed[i]
                    n_errors += 1
                    if self.track_updates:
                        self.updates_.append((list(self.coef_), self.intercept_))

            self.history_.append(n_errors)
            if self.verbose:
                print(f"  epoch {epoch + 1:3d}  误分类数 = {n_errors}")
            if n_errors == 0:              # 训练集已完全正确分类 -> 提前停止
                break

        self.n_iter_ = len(self.history_)
        return self

    def margin(self, X, y):
        """返回每个样本的几何间隔(带符号距离):y_i (w·x_i + b) / ||w||。"""
        norm = math.sqrt(dot(self.coef_, self.coef_)) or 1.0
        y_signed = [1.0 if label == self.classes_[1] else -1.0 for label in y]
        return [(y_signed[i] * (dot(self.coef_, X[i]) + self.intercept_)) / norm
for i in range(len(X))]fit 方法中的更新与式 (13)、(14) 逐项对应;某一轮没有任何样本触发更新(n_errors == 0)时,说明训练集已全部分对,提前停止。
除 predict 外,类中还有两个便于分析的方法:decision_function 返回取符号之前的判别得分 ;margin 返回每个样本的带符号距离 ,其最小值就是式 (9) 的几何间隔。某个样本的这个值越小(或为负),说明它离分界面越近(或被分错)。
1.4.4 标准化、数据划分与评估指标
1.3.7 节说明了为什么要标准化,StandardScaler 类实现了这一步:
python
# ---------------------------------------------------------------------------
# 特征标准化
# ---------------------------------------------------------------------------

class StandardScaler:
    """
    z-score 标准化:x' = (x - mu) / sigma

    为什么感知器需要它?
    感知器的更新量是 Delta_w = eta * y * x,其大小正比于 ||x||。
    若某一列特征的数值在 10^2~10^3 量级(例如相对分子质量),另一列只有 0.1 量级(例如电负性差),
    则权重更新会被大量纲特征主导,学习过程像是在"只训练一个特征"。
    """

    def fit(self, X):
        n_features = len(X[0])
        self.mean_ = [mean(row[j] for row in X) for j in range(n_features)]
        self.std_ = [stdev([row[j] for row in X]) or 1.0 for j in range(n_features)]
        return self

    def transform(self, X):
        return [[(row[j] - self.mean_[j]) / self.std_[j] for j in range(len(row))]
                for row in X]

    def fit_transform(self, X):
        return self.fit(X).transform(X)

    def inverse_transform(self, X):
        return [[row[j] * self.std_[j] + self.mean_[j] for j in range(len(row))]
for row in X]使用标准化时必须防范数据泄漏(data leakage):StandardScaler 的均值与方差计算(fit)只能在训练集上独立完成;测试集及未来的预测样本只能使用训练集拟合出的 mean_ 与 std_ 进行线性变换(transform)。若在划分数据之前就用全部样本计算均值和标准差,测试集的信息就会通过这两个统计量混入训练过程,使测试结果偏乐观(第 00 章;系统讨论见文献 [27])。
与此配套,数据集划分函数 train_test_split 默认开启分层抽样(Stratified Sampling),确保训练集与测试集中的各类别比例与总体一致。在化学与材料的小样本任务中,这可以避免某个稀有类别在随机划分时全部落入训练集或全部落入测试集。下面的代码还包括准确率、混淆矩阵以及精确率、召回率、F1 等评估指标:
python
# ---------------------------------------------------------------------------
# 数据集划分与评价指标
# ---------------------------------------------------------------------------

def train_test_split(X, y, test_size=0.3, random_state=None, stratify=True):
    """
    按比例划分训练集/测试集。
    stratify=True 时保持各类别比例一致(小样本化学数据集非常重要,
    否则某个类别可能一个样本都没进训练集)。
    """
    rng = random.Random(random_state)
    n = len(X)
    if stratify:
        buckets = {}
        for i, label in enumerate(y):
            buckets.setdefault(label, []).append(i)
        test_idx, train_idx = [], []
        for label, idx_list in buckets.items():
            rng.shuffle(idx_list)
            n_test = max(1, int(round(len(idx_list) * test_size)))
            test_idx.extend(idx_list[:n_test])
            train_idx.extend(idx_list[n_test:])
    else:
        idx = list(range(n))
        rng.shuffle(idx)
        n_test = max(1, int(round(n * test_size)))
        test_idx, train_idx = idx[:n_test], idx[n_test:]
    rng.shuffle(train_idx)
    rng.shuffle(test_idx)
    return ([X[i] for i in train_idx], [X[i] for i in test_idx],
            [y[i] for i in train_idx], [y[i] for i in test_idx])


def accuracy_score(y_true, y_pred):
    correct = sum(1 for a, b in zip(y_true, y_pred) if a == b)
    return correct / len(y_true)


def confusion_matrix(y_true, y_pred, positive=None):
    """
    返回 (TN, FP, FN, TP)。positive 指定"正类"标签,默认取 y_true 中较大的标签。
    """
    if positive is None:
        positive = max(set(y_true) | set(y_pred))
    TP = FP = FN = TN = 0
    for t, p in zip(y_true, y_pred):
        if t == positive and p == positive:
            TP += 1
        elif t != positive and p == positive:
            FP += 1
        elif t == positive and p != positive:
            FN += 1
        else:
            TN += 1
    return TN, FP, FN, TP


def classification_report(y_true, y_pred, positive=None):
    """输出准确率、精确率、召回率、F1(正类)。"""
    TN, FP, FN, TP = confusion_matrix(y_true, y_pred, positive)
    precision = TP / (TP + FP) if TP + FP else 0.0
    recall = TP / (TP + FN) if TP + FN else 0.0
    f1 = 2 * precision * recall / (precision + recall) if precision + recall else 0.0
    return {
        "accuracy": accuracy_score(y_true, y_pred),
        "precision": precision,
        "recall": recall,
        "f1": f1,
        "confusion": (TN, FP, FN, TP),
}1.4.5 口袋算法
按照 1.3.6 节的思路,下面继承 Perceptron 实现 PocketPerceptron:每次更新后都在整个训练集上数一遍误分类样本,如果比口袋里记录的更少,就把当前权重复制一份放进口袋。训练结束时返回口袋中的权重。
python
# ---------------------------------------------------------------------------
# 口袋算法(Pocket Algorithm)
# ---------------------------------------------------------------------------

class PocketPerceptron(Perceptron):
    """
    口袋算法:在含噪声(线性不可分)数据上,感知器会一直振荡,
    因此在每次更新后评估整个训练集准确率,把"目前最好"的权重存进口袋。
    这是对感知器最实用的工程修补之一。
    """

    def fit(self, X, y):
        y_signed = self._encode(y)
        n_samples, n_features = len(X), len(X[0])
        rng = random.Random(self.random_state)

        self.coef_ = zeros(n_features)
        self.intercept_ = 0.0
        self.history_ = []
        best_w, best_b = list(self.coef_), self.intercept_
        best_errors = n_samples

        for epoch in range(self.n_epochs):
            order = list(range(n_samples))
            if self.shuffle:
                rng.shuffle(order)
            n_errors = 0
            for i in order:
                if y_signed[i] * (dot(self.coef_, X[i]) + self.intercept_) <= 0.0:
                    for j in range(n_features):
                        self.coef_[j] += self.learning_rate * y_signed[i] * X[i][j]
                    self.intercept_ += self.learning_rate * y_signed[i]
                    n_errors += 1
                    # 更新后立刻在全集上打分,若更好就"放进(复制到)口袋"
                    current_errors = sum(
                        1 for k in range(n_samples)
                        if y_signed[k] * (dot(self.coef_, X[k]) + self.intercept_) <= 0.0)
                    if current_errors < best_errors:
                        best_errors = current_errors
                        best_w, best_b = list(self.coef_), self.intercept_
            self.history_.append(best_errors)
            if self.verbose:
                print(f"  epoch {epoch + 1:3d}  口袋内最优误分类数 = {best_errors}")
            if best_errors == 0:
                break

        self.coef_, self.intercept_ = best_w, best_b
        self.n_iter_ = len(self.history_)
return self关于这段代码,有三点需要注意:
- 必须复制权重。 保存最优权重时写的是
list(self.coef_),即新建一个列表。如果写成best_w = self.coef_,两个变量指向同一个列表,之后对self.coef_的原地修改会同时改变“口袋”里的内容,口袋就失去了作用。这里的列表元素都是浮点数,list()这样的浅复制已经足够,不需要copy.deepcopy。 history_的含义不同。 在Perceptron中,history_记录的是每一轮触发更新的样本数;在PocketPerceptron中,它记录的是每一轮结束时口袋中权重的误分类数,所以只会减少或不变。比较两者的曲线时要注意这一区别。- 计算开销更大。 每次更新后都要遍历整个训练集,单次评估的代价是 ;一轮中最多有 次更新,所以每轮的代价最多为 ,而原始感知器每轮只需 。对本章几十个样本的数据,这不成问题;数据量大时,可以改为每轮结束时评估一次。
1.4.6 核感知器
下面按 1.3.8 节的对偶形式实现核感知器。先定义线性核、多项式核与 RBF 核三个核函数,再实现 KernelPerceptron 类。代码中多项式核的参数 degree、coef0 对应 1.3.8 节的 、,RBF 核的参数 gamma 对应 。训练时预先计算所有样本两两之间的核函数值,存成 Gram 矩阵 K_:
python
# ---------------------------------------------------------------------------
# 核感知器(对偶形式与核技巧)
# ---------------------------------------------------------------------------

def linear_kernel(a, b):
    return dot(a, b)


def polynomial_kernel(a, b, degree=2, coef0=0.0):
    return (dot(a, b) + coef0) ** degree


def rbf_kernel(a, b, gamma=1.0):
    return math.exp(-gamma * sum((ai - bi) ** 2 for ai, bi in zip(a, b)))


class KernelPerceptron:
    """
    对偶形式的感知器:权重可以写成训练样本的线性组合 w = sum_i alpha_i y_i x_i,
    于是预测只需核函数 K(x_i, x_j) = phi(x_i)·phi(x_j):

        f(x) = sum_i alpha_i y_i K(x_i, x) + b

    误分类时只更新一个系数:alpha_i <- alpha_i + eta。
    这使感知器可以在不显式构造高维特征的前提下处理非线性问题
    (对化学而言尤其重要:分子指纹之间的 Tanimoto 相似度可以直接当"核"用)。
    """

    def __init__(self, kernel="rbf", gamma=1.0, degree=2, coef0=0.0,
                 learning_rate=1.0, n_epochs=50, random_state=0):
        self.kernel = kernel
        self.gamma = gamma
        self.degree = degree
        self.coef0 = coef0
        self.learning_rate = learning_rate
        self.n_epochs = n_epochs
        self.random_state = random_state

    def _K(self, a, b):
        if self.kernel == "linear":
            return linear_kernel(a, b)
        if self.kernel == "poly":
            return polynomial_kernel(a, b, self.degree, self.coef0)
        if self.kernel == "rbf":
            return rbf_kernel(a, b, self.gamma)
        raise ValueError(f"未知核函数:{self.kernel}")

    def fit(self, X, y):
        self.classes_ = sorted(set(y))
        y_signed = [1.0 if label == self.classes_[1] else -1.0 for label in y]
        n = len(X)
        rng = random.Random(self.random_state)
        self.alpha_ = zeros(n)
        self.intercept_ = 0.0
        self.X_ = X
        self.y_signed_ = y_signed
        self.history_ = []

        # 预先算好 Gram 矩阵,避免重复计算(这是核方法的常规做法)
        self.K_ = [[self._K(X[i], X[j]) for j in range(n)] for i in range(n)]

        for epoch in range(self.n_epochs):
            order = list(range(n))
            rng.shuffle(order)
            errors = 0
            for i in order:
                s = sum(self.alpha_[j] * self.y_signed_[j] * self.K_[j][i]
                        for j in range(n)) + self.intercept_
                if y_signed[i] * s <= 0.0:
                    self.alpha_[i] += self.learning_rate
                    self.intercept_ += self.learning_rate * y_signed[i]
                    errors += 1
            self.history_.append(errors)
            if errors == 0:
                break
        self.n_iter_ = len(self.history_)
        return self

    def decision_function(self, X):
        out = []
        for x in X:
            s = sum(self.alpha_[j] * self.y_signed_[j] * self._K(self.X_[j], x)
                    for j in range(len(self.X_))) + self.intercept_
            out.append(s)
        return out

    def predict(self, X):
        return [self.classes_[1] if s > 0 else self.classes_[0]
                for s in self.decision_function(X)]

    def score(self, X, y):
return accuracy_score(y, self.predict(X))对偶形式的计算量主要取决于样本数而不是特征维数:Gram 矩阵有 个元素,计算和存储它都需要 量级的开销;预测一个新样本时,还要与所有 的训练样本各算一次核函数。对几百到几千个分子的数据集,这完全可行;样本数达到数万以上时,通常需要 Nyström 方法或随机傅里叶特征等近似方案。
1.4.7 多分类包装器
下面实现 1.3.9 节介绍的一对多(OvR)策略:把 分类问题拆成 个“属于类别 / 不属于类别 ”的二分类问题,每个问题训练一个二分类器(默认是感知器,也可以通过 base_estimator_factory 换成其他模型):
python
# ---------------------------------------------------------------------------
# 一对多多分类包装器
# ---------------------------------------------------------------------------

class OneVsRestClassifier:
    """
    把二分类感知器扩展为多分类:对每个类别 c 训练一个"是 c / 不是 c"的感知器,
    预测时取 decision_function 最大者(也可以用投票)。
    """

    def __init__(self, base_estimator_factory=None):
        self.base_estimator_factory = base_estimator_factory or \
            (lambda: Perceptron(learning_rate=1.0, n_epochs=100, random_state=0))

    def fit(self, X, y):
        self.classes_ = sorted(set(y))
        self.models_ = {}
        for c in self.classes_:
            y_bin = [1 if label == c else 0 for label in y]
            model = self.base_estimator_factory().fit(X, y_bin)
            self.models_[c] = model
        return self

    def decision_function(self, X):
        # 每个样本返回一组分数,维度 = 类别数
        return [[self.models_[c].decision_function([x])[0] for c in self.classes_]
                for x in X]

    def predict(self, X):
        scores = self.decision_function(X)
        return [self.classes_[max(range(len(self.classes_)), key=lambda k: row[k])]
                for row in scores]

    def score(self, X, y):
return accuracy_score(y, self.predict(X))预测时,代码比较样本在各个二分类器上的判别得分 decision_function,取得分最大的类别。这样每个样本都有确定的预测,不会出现几个分类器同时判“是”或全部判“否”而无法归类的情况。但要注意,这些得分来自分别训练的感知器,各自权重的长度 不同,得分的尺度并不统一;如果某一类与其余类别线性不可分,对应的感知器停在振荡中的某个状态,它的得分就更难与其他分类器比较。所以“取最大得分”只是一个实用的约定,不能把得分当作可比较的置信度。
1.4.8 单隐层多层感知器
1.3.10 节说明了多层感知器(MLP)为什么能表示非线性边界。在本章的案例中,单层感知器作为线性基线,单隐层 MLP 作为非线性的对照模型,用来判断非线性能带来多少收益。下面同样只用标准库实现一个单隐层 MLP。它的数学形式是:
其中 为 logistic sigmoid 函数, 是单个样本的二元交叉熵损失。按链式法则求得的各参数梯度写在下面代码的 _gradients 方法中。训练采用小批量梯度下降,并加了很小的 L2 权重衰减(weight_decay):
python
# ---------------------------------------------------------------------------
# 单隐层多层感知器(手写反向传播与 Xavier 初始化)
# ---------------------------------------------------------------------------

class MLPClassifier:
    """
    一个极简的多层感知器:输入层 -> tanh 隐层 -> 线性输出 -> 交叉熵损失。
    只用 Python 标准库实现反向传播,目的是说明:
        "若干线性单元 + 非线性的可微激活 + 梯度下降 = 能学习非线性边界"。

    数学形式:
        h = tanh(W1 x + b1)                 隐层
        z = W2 h + b2                       输出 logit
        p = sigmoid(z)                      概率
        L = -[y log p + (1-y) log(1-p)]     二元交叉熵
    反向传播(链式法则):
        dL/dz = p - y
        dL/dW2 = (p - y) h^T ,  dL/db2 = p - y
        dL/dh = W2^T (p - y)
        dL/d(W1 x + b1) = dL/dh * (1 - h^2)
    """

    def __init__(self, hidden_size=8, learning_rate=0.05, n_epochs=2000,
                 batch_size=16, random_state=0, weight_decay=1e-4):
        self.hidden_size = hidden_size
        self.learning_rate = learning_rate
        self.n_epochs = n_epochs
        self.batch_size = batch_size
        self.random_state = random_state
        self.weight_decay = weight_decay

    @staticmethod
    def _sigmoid(z):
        if z < -60:
            return 0.0
        if z > 60:
            return 1.0
        return 1.0 / (1.0 + math.exp(-z))

    def fit(self, X, y, verbose_every=None):
        self.classes_ = sorted(set(y))
        y_bin = [1.0 if label == self.classes_[1] else 0.0 for label in y]
        n_samples, n_features = len(X), len(X[0])
        rng = random.Random(self.random_state)

        # Xavier 初始化:标准差 sqrt(2/(fan_in + fan_out)),避免隐层饱和。
        # 为简洁起见,输出层也沿用这一尺度(严格按 Xavier,输出层应使用 hidden_size 与 1 计算)
        scale = math.sqrt(2.0 / (n_features + self.hidden_size))
        self.W1 = [[rng.gauss(0, scale) for _ in range(n_features)]
                   for _ in range(self.hidden_size)]
        self.b1 = zeros(self.hidden_size)
        self.W2 = [rng.gauss(0, scale) for _ in range(self.hidden_size)]
        self.b2 = 0.0
        self.loss_history_ = []

        for epoch in range(self.n_epochs):
            idx = list(range(n_samples))
            rng.shuffle(idx)
            total_loss = 0.0
            for start in range(0, n_samples, self.batch_size):
                batch = idx[start:start + self.batch_size]
                batch_X = [X[i] for i in batch]
                batch_y = [y_bin[i] for i in batch]
                # 每个小批量累积梯度
                gW1, gb1, gW2, gb2, batch_loss = self._gradients(batch_X, batch_y)
                total_loss += batch_loss * len(batch)
                # --- 梯度下降(带 L2 权重衰减) ---
                m = len(batch)
                for k in range(self.hidden_size):
                    self.W2[k] -= self.learning_rate * (gW2[k] / m
                                                        + self.weight_decay * self.W2[k])
                    for j in range(n_features):
                        self.W1[k][j] -= self.learning_rate * (
                            gW1[k][j] / m + self.weight_decay * self.W1[k][j])
                    self.b1[k] -= self.learning_rate * gb1[k] / m
                self.b2 -= self.learning_rate * gb2 / m
            self.loss_history_.append(total_loss / n_samples)
            if verbose_every and (epoch + 1) % verbose_every == 0:
                print(f"  epoch {epoch + 1:5d}  loss = {self.loss_history_[-1]:.4f}")
        return self

    def _forward(self, x):
        """返回 (h, p):隐层激活与输出概率。单独抽出来方便做数值梯度校验。"""
        h = [math.tanh(dot(self.W1[k], x) + self.b1[k])
             for k in range(self.hidden_size)]
        z = dot(self.W2, h) + self.b2
        p = self._sigmoid(z)
        p = min(max(p, 1e-12), 1 - 1e-12)     # 防止 log(0)
        return h, p

    def _loss(self, X, y_bin):
        """平均二元交叉熵(不含 L2 正则项,便于做梯度校验)。"""
        total = 0.0
        for x, yt in zip(X, y_bin):
            _, p = self._forward(x)
            total += -(yt * math.log(p) + (1 - yt) * math.log(1 - p))
        return total / len(X)

    def _gradients(self, X, y_bin):
        """
        反向传播:返回 (gW1, gb1, gW2, gb2, 该批次的平均损失)。

        推导(单样本,记 h 为隐层输出,p 为预测概率):
            dz = p - y                      <- sigmoid + 交叉熵 的经典化简
            dW2[k] = dz * h[k]              d b2 = dz
            dh[k]  = W2[k] * dz
            dpre[k] = dh[k] * (1 - h[k]^2)  <- tanh 的导数
            dW1[k][j] = dpre[k] * x[j]      d b1[k] = dpre[k]
        """
        n_features = len(X[0])
        gW1 = [[0.0] * n_features for _ in range(self.hidden_size)]
        gb1 = zeros(self.hidden_size)
        gW2 = zeros(self.hidden_size)
        gb2 = 0.0
        total_loss = 0.0

        for x, yt in zip(X, y_bin):
            h, p = self._forward(x)
            total_loss += -(yt * math.log(p) + (1 - yt) * math.log(1 - p))
            dz = p - yt
            for k in range(self.hidden_size):
                gW2[k] += dz * h[k]
                dh = self.W2[k] * dz
                dpre = dh * (1 - h[k] ** 2)
                for j in range(n_features):
                    gW1[k][j] += dpre * x[j]
                gb1[k] += dpre
            gb2 += dz
        return gW1, gb1, gW2, gb2, total_loss / len(X)

    def predict_proba(self, X):
        return [self._forward(x)[1] for x in X]

    def decision_function(self, X):
        return [p - 0.5 for p in self.predict_proba(X)]

    def predict(self, X):
        return [self.classes_[1] if p > 0.5 else self.classes_[0]
                for p in self.predict_proba(X)]

    def score(self, X, y):
return accuracy_score(y, self.predict(X))_gradients 方法中的每一行都对应一步链式法则: 是 sigmoid 与交叉熵组合后求导的结果; 把误差传回隐藏层; 用到了 。
1.4.9 第一个实验:XOR 与三条补救路线
有了 1.4.3–1.4.8 节的模块,就可以回到 1.3.10 节提出的问题:单层感知器在 XOR 型数据上会怎样失败,又有哪些办法补救?本实验使用 160 个带噪声的样本,分布在四个象限,两个坐标同号的为正类,异号的为负类。这与 1.3.10 节 0/1 编码的 XOR 只差一个类别名称的对调(严格说是“同或”),两类样本同样位于对角,线性可分性完全相同。
下面的脚本依次尝试四条路线:原始感知器、手工加入交叉项、RBF 核感知器、单隐层 MLP。
python
"""
XOR 实验:感知器最著名的失败案例,以及三条补救路线

XOR(异或)型判据的特点是:单看任何一个输入都无法判断类别,
必须看两个输入的组合。本实验的数据是四团带噪声的点:
第 1、3 象限(两个坐标同号)为正类,第 2、4 象限(异号)为负类。

本脚本对比四条路线:
    0. 原始感知器        -> 失败,准确率约 50%(与随机猜测相当)
    1. 人工特征映射      -> 加入 x1*x2 这一项后,在新空间里线性可分
    2. 核感知器(RBF)   -> 不显式构造特征,直接换相似度度量
    3. 单隐层 MLP        -> 用可导激活 + 反向传播自动学出非线性
"""

# perceptron.py 是按 1.4.1 节的说明,把 1.4.3–1.4.8 节代码保存成的模块
from perceptron import (Perceptron, KernelPerceptron, MLPClassifier,
                        StandardScaler)


def make_xor(n_per_quadrant=40, spread=0.22, seed=0):
    """生成带噪声的四象限 XOR 数据:第 1、3 象限为正类。"""
    import random
    rng = random.Random(seed)
    X, y = [], []
    for cx, cy in [(-1, -1), (-1, 1), (1, -1), (1, 1)]:
        label = 1 if cx * cy > 0 else 0          # 同号 -> 正类,异号 -> 负类
        for _ in range(n_per_quadrant):
            X.append([cx + rng.gauss(0, spread), cy + rng.gauss(0, spread)])
            y.append(label)
    return X, y


def main():
    X, y = make_xor()
    print("=" * 72)
    print(f"XOR 数据集:{len(X)} 个样本,(+,+) 与 (-,-) 为正类,其余为负类")
    print("=" * 72)

    # ---------------- 0. 原始感知器 ----------------
    clf = Perceptron(learning_rate=0.1, n_epochs=200, random_state=0)
    clf.fit(X, y)
    print("\n【路线 0】原始感知器,直接在 (x1, x2) 平面上训练")
    print(f"  训练准确率 : {clf.score(X, y):.3f}   (随机猜也有 0.5)")
    print(f"  迭代轮数   : {clf.n_iter_}")
    print(f"  误分类数   : {clf.history_[:20]} ...")
    print(f"  最终权重   : w = {[round(w, 3) for w in clf.coef_]}, "
          f"b = {clf.intercept_:.3f}")
    print("  >> 误分类数始终降不到 0,权重一直在振荡。原因:两类样本线性不可分,")
    print("     不存在能把它们分开的直线。单层感知器在这里无能为力。")

    # ---------------- 1. 人工特征映射 ----------------
    print("\n【路线 1】手工加一个交叉项:phi(x) = (x1, x2, x1*x2)")
    X_phi = [[x1, x2, x1 * x2] for x1, x2 in X]
    scaler = StandardScaler().fit(X_phi)
    clf_phi = Perceptron(learning_rate=0.1, n_epochs=200, random_state=0)
    clf_phi.fit(scaler.transform(X_phi), y)
    print(f"  训练准确率 : {clf_phi.score(scaler.transform(X_phi), y):.3f}")
    print(f"  迭代轮数   : {clf_phi.n_iter_}   "
          f"误分类数 {clf_phi.history_}")
    print(f"  权重       : {[round(w, 3) for w in clf_phi.coef_]}"
          f"(第三维就是 x1*x2 的权重,符号为正 -> 同号判为正类)")
    print("  >> 感知器本身没变,变的是特征空间。")
    print("     在化学里,这一步相当于构造新的描述符,例如两个描述符的乘积或比值。")

    # ---------------- 2. 核感知器 ----------------
    print("\n【路线 2】核感知器(RBF 核),不显式构造高维特征")
    for gamma in (0.5, 2.0):
        kp = KernelPerceptron(kernel="rbf", gamma=gamma, n_epochs=100,
                              random_state=0).fit(X, y)
        n_sv = sum(1 for a in kp.alpha_ if a > 0)
        print(f"  gamma = {gamma:<4} 训练准确率 {kp.score(X, y):.3f}   "
              f"迭代 {kp.n_iter_} 轮   alpha>0 的样本数 {n_sv}/{len(X)}")
    print("  >> RBF 核相当于隐式地把样本映射到无穷维特征空间。")
    print("     在化学中,二值分子指纹之间的 Tanimoto 相似度也是合法的核函数。")

    # ---------------- 3. 多层感知器 ----------------
    print("\n【路线 3】单隐层 MLP(8 个 tanh 神经元)")
    sc = StandardScaler().fit(X)
    mlp = MLPClassifier(hidden_size=8, learning_rate=0.1, n_epochs=2000,
                        random_state=0).fit(sc.transform(X), y)
    print(f"  训练准确率 : {mlp.score(sc.transform(X), y):.3f}")
    print(f"  首次/末次损失 : {mlp.loss_history_[0]:.4f} -> "
          f"{mlp.loss_history_[-1]:.4f}")
    print("  >> 每个隐层单元计算 tanh(w·x + b),可以看作“软化”的感知器;")
    print("     多个单元组合起来,就能拼出 XOR 需要的非线性边界。")

    print("\n" + "=" * 72)
    print("四句话总结:")
    print("  1) 单层感知器 = 一个超平面,只能解决线性可分问题;")
    print("  2) 让它变强的第一条路是换特征(特征工程,需要领域知识);")
    print("  3) 第二条路是换相似度(核方法);")
    print("  4) 第三条路是叠加层数(深度学习)。")
    print("=" * 72)


if __name__ == "__main__":
main()运行这个脚本,得到下面的输出(随机种子固定,重复运行结果相同):
text
========================================================================
XOR 数据集:160 个样本,(+,+) 与 (-,-) 为正类,其余为负类
========================================================================

【路线 0】原始感知器,直接在 (x1, x2) 平面上训练
  训练准确率 : 0.512   (随机猜也有 0.5)
  迭代轮数   : 200
  误分类数   : [75, 76, 66, 79, 85, 82, 77, 72, 69, 70, 84, 76, 70, 76, 81, 67, 82, 82, 71, 69] ...
  最终权重   : w = [-0.151, -0.007], b = -0.100
  >> 误分类数始终降不到 0,权重一直在振荡。原因:两类样本线性不可分,
     不存在能把它们分开的直线。单层感知器在这里无能为力。

【路线 1】手工加一个交叉项:phi(x) = (x1, x2, x1*x2)
  训练准确率 : 1.000
  迭代轮数   : 2   误分类数 [4, 0]
  权重       : [-0.016, 0.029, 0.386](第三维就是 x1*x2 的权重,符号为正 -> 同号判为正类)
  >> 感知器本身没变,变的是特征空间。
     在化学里,这一步相当于构造新的描述符,例如两个描述符的乘积或比值。

【路线 2】核感知器(RBF 核),不显式构造高维特征
  gamma = 0.5  训练准确率 1.000   迭代 2 轮   alpha>0 的样本数 6/160
  gamma = 2.0  训练准确率 1.000   迭代 2 轮   alpha>0 的样本数 6/160
  >> RBF 核相当于隐式地把样本映射到无穷维特征空间。
     在化学中,二值分子指纹之间的 Tanimoto 相似度也是合法的核函数。

【路线 3】单隐层 MLP(8 个 tanh 神经元)
  训练准确率 : 1.000
  首次/末次损失 : 0.7270 -> 0.0011
  >> 每个隐层单元计算 tanh(w·x + b),可以看作“软化”的感知器;
     多个单元组合起来,就能拼出 XOR 需要的非线性边界。

========================================================================
四句话总结:
  1) 单层感知器 = 一个超平面,只能解决线性可分问题;
  2) 让它变强的第一条路是换特征(特征工程,需要领域知识);
  3) 第二条路是换相似度(核方法);
  4) 第三条路是叠加层数(深度学习)。
========================================================================结果解读:
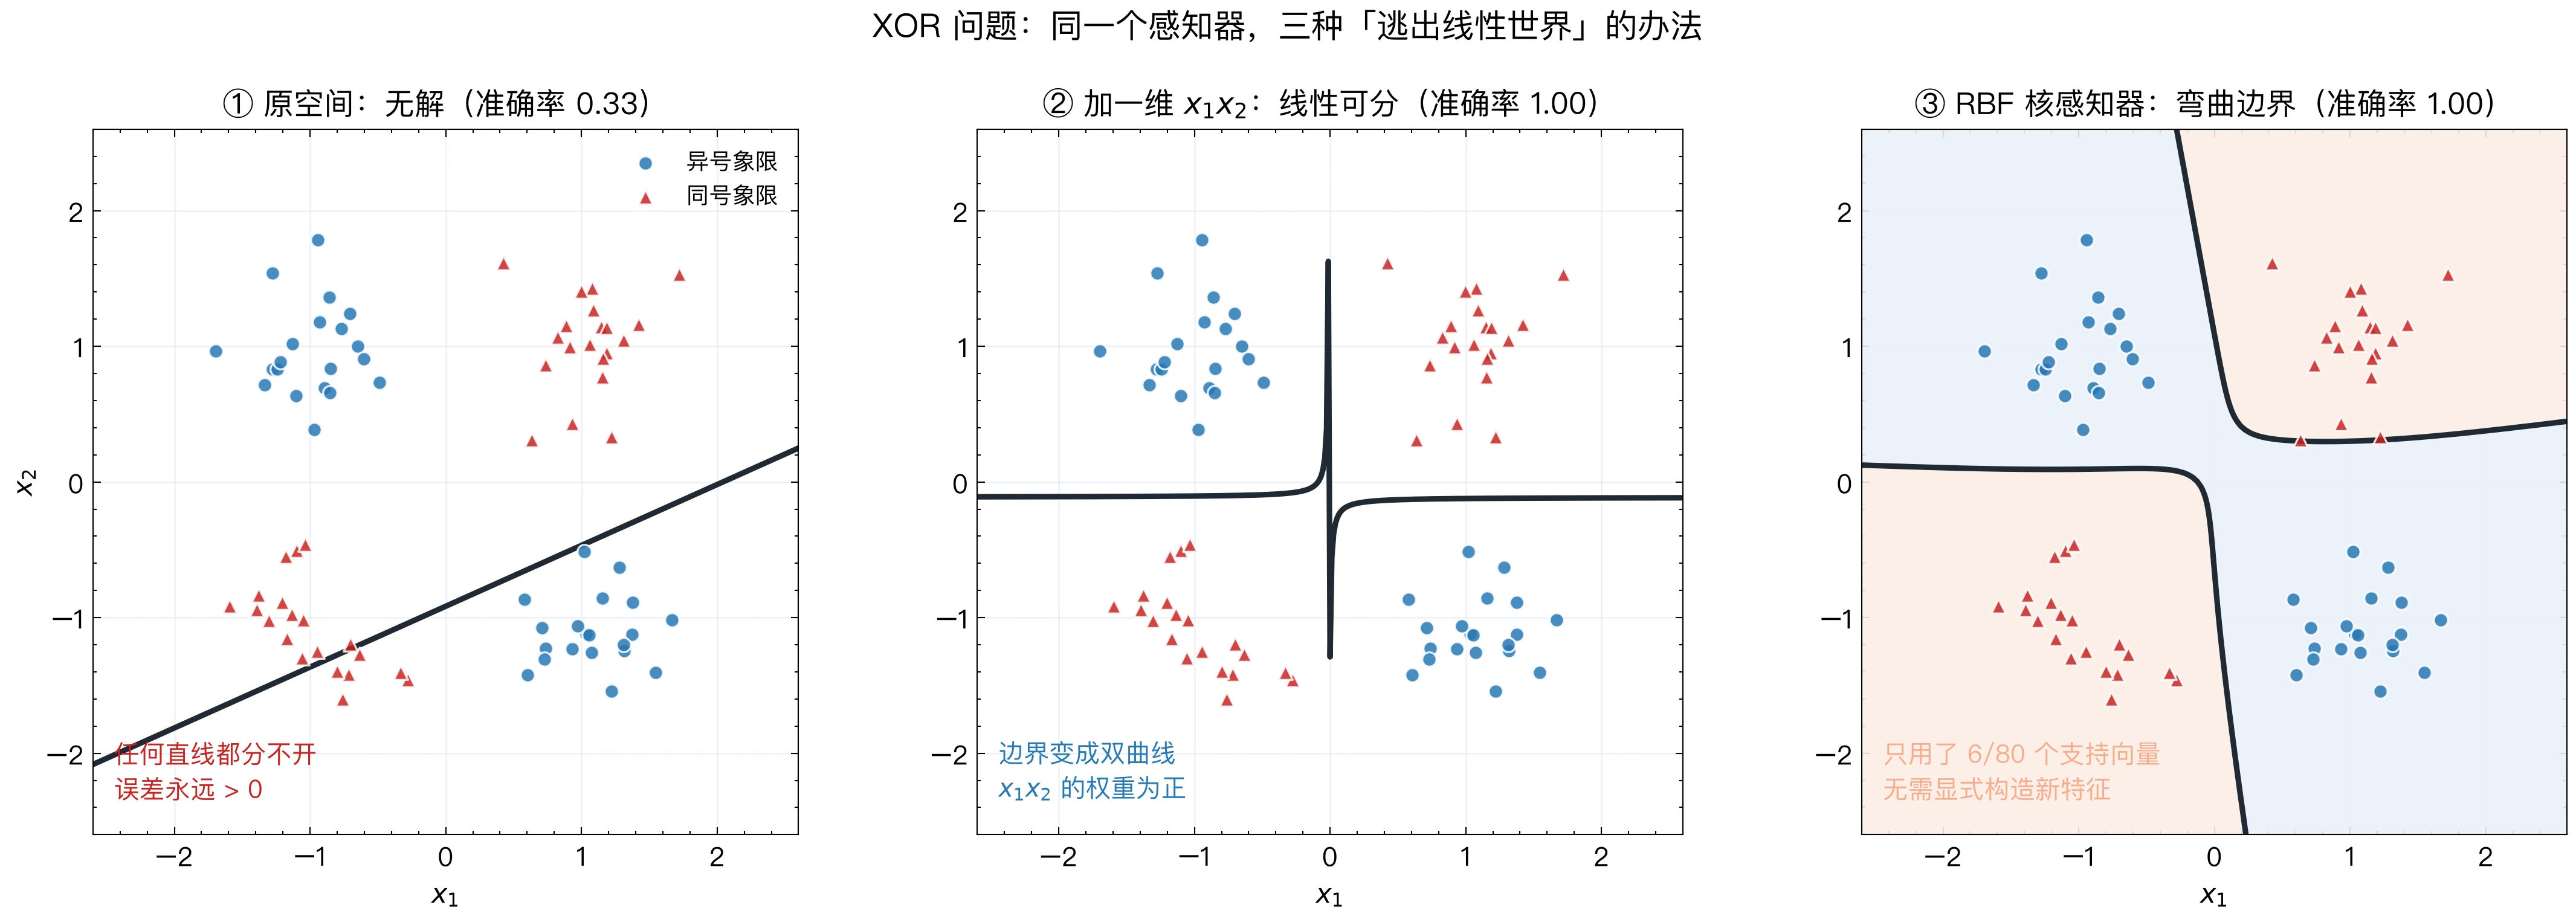
- 路线 0 失败。 训练准确率 0.512,与随机猜测相当;200 轮后每轮误分类数仍在 66~85 之间。这与 1.3.5 节的分析一致:数据线性不可分,感知器不会停下来(图 11 右)。
- 路线 1 成功。 只加入一个交叉项 ,感知器在第 2 轮就把训练集全部分对。第三个权重(0.386)为正,含义是“(同号)倾向于判为正类”,正好是这个问题的规律。算法完全没变,变的只是特征。
- 路线 2 成功。 RBF 核感知器同样在第 2 轮收敛,160 个样本中只有 6 个触发过更新(),模型只依赖这 6 个样本。
- 路线 3 成功。 MLP 的平均交叉熵从 0.7270 降到 0.0011,训练准确率 1.000。
图 17 画出了三条补救路线得到的决策边界。
需要提醒的是,以上四个数字都是训练集准确率。它们说明了模型能否表示 XOR 型边界,并不说明模型在新样本上的表现;评价泛化能力需要独立的测试集(1.5.2 节)。
1.5 化学与材料中的应用
1.5.1 哪些化学任务适合用感知器
第 1.3、1.4 节在人工构造的数据上讨论了感知器能做什么、不能做什么。把它用到化学问题之前,先要判断一个任务是否大致符合线性模型的假设。表 3 按经验列出了一些常见任务;表中的判断只是起点,并非本章的实验结果,只有 1.5.2–1.5.4 节的三个案例有实际运行数据。
表 3 常见化学与材料任务中线性分类模型的适用性(经验判断)。“线性模型的预期表现”一栏是一般规律的概括,具体数据集需要用实验检验。
| 任务 | 典型描述符 | 特征维数 | 线性模型的预期表现 | 建议 |
|---|---|---|---|---|
| 二元化合物带隙分类 | 电负性差、平均主量子数等 | 2–10 | 主族化合物中大致可分;含过渡金属时出现系统性错分(1.5.2 节) | 适合作为基线,重点分析错分的化合物 |
| 类药性初筛 | 分子量、logP、氢键供体/受体数 | 3–8 | “几个阈值同时满足”的规则对应轴对齐的盒状区域,一个超平面只能近似(1.5.3 节) | 可用于快速初筛,但要检查阈值组合附近的样本 |
| 金属/非金属判别 | 电负性、价电子数、共价半径 | 3–10 | 简单体系中往往大致可分,但有例外(如半金属、Mott 绝缘体) | 可作为基线;权重需结合化学知识解读 |
| 晶体结构类型预测 | 组成统计量、局域配位参数 | 10–100 | 多个类别相互交织,线性模型效果通常有限 | 优先考虑树模型、核方法或图神经网络 |
| 电催化活性(火山型关系) | 中间体吸附能、d 带中心 | 1–5 | 活性随吸附能先升后降(Sabatier 原理),一个超平面无法表示 | 加入平方项、分段建模或使用非线性模型 |
| 振动光谱分类 | 各波数处的吸收或散射强度 | 数百–数千 | 维数远大于样本数时训练集往往线性可分,但很容易过拟合 | 先降维(如 PCA)或使用正则化线性模型(如 PLS-DA、线性 SVM) |
| 反应产率预测 | 电子与立体参数、温度、溶剂等 | 5–50 | 产率是连续值,属于回归问题,不适合感知器 | 从线性回归开始,再尝试 MLP、梯度提升树 |
| 生物活性分类(QSAR) | ECFP 等分子指纹(如 2048 位)与理化性质 | 高维、稀疏 | 线性模型常常是有竞争力的基线 | 用线性 SVM、逻辑回归作基线;采用骨架划分评估 |
| 高熵合金固溶相预测 | 混合焓、原子尺寸差、价电子浓度 | 4–10 | 相边界往往较复杂 | 用线性模型检验简单假设,主力模型常用集成树 |
| 强关联体系的基态判断 | 仅有组成统计量 | — | 描述符缺少决定性的物理信息,换用更复杂的模型往往收效有限 | 先补充描述符(如 d 电子数、在位库仑能 的估计值) |
图 18 把这些任务按线性模型的适用程度画成一张示意图。
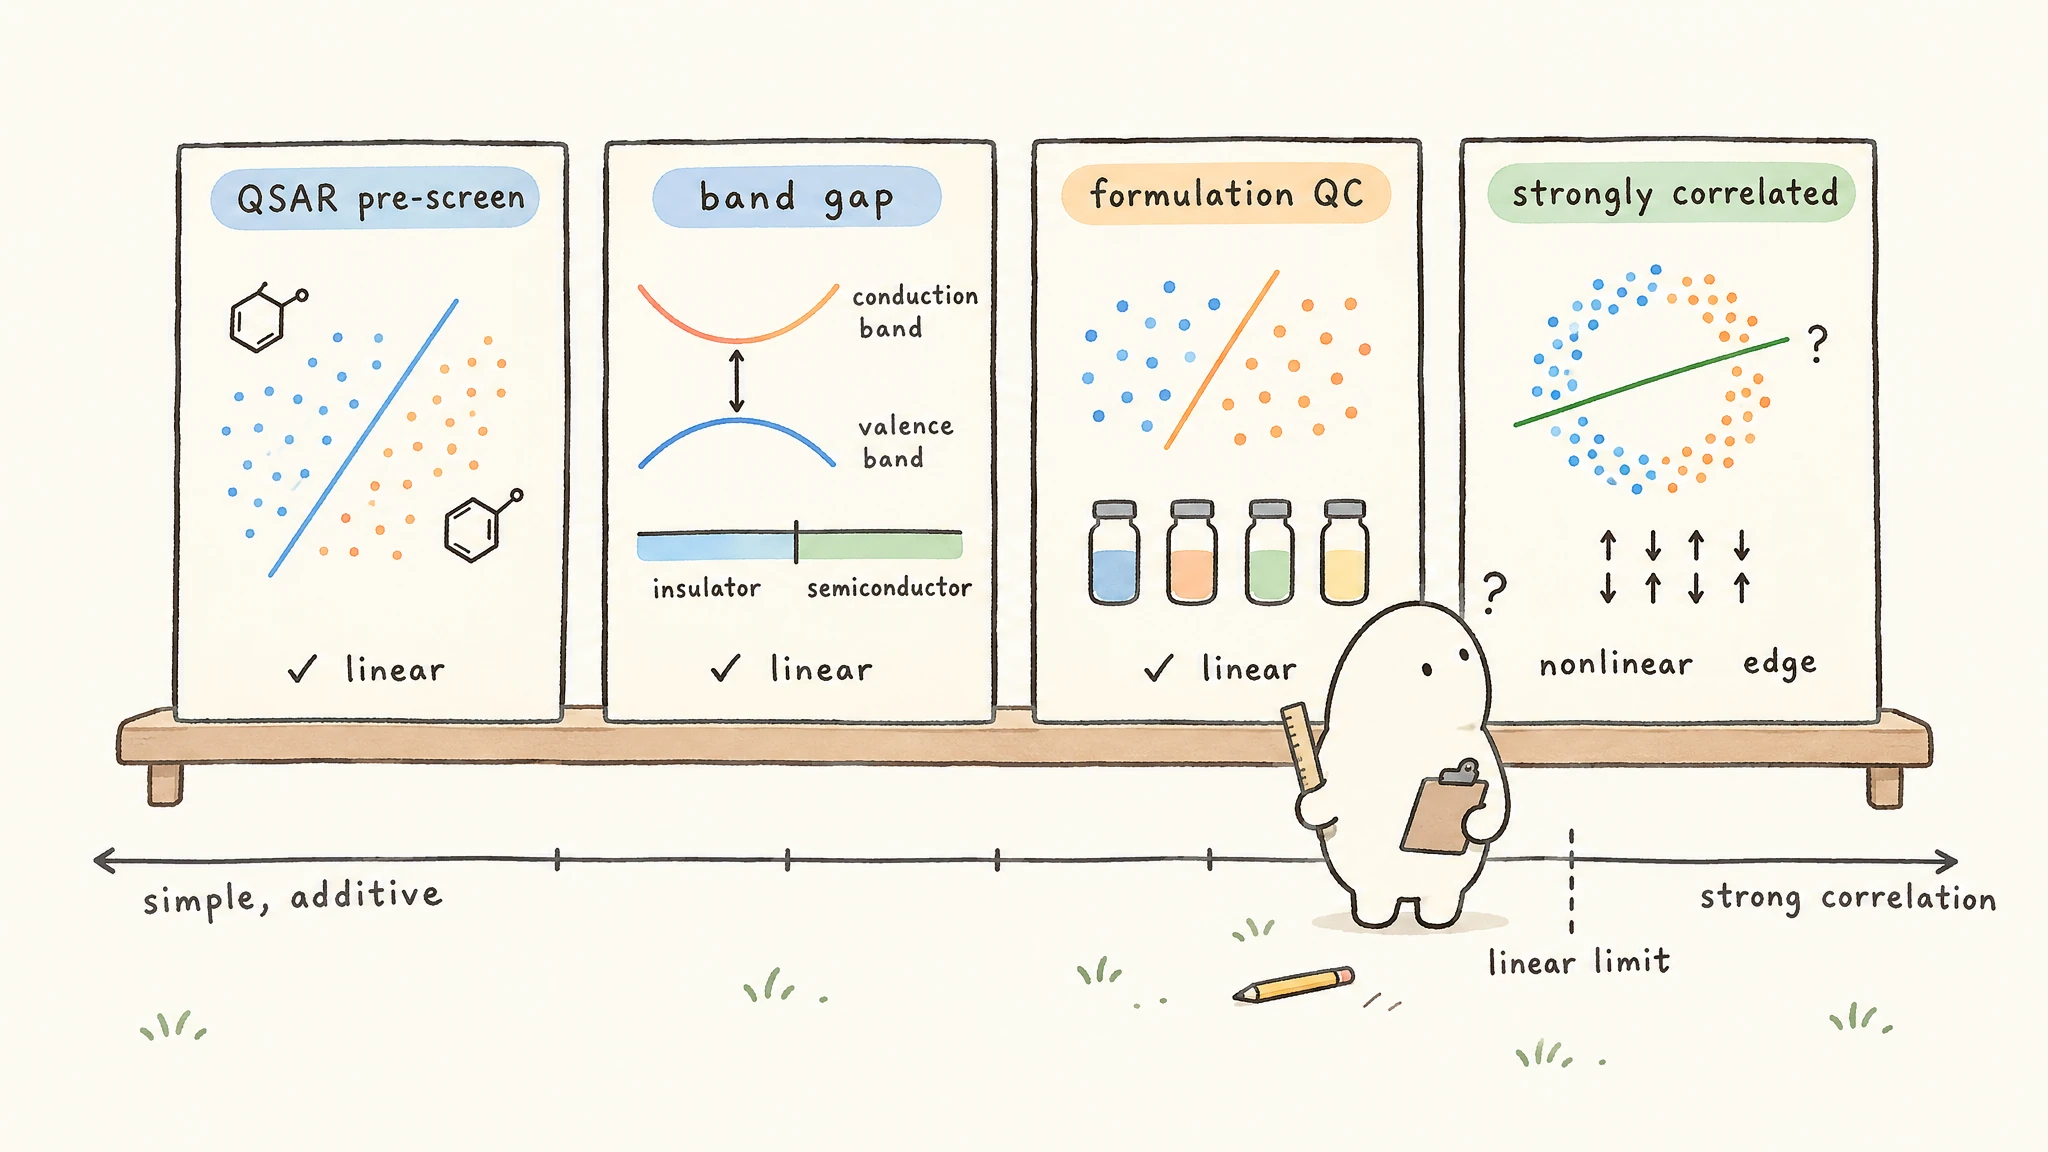
表中最后一行值得强调:当描述符本身缺少关键的物理信息时,问题出在“输入”而不在“模型”,单纯增加模型的复杂度往往无济于事。1.5.2 节的案例会具体展示这种情况。
1.5.2 案例一:二元化合物是半导体还是绝缘体?
1.5.2.1 问题设定
本案例的问题是:只根据化学组成,能否判断一个二元化合物是“半导体”()还是“绝缘体”()?
先说明这里的标签约定。3.0 eV 是为了教学方便人为设定的界线。严格地说,GaN、ZnO 等带隙在 3 eV 以上的材料通常仍被称为宽禁带半导体;本章把 eV 的化合物统称为“绝缘体”,只是一个标签约定。1.5.4 节的三分类改用 1.5 eV 与 3.5 eV 两条界线,所以两处的类别名称不能直接对照。
这类模型的实际用途是高通量初筛:一次 DFT 带隙计算通常需要数十分钟到数小时(具体取决于体系大小和计算方法),而基于元素性质的线性模型给出一个预测只需微秒量级,可以先用它排除明显不合适的候选。
为了让模型在实际筛选中可用,所有特征都只由组成元素的性质计算,不使用待预测化合物的任何测量值,这样也就从源头上避免了“用答案预测答案”的数据泄漏。表 4 列出了四个描述符。
表 4 案例一使用的四个描述符。元素的电负性采用 Pauling 标度;“按化学计量加权”指按化学式中各元素的原子个数求加权平均。
| 符号 | 定义 | 化学含义 |
|---|---|---|
| 阳离子与阴离子 Pauling 电负性之差的绝对值 | 化学键离子性的粗略度量:差值越大,电子越倾向于从阳离子转移到阴离子 | |
| 按化学计量加权的平均主量子数 | 反映价层轨道的大小: 越大,价电子分布越弥散,原子间距和极化率通常越大 | |
| 按化学计量加权的平均电负性 | 反映组成元素整体对电子的吸引能力 | |
| 按化学计量加权的平均价电子数(过渡金属按族序数计) | 反映平均每个原子提供的价电子数 |
以氧化镁 MgO 为例:O 与 Mg 的电负性分别为 3.44 与 1.31,;O 与 Mg 的主量子数分别为 2 与 3,。再看砷化镓 GaAs:两种元素的电负性分别为 2.18 与 1.81,;主量子数都是 4,。MgO 是带隙约 7.8 eV 的绝缘体,GaAs 是带隙 1.42 eV 的半导体,两者在 平面上相距很远。
数据集包含 65 个化合物(为了对照,其中包括 Si、Ge 两种单质),既有主族化合物,也有过渡金属化合物;按 3.0 eV 的界线,半导体 32 个、绝缘体 33 个。带隙数值取自常见文献中的典型值,由作者手工整理,未逐条核对原始出处;同一化合物在不同晶型、温度下的带隙也会不同(例如 MoS₂、WS₂ 取的是单层的值),因此这些数据只适合教学演示,不能作为科研数据引用。如果一个模型什么都不学,总是猜多数类“绝缘体”,准确率为 33/65 = 50.8%,这是任何模型都应当超过的最低基准。
下面的代码给出元素性质表、化合物数据、特征计算函数,以及把标准化空间中的决策边界换算回原始单位的工具函数:
python
# ===========================================================================
# 案例一数据集:65 个二元化合物(含 Si、Ge 两种单质作对照)及辅助函数
# ===========================================================================

ELECTRONEGATIVITY = {
    "H": 2.20, "Li": 0.98, "Be": 1.57, "B": 2.04, "C": 2.55, "N": 3.04,
    "O": 3.44, "F": 3.98, "Na": 0.93, "Mg": 1.31, "Al": 1.61, "Si": 1.90,
    "P": 2.19, "S": 2.58, "Cl": 3.16, "K": 0.82, "Ca": 1.00, "Sc": 1.36,
    "Ti": 1.54, "V": 1.63, "Cr": 1.66, "Mn": 1.55, "Fe": 1.83, "Co": 1.88,
    "Ni": 1.91, "Cu": 1.90, "Zn": 1.65, "Ga": 1.81, "Ge": 2.01, "As": 2.18,
    "Se": 2.55, "Br": 2.96, "Rb": 0.82, "Sr": 0.95, "Y": 1.22, "Zr": 1.33,
    "Nb": 1.60, "Mo": 2.16, "Ag": 1.93, "Cd": 1.69, "In": 1.78, "Sn": 1.96,
    "Sb": 2.05, "Te": 2.10, "I": 2.66, "Cs": 0.79, "Ba": 0.89, "La": 1.10,
    "Ce": 1.12, "Hf": 1.30, "Ta": 1.50, "W": 2.36, "Pb": 2.33, "Bi": 2.02,
}

PRINCIPAL_N = {
    "H": 1, "Li": 2, "Be": 2, "B": 2, "C": 2, "N": 2, "O": 2, "F": 2,
    "Na": 3, "Mg": 3, "Al": 3, "Si": 3, "P": 3, "S": 3, "Cl": 3,
    "K": 4, "Ca": 4, "Sc": 4, "Ti": 4, "V": 4, "Cr": 4, "Mn": 4, "Fe": 4,
    "Co": 4, "Ni": 4, "Cu": 4, "Zn": 4, "Ga": 4, "Ge": 4, "As": 4, "Se": 4, "Br": 4,
    "Rb": 5, "Sr": 5, "Y": 5, "Zr": 5, "Nb": 5, "Mo": 5, "Ag": 5, "Cd": 5,
    "In": 5, "Sn": 5, "Sb": 5, "Te": 5, "I": 5,
    "Cs": 6, "Ba": 6, "La": 6, "Ce": 6, "Hf": 6, "Ta": 6, "W": 6, "Pb": 6, "Bi": 6,
}

VALENCE_ELECTRONS = {
    "H": 1, "Li": 1, "Be": 2, "B": 3, "C": 4, "N": 5, "O": 6, "F": 7,
    "Na": 1, "Mg": 2, "Al": 3, "Si": 4, "P": 5, "S": 6, "Cl": 7,
    "K": 1, "Ca": 2, "Sc": 3, "Ti": 4, "V": 5, "Cr": 6, "Mn": 7, "Fe": 8,
    "Co": 9, "Ni": 10, "Cu": 11, "Zn": 12, "Ga": 3, "Ge": 4, "As": 5,
    "Se": 6, "Br": 7, "Rb": 1, "Sr": 2, "Y": 3, "Zr": 4, "Nb": 5, "Mo": 6,
    "Ag": 11, "Cd": 12, "In": 3, "Sn": 4, "Sb": 5, "Te": 6, "I": 7,
    "Cs": 1, "Ba": 2, "La": 3, "Ce": 4, "Hf": 4, "Ta": 5, "W": 6, "Pb": 4, "Bi": 5,
}


# ---------------------------------------------------------------------------
# 数据集一:二元化合物 (cation)_a (anion)_b
# 字段:(化学式, 阳离子, 阳离子个数, 阴离子, 阴离子个数, E_g / eV)
# ---------------------------------------------------------------------------

RAW_BINARY_COMPOUNDS = [
    # ------- 以下以半导体为主(标签由 build_binary_dataset 按带隙阈值自动生成)-------
    ("Si",    "Si", 1, "Si", 1, 1.12),
    ("Ge",    "Ge", 1, "Ge", 1, 0.67),
    ("SiC",   "Si", 1, "C",  1, 2.36),
    ("BP",    "B",  1, "P",  1, 2.00),
    ("BN",    "B",  1, "N",  1, 6.40),   # 六方 BN:E_g >= 3 eV,按阈值标为绝缘体;Δχ 仅 1.0 而带隙很大
    ("AlP",   "Al", 1, "P",  1, 2.45),
    ("AlAs",  "Al", 1, "As", 1, 2.16),
    ("AlSb",  "Al", 1, "Sb", 1, 1.58),
    ("GaP",   "Ga", 1, "P",  1, 2.26),
    ("GaAs",  "Ga", 1, "As", 1, 1.42),
    ("GaSb",  "Ga", 1, "Sb", 1, 0.72),
    ("GaSe",  "Ga", 1, "Se", 1, 2.00),
    ("InP",   "In", 1, "P",  1, 1.34),
    ("InAs",  "In", 1, "As", 1, 0.35),
    ("InSb",  "In", 1, "Sb", 1, 0.17),
    ("InSe",  "In", 1, "Se", 1, 1.30),
    ("ZnS",   "Zn", 1, "S",  1, 3.60),   # E_g >= 3 eV,按阈值标为绝缘体
    ("ZnSe",  "Zn", 1, "Se", 1, 2.70),
    ("ZnTe",  "Zn", 1, "Te", 1, 2.26),
    ("CdS",   "Cd", 1, "S",  1, 2.42),
    ("CdSe",  "Cd", 1, "Se", 1, 1.74),
    ("CdTe",  "Cd", 1, "Te", 1, 1.50),
    ("PbS",   "Pb", 1, "S",  1, 0.41),
    ("PbSe",  "Pb", 1, "Se", 1, 0.27),
    ("PbTe",  "Pb", 1, "Te", 1, 0.31),
    ("PbI2",  "Pb", 1, "I",  2, 2.30),
    ("MoS2",  "Mo", 1, "S",  2, 1.80),   # 单层的直接带隙;块体为约 1.2 eV 的间接带隙
    ("WS2",   "W",  1, "S",  2, 2.00),   # 单层的直接带隙;块体为约 1.3 eV 的间接带隙
    ("SnS",   "Sn", 1, "S",  1, 1.10),
    ("Bi2S3", "Bi", 2, "S",  3, 1.30),
    ("CuO",   "Cu", 1, "O",  1, 1.40),
    ("CoO",   "Co", 1, "O",  1, 2.60),
    ("FeO",   "Fe", 1, "O",  1, 2.40),
    ("WO3",   "W",  1, "O",  3, 2.70),

    # ------- 以下为绝缘体(E_g >= 3 eV)-------
    ("MgO",   "Mg", 1, "O",  1, 7.80),
    ("CaO",   "Ca", 1, "O",  1, 7.00),
    ("SrO",   "Sr", 1, "O",  1, 5.90),
    ("BaO",   "Ba", 1, "O",  1, 4.30),
    ("BeO",   "Be", 1, "O",  1, 10.60),
    ("Al2O3", "Al", 2, "O",  3, 8.80),
    ("SiO2",  "Si", 1, "O",  2, 9.00),
    ("TiO2",  "Ti", 1, "O",  2, 3.20),
    ("ZrO2",  "Zr", 1, "O",  2, 5.80),
    ("HfO2",  "Hf", 1, "O",  2, 5.80),
    ("SnO2",  "Sn", 1, "O",  2, 3.60),
    ("CeO2",  "Ce", 1, "O",  2, 3.20),
    ("Y2O3",  "Y",  2, "O",  3, 5.60),
    ("La2O3", "La", 2, "O",  3, 5.50),
    ("ZnO",   "Zn", 1, "O",  1, 3.30),
    ("NiO",   "Ni", 1, "O",  1, 3.70),
    ("MnO",   "Mn", 1, "O",  1, 3.60),
    ("GaN",   "Ga", 1, "N",  1, 3.40),
    ("AlN",   "Al", 1, "N",  1, 6.00),
    ("MgS",   "Mg", 1, "S",  1, 4.50),
    ("CaS",   "Ca", 1, "S",  1, 4.40),
    ("MgF2",  "Mg", 1, "F",  2, 11.00),
    ("CaF2",  "Ca", 1, "F",  2, 11.00),
    ("LiF",   "Li", 1, "F",  1, 13.60),
    ("LiCl",  "Li", 1, "Cl", 1, 9.40),
    ("NaCl",  "Na", 1, "Cl", 1, 8.50),
    ("KCl",   "K",  1, "Cl", 1, 8.70),
    ("KBr",   "K",  1, "Br", 1, 7.60),
    ("KI",    "K",  1, "I",  1, 6.30),
    ("NaI",   "Na", 1, "I",  1, 5.90),
    ("CsI",   "Cs", 1, "I",  1, 6.20),
]


def build_binary_dataset(gap_threshold=3.0):
    """
    把原始化合物表转换成 (特征矩阵 X, 标签 y, 元信息)。
    特征全部由元素性质推导,不使用该化合物的任何测量值 —— 这是材料信息学中的
    一条基本要求:特征必须在做预测时就能拿到。
    """
    X, y, meta = [], [], []
    for formula, cat, a, an, b, gap in RAW_BINARY_COMPOUNDS:
        chi_cat, chi_an = ELECTRONEGATIVITY[cat], ELECTRONEGATIVITY[an]
        n_cat, n_an = PRINCIPAL_N[cat], PRINCIPAL_N[an]
        ve_cat, ve_an = VALENCE_ELECTRONS[cat], VALENCE_ELECTRONS[an]
        total = a + b

        delta_chi = abs(chi_cat - chi_an)
        mean_n = (a * n_cat + b * n_an) / total
        mean_chi = (a * chi_cat + b * chi_an) / total
        mean_ve = (a * ve_cat + b * ve_an) / total

        X.append([delta_chi, mean_n, mean_chi, mean_ve])
        y.append(1 if gap >= gap_threshold else 0)
        meta.append({
            "formula": formula, "gap": gap, "delta_chi": delta_chi,
            "mean_n": mean_n, "mean_chi": mean_chi, "mean_ve": mean_ve,
            "cation": cat, "anion": an,
            "label": "绝缘体" if gap >= gap_threshold else "半导体",
        })
    return X, y, meta


FEATURE_NAMES = ["Δχ 电负性差", "n̄ 平均主量子数", "χ̄ 平均电负性", "V̄ 平均价电子数"]

# d 区元素(周期表第 3~12 族,含 Zn、Cd)。含未满 d 壳层过渡金属的化合物,
# 带隙往往由 d 电子决定,只靠电负性、主量子数这类描述符难以刻画。
# 注意 Pb、Sn、Bi 属于 p 区,不在此列。
D_BLOCK = {"Sc", "Ti", "V", "Cr", "Mn", "Fe", "Co", "Ni", "Cu", "Zn",
           "Y", "Zr", "Nb", "Mo", "Ag", "Cd",
           "Hf", "Ta", "W"}


def main_group_indices(meta):
    """返回不含 d 区元素的样本下标(La、Ce 按镧系元素处理,不计入 d 区)。"""
    return [i for i, m in enumerate(meta)
            if m["cation"] not in D_BLOCK and m["anion"] not in D_BLOCK]

def fmt_equation(coef, intercept, names):
    parts = [f"{w:+.3f}·{n.split()[0]}" for w, n in zip(coef, names)]
    return "  ".join(parts) + f"  {intercept:+.3f} = 0"


def raw_space_equation(clf, scaler, names):
    """把标准化空间的决策边界换算回原始物理量纲,方便化学解读。"""
    w_raw = [clf.coef_[j] / scaler.std_[j] for j in range(len(clf.coef_))]
    b_raw = clf.intercept_ - sum(clf.coef_[j] * scaler.mean_[j] / scaler.std_[j]
                                 for j in range(len(clf.coef_)))
return w_raw, b_raw, fmt_equation(w_raw, b_raw, names)1.5.2.2 实验一:两个描述符
先只用 两个描述符。按 7:3 分层划分训练集和测试集,用训练集拟合标准化参数,然后训练感知器:
python
# ---------------- 实验 1 完整可运行代码 ----------------
X_all, y_all, meta = build_binary_dataset()
X2 = [[row[0], row[1]] for row in X_all]          # 只取 (Δχ, n̄)
names2 = [FEATURE_NAMES[0], FEATURE_NAMES[1]]

Xtr, Xte, ytr, yte = train_test_split(X2, y_all, test_size=0.3,
                                      random_state=7, stratify=True)
scaler = StandardScaler().fit(Xtr)
Xtr_s, Xte_s = scaler.transform(Xtr), scaler.transform(Xte)

clf = Perceptron(learning_rate=1.0, n_epochs=100, random_state=0)
clf.fit(Xtr_s, ytr)
rep = classification_report(yte, clf.predict(Xte_s))
w_raw, b_raw, eq_raw = raw_space_equation(clf, scaler, names2)

print("【实验 1】(Δχ, n̄) 两个特征,训练集 45 个 / 测试集 20 个")
print(f"  训练集准确率 : {clf.score(Xtr_s, ytr):.3f}")
print(f"  测试集准确率 : {rep['accuracy']:.3f}  (TN={rep['confusion'][0]}, FP={rep['confusion'][1]}, FN={rep['confusion'][2]}, TP={rep['confusion'][3]})")
print(f"  跑满 {clf.n_iter_} 轮,每轮误分类数始终没有降到 0,在 {min(clf.history_)}~{max(clf.history_)} 之间振荡。前 30 轮:")
print(f"    {clf.history_[:30]} ...")
print(f"  标准化空间决策边界:{fmt_equation(clf.coef_, clf.intercept_, names2)}")
print(f" 原始物理量纲边界 :{eq_raw}")运行输出如下:
text
【实验 1】(Δχ, n̄) 两个特征,训练集 45 个 / 测试集 20 个
  训练集准确率 : 0.933
  测试集准确率 : 0.900  (TN=8, FP=2, FN=0, TP=10)
  跑满 100 轮,每轮误分类数始终没有降到 0,在 2~8 之间振荡。前 30 轮:
    [8, 6, 3, 6, 3, 3, 6, 4, 3, 3, 2, 3, 4, 6, 3, 4, 3, 8, 2, 2, 4, 2, 3, 2, 6, 4, 3, 5, 4, 3] ...
  标准化空间决策边界:+2.011·Δχ  -0.147·n̄  +1.000 = 0
原始物理量纲边界 :+2.416·Δχ -0.177·n̄ -1.463 = 0测试集准确率 0.900,看上去不错,但还有一个数字值得特别注意:训练跑满了 100 轮也没停下来。从输出中可以读出三点:
- 有一定区分能力。 测试集准确率为 0.900,明显高于 0.508 的多数类基线,说明 中包含与带隙相关的信息。但测试集只有 20 个样本,多错或少错 1 个就相差 0.05,这个数字只能作为大致参考。
- 训练没有收敛。 100 轮中每轮的误分类数始终在 2 至 8 之间振荡,从未降到 0。根据 1.3.5 节的收敛定理,线性可分的数据一定会在有限步内收敛;反过来,长时间不收敛提示数据可能线性不可分,但单凭“100 轮没收敛”还不能下结论,因为上界 可能很大。附录 A.3 介绍了一种严格的检验办法:求解一个线性规划问题。作者用这种方法检验过,这 45 个训练样本在 平面上确实线性不可分。
- 权重符号与化学直觉一致。 换算回原始单位后,决策边界为
- 的权重为正:电负性差越大,化学键的离子性越强,成键态与反键态之间的能量差越大,带隙越宽。这与 Phillips–Van Vechten 的介电理论 [32] 中“离子性贡献使带隙增大”的图像一致。
- 的权重为负:主量子数越大,价层轨道越弥散,相邻原子轨道重叠越强,能带越宽,带隙越窄。例如 GaAs(1.42 eV)的带隙小于 GaP(2.26 eV),InSb(0.17 eV)的带隙小于 InP(1.34 eV)。
需要强调,符号“一致”只说明模型没有学出违背常识的规律,并不能证明这就是带隙变化的机理;而且这组权重来自振荡中某一时刻的状态,换一个随机种子,数值可能明显不同(1.5.5 节)。
1.5.2.3 实验二:去掉含 d 区元素的化合物
实验一不收敛,问题出在哪里?做一个对照实验:特征和算法都不变,只去掉含 d 区元素(周期表第 3–12 族,包括 Zn、Cd 等)的 19 个化合物,用剩下的 46 个样本训练。这里的目的是检验可分性,所以 46 个样本全部用于训练:
python
# ---------------- 实验 2 完整可运行代码 ----------------
keep = main_group_indices(meta)
Xmg, ymg = [X2[i] for i in keep], [y_all[i] for i in keep]
sc_mg = StandardScaler().fit(Xmg)
clf_mg = Perceptron(learning_rate=1.0, n_epochs=200, random_state=0)
clf_mg.fit(sc_mg.transform(Xmg), ymg)
w_mg, b_mg, eq_mg = raw_space_equation(clf_mg, sc_mg, names2)

print(f"【实验 2】去掉含 d 区元素的化合物:剩 {len(ymg)} 个样本,其中绝缘体 {sum(ymg)} 个")
print(f"  标准化空间权重:{fmt_equation(clf_mg.coef_, clf_mg.intercept_, names2)}")
print(f"  迭代轮数     : {clf_mg.n_iter_},每轮误分类数 {clf_mg.history_}")
print(f"  训练集准确率 : {clf_mg.score(sc_mg.transform(Xmg), ymg):.3f}")
print(f" 原始量纲边界 :{eq_mg}")运行输出如下:
text
【实验 2】去掉含 d 区元素的化合物:剩 46 个样本,其中绝缘体 25 个
  标准化空间权重:+1.735·Δχ  -0.525·n̄  +0.000 = 0
  迭代轮数     : 2,每轮误分类数 [2, 0]
  训练集准确率 : 1.000
原始量纲边界 :+1.906·Δχ -0.552·n̄ -0.479 = 0去掉含 d 区元素的化合物之后,感知器第 2 轮就把 46 个样本全部分对了。这说明在 平面上,不含 d 区元素的化合物是线性可分的,实验一中的不可分来自含 d 区元素的那部分样本。
感知器 2 轮就全部分对,容易让人兴奋,但先别急着下结论:这只说明主族化合物在这两个描述符下可分,并不说明规律能推广到含 d 电子的体系。这个对照实验提供了一个通用的思路:模型在训练集上迟迟不收敛时,不要急于调整学习率、轮数这些超参数,而应先检查数据在当前特征下是否可分,以及不可分是由哪些样本造成的。
换算回原始单位,决策边界为:
把三个化合物代入式 (34) 验算,结果见表 5。
表 5 用式 (34) 对三个化合物的手算验证。判别得分为式 (34) 左边的数值,大于 0 判为绝缘体。ZnS 含 d 区元素 Zn,不在实验二的训练集中。
| 化合物 | 判别得分 | 模型预测 | 实际带隙 | 结果 | ||
|---|---|---|---|---|---|---|
| MgO | 2.13 | 2.50 | 绝缘体 | 7.80 eV | 正确 | |
| GaAs | 0.37 | 4.00 | 半导体 | 1.42 eV | 正确 | |
| ZnS | 0.93 | 3.50 | 半导体 | 3.60 eV | 错误(训练分布之外) |
MgO 和 GaAs 都判断正确,ZnS 却判错了:它的带隙为 3.60 eV,按本章的约定属于绝缘体,模型却判为半导体。
原因在于 ZnS 含有 d 区元素 Zn,而实验二的训练集中没有任何含 d 区元素的化合物。这是一个典型的**分布外(out-of-distribution, OOD)**样本:模型在训练数据覆盖的化学范围内表现很好,用到没见过的化学范围时却可能出错,而且不会提示“我不确定”。值得注意的是,实验一中用全部化合物训练的模型把 ZnS 判对了(实验三的错分清单中没有它)。另外,ZnS 的带隙离 3.0 eV 的界线不远,本来就是容易判错的样本。使用模型之前,应当先检查待预测样本是否落在训练数据覆盖的范围内(1.6.5 节)。
1.5.2.4 实验三:错在哪里,为什么错
回到实验一的模型,把它在全部 65 个化合物上的错分样本列出来:
python
# ---------------- 实验 3 完整可运行代码 ----------------
all_pred = clf.predict(scaler.transform(X2))
wrong = [(i, meta[i]) for i in range(len(meta)) if all_pred[i] != y_all[i]]
print(f"【实验 3】所有样本的错分情况(用实验 1 的模型)")
print(f"  {len(meta)} 个样本里错 {len(wrong)} 个:")
print(f"  {'化学式':<7}{'E_g/eV':>8}{'Δχ':>7}{'n̄':>6}   真实 -> 预测")
for i, m in sorted(wrong, key=lambda t: t[1]["gap"]):
    pred_label = "绝缘体" if all_pred[i] == 1 else "半导体"
print(f" {m['formula']:<7}{m['gap']:>8.2f}{m['delta_chi']:>7.2f}{m['mean_n']:>6.2f} {m['label']} -> {pred_label}")检出结果如下:
text
【实验 3】所有样本的错分情况(用实验 1 的模型)
  65 个样本里错 5 个:
  化学式      E_g/eV     Δχ    n̄   真实 -> 预测
  CuO        1.40   1.54  3.00   半导体 -> 绝缘体
  FeO        2.40   1.61  3.00   半导体 -> 绝缘体
  CoO        2.60   1.56  3.00   半导体 -> 绝缘体
  ZnSe       2.70   0.90  4.00   半导体 -> 绝缘体
WO3 2.70 1.08 3.00 半导体 -> 绝缘体5 个错分样本有一个共同点:都是半导体被误判为绝缘体。其中最值得关注的是三种过渡金属一氧化物 CuO、FeO 与 CoO。它们的电负性差在 1.54~1.61 之间,主量子数平均值都是 3.00,与绝缘体 NiO(,)几乎重合,与 CaS(1.58)、SiO₂(1.54)的电负性差也很接近;但它们的带隙只有 1.40~2.60 eV。在 平面上,这几个化合物几乎落在同一点,却分属两类,任何直线都无法把它们分开。
为什么组成统计量如此接近的化合物,带隙会相差这么多?这些过渡金属氧化物的带隙主要由未满 d 壳层的电子决定。按照 Zaanen–Sawatzky–Allen(ZSA)的分类 [10],带隙的大小取决于 d 电子之间的在位库仑排斥能 和配体 p 轨道到金属 d 轨道的电荷转移能 的相对大小,而不是由电负性差决定。NiO、CoO、FeO 是这类“强关联”氧化物的典型例子。电负性差和平均主量子数完全不包含 d 电子数、、 这些信息,所以模型无法区分它们。
另外两个错分样本的原因不同。ZnSe(2.70 eV)中 Zn 的 3d 壳层是满的,不属于强关联体系,它被判错主要是因为带隙离 3.0 eV 的界线很近;WO₃(2.70 eV)中 W 为 +6 价、5d 轨道全空,带隙由 O 2p 到 W 5d 的跃迁决定,带隙同样接近界线。可见错分样本需要逐个分析,不能一概归于同一个原因。
图 19 把全部样本和实验一的决策边界画在 平面上。
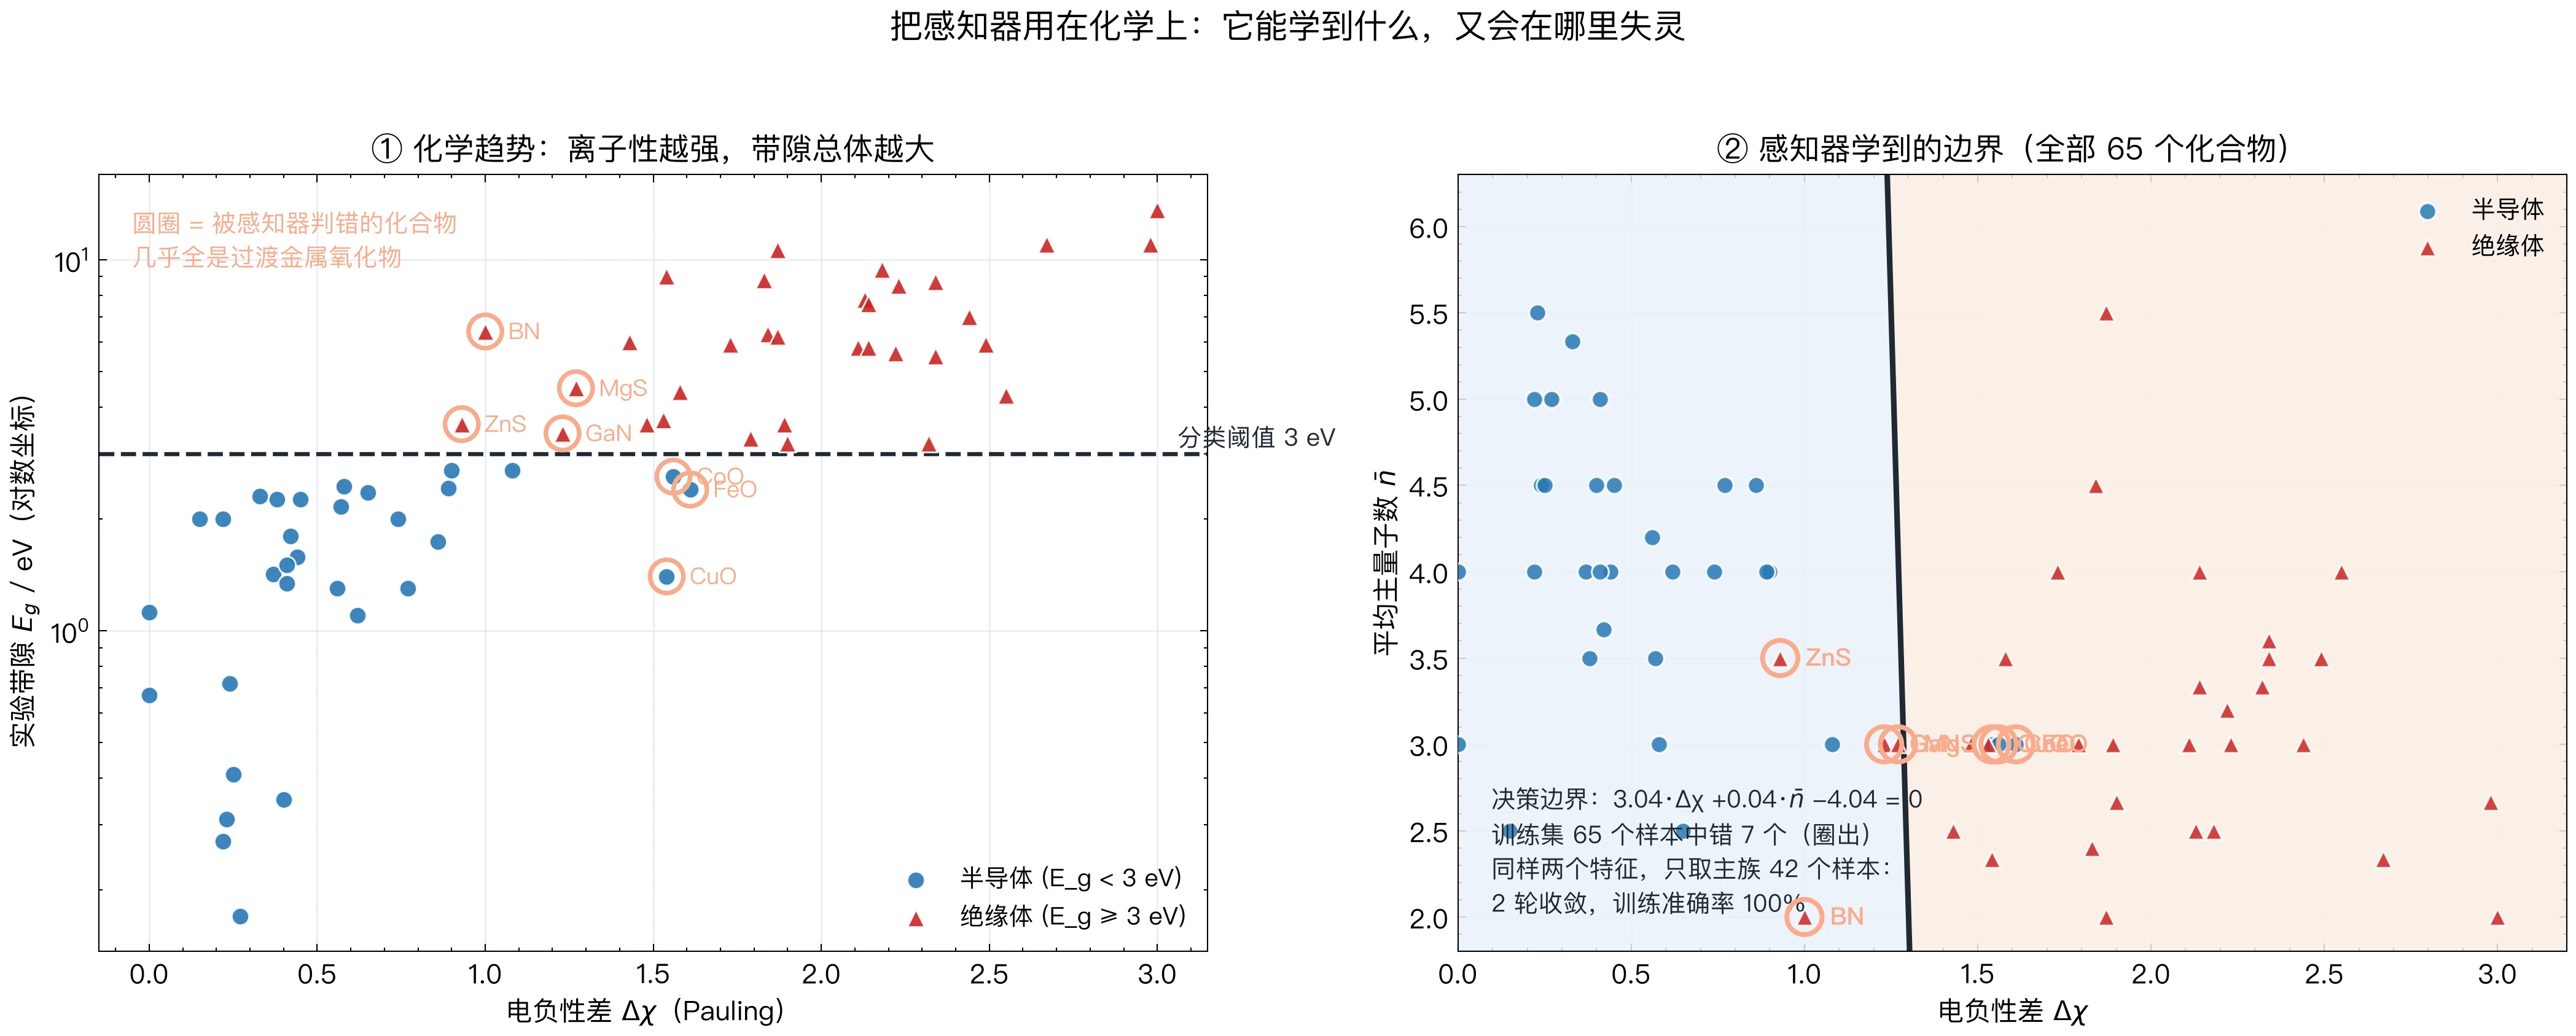
这一分析给出的启示是:模型在某一类化合物上系统性地出错时,首先应该检查特征是否遗漏了决定这类化合物性质的物理量(这里是 d 电子数、、 等),而不是急于换用更深的模型。根据物理知识设计新的描述符,是解决这类问题的常用办法。
1.5.2.5 实验四:特征越多越好吗?
既然两个描述符不够,一个自然的想法是增加特征。下面依次加入平均电负性 和平均价电子数 ,用与实验一相同的划分比较:
python
# ---------------- 实验 4 完整可运行代码 ----------------
Xtr4, Xte4, ytr4, yte4 = train_test_split(X_all, y_all, test_size=0.3,
                                          random_state=7, stratify=True)
print("【实验 4】把特征从 2 维扩到 4 维 (Δχ, n̄, χ̄, V̄)")
for feat_idx, tag in [([0, 1], "2 维 (Δχ, n̄)"),
                      ([0, 1, 2], "3 维 (+χ̄)"),
                      ([0, 1, 2, 3], "4 维 (+χ̄, +V̄)")]:
    a = [[row[j] for j in feat_idx] for row in Xtr4]
    b = [[row[j] for j in feat_idx] for row in Xte4]
    sc = StandardScaler().fit(a)
    m = Perceptron(n_epochs=200, random_state=0).fit(sc.transform(a), ytr4)
print(f" {tag:<16} 训练 {m.score(sc.transform(a), ytr4):.3f} 测试 {m.score(sc.transform(b), yte4):.3f} (跑满 {m.n_iter_} 轮)")实验输出结果如下:
text
【实验 4】把特征从 2 维扩到 4 维 (Δχ, n̄, χ̄, V̄)
  2 维 (Δχ, n̄)     训练 0.933   测试 0.900   (跑满 200 轮)
  3 维 (+χ̄)        训练 0.911   测试 0.850   (跑满 200 轮)
4 维 (+χ̄, +V̄) 训练 0.956 测试 0.850 (跑满 200 轮)从 2 维增加到 4 维,测试集准确率没有提高,反而从 0.900 变为 0.850。
这个结果需要谨慎解读。20 个测试样本中,0.050 的差别只相当于 1 个样本,单次划分不足以说明“加特征会变差”。作者另外计算了 65 个化合物上四个描述符两两之间的相关系数,绝对值都不超过 0.50(最大的是 与 之间的 ),所以这里并不存在严重的多重共线性,不能把准确率的变化归因于共线性。更合理的解释是:数据在这些特征下仍然线性不可分,感知器的最终权重取决于最后几次更新,结果会随划分方式和特征组合而波动;而新加入的 、 同样不包含 d 电子关联的信息,不能解决实验三发现的问题。要可靠地判断加特征是否有益,需要像实验五那样做多次划分取平均,并使用更稳定的模型。
1.5.2.6 实验五:多次划分下比较三个模型
前面的实验都只用了一次随机划分。为了减少偶然性,下面用 20 个不同的随机种子各做一次分层划分,在 两个描述符上比较原始感知器、口袋感知器和单隐层 MLP 的测试准确率:
python
# ---------------- 实验 5 完整可运行代码 ----------------
acc_perc, acc_pocket, acc_mlp = [], [], []
for seed in range(20):
    Xtr5, Xte5, ytr5, yte5 = train_test_split(X2, y_all, test_size=0.3,
                                              random_state=seed, stratify=True)
    sc = StandardScaler().fit(Xtr5)
    a, b = sc.transform(Xtr5), sc.transform(Xte5)
    acc_perc.append(Perceptron(n_epochs=200, random_state=seed)
                    .fit(a, ytr5).score(b, yte5))
    acc_pocket.append(PocketPerceptron(n_epochs=200, random_state=seed)
                      .fit(a, ytr5).score(b, yte5))
    acc_mlp.append(MLPClassifier(hidden_size=8, learning_rate=0.1,
                                 n_epochs=800, random_state=seed)
                   .fit(a, ytr5).score(b, yte5))

def summary(v):
    m = sum(v) / len(v)
    s = (sum((a - m) ** 2 for a in v) / len(v)) ** 0.5
    return f"{m:.3f} ± {s:.3f}   (最低 {min(v):.2f},最高 {max(v):.2f})"

print("【实验 5】重复 20 次随机划分,测试准确率的均值 ± 标准差(都用 Δχ, n̄)")
print(f"  原始感知器(停在最后一个 epoch) {summary(acc_perc)}")
print(f"  口袋感知器(保留历史最优权重)   {summary(acc_pocket)}")
print(f"  单隐层 MLP(8 个 tanh 神经元)   {summary(acc_mlp)}")
diff = [a - b for a, b in zip(acc_mlp, acc_pocket)]
print(f"  逐次比较 MLP 与口袋感知器:MLP 更好 {sum(d > 0 for d in diff)} 次,"
f"持平 {sum(d == 0 for d in diff)} 次,更差 {sum(d < 0 for d in diff)} 次")评测统计输出如下:
text
【实验 5】重复 20 次随机划分,测试准确率的均值 ± 标准差(都用 Δχ, n̄)
  原始感知器(停在最后一个 epoch) 0.850 ± 0.095   (最低 0.60,最高 0.95)
  口袋感知器(保留历史最优权重)   0.905 ± 0.047   (最低 0.80,最高 0.95)
  单隐层 MLP(8 个 tanh 神经元)   0.915 ± 0.039   (最低 0.85,最高 1.00)
逐次比较 MLP 与口袋感知器:MLP 更好 5 次,持平 13 次,更差 2 次从 20 次划分的结果可以得出三点结论:
- 原始感知器很不稳定。 测试准确率的标准差为 0.095,最低只有 0.60。数据线性不可分时,感知器的最终权重由停止前最后几次更新决定,结果在不同划分之间波动很大。
- 口袋算法更稳定。 口袋感知器保存训练误差最小的权重,平均测试准确率 0.905,标准差降到 0.047。这正是 1.3.6 节所说的作用:它不能让数据变得可分,但能避免停在一个糟糕的振荡状态上。
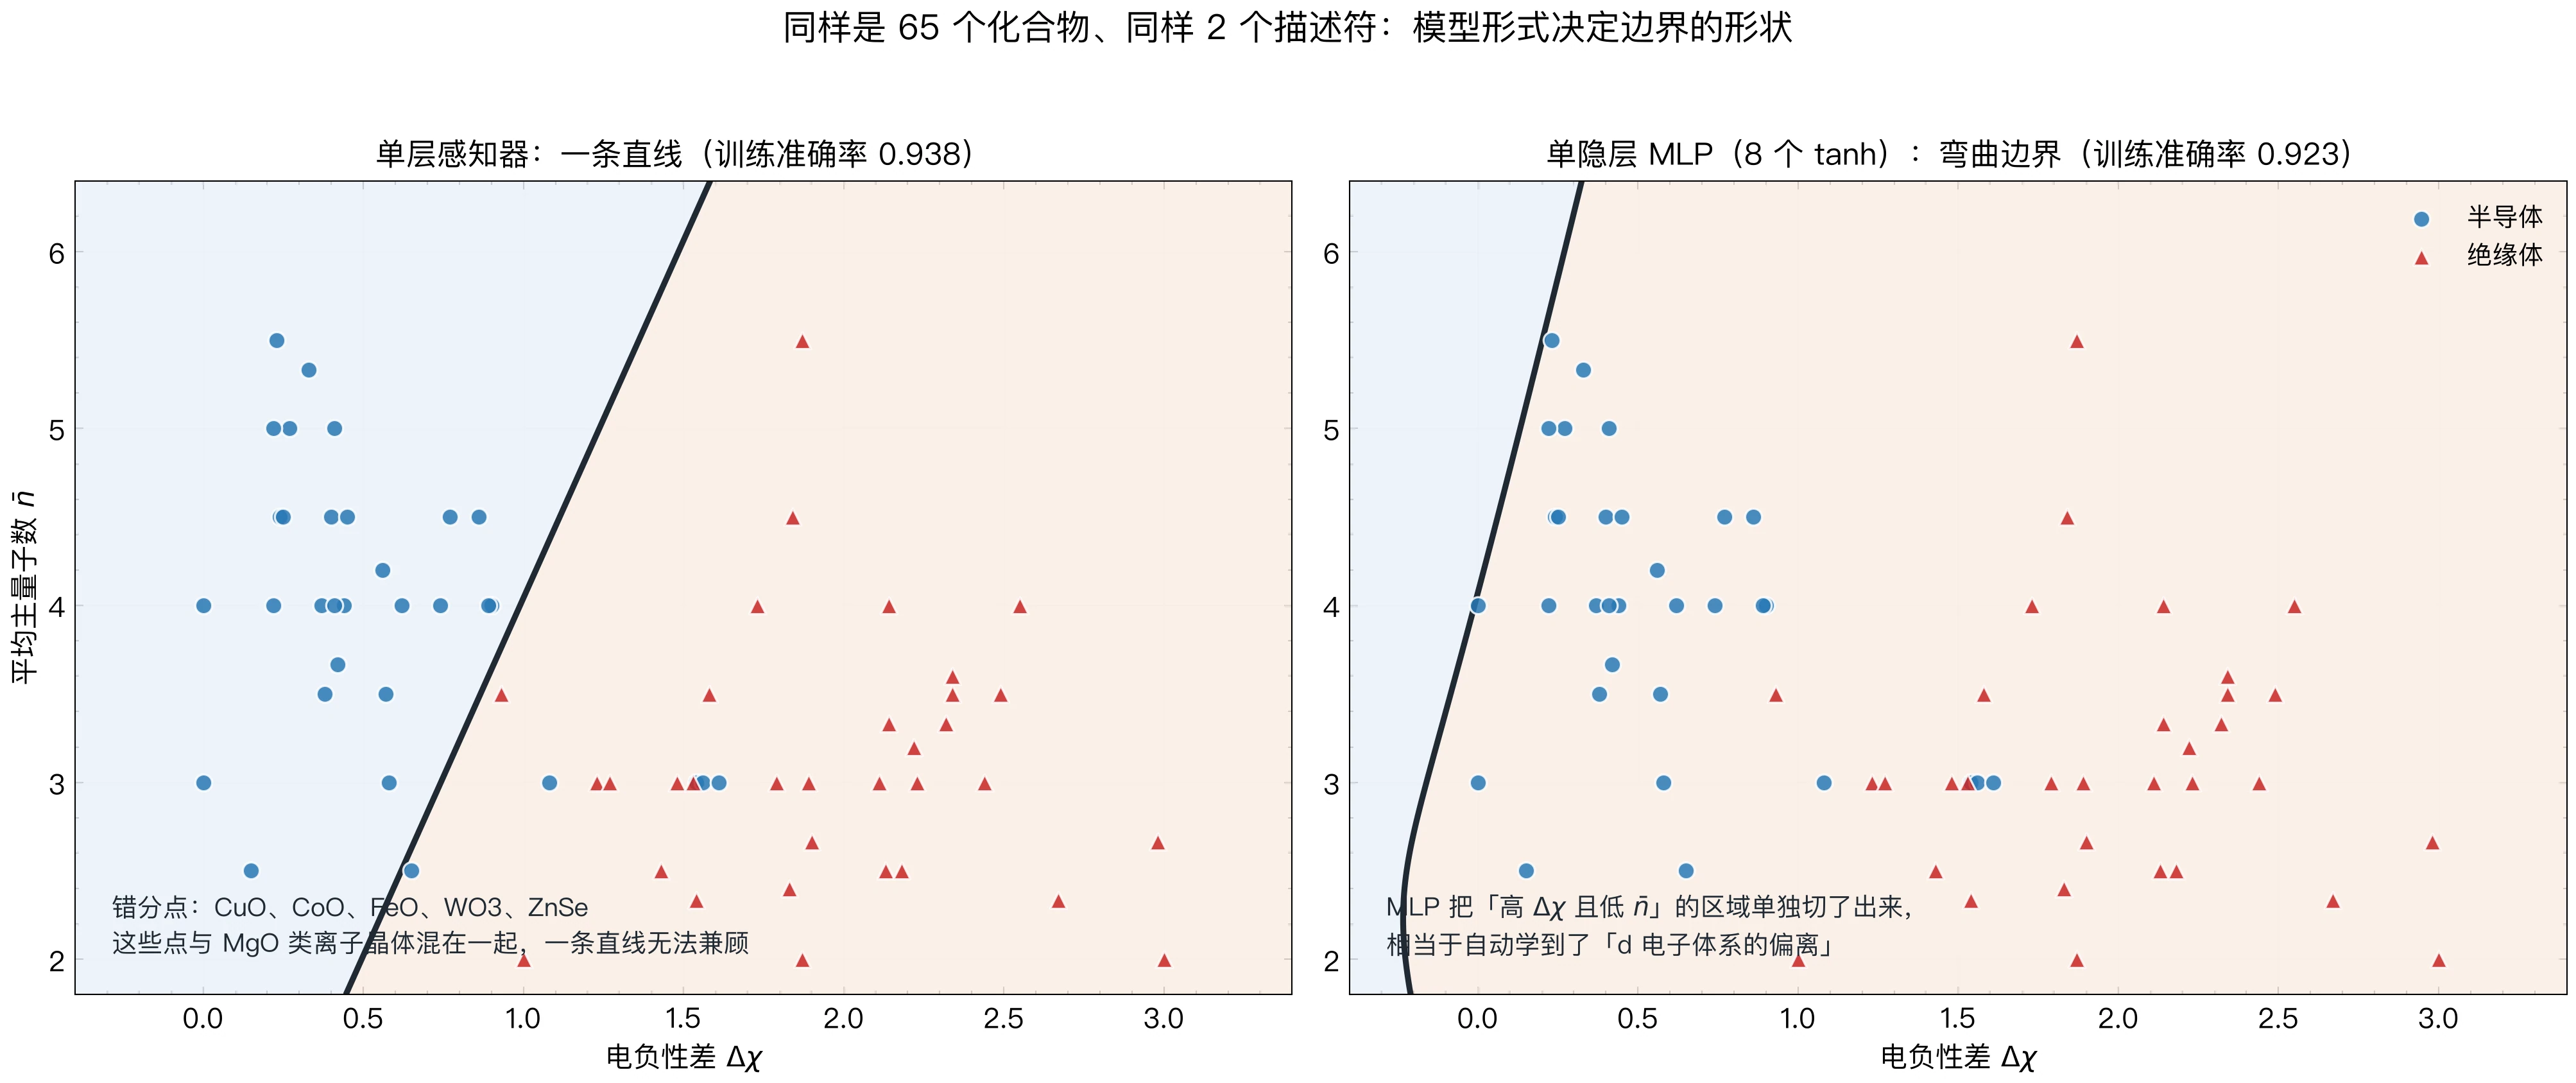
- MLP 并没有明显更好。 MLP 的平均测试准确率为 0.915,比口袋感知器只高 0.01;逐次比较,20 次中 13 次两者持平,MLP 更好 5 次、更差 2 次。每次的差别最多只有 1~2 个测试样本,这样的差距不足以说明 MLP 更好。实验三已经说明,错分的根源是特征缺少 d 电子的信息,非线性模型同样无法凭空补出这些信息。
图 20 对比了单层感知器和 MLP 在全部 65 个化合物上的决策区域。
【适用范围:不要把本案例的线性边界直接用于过渡金属与稀土化合物】
本案例依据的“离子性越强、带隙越大”的图像,适用于由主族元素组成的简单二元共价/离子晶体(如 NaCl、GaAs),在这类化合物上可以得到较好的线性划分。但不要把它直接推广到含 3d/4f 电子的过渡金属和稀土化合物:
- 强电子关联。 在 NiO、CoO、FeO 等 3d 氧化物中,d 电子之间的在位库仑排斥能 与 d 带宽度 相当或更大。按照不考虑这种关联的简单能带图像,d 壳层未填满的化合物应当是金属;实际上,电子关联使它们成为带隙达数电子伏特的绝缘体(Mott 绝缘体或电荷转移绝缘体)。
- 带隙由 与 决定。 按照 ZSA 分类 [10],这类化合物的带隙主要取决于 与电荷转移能 中较小的一个,而不是电负性差 。把在主族化合物上得到的直线 套用到这类化合物上,很容易判错。
- 晶格畸变。 d 轨道简并还可能引起 Jahn–Teller 畸变等结构变化,进一步改变电子结构。
处理这类体系,需要补充描述 d 电子填充、关联强度、局域配位环境的特征,或者使用能直接利用晶体结构信息的模型(如图神经网络,后续章节介绍)。
1.5.3 案例二:感知器能学会 Lipinski 规则吗?
案例一中,数据线性不可分,感知器在训练集上就分不对。案例二展示另一种情况:训练集上全部分对,模型却仍然有结构性的缺陷。
1.5.3.1 问题设定
在药物化学中,Lipinski 的“五规则”(Rule of Five, Ro5)[9] 常用于粗筛口服吸收潜力较好的小分子。原始规则包括四条阈值:相对分子质量 MW ≤ 500、、氢键供体数 HBD ≤ 5、氢键受体数 HBA ≤ 10,并且指出违反两条及以上时吸收不良的可能性较大。为了让问题便于可视化,本案例做了简化:只用前三条阈值(表 6),并把“三条同时满足”定义为“类药”,否则为“非类药”。
表 6 本案例使用的三条阈值。原始 Lipinski 规则还包括氢键受体数 HBA ≤ 10 一条;“背景”一栏是经验性的解释。
| 判据 | 阈值 | 背景 |
|---|---|---|
| 相对分子质量(MW) | 分子过大,通常不利于被动扩散穿过肠上皮细胞膜 | |
| 脂水分配系数() | 亲脂性过强的分子往往水溶性差 | |
| 氢键供体数(HBD) | 氢键供体过多时,分子进入脂质膜需要付出较大的去溶剂化代价 |
我们选取了 30 个有机小分子,其中 17 个满足三条阈值、13 个不满足,看感知器能否从这些数据中学会这条规则。分子的数据与标签生成代码如下:
python
# ===========================================================================
# 案例二数据集:30 个有机小分子(MW、logP、HBD 取常见文献值,仅供教学)
# ===========================================================================

RAW_MOLECULES = [
    # 满足三条阈值(MW≤500, logP≤5, HBD≤5)的分子,多数是常见口服药物
    ("对乙酰氨基酚", 151.2, 0.46, 2),
    ("阿司匹林",     180.2, 1.19, 1),
    ("咖啡因",       194.2, -0.07, 0),
    ("布洛芬",       206.3, 3.50, 1),
    ("茶碱",         180.2, -0.02, 1),
    ("萘普生",       230.3, 3.18, 1),
    ("利多卡因",     234.3, 2.26, 1),
    ("普萘洛尔",     259.3, 3.48, 2),
    ("地西泮",       284.7, 2.82, 0),
    ("华法林",       308.3, 2.70, 1),
    ("环丙沙星",     331.3, 0.28, 2),
    ("硝苯地平",     346.3, 2.20, 1),
    ("青霉素 G",     334.4, 1.83, 2),
    ("二甲双胍",     129.2, -1.43, 2),
    ("维生素 C",     176.1, -1.85, 4),
    ("苯胺",         93.1, 0.90, 2),

    ("葡萄糖",       180.2, -3.24, 5),   # HBD = 5,恰好在阈值上,仍算满足

    # 违反一条或多条阈值
    ("蔗糖",         342.3, -3.70, 8),   # HBD > 5
    ("视黄醇",       286.5, 5.68, 1),    # logP > 5
    ("胆固醇",       386.7, 7.02, 1),    # logP > 5
    ("α-生育酚",     430.7, 10.70, 1),   # logP >> 5
    ("十八烷",       254.5, 9.20, 0),    # logP >> 5
    ("三硬脂酸甘油酯", 891.5, 24.0, 0),  # MW、logP 双超标
    ("叶绿醌",       450.7, 9.30, 0),    # logP > 5
    ("辅酶 Q10",     863.3, 15.00, 0),   # MW、logP 双超标
    ("紫杉醇",       853.9, 3.00, 4),    # MW > 500
    ("阿霉素",       543.5, 1.30, 5),    # MW > 500
    ("环孢素 A",     1202.6, 2.90, 5),   # MW > 500
    ("地高辛",       780.9, 1.00, 6),    # MW、HBD 双超标
    ("维生素 B12",   1355.4, -3.40, 8),  # MW、HBD 双超标
]


def build_molecule_dataset(mw_max=500.0, logp_max=5.0, hbd_max=5):
    """
    生成分子数据集:标签 = 是否同时满足三条阈值(Lipinski 规则的简化版)。
    这个标签是三个阈值条件的逻辑与(AND),满足条件的区域是三个半空间的交集,
    即一个与坐标轴对齐的"盒子";而感知器只能画一个超平面。
    """
    X, y, meta = [], [], []
    for name, mw, logp, hbd in RAW_MOLECULES:
        ok = (mw <= mw_max) and (logp <= logp_max) and (hbd <= hbd_max)
        X.append([mw, logp, float(hbd)])
        y.append(1 if ok else 0)
        meta.append({"name": name, "mw": mw, "logp": logp, "hbd": hbd,
                     "label": "类药" if ok else "非类药"})
    return X, y, meta


MOLECULE_FEATURE_NAMES = ["MW 相对分子质量", "logP 脂水分配系数", "HBD 氢键供体数"]1.5.3.2 训练结果
把 30 个分子全部用于训练(目的是看感知器能否表示这条规则),特征先做标准化:
python
# ---------------- 案例二训练与边界提取代码 ----------------
X, y, meta = build_molecule_dataset()
scaler = StandardScaler().fit(X)
Xs = scaler.transform(X)

clf = Perceptron(learning_rate=1.0, n_epochs=300, random_state=0)
clf.fit(Xs, y)
pred = clf.predict(Xs)
rep = classification_report(y, pred)

print("【结果】感知器在整个数据集上训练")
print(f"  训练准确率 : {rep['accuracy']:.3f}")
print(f"  混淆矩阵   : TN={rep['confusion'][0]}  FP={rep['confusion'][1]}  FN={rep['confusion'][2]}  TP={rep['confusion'][3]}")
print(f"  迭代轮数   : {clf.n_iter_}(误分类数降到 0,正常收敛)")
print(f"  误分类数曲线(前 20 轮):{clf.history_[:20]}")
print(f"  标准化空间决策边界:{clf.coef_[0]:+.3f}·MW {clf.coef_[1]:+.3f}·logP {clf.coef_[2]:+.3f}·HBD {clf.intercept_:+.3f} = 0")
print("  换算回原始单位(每个特征除以自己的标准差):")
for name, w, s in zip(MOLECULE_FEATURE_NAMES, clf.coef_, scaler.std_):
print(f" {name:<20} 每单位实际贡献 {w / s:+.5f}")模型执行输出如下:
text
【结果】感知器在整个数据集上训练
  训练准确率 : 1.000
  混淆矩阵   : TN=13  FP=0  FN=0  TP=17
  迭代轮数   : 9(误分类数降到 0,正常收敛)
  误分类数曲线(前 20 轮):[8, 1, 3, 2, 1, 3, 6, 1, 0]
  标准化空间决策边界:-1.629·MW -4.875·logP -3.852·HBD -1.000 = 0
  换算回原始单位(每个特征除以自己的标准差):
    MW 相对分子质量            每单位实际贡献 -0.00512
    logP 脂水分配系数          每单位实际贡献 -0.86152
HBD 氢键供体数 每单位实际贡献 -1.69277感知器在第 9 轮把 30 个分子全部分对,训练准确率 100%,混淆矩阵中没有任何错误。三个权重都是负的,含义是 MW、logP、HBD 越大越不像药物,这与规则的方向一致。但满分只说明这 30 个样本恰好能被一个平面分开,并不说明模型学会了规则本身。下面换一种方式检验。
1.5.3.3 用反事实样本检验
我们人为构造 3 个假想分子,让它们落在训练数据很少覆盖的区域,用规则本身给出“正确答案”,再看模型的判断。这种“如果分子是这样,结果会怎样”的样本称为反事实样本(counterfactual):
python
# ---------------- 反事实分子测试代码 ----------------
counterfactuals = [
    ("假想 A:小分子但强亲脂", 120.0, 6.5, 0),
    ("假想 B:大分子但极性好", 480.0, 1.0, 1),
    ("假想 C:两项接近阈值",   300.0, 4.5, 5),
]
print("【反事实样本检验】")
for name, mw, logp, hbd in counterfactuals:
    x = scaler.transform([[mw, logp, float(hbd)]])
    score = clf.decision_function(x)[0]
    truth = 1 if (mw <= 500 and logp <= 5 and hbd <= 5) else 0
    predicted = clf.predict(x)[0]
    flag = "   <-- 判错了" if predicted != truth else ""
    print(f"  {name:<22} MW={mw:>6.1f} logP={logp:>5.2f} HBD={hbd}  "
          f"判别值 {score:>+6.2f}  规则判定 {'类药' if truth else '非类药'},"
f"模型判 {'类药' if predicted else '非类药'}{flag}")比对输出如下(每行一个分子,真实运行结果):
text
【反事实样本检验】
  假想 A:小分子但强亲脂           MW= 120.0 logP= 6.50 HBD=0  判别值  +1.57  规则判定 非类药,模型判 类药   <-- 判错了
  假想 B:大分子但极性好           MW= 480.0 logP= 1.00 HBD=1  判别值  +2.77  规则判定 类药,模型判 类药
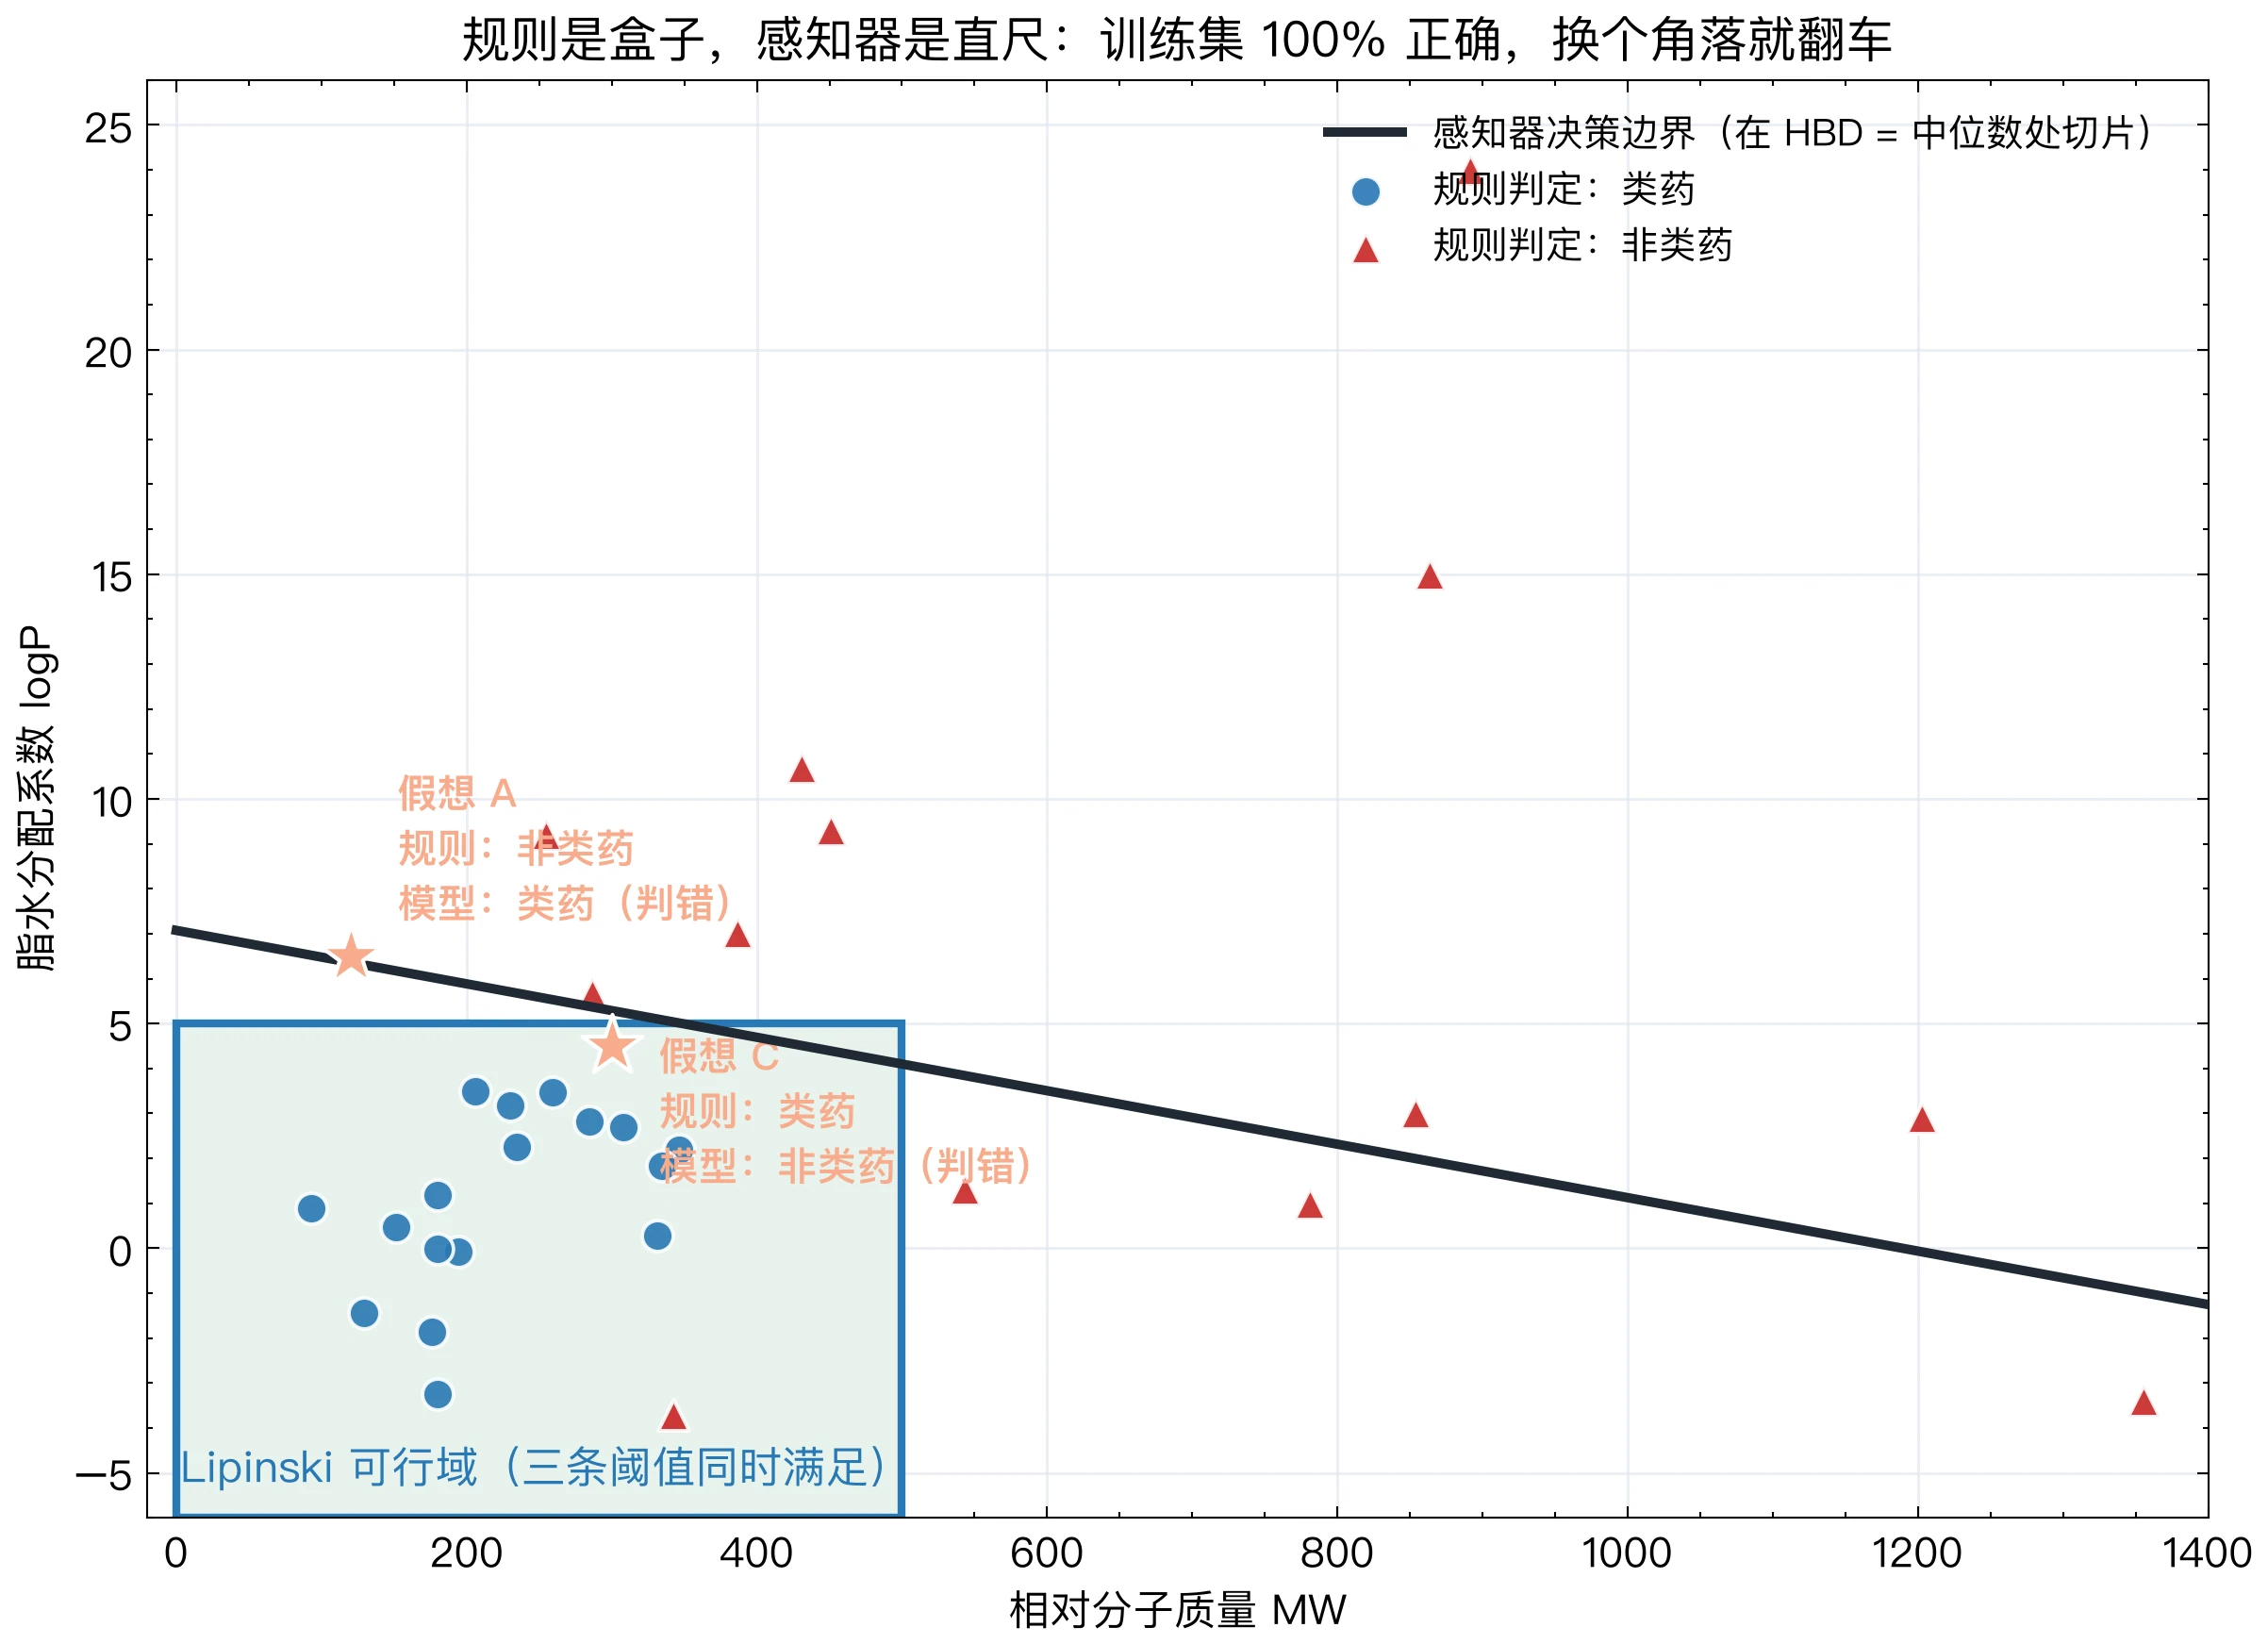
假想 C:两项接近阈值 MW= 300.0 logP= 4.50 HBD=5 判别值 -6.09 规则判定 类药,模型判 非类药 <-- 判错了3 个假想分子中,感知器判错了 A 和 C。图 21 从几何上解释了原因。
本案例的标签是三个单变量阈值条件的逻辑与(AND):
在特征空间中,满足式 (35) 的区域是三个半空间的交集,即一个各面分别垂直于坐标轴的盒状区域(只有上界)。单个超平面 无法精确表示这样的区域:它用一个倾斜的平面去近似盒子的三个面,在盒子的角落附近必然出现两类错误:
- 假阳性(分子 A):MW 很小(120),但 logP = 6.5 已经超标。线性模型把三个特征的贡献加在一起,MW 远低于平均水平带来的“加分”抵消了 logP 超标的“扣分”,于是判为类药。而规则不允许这种补偿:任何一条超标就不算类药。
- 假阴性(分子 C):三项都没有超标,但 logP(4.5)和 HBD(5)都接近阈值。两项各自的“扣分”累加起来超过了阈值,于是被判为非类药。而规则只要求每一项不超标,不关心它们离阈值有多近。
说得直白些:Lipinski 规则是“一票否决制”,每一项都必须达标;而感知器的 是“总分及格制”,一项很差可以被另一项的高分补回来。训练集之所以能达到 100% 准确率,是因为这 30 个真实分子恰好没有落在这些角落附近。这个案例说明:训练集甚至测试集上的高准确率,都不等于模型学到了真实的判别规则;有针对性地构造反事实样本,是发现这类结构性缺陷的有效办法。
1.5.3.4 换成 MLP 会怎样
单隐层 MLP 能表示多个半空间的组合(1.3.10 节),原则上可以表示盒状区域:用三个隐藏单元分别实现三条阈值,再在输出层做“与”运算即可。下面用 8 个 tanh 隐藏单元的 MLP 重新训练,并在同样的反事实样本上检验:
python
# ---------------- MLP 对照实验代码 ----------------
mlp = MLPClassifier(hidden_size=8, learning_rate=0.1, n_epochs=3000,
                    random_state=0).fit(Xs, y)
print("【对照实验】换成单隐层 MLP(8 个 tanh 神经元)")
print(f"  训练准确率 : {mlp.score(Xs, y):.3f}")
print(f"  损失下降   : {mlp.loss_history_[0]:.4f} -> {mlp.loss_history_[-1]:.4f}")
print("  在同样 3 个反事实样本上:")
for name, mw, logp, hbd in counterfactuals:
    x = scaler.transform([[mw, logp, float(hbd)]])
    truth = 1 if (mw <= 500 and logp <= 5 and hbd <= 5) else 0
    predicted = mlp.predict(x)[0]
    flag = "   <-- 判错了" if predicted != truth else ""
    print(f"    {name:<22} 规则判定 {'类药' if truth else '非类药'},"
f"MLP 判 {'类药' if predicted else '非类药'}{flag}")训练输出如下:
text
【对照实验】换成单隐层 MLP(8 个 tanh 神经元)
  训练准确率 : 1.000
  损失下降   : 0.9475 -> 0.0029
  在同样 3 个反事实样本上:
    假想 A:小分子但强亲脂           规则判定 非类药,MLP 判 类药   <-- 判错了
    假想 B:大分子但极性好           规则判定 类药,MLP 判 类药
假想 C:两项接近阈值 规则判定 类药,MLP 判 非类药 <-- 判错了MLP 同样达到了 100% 的训练准确率,交叉熵从 0.9475 降到 0.0029,但它在反事实样本 A 和 C 上犯了与感知器完全相同的错误。
这个结果初看令人意外,其实很好理解:MLP 能够表示盒状区域,但训练数据并没有“告诉”它边界应该在哪里。30 个训练分子都不在 A、C 所在的角落附近,只要把训练样本分对,弯曲的边界和倾斜的平面在训练集上都一样“好”,梯度下降没有理由偏向规则本身。换言之,模型的表示能力只是必要条件;要学到正确的边界,还需要训练数据覆盖边界附近的区域。在实际工作中,如果判据已知是几个阈值的组合(如本案例),直接写成规则,或者使用决策树这类天然产生轴对齐边界的模型,往往比感知器或 MLP 更合适。
1.5.4 案例三:带隙三分类
最后一个案例用 1.5.2 节的 65 个化合物,演示 1.3.9 节和 1.4.7 节的多分类方法。按带隙把化合物分成三类:窄带隙半导体( eV,14 个)、中等带隙半导体(1.5 eV ≤ < 3.5 eV,22 个)和绝缘体( eV,29 个)。注意这里绝缘体的界线是 3.5 eV,与 1.5.2 节二分类的 3.0 eV 不同,两处的类别不能直接对应。特征使用 、、 三个描述符。由于目的是比较几种多分类方法能否表示这三类的划分,全部样本都用于训练,下面报告的都是训练集准确率。
首先准备三分类标签和打印混淆矩阵的辅助函数(本节代码沿用 1.5.2 节定义的数据和函数):
python
# ===========================================================================
# 案例三:带隙三分类数据准备与评估辅助函数
# ===========================================================================

LABELS = ["窄带隙半导体", "中等带隙半导体", "绝缘体"]


def make_three_class(meta, thresholds=(1.5, 3.5)):
    y = []
    for m in meta:
        if m["gap"] < thresholds[0]:
            y.append(0)
        elif m["gap"] < thresholds[1]:
            y.append(1)
        else:
            y.append(2)
    return y


def _pad(text, width):
    """按显示宽度补齐空格(一个汉字占两个英文字符的宽度),让表格对齐。"""
    import unicodedata
    w = sum(2 if unicodedata.east_asian_width(ch) in "WF" else 1 for ch in text)
    return " " * max(0, width - w) + text


def print_confusion(y_true, y_pred):
    k = 3
    table = [[0] * k for _ in range(k)]
    for t, p in zip(y_true, y_pred):
        table[t][p] += 1
    print("  混淆矩阵(行 = 真实,列 = 预测)")
    print("  " + _pad("", 16) + "".join(_pad(LABELS[j], 16) for j in range(k)))
    for i in range(k):
        row = "".join(_pad(str(table[i][j]), 16) for j in range(k))
        print("  " + _pad(LABELS[i], 16) + row)


# ---------------- 准备数据 ----------------
X_all, _, meta = build_binary_dataset()
y = make_three_class(meta)
X = [[row[0], row[1], row[2]] for row in X_all]     # Δχ, n̄, χ̄

counts = [y.count(c) for c in range(3)]
print("=" * 76)
print(f"三分类任务:{len(y)} 个化合物,类别分布 "
      f"{ {LABELS[c]: counts[c] for c in range(3)} }")
print(f"特征:{FEATURE_NAMES[0]}, {FEATURE_NAMES[1]}, {FEATURE_NAMES[2]}")
print("=" * 76)

scaler = StandardScaler().fit(X)
Xs = scaler.transform(X)运行后打印出类别分布:
text
============================================================================
三分类任务:65 个化合物,类别分布 {'窄带隙半导体': 14, '中等带隙半导体': 22, '绝缘体': 29}
特征:Δχ 电负性差, n̄ 平均主量子数, χ̄ 平均电负性
============================================================================然后依次运行三种多分类方案:一对多(OvR)感知器、一对一(OvO)感知器,以及把 OvR 的基分类器换成单隐层 MLP:
python
# ---------------- 方法一:一对多(One-vs-Rest, OvR)----------------
ovr = OneVsRestClassifier().fit(Xs, y)
pred_ovr = ovr.predict(Xs)
acc_ovr = accuracy_score(y, pred_ovr)
print("【方法一】一对多(OvR)        训练准确率 :", f"{acc_ovr:.3f}")
print("  各二分类器的权重(标准化空间):")
for c in range(3):
    model = ovr.models_[c]
    w = "  ".join(f"{wi:+.2f}·{n.split()[0]}"
                  for wi, n in zip(model.coef_, FEATURE_NAMES[:3]))
    print(f"    {_pad(LABELS[c], 14)}  {w}  {model.intercept_:+.2f} = 0   (跑满 {model.n_iter_} 轮)")
print_confusion(y, pred_ovr)

# ---------------- 方法二:一对一(One-vs-One, OvO)----------------
pairs = [(0, 1), (1, 2), (0, 2)]
votes = [[0] * 3 for _ in range(len(X))]
for a, b in pairs:
    idx = [i for i in range(len(X)) if y[i] in (a, b)]
    sub_X = [Xs[i] for i in idx]
    sub_y = [y[i] for i in idx]
    m = Perceptron(n_epochs=200, random_state=0).fit(sub_X, sub_y)
    for i in range(len(X)):
        winner = m.predict([Xs[i]])[0]
        votes[i][winner] += 1
pred_ovo = [max(range(3), key=lambda c: votes[i][c]) for i in range(len(X))]
print(f"\n【方法二】一对一(OvO)        训练准确率 : {accuracy_score(y, pred_ovo):.3f}")
print_confusion(y, pred_ovo)

# ---------------- 方法三:单隐层 MLP 一对多 ----------------
mlp_ovr = OneVsRestClassifier(base_estimator_factory=lambda: MLPClassifier(
    hidden_size=16, learning_rate=0.1, n_epochs=1500, random_state=0))
mlp_ovr.fit(Xs, y)
print(f"\n【方法三】把基分类器换成 MLP 训练准确率 : {mlp_ovr.score(Xs, y):.3f}")运行输出如下:
text
【方法一】一对多(OvR)        训练准确率 : 0.692
  各二分类器的权重(标准化空间):
      窄带隙半导体  -3.47·Δχ  +0.69·n̄  +1.31·χ̄  -3.00 = 0   (跑满 100 轮)
    中等带隙半导体  -2.58·Δχ  -0.80·n̄  +0.63·χ̄  +0.00 = 0   (跑满 100 轮)
            绝缘体  +3.54·Δχ  -1.19·n̄  -1.38·χ̄  -1.00 = 0   (跑满 100 轮)
  混淆矩阵(行 = 真实,列 = 预测)
                      窄带隙半导体  中等带隙半导体          绝缘体
      窄带隙半导体               3              11               0
    中等带隙半导体               1              18               3
            绝缘体               0               5              24

【方法二】一对一(OvO)        训练准确率 : 0.662
  混淆矩阵(行 = 真实,列 = 预测)
                      窄带隙半导体  中等带隙半导体          绝缘体
      窄带隙半导体               7               7               0
    中等带隙半导体               4              12               6
            绝缘体               4               1              24

【方法三】把基分类器换成 MLP 训练准确率 : 0.923先看一对多(OvR)的结果。训练准确率为 0.692,混淆矩阵显示错误主要集中在相邻类别之间:14 个窄带隙半导体中有 11 个被判为中等带隙,22 个中等带隙半导体中有 1 个被判为窄带隙、3 个被判为绝缘体,29 个绝缘体中有 5 个被判为中等带隙;窄带隙与绝缘体之间没有互相混淆。再看三个分类器中 的权重:窄带隙为 ,中等带隙为 ,绝缘体为 ,由负变正。这说明三类样本大致沿“离子性”这一个方向依次排开,带隙越大的类别, 越大。
这也解释了为什么中间类别最难处理:中等带隙半导体夹在另外两类之间,“中等带隙 / 其余”这个二分类问题要求用一个平面把位于中间的一类与两侧的样本分开,即使三类样本沿离子性方向排得很整齐,单个超平面也做不到。输出显示三个分类器都跑满了 100 轮,没有一个收敛,所以它们的得分都来自振荡中的某个状态,按 1.4.7 节的提醒,比较这些得分时要格外小心。
一对一(OvO)的训练准确率更低,为 0.662。混淆矩阵中有 4 个绝缘体被判为窄带隙半导体,这种“跨级”错误在 OvR 中没有出现。原因在投票规则:三个类别两两比较共有三场“比赛”,如果每个类别各赢一场,三类各得 1 票,代码中的 max 会选择编号最小的类别,即窄带隙半导体。作者统计过,65 个样本中有 9 个出现这种平票,全部被归为窄带隙,其中包括 BN、SiO₂、SnO₂、NiO 四个绝缘体。实际使用 OvO 时,应当用各分类器的判别得分来打破平票,而不是依赖默认的类别顺序。
把基分类器换成 MLP 后,训练准确率提高到 0.923,说明非线性边界能够更好地拟合这三类的划分,特别是夹在中间的类别。但这是训练集准确率,案例一的实验五已经提醒我们,训练集上的提升不一定能转化为新样本上的提升。
从这个案例还可以得到一个启示:当前特征的区分信息主要集中在离子性这一个方向上,继续加入与电负性类似的描述符,可能难以明显改善结果;更有效的办法是引入与离子性无关的结构和电子特征,例如配位数、结构容忍因子、d 电子排布等。
1.5.5 怎样解读感知器的权重
线性模型的一大优点是可以直接查看权重:权重的符号表示某个描述符把样本推向哪一类,大小表示推动的强弱。但这种解读有前提条件,本节结合前面的实验加以说明。
第一,只有标准化之后,权重的大小才能相互比较。 标准化后, 表示第 个特征变化一个标准差时判别得分的变化量。如果不标准化,权重的大小与特征的单位有关:把相对分子质量的单位从 Da 换成 kDa,对应的权重就会放大 1000 倍,而模型的预测完全不变。
第二,感知器的解不唯一,权重的大小可能很不稳定。 1.3.6 节说过,线性可分时能把训练集分对的超平面有无穷多个。下面用实验二中线性可分的 46 个化合物验证这一点:只改变随机种子(即样本的遍历顺序),重复训练 20 次,看权重如何变化。
python
# ---------------- 权重随随机种子的变化(沿用 1.5.2 节的数据与函数)----------------
keep = main_group_indices(meta)
Xmg, ymg = [X2[i] for i in keep], [y_all[i] for i in keep]
Xmg_s = StandardScaler().fit_transform(Xmg)

pos_chi, neg_n, ratios = 0, 0, []
for seed in range(20):
    m = Perceptron(n_epochs=200, random_state=seed).fit(Xmg_s, ymg)
    w_chi, w_n = m.coef_
    pos_chi += w_chi > 0
    neg_n += w_n < 0
    ratios.append(abs(w_chi / w_n))
ratios.sort()
print("【权重稳定性】46 个不含 d 区元素的化合物,20 个随机种子,每次都收敛到训练误差 0")
print(f"  Δχ 权重为正的次数:{pos_chi}/20;n̄ 权重为负的次数:{neg_n}/20")
print(f" |w_Δχ / w_n̄| 最小 {ratios[0]:.1f},中位数 {(ratios[9] + ratios[10]) / 2:.1f},最大 {ratios[-1]:.1f}")运行输出如下:
text
【权重稳定性】46 个不含 d 区元素的化合物,20 个随机种子,每次都收敛到训练误差 0
  Δχ 权重为正的次数:20/20;n̄ 权重为负的次数:20/20
|w_Δχ / w_n̄| 最小 3.3,中位数 5.3,最大 75.120 次训练都把这 46 个样本全部分对,两个权重的符号也始终不变: 为正, 为负。但两者的比值从 3 多变到 70 多,相差 20 倍以上。如果只看其中一次结果,我们可能得出“离子性的影响是主量子数的 3 倍”,也可能得出“是 70 倍”,两个结论都不可靠。这组数据能支持的只是:在这批化合物中, 增大倾向于绝缘体, 增大倾向于半导体,而且 的作用更明显。
由此可以总结出解读权重时需要注意的几点:
- 相关不等于因果。 权重反映的是特征与标签之间的统计关联。特征之间存在相关性时,某个特征权重大,可能只是因为它与一个没有纳入模型的关键变量相关。
- 权重取决于特征集合。 增加或删除一个特征,其余特征的权重都可能随之改变。
- 权重取决于训练过程。 对感知器这种解不唯一的模型,权重的大小随样本顺序变化;数据线性不可分时,权重还取决于训练停在振荡的哪个时刻。报告结果时,应当给出多次训练或多次划分下的均值与波动范围,而不是挑选某一次的结果。如果需要稳定、可比较的权重,应改用有唯一解的模型,例如带正则化的逻辑回归或线性 SVM(附录 A.1)。
1.5.6 感知器在研究流程中的位置
图 22 示意了化学与材料机器学习研究的典型流程。
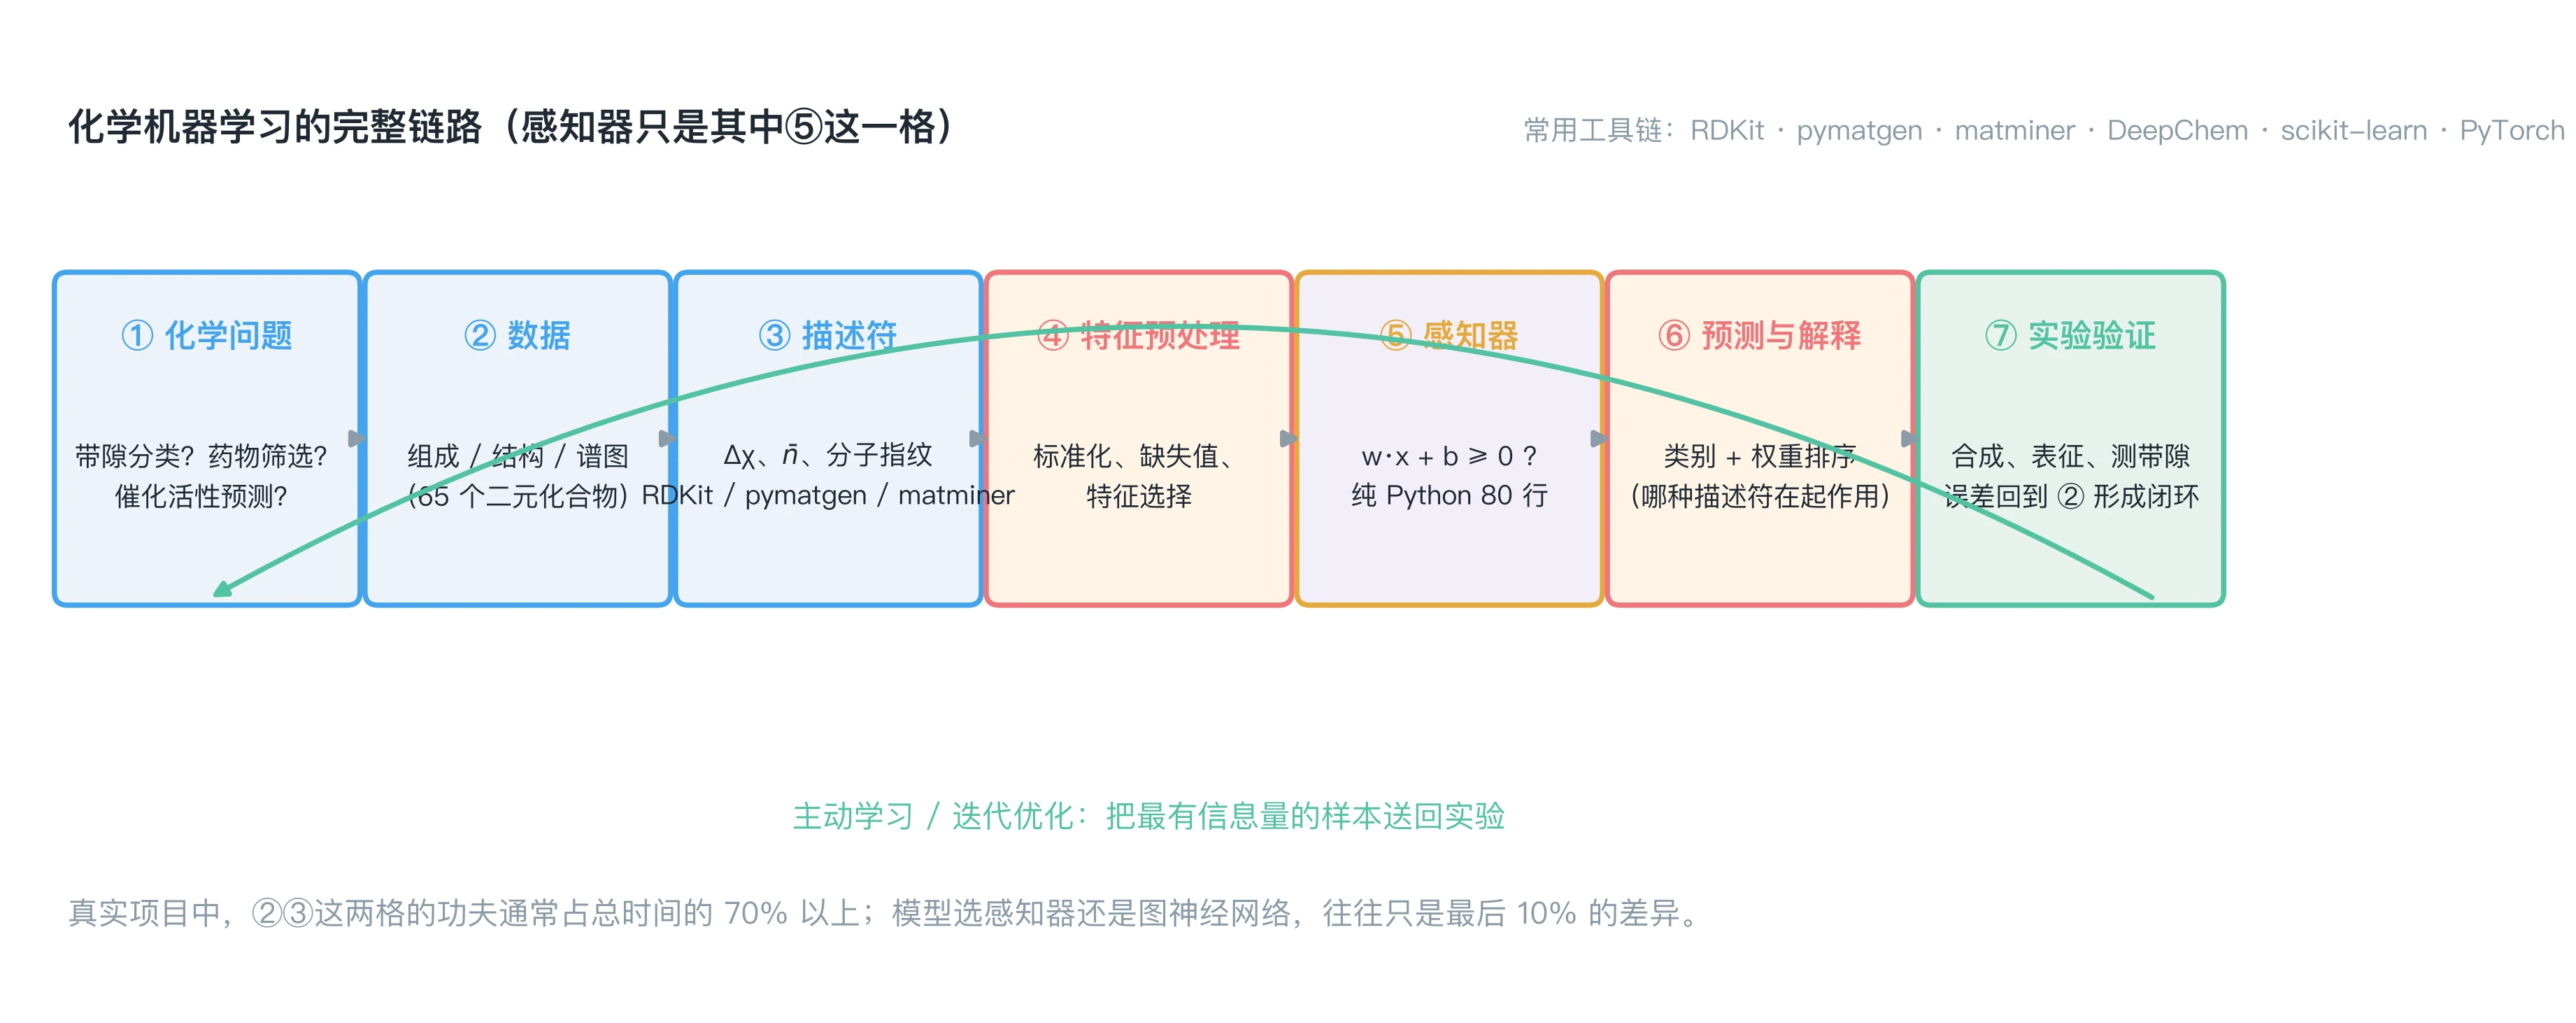
在实际研究中,数据清洗、特征构建和数据划分往往占用了大部分精力,而模型的选择应当建立在与简单基线的对比之上。本章的三个案例说明了基线的作用:在案例一中,口袋感知器与 MLP 的测试准确率几乎相同,说明在当前特征下,复杂模型并没有带来实质收益。
流程中尤其需要注意数据划分方式。对分子或晶体数据,简单的随机划分容易让同一母核的同系物同时出现在训练集和测试集中,模型只要“记住”相似的结构就能在测试集上得高分,泛化能力因而被高估 [26]。应当根据要回答的科学问题选择划分方式,例如按分子骨架划分(scaffold split),或按化学组成聚类后再划分,以更真实地评估模型对新化学空间的预测能力。第 00 章对这些划分方式有更详细的讨论。
1.5.7 什么时候应该换用更复杂的模型
当任务具有表 7 所列的特点时,线性分类器通常不够用,应当考虑相应的进阶方法。
表 7 线性分类器的局限与可选的进阶方法。最后一列中的多数方法将在本系列后续章节中陆续介绍。
| 任务与数据特点 | 线性分类器的局限 | 可考虑的方法 |
|---|---|---|
| 输入是分子图或晶体结构 | 原子数和连接方式各不相同,很难无损地转换为固定长度的向量 | 图神经网络(GNN)、消息传递神经网络(MPNN) |
| 需要利用三维几何结构 | 能量在旋转、平移下应保持不变,力应随之旋转,线性模型难以保证 | 不变或等变的图神经网络(如 SchNet、PaiNN、MACE) |
| 输入是谱图或图像 | 信号具有局部相关性,同一特征可能出现在不同位置 | 卷积神经网络(CNN)、视觉 Transformer |
| 数据量很大(如 个样本) | 单个超平面的容量有限,数据多时容易欠拟合 | 深度神经网络、预训练模型 |
| 性质与描述符呈非单调关系 | 一个超平面无法表示火山型曲线这样先升后降的关系 | 梯度提升树(如 XGBoost、LightGBM)、MLP |
| 需要生成新分子或新材料 | 感知器是判别模型,只能判断类别,不能生成新结构 | 变分自编码器(VAE)、扩散模型、自回归生成模型 |
| 需要高精度的电子结构信息 | 统计模型不能代替量子力学计算 | 密度泛函理论(DFT)、耦合簇方法(如 CCSD(T)) |
表中 SchNet 对旋转、平移是不变的(invariant),PaiNN、MACE 则是等变的(equivariant)。即使在深度学习广泛应用的今天,先建立一个简单、可解释的线性基线,仍然是建模工作中重要的第一步:它为判断复杂模型带来多少额外收益提供了参照。
1.6 优缺点与方法对比
1.6.1 优点
- 有理论保证。 数据线性可分时,Novikoff 定理保证感知器在有限步内收敛,而且几乎不需要调节超参数。
- 计算量小,实现简单。 每次更新只需 次乘加运算;在本章几十个样本的数据上,纯 Python 实现的训练也只需毫秒量级,适合快速试验和反复的交叉验证。
- 便于初步解读。 特征标准化后,权重的符号可以与化学知识相互印证(1.5.2 节、1.5.5 节)。但权重的大小可能随训练过程大幅变化,不宜过度解读。
- 天然支持在线学习。 感知器逐个样本更新,内存占用很小,适合数据不断到来的场景,例如实验过程中的实时监测。
1.6.2 缺点
- 只能表示线性边界。 无法表示 XOR 型判据、多个阈值的组合(1.5.3 节)或火山型这样非单调的关系。
- 不输出概率。 只给出类别,不给出“有多大把握”,难以直接用于需要不确定性估计的任务,例如贝叶斯优化或主动学习。
- 解不唯一,结果依赖样本顺序。 可分时得到的超平面取决于初始值和样本顺序,间隔可能很小;不可分时权重持续振荡,必须配合口袋算法等办法。
- 对噪声和离群点敏感。 一个标错的样本就可能使数据变得不可分,导致训练持续振荡。
- 依赖特征工程。 对特征尺度敏感,需要标准化;也不能自动发现特征之间的组合效应,交叉项等需要人为构造(1.4.9 节)。
1.6.3 与其他分类模型的比较
表 8 从几个方面比较了感知器与其他常用分类模型。表中的描述是一般规律的概括,不是本章的实验结果。
表 8 感知器与其他常用分类模型的比较。“训练开销”指本章这种规模(几十到几百个样本)的数据上的大致量级。
| 比较项目 | 感知器 | 逻辑回归 | 线性 SVM | 多层感知器(MLP) | 随机森林 | 图神经网络(GNN) |
|---|---|---|---|---|---|---|
| 决策边界 | 超平面 | 超平面 | 间隔最大的超平面 | 非线性曲面 | 与坐标轴平行的分段边界 | 非线性,依赖图结构 |
| 输出 | 类别 | 概率(通常需要检验校准程度) | 判别得分(可后处理为概率) | 概率 | 类别比例(可作为概率估计) | 依任务而定 |
| 损失函数 | 感知器损失 | 交叉熵(对数损失) | 合页损失 + 正则项 | 交叉熵或均方误差 | 按基尼不纯度或信息增益分裂 | 依任务而定 |
| 优化方式 | 逐样本纠错更新 | 凸优化(如 L-BFGS、牛顿法) | 凸二次规划或坐标下降 | 非凸,反向传播 + SGD/Adam | 贪心分裂 + 自助采样 | 反向传播 + SGD/Adam |
| 对特征尺度 | 敏感(需标准化) | 敏感(需标准化) | 敏感(需标准化) | 敏感(需标准化) | 不敏感 | 敏感(需归一化) |
| 主要超参数 | 很少(轮数;学习率通常无影响) | 少(正则化强度) | 少(惩罚系数 ;核 SVM 还有核参数) | 较多(层数、宽度、学习率等) | 中等(树数、深度等) | 很多(层数、聚合方式等) |
| 可解释性 | 中等(权重符号可读,但解不唯一) | 较高(权重对应对数几率的变化) | 中等 | 较低 | 中等(特征重要性、树规则) | 较低(需借助专门的解释方法) |
| 小样本表现 | 一般,波动较大 | 通常较稳健 | 通常较稳健 | 容易过拟合 | 通常较稳健 | 数据太少时难以训练 |
| 训练开销 | 毫秒级 | 毫秒级 | 毫秒至秒级 | 秒级 | 毫秒至秒级 | 分钟至小时级 |
1.6.4 感知器训练中的典型现象与诊断
表 9 把本章遇到的几种现象整理成“现象—常见误判—原因—诊断与对策”的形式,便于在自己的数据上对照排查。表中的阈值(如方差比 )只是经验参考值。
表 9 感知器训练中的典型现象与诊断。
| 现象 | 常见误判 | 原因 | 诊断与对策 |
|---|---|---|---|
| 特征尺度相差悬殊时收敛很慢 | 以为数据线性不可分 | 更新方向被数值最大的特征主导, 变大,收敛所需的更新次数增加(1.3.5 节) | 检查各特征的方差(例如最大与最小方差之比超过 );用训练集统计量做标准化(1.4.4 节) |
| 误分类数长期在一个范围内波动 | 以为学习率太大,不断调小 | 数据线性不可分;零初始化时 只缩放权重,调小它不会改变结果(1.3.7 节) | 用线性规划检验可分性(附录 A.3);改用口袋算法;构造交叉项或使用核方法、MLP(1.4.9 节) |
| 换一个随机种子,权重和测试结果变化很大 | 以为代码有 bug | 解不唯一,且感知器一旦分对就停止;不可分时停在振荡中的任意状态(1.3.6 节、1.5.5 节) | 报告多次划分的均值与标准差(1.5.2.6 节);需要稳定的解时改用正则化逻辑回归或线性 SVM |
| 类别极不平衡时准确率很高 | 以为模型筛选成功 | 少数类样本太少,模型几乎总是预测多数类也能得到高准确率 | 同时查看混淆矩阵、少数类召回率、平衡准确率和马修斯相关系数(MCC);对少数类加权 |
| 在新的化学体系上大量出错 | 以为训练样本不够,继续扩充同类数据 | 待预测样本落在训练分布之外,描述符不包含决定新体系性质的物理量(1.5.2.3–1.5.2.4 节) | 检查新样本是否在训练数据覆盖的范围内(适用域检验);为新体系补充相应的描述符 |
1.6.5 常见陷阱
除了感知器特有的问题,把机器学习用于化学研究时,还有一些普遍的陷阱。下面 10 条在第 00 章和本章中都有体现:
- 不做特征标准化。 不同量纲的特征数值相差几个数量级时,更新几乎完全由数值大的特征主导,权重也无法相互比较。
- 在划分数据之前做标准化。 用全部样本计算均值和标准差,测试集的信息就泄漏到了训练过程中,评估结果偏乐观 [27]。
- 对同系物数据使用纯随机划分。 母核相近的分子同时出现在训练集和测试集中,会高估泛化能力;应考虑骨架划分或按组成聚类划分 [26]。
- 只用一次随机划分报告结果。 小样本上不同划分之间的波动很大,应报告多次划分的均值与标准差。
- 类别不平衡时只看准确率。 如果 90% 的样本属于同一类,总是预测这一类也有 90% 的准确率;应同时查看混淆矩阵、F1 分数和 MCC。
- 把训练集满分当作泛化良好。 线性可分的数据、或特征维数接近样本数时,训练集很容易全部分对;泛化能力只能用没参与训练的数据检验(1.5.3 节)。
- 特征中暗含了标签信息。 例如用与带隙直接相关的测量量(如电导率)作为预测带隙的特征,造成循环论证。
- 把权重直接当作因果机制。 特征之间常有相关性,某个特征权重大,可能只是因为它代表了某个未纳入模型的关键变量;因果结论需要实验或第一性原理计算来验证(1.5.5 节)。
- 混合测试条件不同的数据。 来自不同文献的数据,若测试温度、压力或晶相不同,模型可能把系统偏差误当作规律。
- 超出适用范围外推。 模型在训练数据覆盖的范围内比较可靠,外推到没见过的化学空间时可能严重出错(1.5.2.3 节);使用前应检查新样本与训练数据的距离,例如在主成分空间中计算马氏距离,距离过大(如超过 3,经验值)时给出警告。
1.7 小结与下一章预告
本章从一个最简单的模型出发,建立了后续章节反复用到的几个概念:
- 感知器用超平面 把特征空间分成两半, 是法向量, 决定位置(第 1.2 节);
- 它的学习规则是“分错一个就修正一次”,数据线性可分时保证在有限步内收敛,不可分时持续振荡(第 1.3 节);
- 口袋算法、核方法、多分类包装器和多层感知器分别从“保留最好的解”“换相似度”“拆成多个二分类问题”“叠加非线性层”四个方向弥补它的不足(第 1.3、1.4 节);
- 在化学数据上,训练不收敛往往提示特征缺少关键信息;训练集满分并不保证学到了正确的规则;权重的符号比大小更可靠(第 1.5 节)。
感知器的阶跃函数也留下了一个问题:它在 处不可导,在其他地方导数为零,所以无法用梯度来指导参数的调整,也无法把多层网络连起来训练。后续章节将沿着下面的顺序解决这个问题:
- 第 2 章 线性单元与梯度下降。 去掉阶跃函数,直接用连续的输出 与目标值之间的均方误差作为损失,得到 Widrow 与 Hoff 的自适应线性单元(Adaline)和最小均方(LMS)规则 [6]。我们将推导梯度下降的收敛条件:学习率需要满足 ,其中 是损失函数 Hessian 矩阵的最大特征值。与感知器不同,那时学习率的大小将真正影响训练结果。
- 第 3 章 神经网络与反向传播。 用 sigmoid、tanh、ReLU 等可导的非线性激活函数构造多层网络,系统推导反向传播算法,并讨论通用逼近定理的含义与局限,从而真正解决本章 1.3.10 节提出的 XOR 问题。
- 更后面的章节。 把同样的“线性变换 + 非线性激活”的思路推广到分子图和晶体结构上,构造在旋转、平移等对称操作下保持不变或等变的网络。
1.8 参考文献与延伸阅读
原始文献
Rosenblatt, F. The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review, 65(6), 386–408, 1958.
—— 感知器的原始论文。Novikoff, A. On Convergence Proofs for Perceptrons. Proceedings of the Symposium on Mathematical Theory of Automata, 12, 615–622, 1962.
—— 感知器收敛定理的出处。本章 1.3.5 节的证明采用了现代教材中常见的写法。Minsky, M., & Papert, S. Perceptrons: An Introduction to Computational Geometry. MIT Press, 1969.
—— 系统分析单层感知器能够表示和不能表示的判别规则(如奇偶性、连通性)的经典著作(1988 年出版了扩充版)。Cybenko, G. Approximation by Superpositions of a Sigmoidal Function. Mathematics of Control, Signals and Systems, 2(4), 303–314, 1989.
—— 单隐层前馈网络的通用逼近定理(Sigmoid 激活)。Gallant, S. I. Perceptron-based learning algorithms. IEEE Transactions on Neural Networks, 1(2), 179–191, 1990.
—— 口袋算法(Pocket Algorithm)的出处。Widrow, B., & Hoff, M. E. Adaptive switching circuits. IRE WESCON Convention Record, Part 4, 96–104, 1960.
—— Adaline 与 LMS 算法的原始文献。Hornik, K. Approximation capabilities of multilayer feedforward networks. Neural Networks, 4(2), 251–257, 1991.
—— 通用逼近定理的推广(不依赖具体激活函数)。Hammett, L. P. The effect of structure upon the reactions of organic compounds. Benzene derivatives. Journal of the American Chemical Society, 59(1), 96–103, 1937.
—— Hammett 方程的原始文献。Lipinski, C. A., Lombardo, F., Dominy, B. W., & Feeney, P. J. Experimental and computational approaches to estimate solubility and permeability in drug discovery and development settings. Advanced Drug Delivery Reviews, 23(1–3), 3–25, 1997.
—— Lipinski 五规则的出处。Zaanen, J., Sawatzky, G. A., & Allen, J. W. Band gaps and electronic structure of transition-metal compounds. Physical Review Letters, 55(4), 418–421, 1985.
—— 过渡金属化合物的 Mott–Hubbard 与电荷转移型分类(ZSA 方案)。
经典机器学习教材
Bishop, C. M. Pattern Recognition and Machine Learning. Springer, 2006.
—— 模式识别与机器学习教材;第 4 章讲线性分类模型,第 5 章讲神经网络。Hastie, T., Tibshirani, R., & Friedman, J. The Elements of Statistical Learning: Data Mining, Inference, and Prediction. Springer, 2nd ed., 2009.
—— 统计学习教材;第 4 章讲线性分类与分离超平面,作者网站提供免费电子版。Goodfellow, I., Bengio, Y., & Courville, A. Deep Learning. MIT Press, 2016.
—— 深度学习教材(常称“花书”);第 6 章介绍前馈网络与反向传播。
化学信息学与材料信息学
Leach, A. R., & Gillet, V. J. An Introduction to Chemoinformatics. Springer, 2007.
—— 化学信息学入门教材,涉及描述符与 QSAR 建模。Hansch, C., & Fujita, T. ρ-σ-π Analysis. A Method for the Correlation of Biological Activity and Chemical Structure. Journal of the American Chemical Society, 86(8), 1616–1626, 1964.
—— Hansch 方程(本章 1.1.2 节)的出处。Hansch, C., Maloney, P. P., Fujita, T., & Muir, R. M. Correlation of Biological Activity of Phenoxyacetic Acids with Hammett Substituent Constants and Partition Coefficients. Nature, 194, 178–180, 1962.
—— Hansch 方法的早期论文,把 Hammett 常数与分配系数用于线性构效关系。Ramakrishnan, R., Dral, P. O., Rupp, M., & von Lilienfeld, O. A. Quantum Chemistry Structures and Properties of 134 Kilo Molecules (QM9). Scientific Data, 1, 140022, 2014.
—— QM9 数据集的发布论文(约 13.4 万个小分子的量子化学性质),分子机器学习中常用的公开数据集。Schmidt, J., Marques, M. R. G., Botti, S., & Marques, M. A. L. Recent Advances and Applications of Machine Learning in Solid-State Materials Science. npj Computational Materials, 5, 83, 2019.
—— 固体材料中机器学习应用的综述。Butler, K. T., Davies, D. W., Cartwright, H., Isayev, O., & Walsh, A. Machine Learning for Molecular and Materials Science. Nature, 559, 547–555, 2018.
—— 分子与材料科学中机器学习方法的综述。
常用开源工具与数据库
RDKit: Open-Source Cheminformatics Software: https://www.rdkit.org/
—— 常用的开源化学信息学工具包,可计算分子指纹与描述符。本章代码没有使用它。pymatgen (Python Materials Genomics): https://pymatgen.org/
—— 常用的材料分析 Python 库(晶体结构、相图等)。本章代码没有使用它。matminer: https://hackingmaterials.lbl.gov/matminer/
—— 用于从材料数据中批量生成描述符的 Python 库。本章代码没有使用它。DeepChem: https://deepchem.io/
—— 面向化学、材料与生命科学的开源机器学习库。本章代码没有使用它。The Materials Project: https://materialsproject.org/
—— 基于第一性原理计算的材料性质数据库,免费开放。ChEMBL: https://www.ebi.ac.uk/chembl/
—— 欧洲生物信息学研究所(EMBL-EBI)维护的小分子生物活性数据库。
方法学:评估与数据泄漏
Wallach, I., & Heifets, A. Most Ligand-Based Classification Benchmarks Reward Overfitting and Loss of Chemical Validity, with Lessons for the Coming Era of Deep Learning. Journal of Chemical Information and Modeling, 58(5), 916–932, 2018.
—— 指出一些配体分类基准会奖励过拟合,提醒读者注意训练集与测试集之间的相似性。Kapoor, S., & Narayanan, A. Leakage and the Reproducibility Crisis in Machine-Learning-Based Science. Patterns, 4(9), 100804, 2023.
—— 对多个学科中基于机器学习的论文所存在的数据泄漏问题的综述。
其他原始文献
McCulloch, W. S., & Pitts, W. A logical calculus of the ideas immanent in nervous activity. Bulletin of Mathematical Biophysics, 5, 115–133, 1943.
—— 阈值神经元模型的原始论文。Aizerman, M. A., Braverman, E. M., & Rozonoer, L. I. Theoretical foundations of the potential function method in pattern recognition learning. Automation and Remote Control, 25, 821–837, 1964.
—— 势函数方法,核感知器思想的早期来源。Rumelhart, D. E., Hinton, G. E., & Williams, R. J. Learning representations by back-propagating errors. Nature, 323, 533–536, 1986.
—— 推广反向传播算法的经典论文。Freund, Y., & Schapire, R. E. Large margin classification using the perceptron algorithm. Machine Learning, 37(3), 277–296, 1999.
—— 分析了感知器的对偶(核)形式及其泛化性质。Phillips, J. C. Ionicity of the chemical bond in crystals. Reviews of Modern Physics, 42(3), 317–356, 1970.
—— 晶体化学键离子性与带隙关系的 Phillips–Van Vechten 理论综述。
附录 A:数学补充
A.1 感知器损失与合页损失
本附录比较感知器损失(式 (11))与线性支持向量机(SVM)使用的合页损失(hinge loss):
两者的区别主要有两点:
对“刚好分对”的样本的处理。
- 感知器损失只惩罚分错的样本(集合 )。只要 ,即使样本紧贴分界面,损失也是 0。
- 合页损失要求函数间隔至少为 1。不仅分错的样本受罚, 的样本虽然分对了,也要承担损失。函数间隔可以通过放大 和 任意增大,所以这个要求本身没有意义;只有与下面的正则项结合,才相当于要求几何间隔不小于 。
解是否唯一。
- 感知器损失在可分数据上有无穷多个使 的解(包括平凡解 ,见 1.3.1 节),最终停在哪里由初始值和样本顺序决定。
- 线性 SVM 在合页损失上加入 正则项 ,构成凸优化问题,目标函数对 是严格凸的,所以最优的 唯一。可分数据上,当正则化足够弱时,它给出的就是几何间隔最大的超平面。间隔大的超平面对样本的小扰动不那么敏感,这也是 SVM 在小样本、有噪声的数据上往往比感知器更稳定的原因之一。
A.2 核函数与隐式特征映射
以二维输入的二次齐次多项式核为例,看核函数如何对应一个显式的特征映射。设 、,则
这恰好是两个三维向量的内积:
即 。在原始的二维空间中计算一次点积再平方,结果等于先映射到三维空间再做内积。其中 正是 1.4.9 节手工加入的交叉项(相差一个常数因子)。
一般地, 维输入的 次齐次多项式核对应的特征空间维数为 ;带常数项的多项式核 ()包含所有不超过 次的单项式,维数为 。维数随 和 迅速增长,而直接计算核函数只需 次运算。高斯 RBF 核则对应无穷维的特征空间(可以把指数函数做泰勒展开来理解)。
什么样的函数可以作为核函数?Mercer 定理给出的条件是: 对称,并且对任意有限个样本,由 组成的 Gram 矩阵都是半正定的。满足这一条件时,一定存在某个特征映射 使 ,核感知器和 SVM 才有明确的几何意义;对 SVM 来说,这也保证了训练问题是凸的。不满足这一条件的“相似度”(例如 1.3.8 节提到的由 RMSD 构造的相似度)直接用作核函数时,这些性质就不再成立。
A.3 怎样判断数据是否线性可分
1.5.2.2 节提到,“感知器 100 轮没有收敛”只是线性不可分的线索,不是证明。严格的判断可以转化为一个线性规划问题:数据线性可分,当且仅当存在 使所有样本满足
(若某组参数使所有函数间隔都大于 0,把它乘以一个足够大的正数,就能使所有函数间隔都不小于 1。)式 (40) 是关于 的一组线性不等式,判断它是否有解就是一个线性规划的可行性问题。下面的函数用 SciPy 的 linprog 求解,这是本章唯一需要第三方库的代码:
python
import numpy as np
from scipy.optimize import linprog

def is_linearly_separable(X, y):
    """y 为任意两类标签;返回 True 表示存在把两类严格分开的超平面。"""
    X = np.asarray(X, dtype=float)
    labels = sorted(set(y))
    s = np.where(np.asarray(y) == labels[1], 1.0, -1.0)
    A = -(s[:, None] * np.hstack([X, np.ones((len(X), 1))]))   # -y_i [x_i, 1]·[w, b] <= -1
    res = linprog(np.zeros(X.shape[1] + 1), A_ub=A, b_ub=-np.ones(len(X)),
                  bounds=[(None, None)] * (X.shape[1] + 1))
return res.status == 0 # 0:找到可行解;2:不可行作者用这个函数检验了 1.5.2 节的数据:实验一的 45 个训练样本在 平面上线性不可分;全部 65 个化合物在四个描述符下也线性不可分;实验二中不含 d 区元素的 46 个化合物线性可分。这与感知器的表现一致。
没有 SciPy 时,也可以借助以下经验做法粗略判断,但它们都不是严格的证明:
- 看误分类数曲线。 若误分类数在若干轮后降到 0,数据一定线性可分;若长期在某个正数附近波动,数据很可能不可分,但也可能只是 很大、需要更多轮。
- 看口袋算法的最低训练误差。 若充分迭代后口袋中的最低错误率很低(如低于 5%),说明数据接近线性可分,少数错分样本可能是噪声或特殊情况,值得逐个检查;若错误率始终很高(如高于 20%),说明线性模型不适合当前的特征,需要补充特征或使用非线性模型。
- 看不同随机种子下的权重方向。 1.5.5 节显示,即使数据线性可分,不同种子得到的权重大小也可能相差很大,所以这一条只能参考权重的符号是否稳定;若连符号都随种子变化,说明该特征对分类的贡献不明确。