Appearance
第 04 章 卷积神经网络(CNN)
4.0 本章导读
4.0.1 从全连接网络说起
上一章,我们把一个样本写成一组数 ,交给多层感知机(MLP)完成分类或回归。例如,用若干分子描述符预测一种性质时,每个数代表什么,由描述符的定义决定。我们还用链式法则说明了网络怎样通过反向传播调整权重。
现在把输入换成一条红外光谱。它同样可以存成一组数,但这些数的排列顺序有了特别的意义:相邻的数对应相邻的波数,连在一起才构成峰形。阅读谱图时,我们会把一段曲线放在一起看,比较峰的位置、宽度、强度,以及附近是否还有其他峰。
显微图像也是如此。一个像素只记录一个位置的数值,把周围的像素一起考虑,才能描述边缘、条纹和颗粒轮廓。等间隔采样的谱线是一维数组,SEM、TEM 和光学金相照片是二维像素阵列,DFT 计算得到的电子密度还可以存成三维体素数组。这些数据都排列在规则网格上,相邻位置之间的关系值得利用。
把这些数据展平成向量后,仍然可以使用全连接网络。不过,全连接层没有专门规定哪些相邻位置应该一起处理,也没有规定同一种局部图样换个位置后应沿用原来的识别规则。输入很大时,它还会引入大量参数。下一节将具体计算这个差别。
卷积神经网络(Convolutional Neural Network, CNN)在这里做了两项安排:每次只处理一小段谱线或一小块图像,称为局部连接;处理不同位置时,反复使用同一组权重,称为权值共享。 本章先说明这个小窗口怎样计算,再把多个窗口组成完整的网络,解释权重怎样学出来,最后用实验检查模型的效果与局限。
4.0.2 本章的两个化学例子
后面的计算主要围绕红外光谱和显微图像展开。先熟悉这两个对象,再看公式中的数组和下标,就更容易知道每一步在处理什么。
一维例子:红外光谱的局部峰形。 例如,1715 cm⁻¹ 附近的 C=O 伸缩峰与 3200–3500 cm⁻¹ 处由氢键展宽的 O–H 宽峰,在位置和形状上都有差别。一维卷积用一个小窗口沿波数轴逐段计算,得到各处的局部响应。可以先用“拿一个峰形模板沿谱线比对”来理解这种操作,不过实际学到的权重不一定像一条完整的峰。还要保留一个谱学上的判断:绝对峰位本身就有化学含义,同样的形状出现在不同波数处,不能一概视为相同的信息。
二维例子:显微图像中的局部纹理。 晶粒轮廓、层片条纹和界面都可以由图像的局部区域描述,而且同一种局部图样会出现在视场的不同位置,权值共享正好适合这种情形。
第 4.9 节会把这些想法放进实验。我们用程序生成的二维点状图样检查平移的影响,用合成红外曲线和合成纹理练习分类,再通过真实的 ESOL 分子水溶性数据比较不同输入表示和模型。合成数据的生成规则已知,适合检查算法,但它们只是计算示例,不能代替对真实物相、官能团或电子结构的验证。
4.0.3 学习目标
本章希望帮助你完成以下几件事:
- 写出一维、二维和多通道卷积(互相关)的定义,并手算一个小例子;
- 用输出尺寸公式和感受野递推公式设计网络的各层形状;
- 说明权值共享为什么带来平移等变性,以及边界、步长和池化如何破坏它;
- 从链式法则出发推导卷积层对偏置、卷积核和输入的三个梯度,并理解 im2col/col2im 的矩阵形式;
- 读懂并运行一个只用 Python 标准库实现的 CNN,用有限差分检验梯度;
- 针对光谱、显微图像和分子数据,判断 CNN 何时是合适的选择、何时应改用图神经网络或描述符模型。
第一次阅读,可以先沿着“窗口怎样计算—各层怎样连接—权重怎样学习—实验怎样检验”的顺序建立整体认识。连续卷积、梯度的矩阵推导和傅里叶分析用于进一步解释原理,可以在理解基本网络后回读。第 4.8–4.9 节保留了完整代码;只阅读正文和结果图,也能跟上实验的思路,需要复现时再展开代码。
4.1 为什么需要卷积
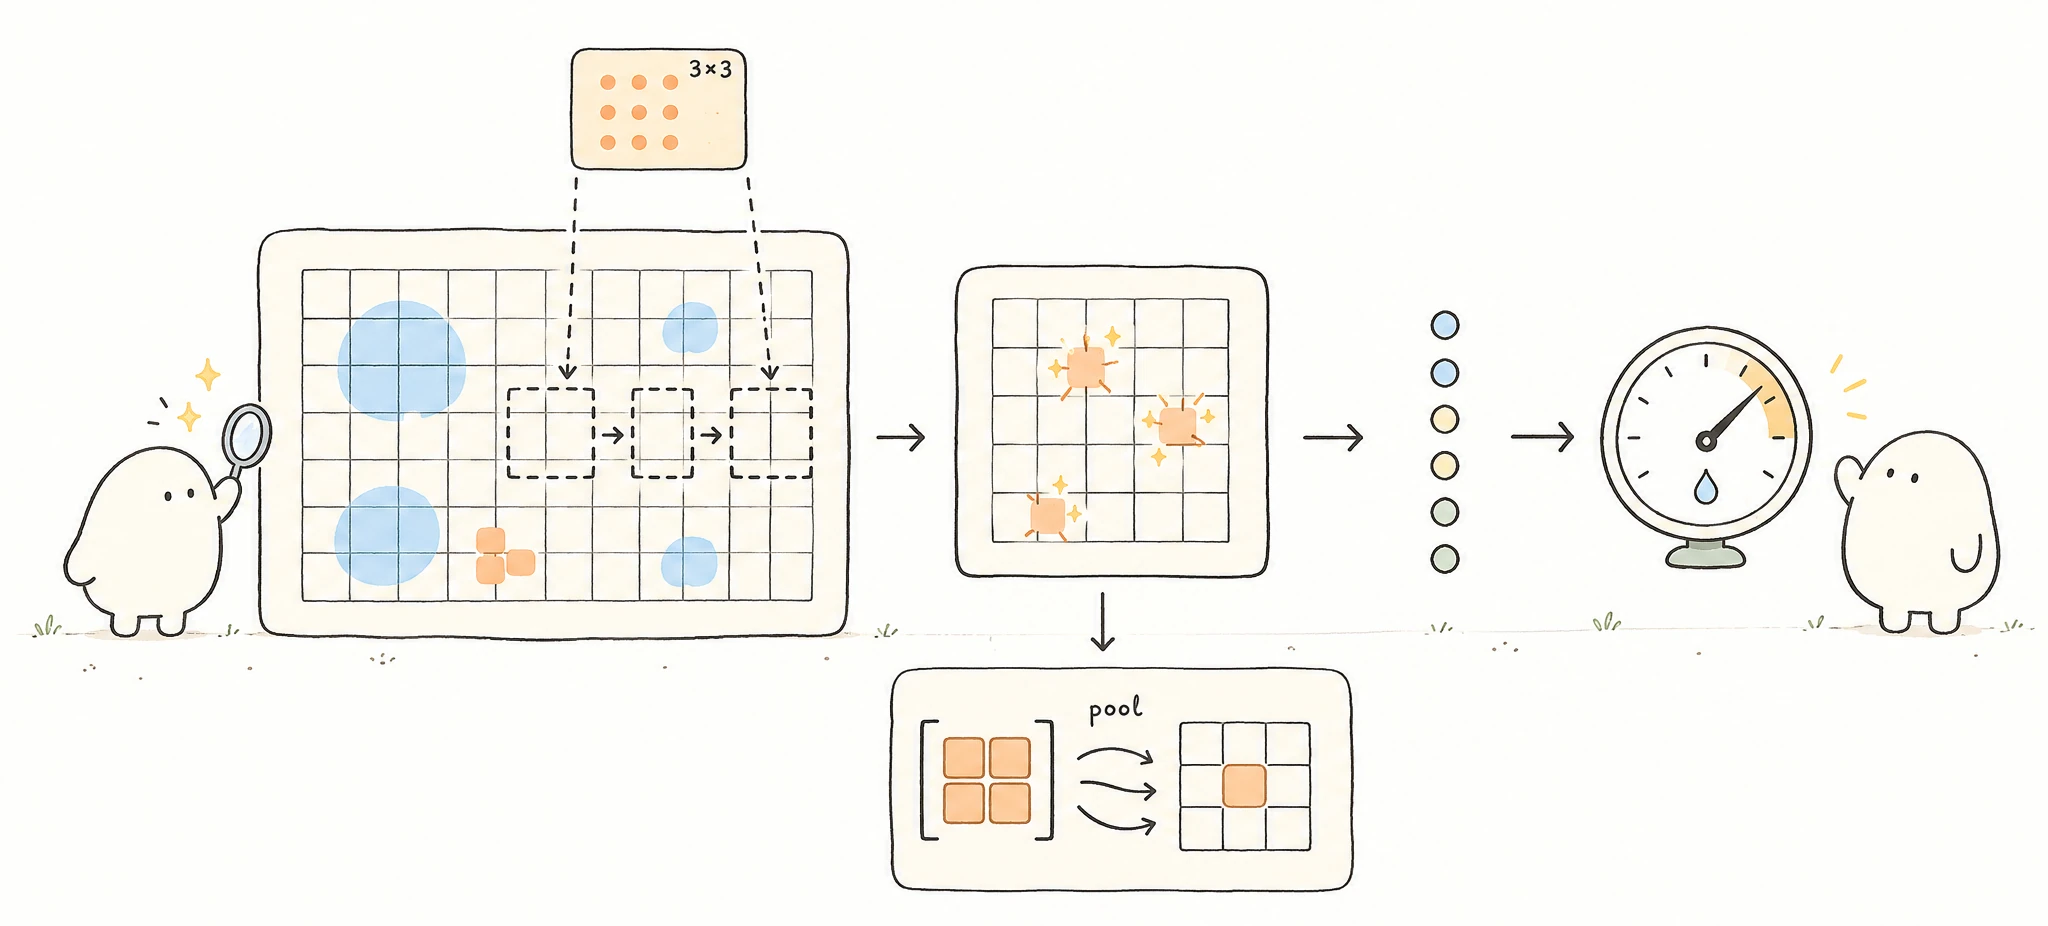
为什么要给谱线和图像专门设计一种网络?先看全连接层在图像稍大时需要多少参数,再看其中哪些计算可以共用。图 2 先给出整体印象:小窗口在输入上滑动,产生局部响应,后面的层再把这些响应组合起来。图中的公式暂时不用展开,后面会逐项解释。
4.1.1 先算一笔账:全连接层的参数量
设我们要把分辨率为 的单通道显微图像分为 10 类组织。若使用全连接网络,先把图像展平成长度为 65 536 的向量,再连接到含 1000 个神经元的隐藏层:
仅这一层的权重与偏置就有
个参数。图像边长每翻一倍,像素数变为四倍,权重数也随之变为四倍。面对只有几百到几千个样本的实验数据,这么多独立权重会增加学习的负担,因此需要考虑哪些参数可以共用。
除了参数多,还要看这些参数怎样使用。全连接层为不同输入位置设置独立权重,没有专门要求相邻像素优先组合,也没有要求图像左侧和右侧使用相同的检测规则。一个局部图样换了位置,网络能否继续识别,要依靠训练中学到的关系,结构本身不提供这个保证。
这里容易产生一个误解:展平本身并不会丢失图像信息。单通道图像中,位置 对应向量下标 ,同一行内左右相邻的像素在向量中相差 1,上下相邻的像素相差 ,仍能按下标恢复邻接关系。问题在于全连接层没有专门利用这种关系。
卷积层则明确规定:每个输出只连接一个局部窗口,各窗口使用同一组权重。这样,模型在开始训练之前就已经具有了某种处理数据的偏好,称为归纳偏置(inductive bias)。当这种偏好符合数据中的规律时,网络有机会用更少的参数和样本学到有用的关系;是否确实有效,仍要通过实验检验。
4.1.2 两条先验假设:局部性与平移对称性
刚才的两项设计,分别对应我们对谱线和图像的两种判断。
- 局部性。 描述一个峰形需要把相邻采样点放在一起,描述一小段边界也需要比较周围像素。因此,可以先从小窗口中的变化入手,再逐层组合更大范围的信息。
- 同一种局部计算可以在不同位置复用。 例如,颗粒轮廓出现在视场左侧或右侧时,都可以用相同的局部规则检测。这是引入平移对称性的出发点:检测规则不随窗口位置改变。
由这两条假设直接得到卷积层的核心机制:设计一个小尺寸的权重窗口(卷积核),让它在整个输入网格上滑动,并在所有位置共享同一组权重。
局部计算也有边界。显微图像中可能存在跨越整个视场的关联,只看一个小窗口还不够;红外谱中,同一峰形出现在 1715 cm⁻¹ 和 2900 cm⁻¹,化学含义也不同。因此,“各处使用相同权重”不能理解成“各处的信息完全等价”。卷积会把响应记录在相应的位置上:输入中的图样移动,特征图上的响应也随之移动。这叫作平移等变性,第 4.3.2 节将进一步区分它与“预测结果不随位置改变”的平移不变性。
4.1.3 从全连接到卷积:结构对比
图 3 对比了两种连接方式。左侧的全连接层中,每个隐藏单元与输入网格的所有像素相连,每条连线都有独立的权重;右侧的卷积层中,每个输出单元只与一个 的局部窗口相连,而且窗口滑到任何位置都使用同一套 9 个权重。
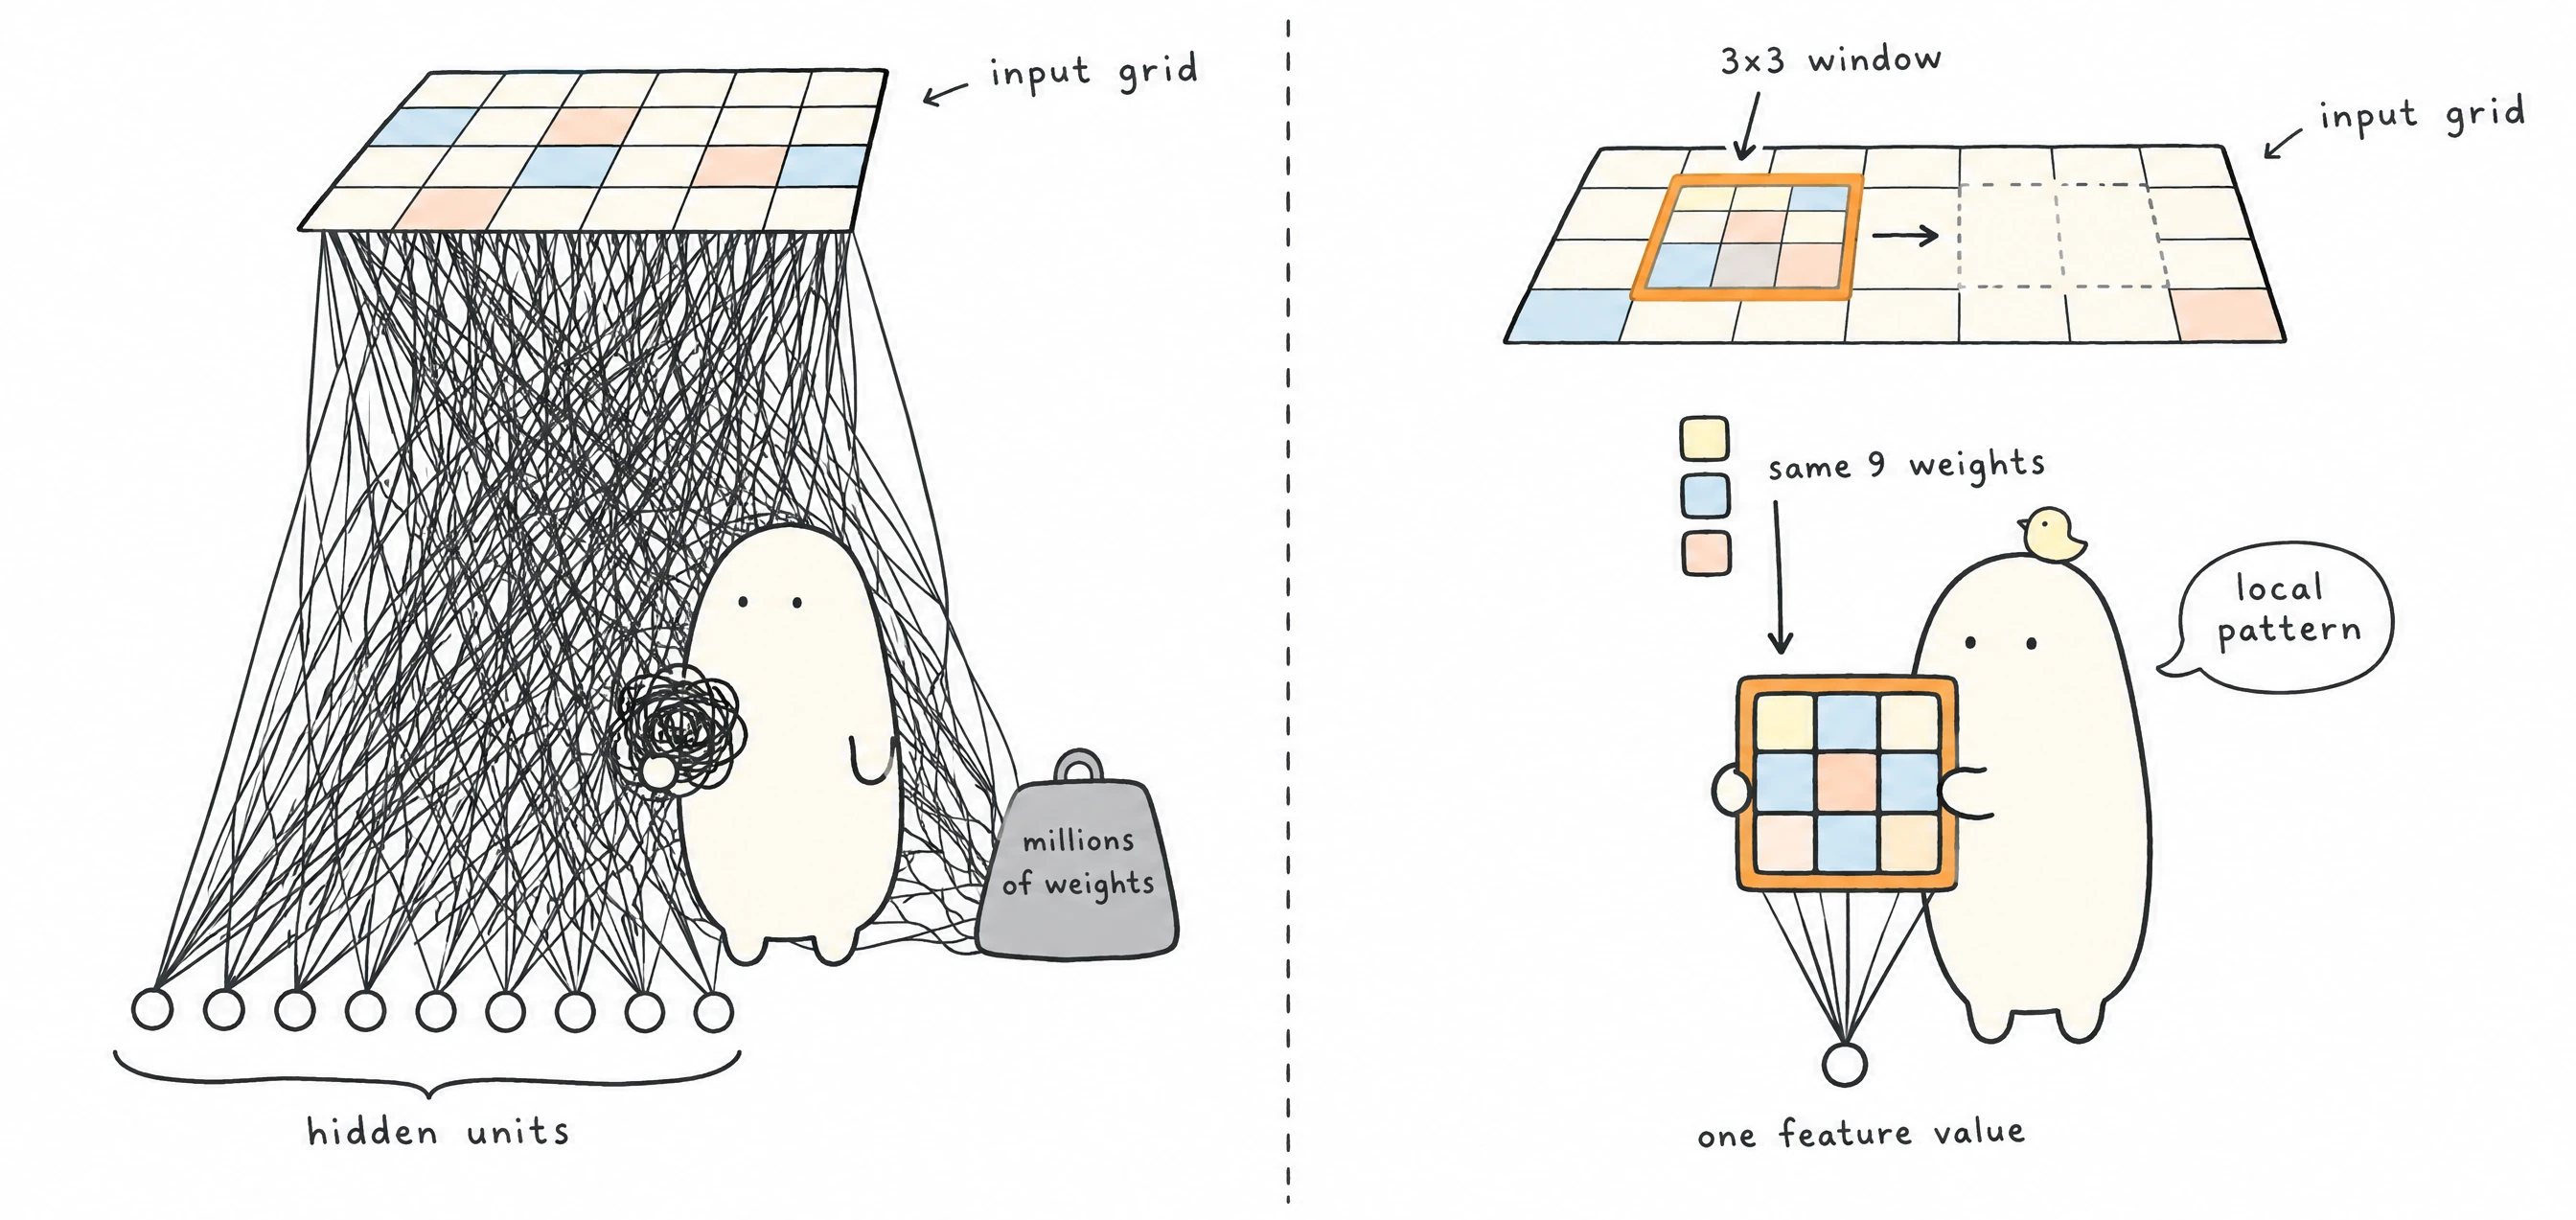
对于固定的输入通道数 、输出通道数 和核尺寸 ,卷积层的参数量为 (推导见第 4.2.6 节),与输入图像的高和宽无关。因此,图像变大时,可以继续复用这些权重;需要增加的是滑动计算的次数。
特征图与典型网络结构
窗口每移动一次,就算出一个数。把这些数按窗口的位置排回二维网格,就得到一张特征图(feature map)。使用多组不同的权重扫描同一输入,会得到多张特征图,分别记录不同的局部响应。
为了在程序中存放这些图,可以把它们叠成一个三维数组,三个维度分别是图的张数、高度和宽度。这里的“张数”称为通道数(channel),这样的多维数组称为张量。对输入而言,灰度显微图只有一个通道,RGB 彩色图有三个通道,高光谱图像则可以有更多通道。对中间层而言,通道记录的是网络计算出的特征,不一定直接对应某种物理量。
本章的二维卷积层对单个样本采用“通道数 × 高度 × 宽度”的排列。一个卷积层使用 组卷积核权重,就输出 张特征图。随后的池化层对每张图分别降低分辨率,通道数保持不变;第 4.4 节会说明它如何计算。
有了局部响应,还需要把它们组合成整个样本的判断。经典卷积网络通常反复使用卷积层和池化层,最后接全连接层。下面的式子只是这种连接顺序的简写,图 4 给出了对应的数据流:
即先连续堆叠 个卷积层(通常配合激活函数),再接一个可选的池化层,构成一个“卷积块”;卷积块重复 次后,把特征图展平,送入 个全连接层完成分类或回归。图 4 画出了 时的数据流。
4.1.4 发展简史
前面的结构并非一次设计完成,而是在图像识别任务中逐步形成的。下面简要交代几个来源,方便以后阅读文献;第一次学习时,记住小窗口、共享权重和多层组合这条主线即可。
- 1959 年,Hubel 与 Wiesel 在猫的初级视觉皮层中发现,单个神经元只对视野中某一小块区域、某一方向的刺激产生响应,由此提出“感受野”的概念 [6]。
- 1980 年,Fukushima 提出 Neocognitron,交替堆叠特征提取层和下采样层,已具备现代 CNN 的雏形;其权重通过无监督的自组织规则学习,尚未使用反向传播 [7]。
- 1989 年,LeCun 等人用反向传播端到端地训练卷积核,用于手写邮政编码识别 [8];这一路线在 1998 年发展为经典的 LeNet-5 [9]。
- 2012 年,Krizhevsky 等人提出的 AlexNet 结合 GPU 计算、ReLU 激活和 Dropout 正则化,在 ImageNet 图像分类竞赛中把错误率大幅降低,引发了深度学习的热潮 [10]。
- 此后,VGG 用多个小的 卷积核级联代替大卷积核 [11],ResNet 引入残差连接使上百层的网络可以有效训练 [12]。
- 2020 年前后,以自注意力为核心的 Vision Transformer 在大规模数据上取得了与 CNN 相当甚至更好的表现 [13];但在样本较少、局部结构明显的任务中,CNN 的局部性偏置仍然很有价值,二者的混合架构也很常见。
从能够用反向传播训练卷积核开始,这一路线不断通过网络深度、训练技巧、计算硬件和数据规模得到改进 [2]。后面要学习的滑动计算和梯度求法,是理解这些网络的基础。希望系统阅读的同学可参考 Goodfellow 等人的教材 [1],其第 9 章专门讨论卷积网络。
4.1.5 在化学与材料科学中的用途
回到材料与化学研究,选择 CNN 的一个出发点是输入怎样排列。我们可能希望从分子构型预测势能 ,从组成与温度预测自由能 ,也可能从一张图像预测组织类别。经验模型(如 Lennard-Jones 势)和第一性原理计算(如 DFT、CCSD(T))各有自己的物理描述;如果改用数据训练模型,还需要先选择输入表示。数据已经排列在规则网格上时,CNN 可以直接处理其中的局部关系。下面几类任务会反复遇到这种输入:
- 谱图分析。 IR、拉曼、NMR 和 XRD 数据都可以离散为一维数组,但横轴的物理含义不同:分别是波数、拉曼位移、化学位移和衍射角(或散射矢量)。一维卷积擅长提取峰形和相邻峰的组合;至于吸收、散射和衍射信号各自的物理解释,仍需结合谱学知识。
- 显微图像分析。 SEM、TEM 和 STM 图像包含颗粒、界面和缺陷信息,CNN 可用于分类、分割和目标定位。图像衬度受仪器、制样和成像机制影响,亮暗结构不能直接等同于物相,物相认定通常还需要成分或衍射证据。
- 量子化学网格场。 电子密度 、静电势等可以采样为二维截面或三维体素数组。此时网格间距、边界条件和坐标朝向都成为输入表示的一部分,需要与预测目标一起设计。
- 高通量实验。 视觉模型可以辅助识别结晶形态、筛选显微图像、发现异常样本。评估这类模型时应按实验批次、样品或仪器划分数据,检验它在新条件下是否仍然可靠。
需要强调的是,普通 CNN 要求输入排列在规则网格上。分子图和原子点云既可以用图神经网络直接处理,也可以先网格化(体素化)再用 3D CNN 处理;选择哪种方式,要权衡信息损失、对称性、计算成本和目标任务。我们将在第 4.9.1 节和第 4.10 节回到这个问题。
4.2 卷积的数学定义
前面反复提到“小窗口”,现在来算一次它的输出。操作只有三步:取出窗口覆盖的数据,与相应的权重逐项相乘,再把乘积相加。窗口移动后,数据换了一段,权重仍用原来那一组。
下面先用一维光谱手算,再推广到二维图像。中间的第 4.2.2–4.2.3 节解释“卷积”这个名称及其与仪器展宽的联系;若想先连贯地掌握计算方法,可以在完成一维例子后接着阅读第 4.2.4–4.2.7 节。
图 5 直观地展示了“滑动内积”的含义。左图是一条含有一个吸收峰的简化曲线;中图是一个长度为 15 的权重模板(卷积核),它中间为负、两侧为正;右图是把模板沿曲线滑动、在每个位置计算内积得到的响应。可以看到,响应在模板与峰形最匹配的位置(峰中心)达到最大,而在平坦区域接近零。这正是卷积能够“检测”局部图样的原因。
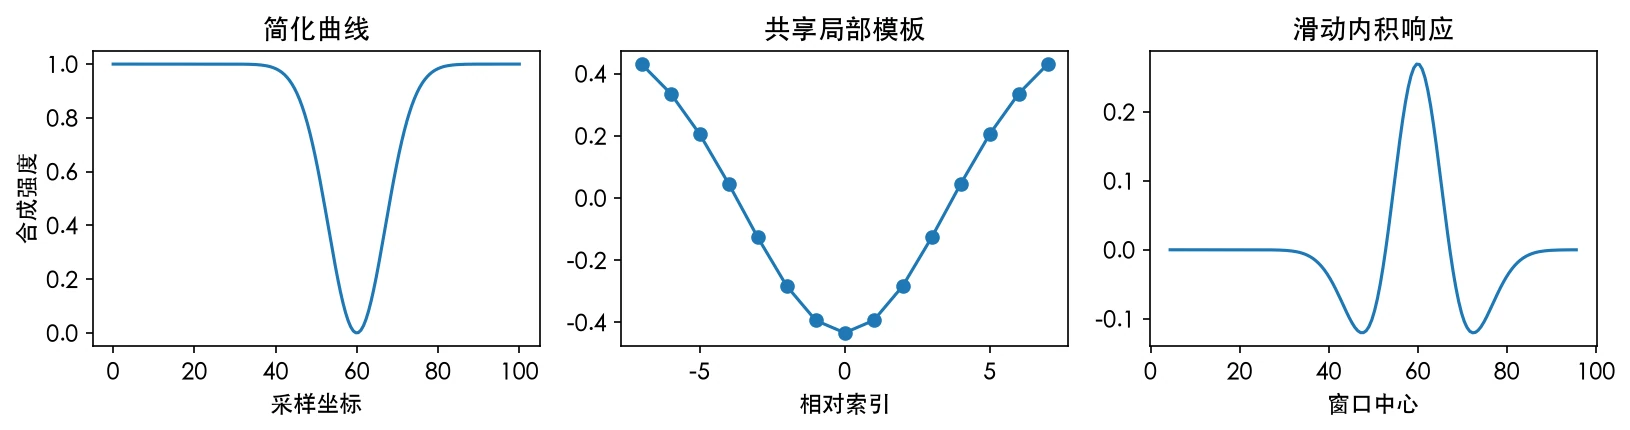
4.2.1 离散一维卷积:以红外光谱为例
仪器保存的光谱由一个个采样值组成。设这条谱线有 个数,写成 ;另取 个权重,写成 。这组权重就是卷积核。窗口每次覆盖连续的 个采样点,把它们与 个权重对应相乘,再求和。这种“对应相乘再求和”也称为内积。
下面的手算例子使用吸光度式的表示,峰向上。图 5 和后面的合成实验采用向下的峰形示意,读图时要留意纵轴约定;窗口的乘加规则本身不变。先看交互图中的不同核,再把这一计算写成公式:
卷积核
合成 IR 光谱,10 个吸收峰
信噪比 输入 → 输出18 → 42在 1900–2500 cm⁻¹ 空白区估计
检出吸收峰10 / 10误检 1
核长度25 点点间距 4 cm⁻¹
1100/1050 双峰分辨平滑过度会合并
一维卷积处理红外光谱横轴为波数(从高到低),输出已归一化
含噪输入 卷积输出
公式中, 表示窗口从哪个采样点开始, 表示窗口内部的第几个位置。例如, 就是当前窗口中的一个采样值, 是与它相乘的权重。求和号把窗口内的 个乘积加起来,得到 。
这里每次移动一个采样点,称为步长为 1;两端也不补零。窗口只能从第 0 个位置移到第 个位置,因此一共得到 个输出(要求 )。严格地说,这种不翻转核的滑动内积叫作互相关;深度学习中通常也称它为卷积,第 4.2.2 节会解释这个约定。
例 2.1 手算一段谱线的平滑
设一段归一化的吸收光谱为
第 2、3 号采样点(从 0 开始编号)的强度较高,构成一个吸收峰。取一个长度为 3、权重之和为 1 的对称平滑核:
让核从左向右滑动:
,窗口为 :
,窗口为 :
,窗口为 :
,窗口为 :
最终得到 ,长度为 。与原始数据相比,峰被“抹平”了:最大值从 0.90 降到 0.7125,峰两侧的值被抬高。这就是平滑核的作用——对每个位置取邻域的加权平均,抑制逐点的随机噪声,代价是峰变宽、变矮。
这个例子中的权重是我们手工指定的,只负责平滑,没有化学特异性。如果输入是一条常数直线,因为权重和为 1,输出仍是同一常数。换一组权重,响应也会改变,图 5 就展示了另一种局部模板。
到了 CNN 中,窗口的乘加方法仍然相同,改变的是权重的来源:训练过程会根据预测误差调整这些权重。实际学到的核可能组合出有用的局部响应,但未必像一条完整的峰,也不能仅凭核的形状判断它对应哪个官能团。
4.2.2 互相关与卷积:深度学习中的约定
刚才没有翻转权重,直接逐项相乘。查阅信号处理教材时,你会看到一个看起来不同的定义:
下标 意味着:随着 增大,核的下标反而减小。换句话说,计算之前要先把核左右翻转(二维时旋转 180°),再滑动相乘。而式 (4) 定义的互相关
不翻转核。两者唯一的区别就是是否翻转卷积核。本章用 表示数学卷积,用 表示互相关。
PyTorch、TensorFlow 等深度学习框架中的“卷积层”实际计算的都是互相关 [42],本章第 4.8 节的代码也是如此。之所以可以这样做,是因为卷积核是可学习的:如果某个任务需要的最优核是 ,那么用互相关学到的就是翻转后的 ;两种约定能表示的函数完全相同,只是参数的排列顺序不同。因此,深度学习文献沿用“卷积”这一名称,指的是互相关运算。
实践提示 从图像处理文献中照搬固定算子(如 Sobel、Laplacian)时,要先确认文献使用的是卷积还是互相关。中心对称的核(如高斯核、Laplacian 核)翻转后不变,两种约定结果相同;反对称的导数核(如 Sobel 核)翻转后变号,响应的符号会相反;一般的非对称核两种约定下的结果不同。
4.2.3 连续卷积:仪器展宽的数学模型
卷积还可以用来描述一个熟悉的测量现象:理想的窄谱线经过仪器后会展宽。这个例子能帮助我们理解上一节公式中的 从哪里来。
对于线性且平移不变的测量系统,设真实信号为 ,仪器对理想窄脉冲给出的响应为 ,后者称为脉冲响应。这里的 是信号坐标,在光谱例子中可以对应谱轴,不必理解为时间。测得的信号是
在光谱测量中, 是理想谱线, 是仪器线形函数。式 (13) 的含义是:在坐标 处的每一份真实信号 ,都被仪器展宽成以 为中心的一个响应 ,测得的谱线是所有这些响应的叠加。翻转正是来自“以 为中心”的 。若输入是理想的狄拉克 脉冲,输出正好是 本身。
这个模型有两个前提:仪器在所考察的区间内近似线性;相同形状的输入只是平移,响应形状也只平移不变形。如果仪器分辨率随波数变化(这在色散型光谱仪中很常见),就需要用依赖两个坐标的核 ,单一的共享核不再适用。这也提醒我们:卷积的“平移不变”假设在物理上并不总是成立。
对积分做等间隔离散化时,还应包含采样间隔 :
机器学习代码通常把常数因子 吸收进可学习的核权重中,于是得到式 (11) 的离散形式。
4.2.4 二维卷积:显微图像的局部加权和
回到离散数据。如果把谱线换成 SEM 图像,窗口就从一小段数组变成一个小矩形。计算方法没有变:取出矩形内的像素,与对应权重逐项相乘,再把所有乘积相加。对单通道输入 和 的卷积核 ,这一操作写为
即把窗口左上角放在 ,窗口内的像素与核权重逐元素相乘再求和。 或 的核最为常用,它们只比较一个很小邻域内的强度变化。
式 (15) 已经足够完成一次单通道二维计算。若想先手算,可以直接对照第 4.2.7 节的矩阵。下面把实际卷积层还需要的设置写全,供后面的推导和代码统一使用。
先用文字理解这些设置:步长决定窗口一次移动几格;补零决定图像边缘外侧怎样填值;输入通道表示同一位置上有几组数据;多个卷积核则各自产生一张输出图。偏置是在每次加权求和后加上的数。同一输出通道的各个位置共用一个偏置。
对应的符号如下,附录 A 的表10 也提供了查询表:
- 输入张量 ,其中 为通道数,、 为高和宽;
- 卷积核张量 ,共 个卷积核,每个卷积核覆盖全部 个输入通道;偏置向量 ;
- 步长 :窗口每次移动的格数;补零层数 :在输入四周各补 圈零;
- 补零后的输入记为 ,输出记为 。
这里把卷积核记为 ,以免与图像宽度 混淆;第 4.8 节代码中卷积核存放在变量 Conv2D.W 中,对应的就是 。
补零的含义是:原始像素 放在补零后网格的 处,即当 且 时 ,其余位置取 0。
在这些符号下,卷积层输出的每一个元素为
读式 (16) 时,可以分成三步:先固定输出通道 和窗口位置 ;再对每个输入通道,在窗口内完成逐项乘加;最后把各通道的结果相加,并加上偏置。 和 只是把“第几个窗口”换成“窗口在输入中的起点”。后面的反向传播和代码都使用这个式子。接下来先弄清窗口能移动多少次,再具体解释通道怎样合并。
4.2.5 输出尺寸公式
每放置一次窗口,就产生一个输出。因此,输出有多大,归根结底是在数窗口能放多少次。先只看竖直方向:补零后输入的高度为 ,第 个窗口的上边缘位于 ,下边缘位于 。整个窗口都必须放在补零后的输入内,即
由此得 。由于 取非负整数,合法的取值为 ,共
个。高、宽方向的步长或补零不同时,分别代入 和 即可。若使用空洞卷积(第 4.4.4 节),核的有效尺寸变为 ,其中 为空洞率。
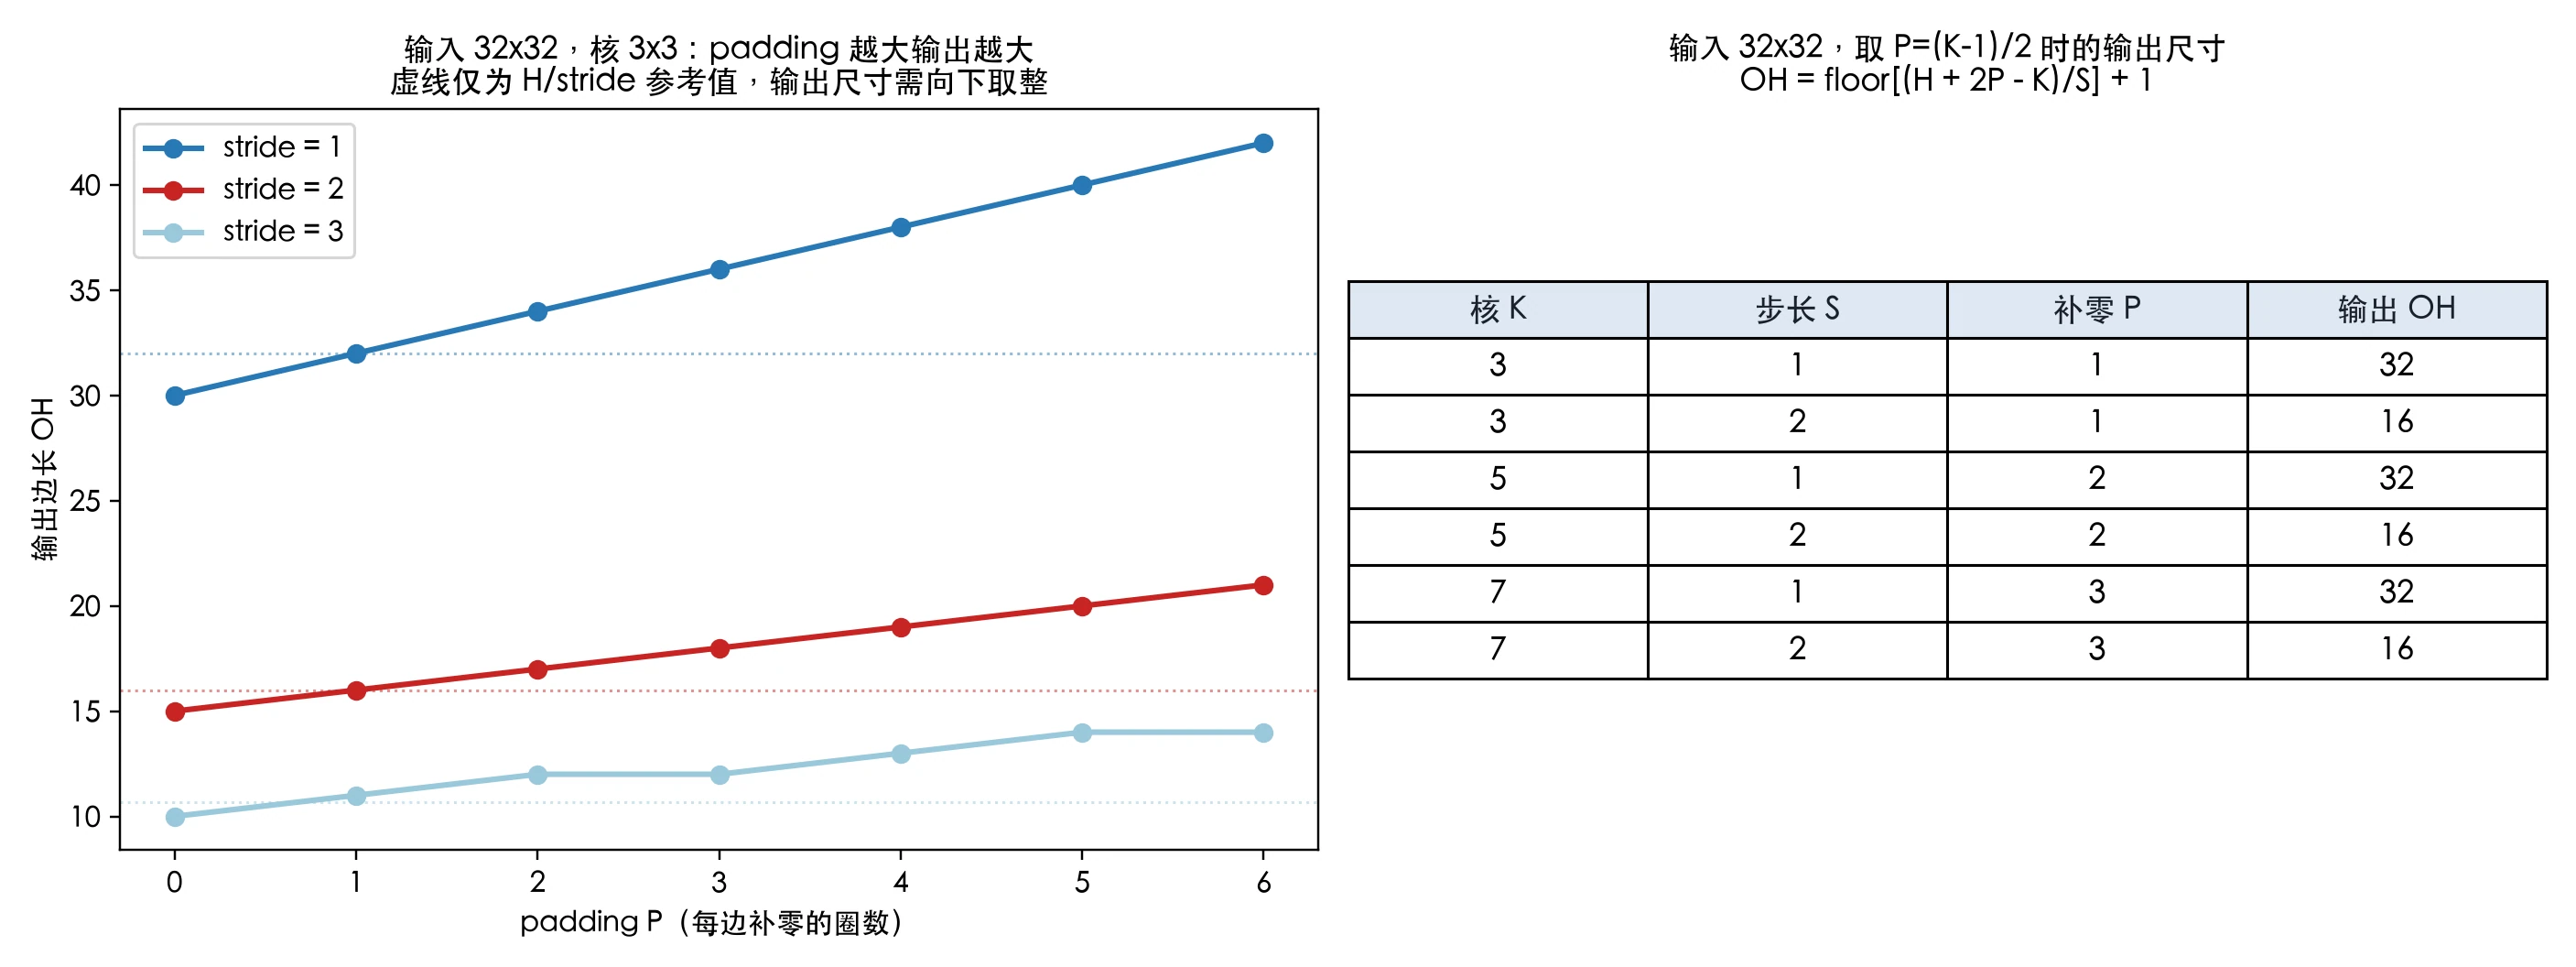
式 (18) 对应两种最常见的设计:
- 保持尺寸(same padding)。 当 时,要使 ,需 。这就是卷积核通常取奇数尺寸的原因: 核取 , 核取 , 核取 ,两侧对称补零即可保持尺寸不变。偶数尺寸的核需要两侧不对称补零。
- 减半尺寸(步长 2 下采样)。 取 、、,得 : 为偶数时输出为 , 为奇数时输出为 。现代网络常用这种步长卷积代替池化层来降低分辨率。
图 6 用 的输入具体展示了补零和步长对输出尺寸的影响;Dumoulin 与 Visin 的图解指南 [3] 对各种步长、补零组合给出了更多直观的示意。
4.2.6 多通道卷积
到这里,窗口的位置和输出大小已经清楚了,还剩一个问题:同一位置有多组数据时,怎样一起计算?
先看 RGB 彩色显微图。每个像素有红、绿、蓝三个数,可以把整张图看成三张对齐的二维数组,也就是三个输入通道。一个卷积核分别在三个通道上计算局部加权和,然后把三个结果相加,再加上偏置,得到一个输出值。高光谱图像和网络中间层的多个特征通道,也按相同方式处理。
式 (16) 中,对 求和是在一个通道的窗口内计算,对 求和则是合并不同通道的结果:
因此,生成一张输出特征图,需要一组大小为 的权重。其中每个 切片负责一个输入通道,合起来称为第 个卷积核。它扫描全部位置后,仍然只生成一张特征图。使用 组这样的权重,才会生成 个输出通道。图 7 展示了三个输入通道、两组卷积核的例子。
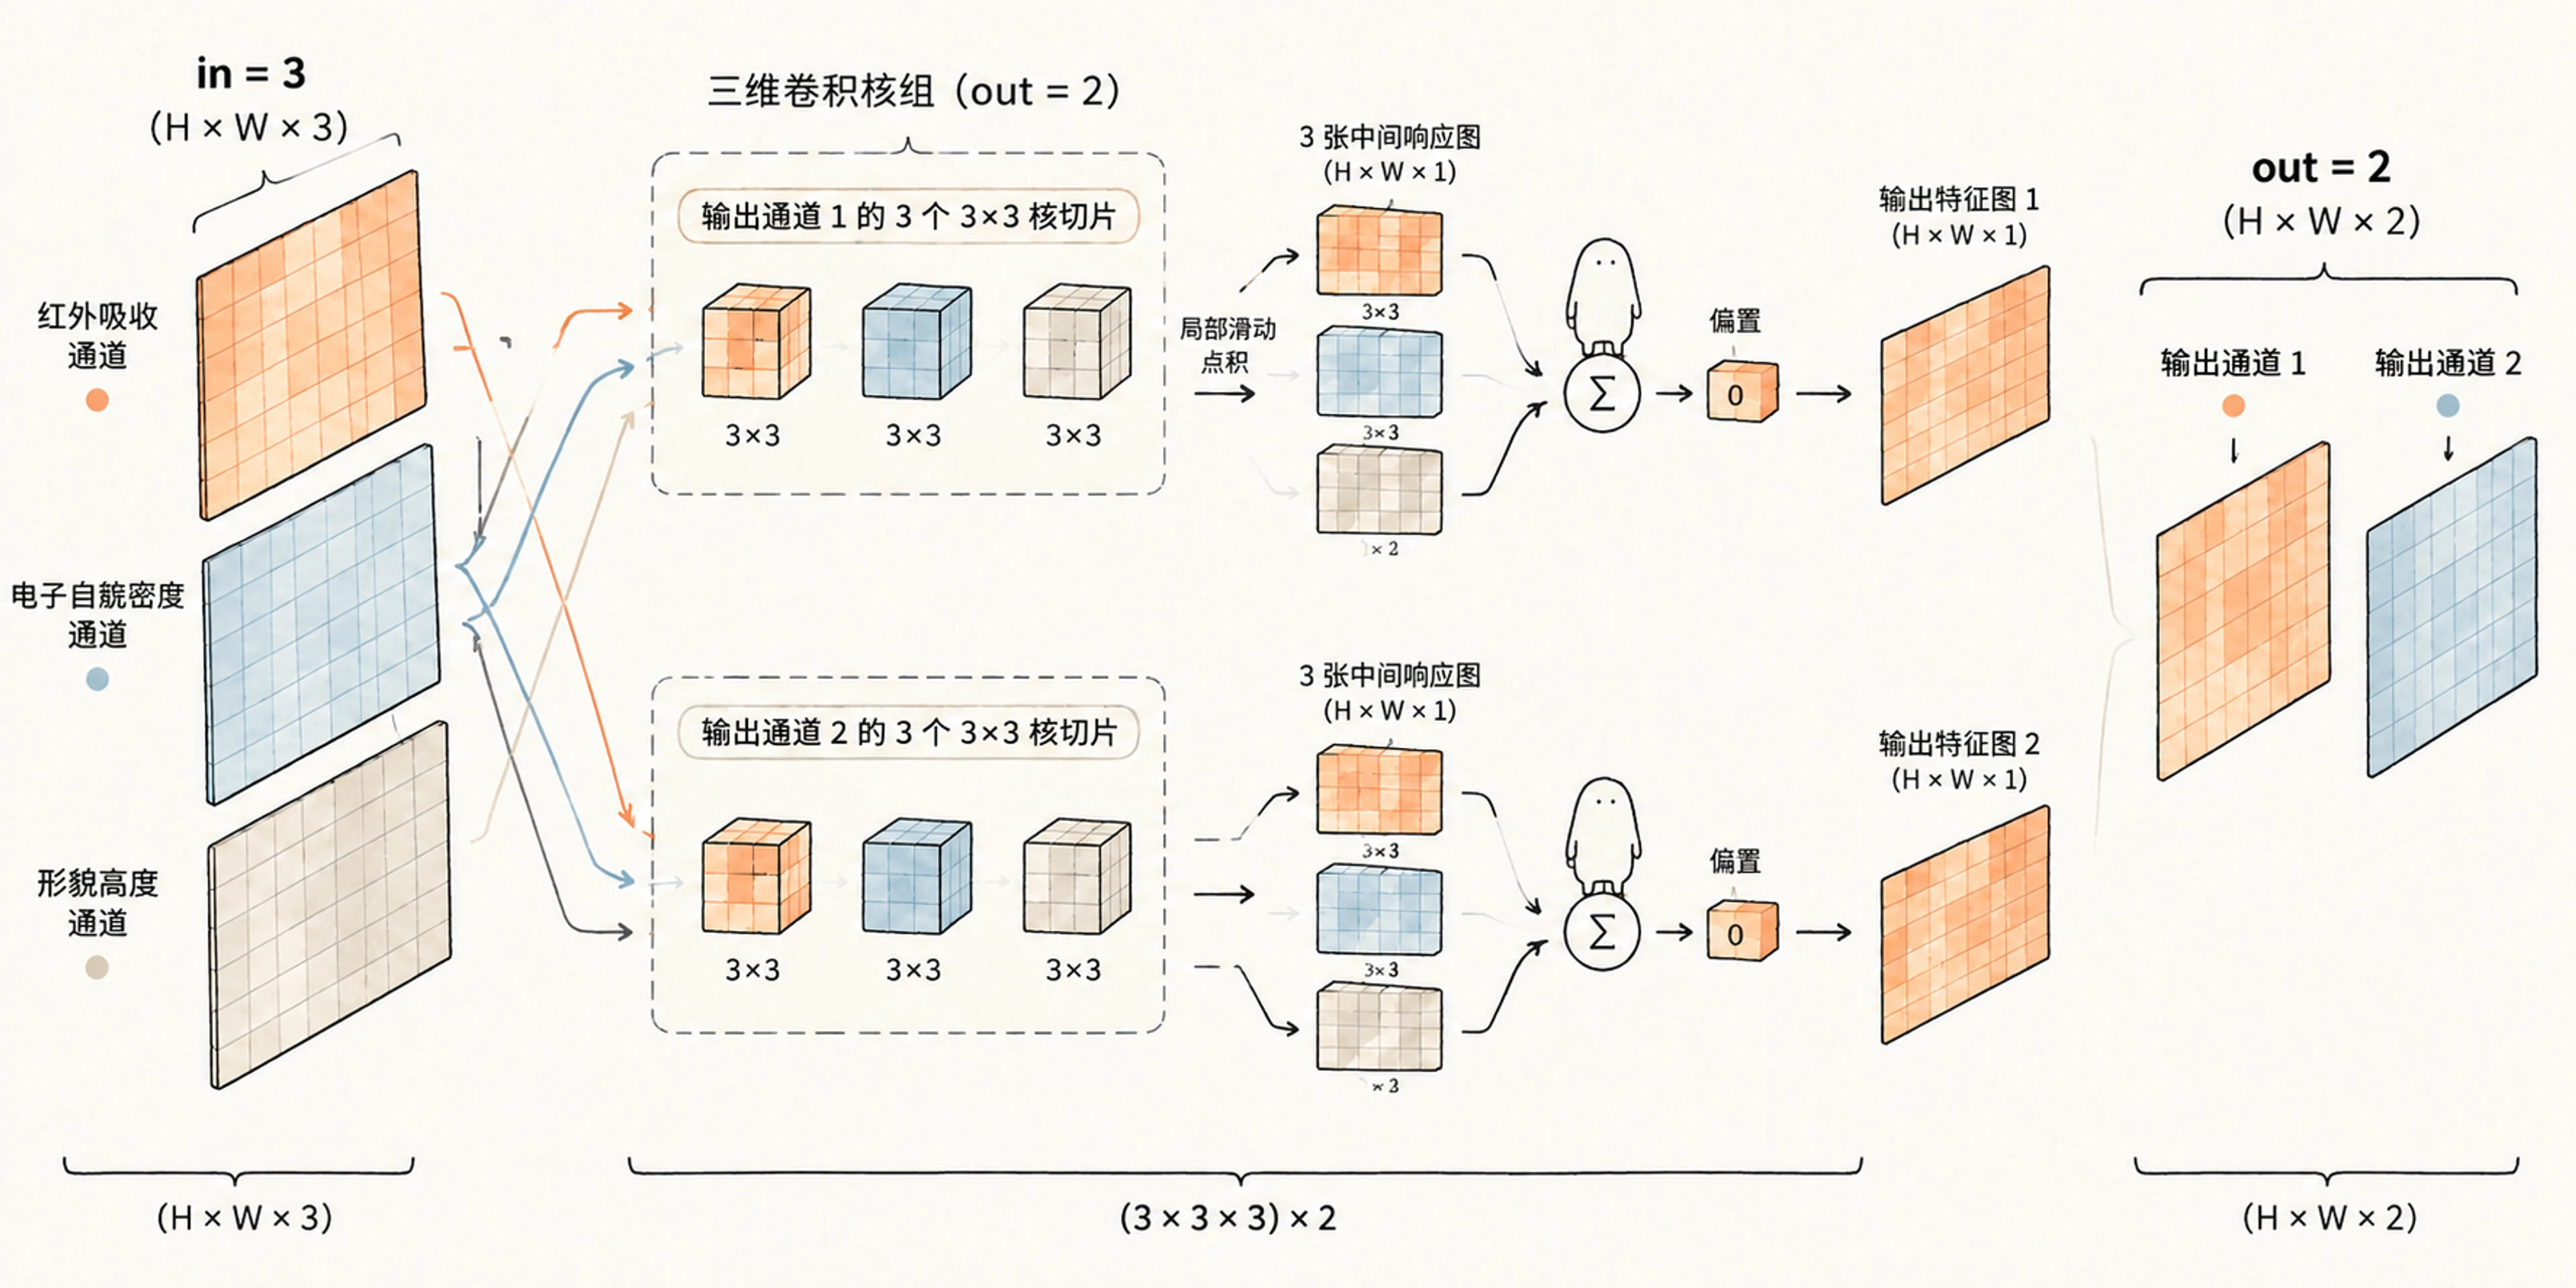
由此可数出卷积层的可训练参数: 个卷积核各有 个权重,再加 个偏置,
这个数只取决于输入通道数、输出通道数和核尺寸,与输入的高 、宽 无关,这正是第 4.1.3 节所说的“参数量与图像尺寸无关”的来源。例如图 7 中的卷积层有 个参数,无论输入图像是 还是 。
4.2.7 二维手算例子
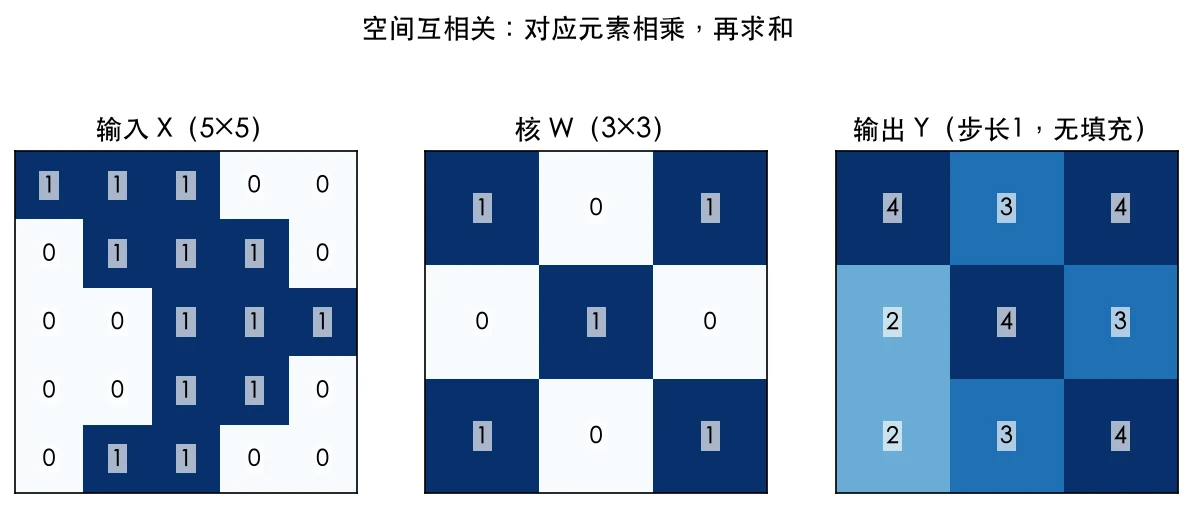
现在把前面的规则放在一起,手算一个完整的二维例子。先用一个 窗口计算输出的第一个数,再把窗口向右移动,最后比较不同步长下的结果。图 8 给出了输入、权重和最终输出,计算时可以逐项核对。
输入图案(7×7)
卷积核(3×3)
步幅 s
零填充 p
输出尺寸5 × 5⌊(7+0−3)/1⌋+1
当前输出位置(0, 0)
当前输出值0
乘加次数225参数仅 9 个
卷积核在输入上滑动虚线格为零填充,橙框为当前窗口
正 负
👉 在浏览器中打开独立交互实验:CNN 卷积核滑动计算实验室
交互实验 4-A 二维卷积核滑动计算与逐项乘加。 支持动态调整输入矩阵、切换预设卷积核(包含例 2.2 的手算参数)、配置步长/补零与 ReLU 激活,单步单格直观观察滑动内积。(需与本章配套的 interactive 目录一同打开)
例 2.2 设定
输入为一个 的单通道网格(为便于手算,取 0/1 值):
卷积核为一个 的“X 形”核,偏置 ,激活函数取 (第 4.4.3 节将详细介绍):
情形 A:步长 ,不补零
由式 (18),输出尺寸为
计算 。 窗口覆盖左上角的子块 :
与 逐元素相乘并求和(按行写出):
经 ReLU 激活:。
向右移动一格,计算 。 窗口覆盖 :
依此类推遍历全部 9 个位置,得到
请读者自行验算其余 7 个元素。由于本例所有加权和都非负,ReLU 不改变结果。
情形 B:步长
步长为 2 时,窗口每次在水平和竖直方向各跳两格。由式 (18):
窗口左上角依次位于 、、、,恰好是情形 A 中 的四个角元素:
比较两种情形可见:步长为 的卷积等价于先做步长为 1 的卷积,再每隔 个元素取一个。因此,步长卷积在提取局部特征的同时降低了空间分辨率,计算量也相应减少。至于补零,它的作用是控制输出尺寸,并让边缘像素也能处在窗口中心;代价是引入了“视场之外全为零”这一人为的边界假设,第 4.3.2 节将讨论它对平移等变性的影响。
手算到这里,可以把卷积概括为“局部乘加、移动窗口、复用权重”。第 4.6 节会沿用这种逐窗口分析的方法,说明输出误差怎样传回卷积核和输入。
复现本节 5×5 输入与 3×3 交叉核;沿窗口扫描,核权重始终共享。
输入 X
1110001110001110011001100
共享卷积核 W
101010101
输出 Y
4········
输出尺寸 3×3;当前窗口左上角 (0,0)。
思考与说明
思考步长变为 2 时,输出边长为什么从 3 变为 2?
采用互相关,不翻转核;偏置为 0,无补零。显示原始响应,不应用 ReLU。
4.3 卷积层:参数共享、平移等变与感受野
上一节已经算出了卷积的输出。接下来看看这种算法带来什么:同一组权重反复使用,究竟省了多少参数;图样换个位置,输出怎样变化;每次只看小窗口,又怎样联系更大范围的信息。这三个问题分别对应参数共享、平移等变和感受野。
4.3.1 参数量对比
以一张 的单通道小图为例(第 4.5 节和第 4.9.1 节将用到同样大小的输入),比较两种网络第一层的参数量。
若用全连接层把 144 个像素连接到 48 个隐藏单元,第一层的权重与偏置共有
个。若改用 4 个 卷积核,由式 (20),第一层只有
个参数。随着图像增大,两者的差距迅速扩大:
- 输入为 时,全连接层需要 6960 个参数,卷积层需要 40 个;
- 输入为 时,全连接层增至 个,卷积层仍为 40 个;
- 输入为 时,全连接层约为 个,卷积层依然是 40 个。
这里比较的是参数量,两层承担的计算并不相同。全连接层的每个隐藏单元都能接收整幅图像的信息,卷积层的每个输出只接收一个 窗口的信息。卷积网络需要继续堆叠多层,才能逐步联系更大的区域。第 4.3.3 节会具体计算这个范围。
4.3.2 平移等变性
设想显微图像中的一个颗粒向右移动了 2 个像素。我们可能关心两种不同的输出:如果输出是一张标出颗粒位置的图,标记也应向右移动;如果输出只是组织类别,我们则希望类别判断保持不变。这两种要求需要分开讨论。
用 表示把输入平移 个网格点,用 表示网络的某一部分,就可以把它们写成:
- 等变性(equivariance):输入平移后,输出也做相应的平移,即 。例如,显微图像中的颗粒向右移动 2 个像素,特征图上对应的响应也向右移动 2 个像素。
- 不变性(invariance):输入平移后,输出完全不变,即 。例如,我们希望“这是哪一类组织”的判断不随颗粒在视场中的位置而改变。
对于步长为 1、暂不受边界影响的卷积层,图样移动后,同样的数据仍会与同样的权重相乘,只是计算发生在新的位置。因此,响应的位置随之移动,数值保持对应,这正是平移等变性。下面把这句话写成公式。设输入沿竖直方向平移 格,即 。代入式 (16):
最后一步只是把 看作新的窗口位置,与式 (16) 对比即得。结论是:输入平移 格,输出特征图也平移 格,数值逐点对应。水平方向的证明完全相同。证明的关键在于第二行中 与窗口位置 无关——这正是权值共享。如果每个位置使用不同的权重 ,第二行就无法化成第三行。因此,权值共享在网络结构中内置了平移等变性,网络不需要额外的参数去“学习”平移。
图 9 用一个简单例子展示了这一性质。
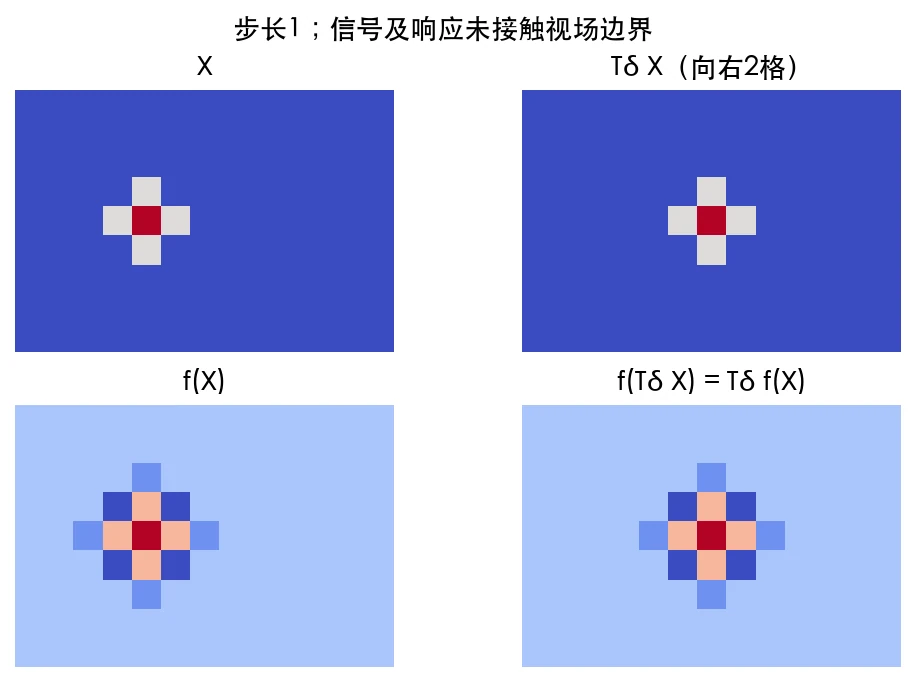
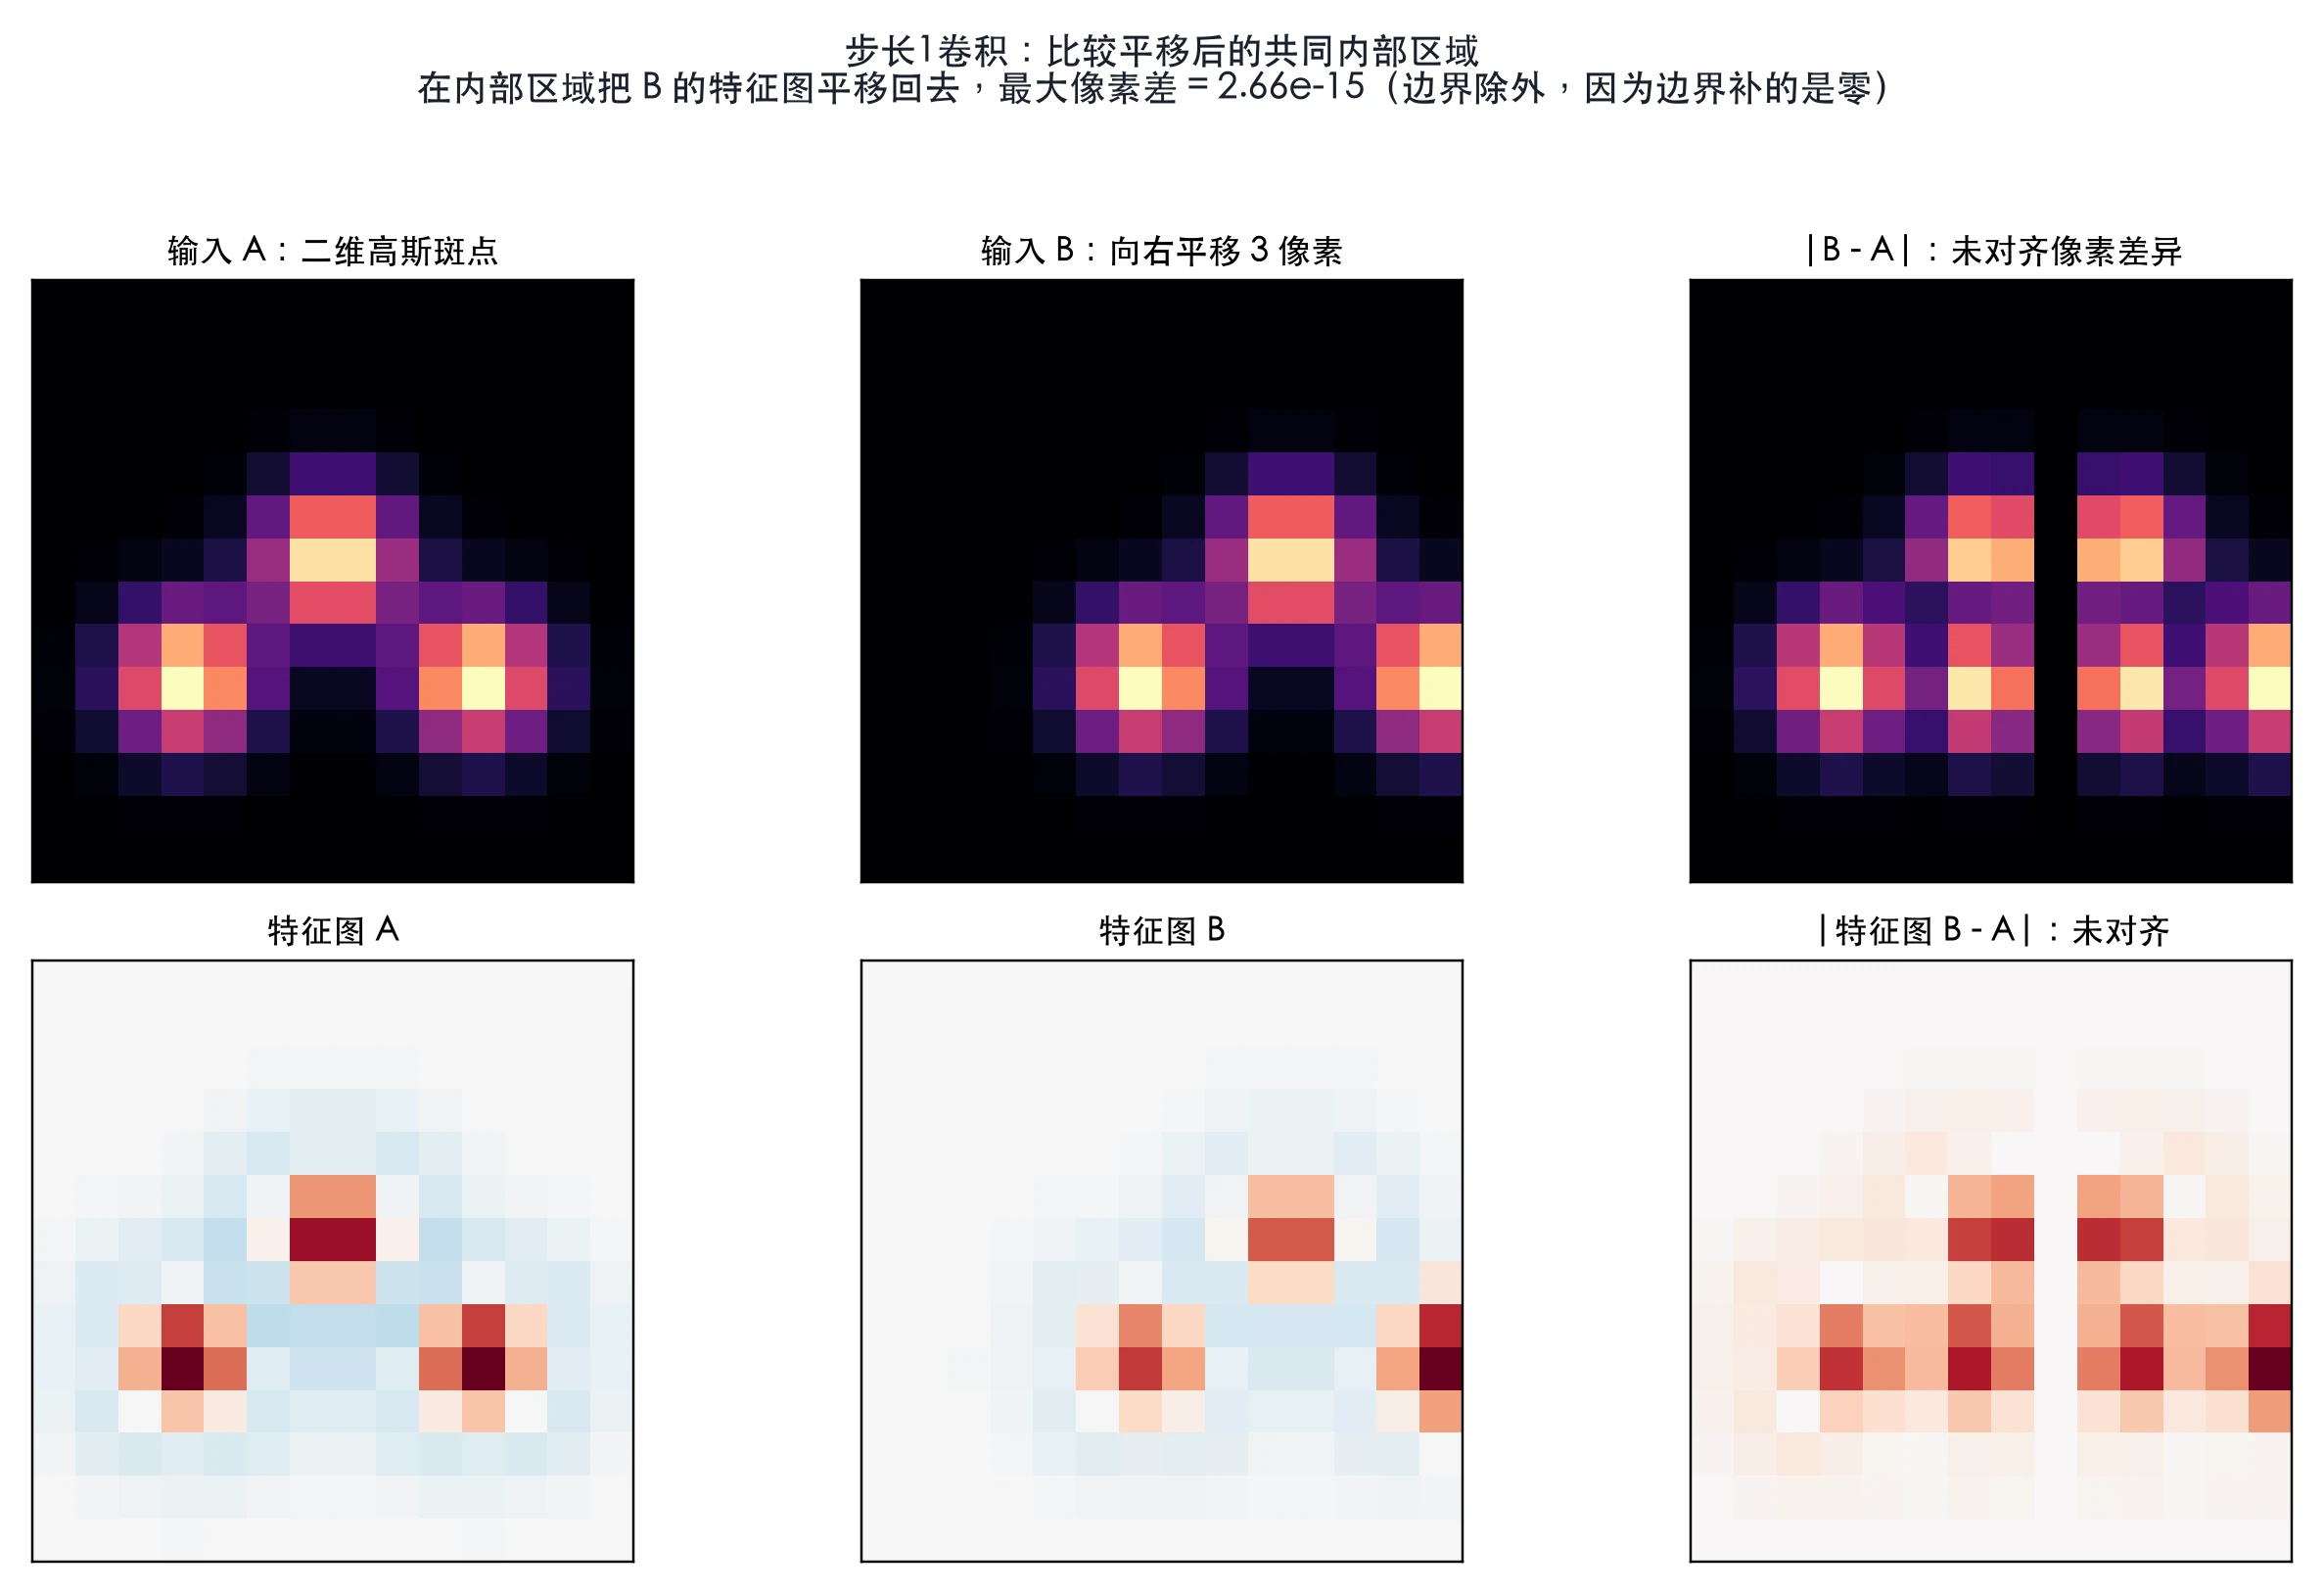
图 10 用数值实验做了更严格的检验:对一幅二维斑点图像和它向右平移 3 个像素后的版本分别做步长 1 的卷积,再把第二张特征图平移回来,与第一张比较。在不受边界影响的内部区域,两者的最大差异仅为 ,即双精度浮点数的舍入误差量级,与式 (33) 的结论一致。
实际中破坏等变性的因素
式 (33) 是在理想条件下得到的。实际网络中有三类因素会破坏它:
- 边界补零。 补零相当于假设视场之外全是零。当图样移到视场边缘时,窗口会把这些人为的零卷进来,响应因此改变;图 10 右侧边缘的差异就是这样产生的。如果图样移出视场,信息本身就丢失了。
- 步长与池化。 对步长为 的卷积或池化,只有平移量是 的整数倍时,输出才对应平移;其他平移量会改变采样的“相位”,输出可能明显不同。多次下采样后,需要考虑累积步长。此外,展平(Flatten)后接全连接层时,全连接层对每个位置使用不同的权重,因此整个分类网络一般不再具有平移不变性。
- 连续位移与离散采样。 真实图像中的亚像素位移,或谱线中峰位的连续偏移,要经过采样或插值才变成数组,这不再是整数下标的平移,式 (33) 的证明不能直接覆盖。
如果希望整个网络对平移不变,常用的做法是在卷积层之后接全局平均池化(第 4.4.4 节):对每个通道的整张特征图取平均。若特征图满足等变性,且平移只是把同一组数值在网格内重新排列,那么平均值不变,即 。当图样移出视场、补零改变了特征,或者下采样引入了混叠时,这个前提不再成立 [24]。第 4.9.1 节将用实验比较 MLP 与 CNN 在输入平移时的表现。
补充:卷积与平移等变的等价性 上面证明了“卷积 ⟹ 平移等变”。反过来也成立:在有限长的周期网格上,任何与所有循环平移操作可交换的线性映射,都可以写成循环卷积的形式(对应的矩阵是第 4.7.1 节将介绍的循环矩阵)。从这个意义上说,卷积是“具有平移对称性的线性映射”的唯一形式。
4.3.3 感受野:每个神经元能看多远
第一层的一个输出只依赖原图中的 个像素。第二层再处理第一层特征图上相邻的 个输出,就把这些输出各自对应的原图区域联系起来了。在两层步长都为 1 的情况下,这些区域合起来覆盖原图中的 范围。
这样逐层组合,就能从局部变化走向更大范围的结构。一个神经元在原始输入上能够“看到”的区域,称为它的感受野(receptive field)。计算感受野时始终要回到原始输入,不能只看它在上一层连接了几个数。
核大小 k
前两层步幅 s
膨胀率 d
理论感受野7输入位置
实际覆盖7
有效感受野标准差1.4≈ √L 增长(无膨胀时)
每通道参数9
顶层中心神经元的感受野底部柱高 = 输入对该神经元的梯度权重(核权重均为 1/k)
参与计算的节点
如果中间还做了下采样,特征图上相邻两个位置就不再对应原图上相邻的两个像素。因此,除了记录覆盖范围,还需要记录位置之间的间隔。
设第 层的核尺寸为 、步长为 。用 记录累积步长,也就是这一层相邻两个位置的中心在原始输入上相隔多少个像素。起点取 、。在不使用空洞卷积时,感受野按下面的关系逐层增加 [23]:
这个公式可以这样理解:第 层的神经元把第 层的 个相邻神经元组合起来;这 个神经元中,首尾两个的中心在输入上相距 个像素,再加上单个神经元自身覆盖的宽度 ,就得到式 (34)。池化层同样适用此式,只需把 、 换成池化窗口的尺寸和步长。对于非方形的核,高、宽方向分别计算即可。
下面用一个七层网络演示递推过程,结果列于表1。
表1 一个七层网络的感受野递推(式 (34))。 池化层使累积步长翻倍,此后每个 卷积层使感受野增加的量也随之翻倍。
| 层 | 类型 | 累积步长 | 感受野 | ||
|---|---|---|---|---|---|
| 0 | 输入 | — | — | 1 | 1 |
| 1 | Conv | 3 | 1 | 1 | |
| 2 | Conv | 3 | 1 | 1 | |
| 3 | MaxPool | 2 | 2 | 2 | |
| 4 | Conv | 3 | 1 | 2 | |
| 5 | Conv | 3 | 1 | 2 | |
| 6 | MaxPool | 2 | 2 | 4 | |
| 7 | Conv | 3 | 1 | 4 |
如果只堆叠步长为 1 的 卷积层,感受野为 ,要达到 24 以上需要 12 层;而上表在适当位置加入两次步长为 2 的下采样,7 层就能达到 24。原因是下采样增大了相邻位置在原图上的间隔,同样大小的后续窗口就能联系更大的区域。图 11 画出了这个增长过程;下一节会说明降低分辨率同时会丢掉哪些细节。
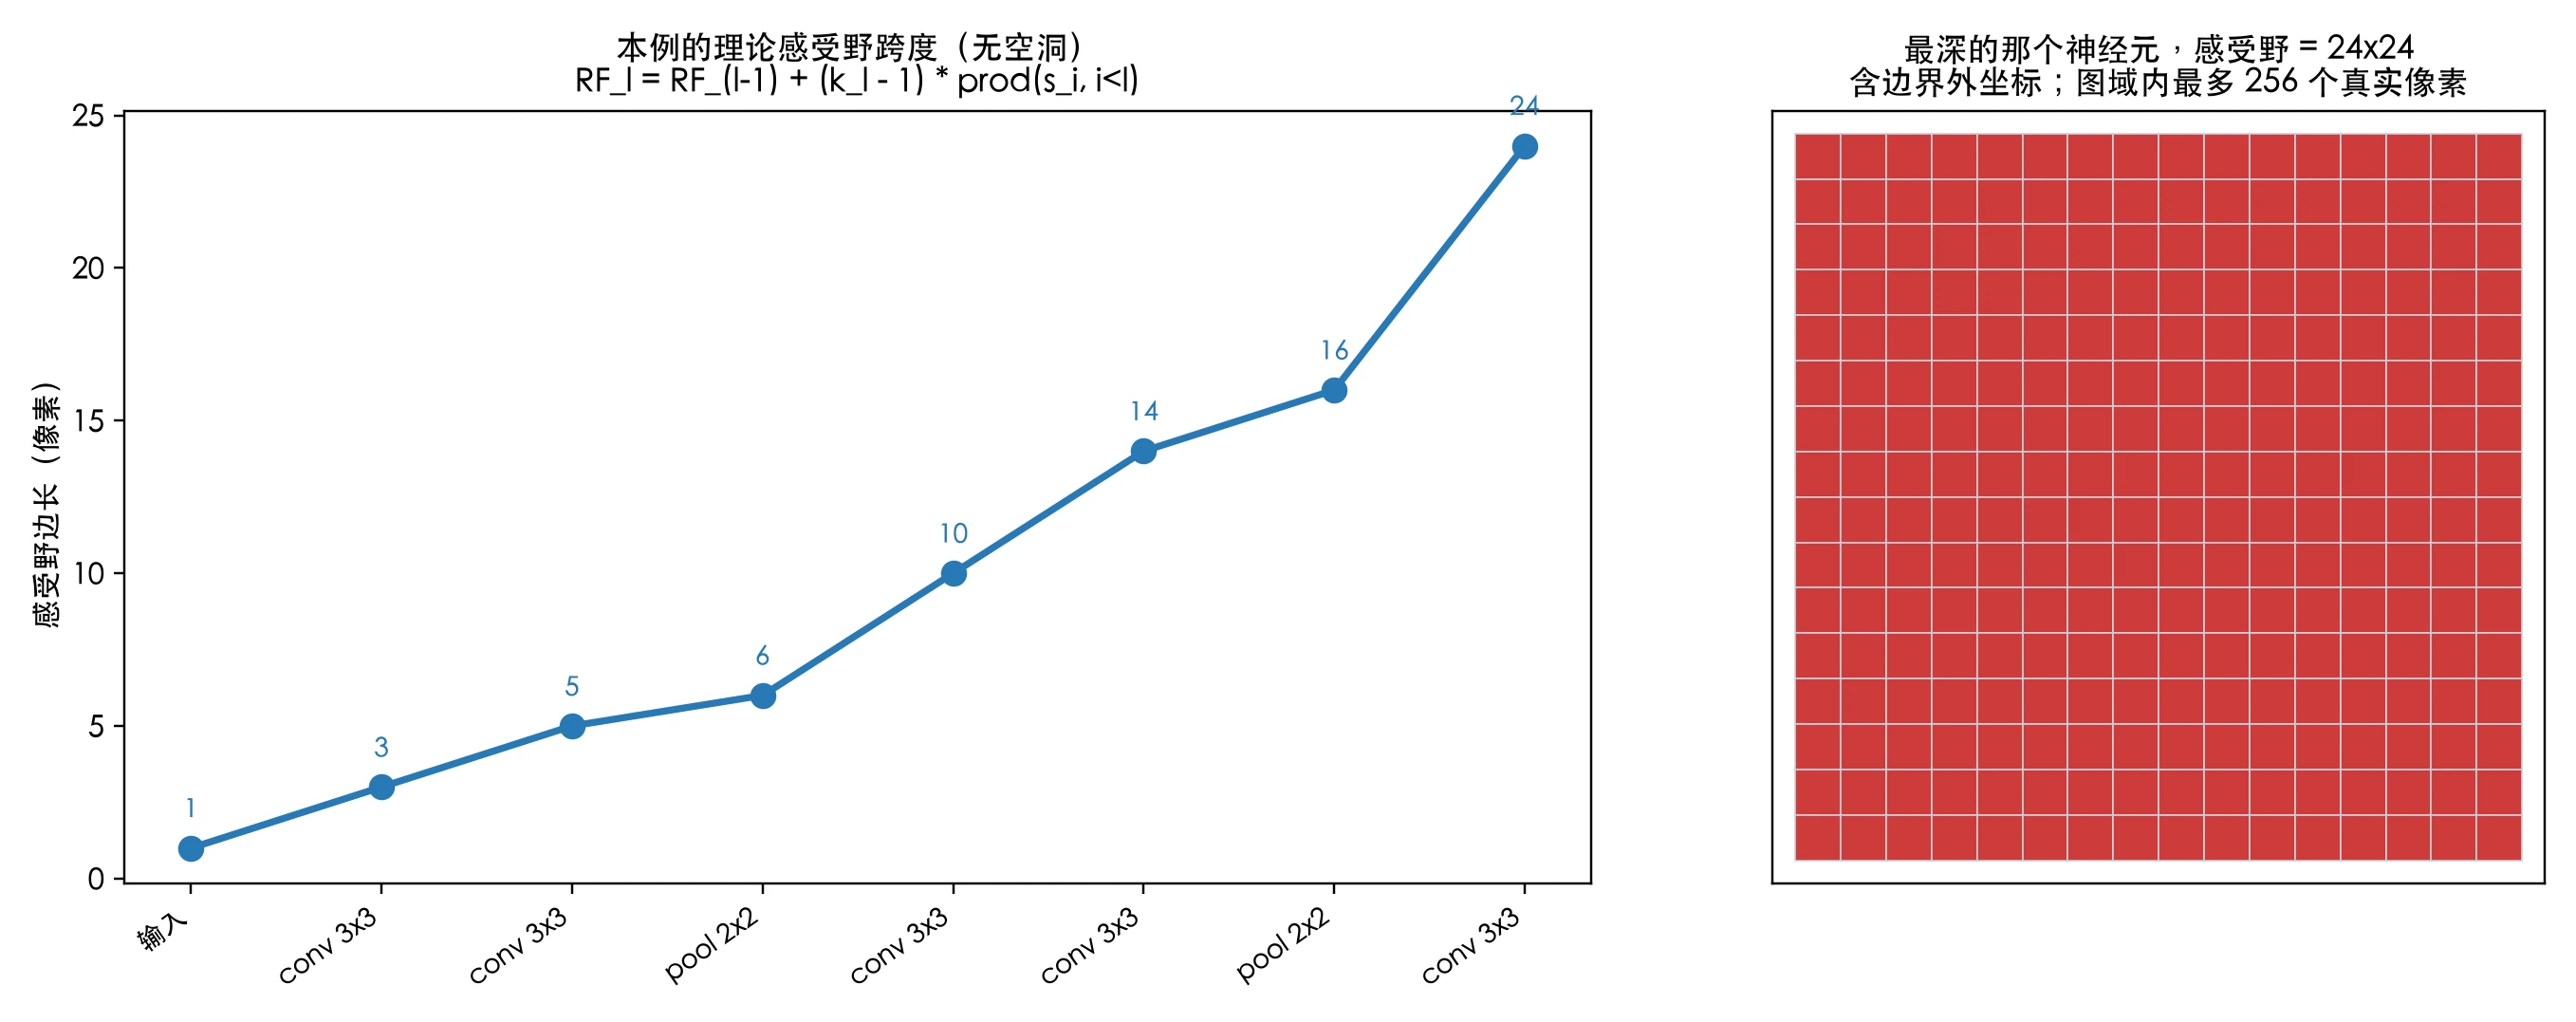
式 (34) 回答的是“哪些输入位置有可能影响这个输出”,因此称为理论感受野。它并不表示这些位置的影响同样大。对于这里讨论的堆叠结构,靠近中心的位置往往有更多计算路径通向输出;各位置实际影响多大,还要结合权重和激活来检查。第 4.7.5 节会用“有效感受野”进一步描述这个差别。
由局部到整体:层级特征
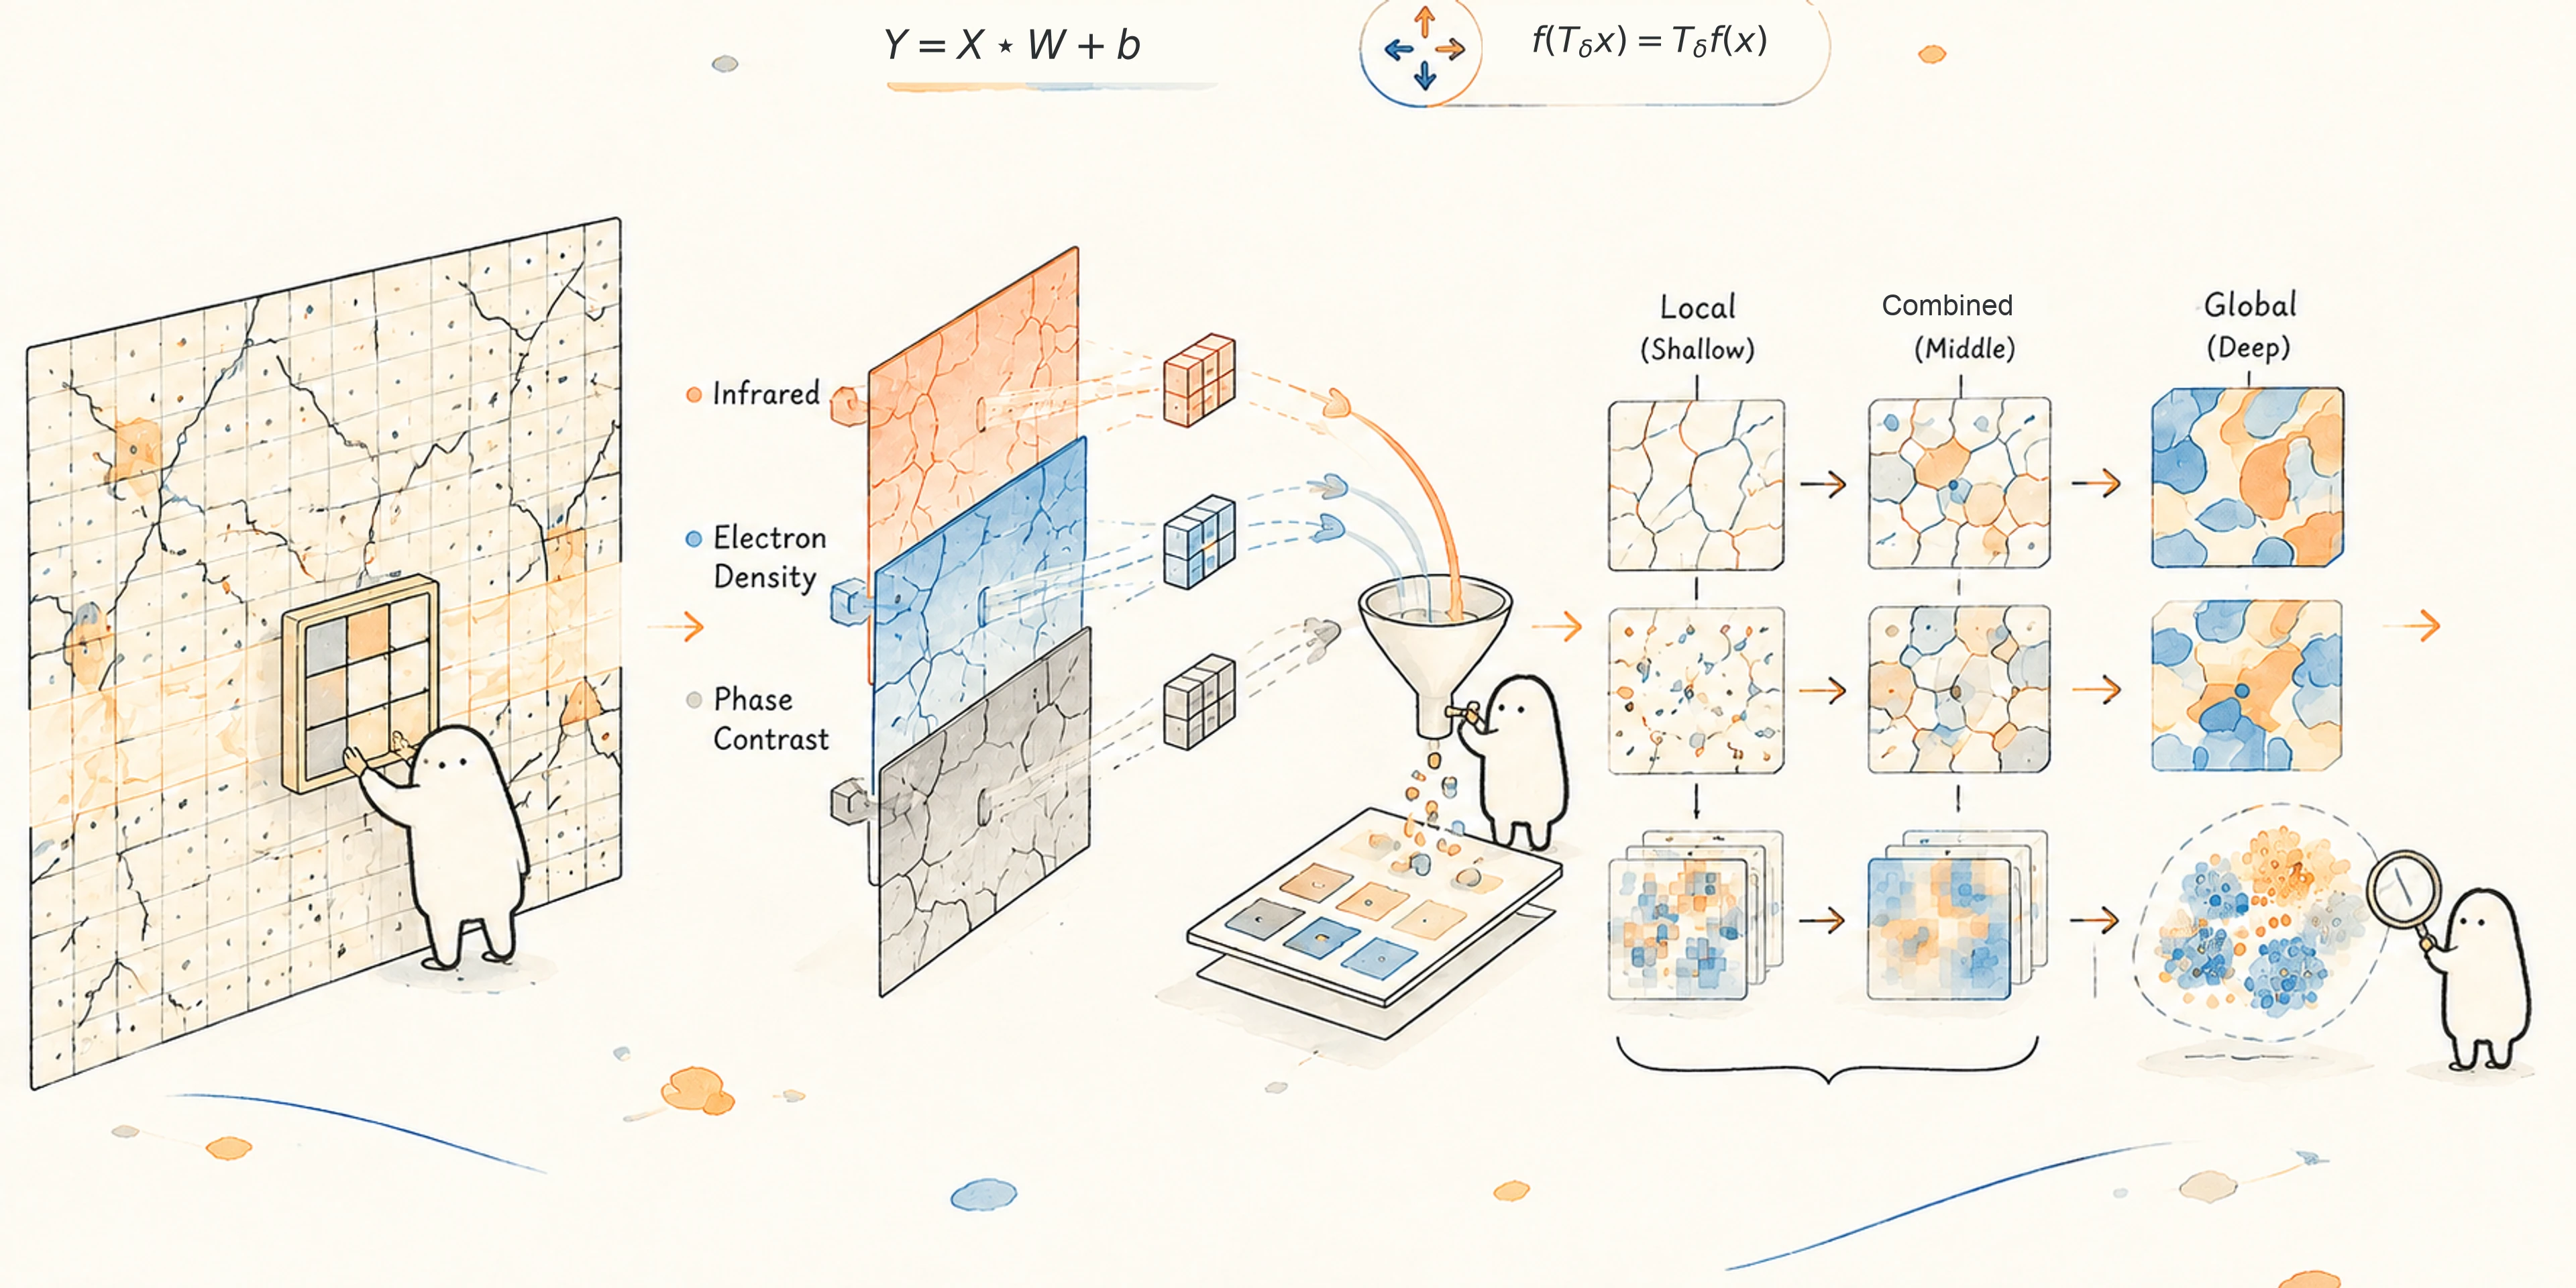
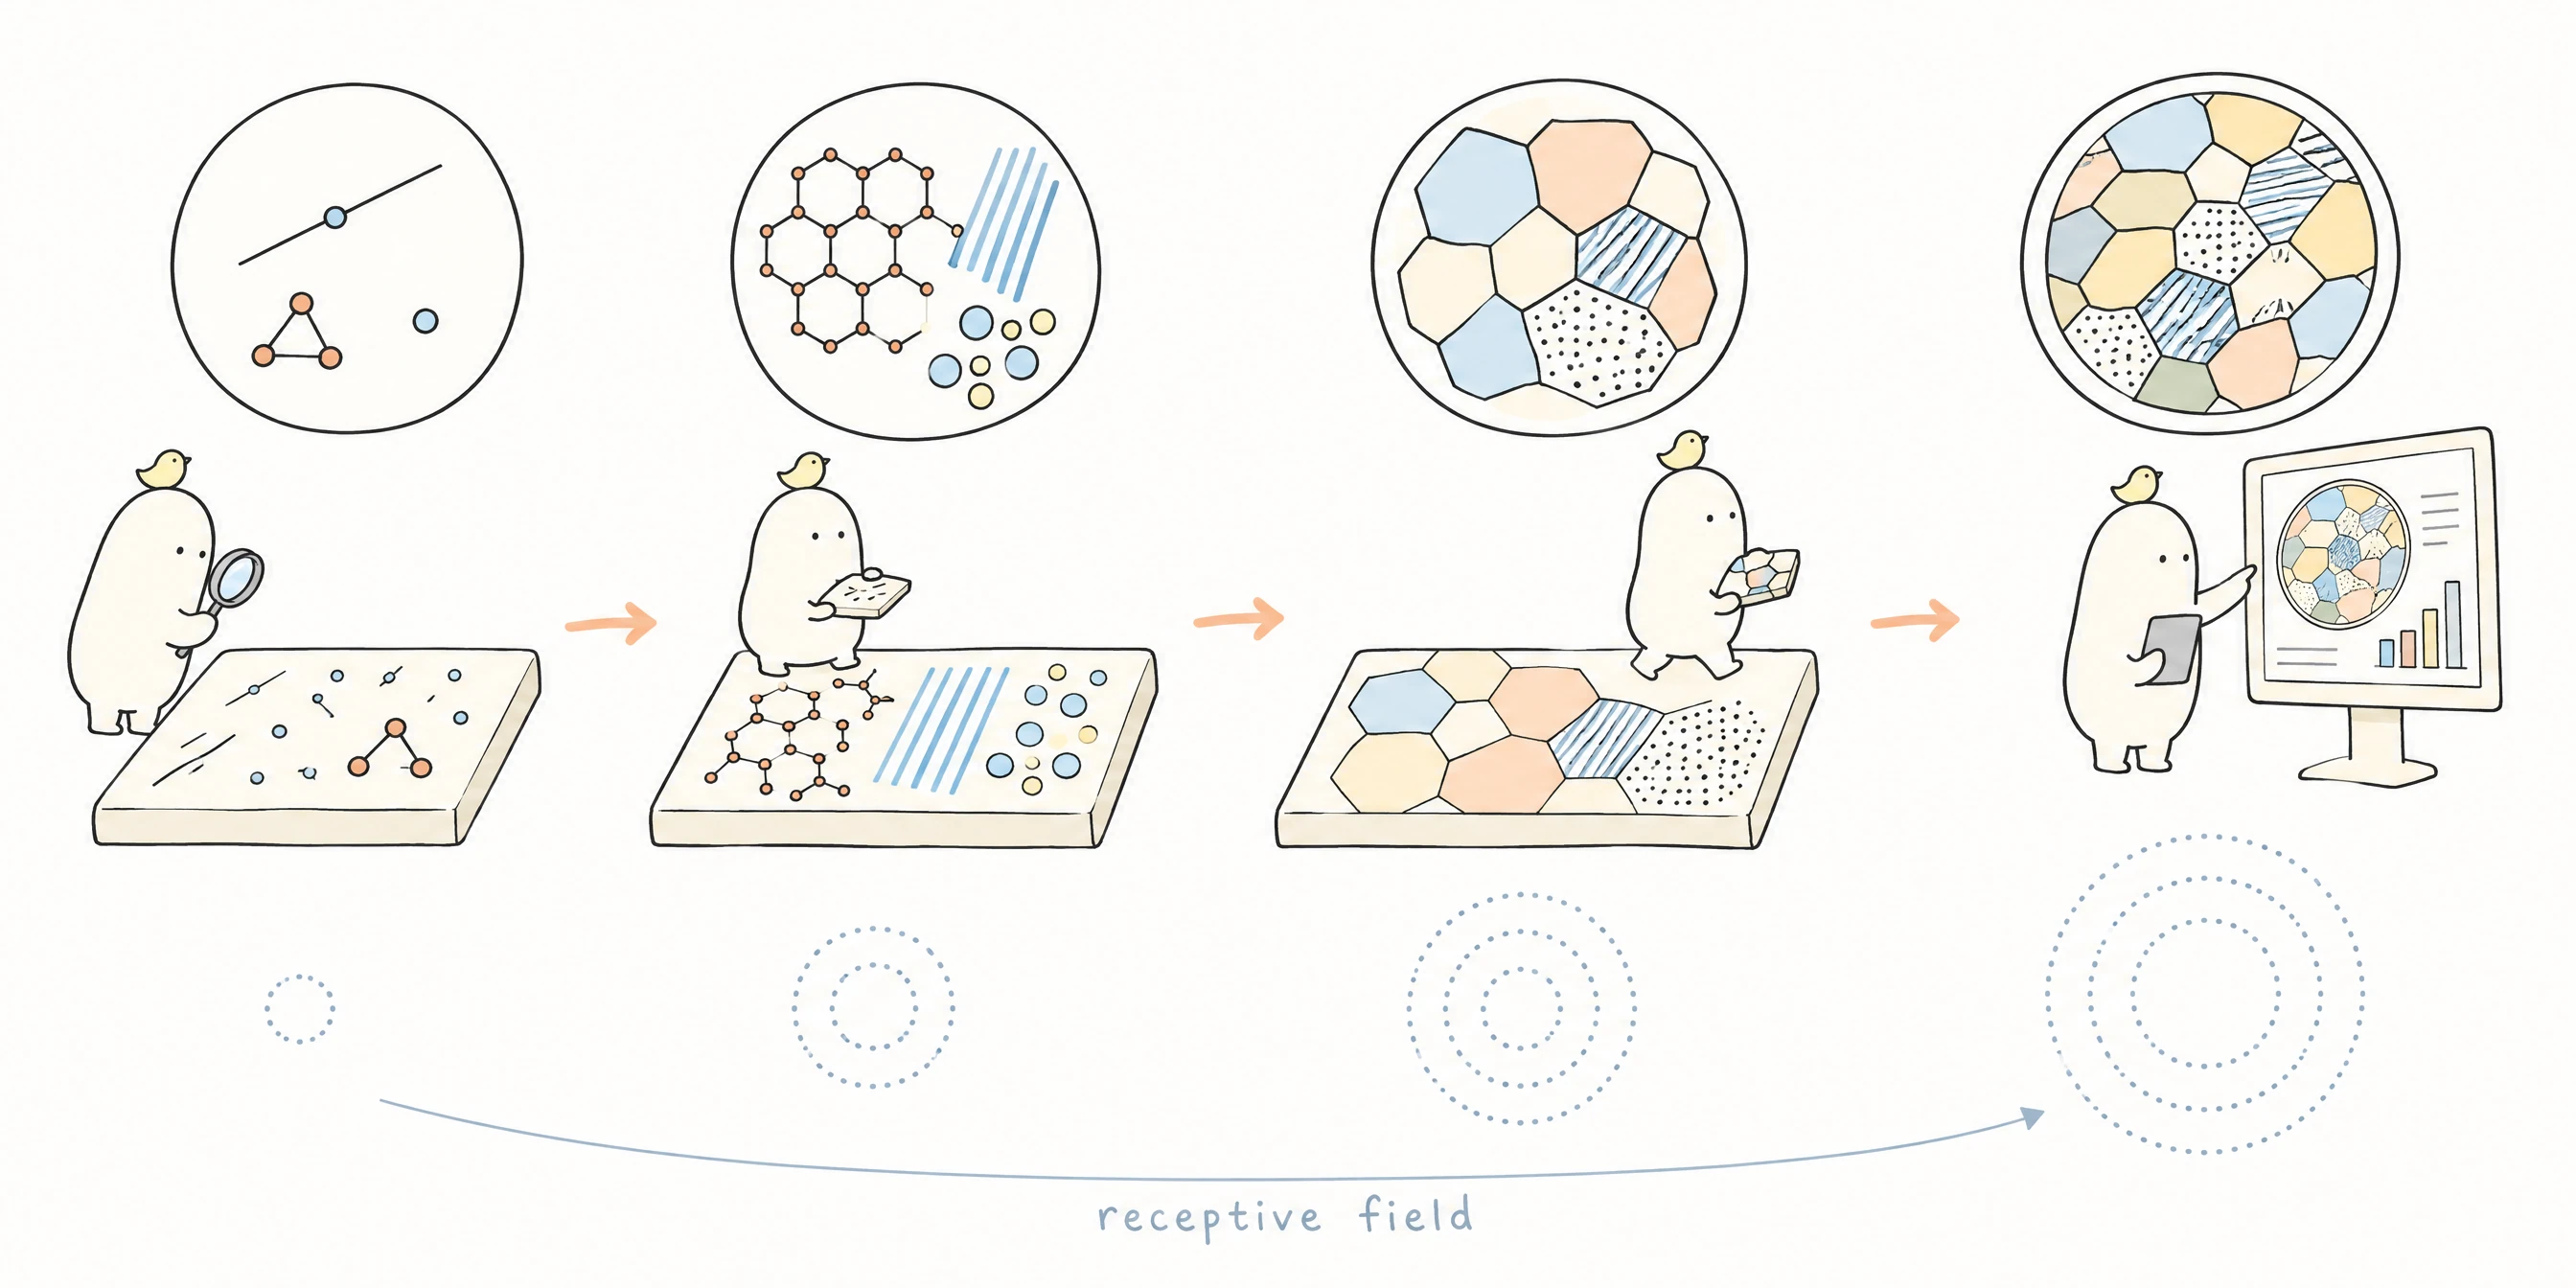
感受野随深度增长,意味着不同深度的层自然地处理不同尺度的信息:浅层神经元只看到几个像素,适合响应边缘、斑点这类局部图样;深层神经元覆盖大片区域,可以组合浅层的局部响应,描述更大尺度的结构。图 12 用材料显微组织作类比,示意了这种“由局部到整体”的层级组合。
4.4 池化、激活函数与常用组件
卷积把输入变成了一组特征图。继续向后计算时,还需要决定两件事:是否把这些图缩小,以减少后续计算;怎样在多次加权求和之间加入非线性处理。池化和激活函数分别承担这些工作。理解它们后,就可以在下一节把完整网络连接起来。
降低特征图分辨率有两个好处:减少后续层的计算量,并像第 4.3.3 节所示那样成倍扩大后续层的感受野。以显微图像为例, 池化把相邻四个响应汇总为一个数,使后面的卷积核覆盖更大的原始区域。代价是丢失了这四个位置的细节:最大池化只保留最强的响应,均值池化只保留平均值。如果研究目标是颗粒尺寸统计或微小缺陷定位,过早降采样可能丢掉关键信息。
4.4.1 最大池化
先看一种常见做法:把一个小窗口中的最大值留下,其余值不再传给下一层。这叫作最大池化(max pooling)。它也使用滑动窗口,不过窗口里不再做加权求和,而是直接取最大值。对每个通道,计算为:
池化方式
窗口 = 步幅
输入平移 / 数据
输出尺寸3 × 3参数 0 个
选中单元输出5
接收梯度的输入位置9 / 36
平移 1 像素后不变的输出78%局部平移不变性
池化的前向与反向橙色框为选中窗口,粗框为最大值位置
最常见的配置是 、:窗口互不重叠,特征图的高和宽各减半(奇数尺寸时向下取整,最后一行或一列被舍弃)。池化对每个通道独立进行,因此通道数不变;它也没有任何可训练参数。图 13 展示了一个 输入的计算过程。
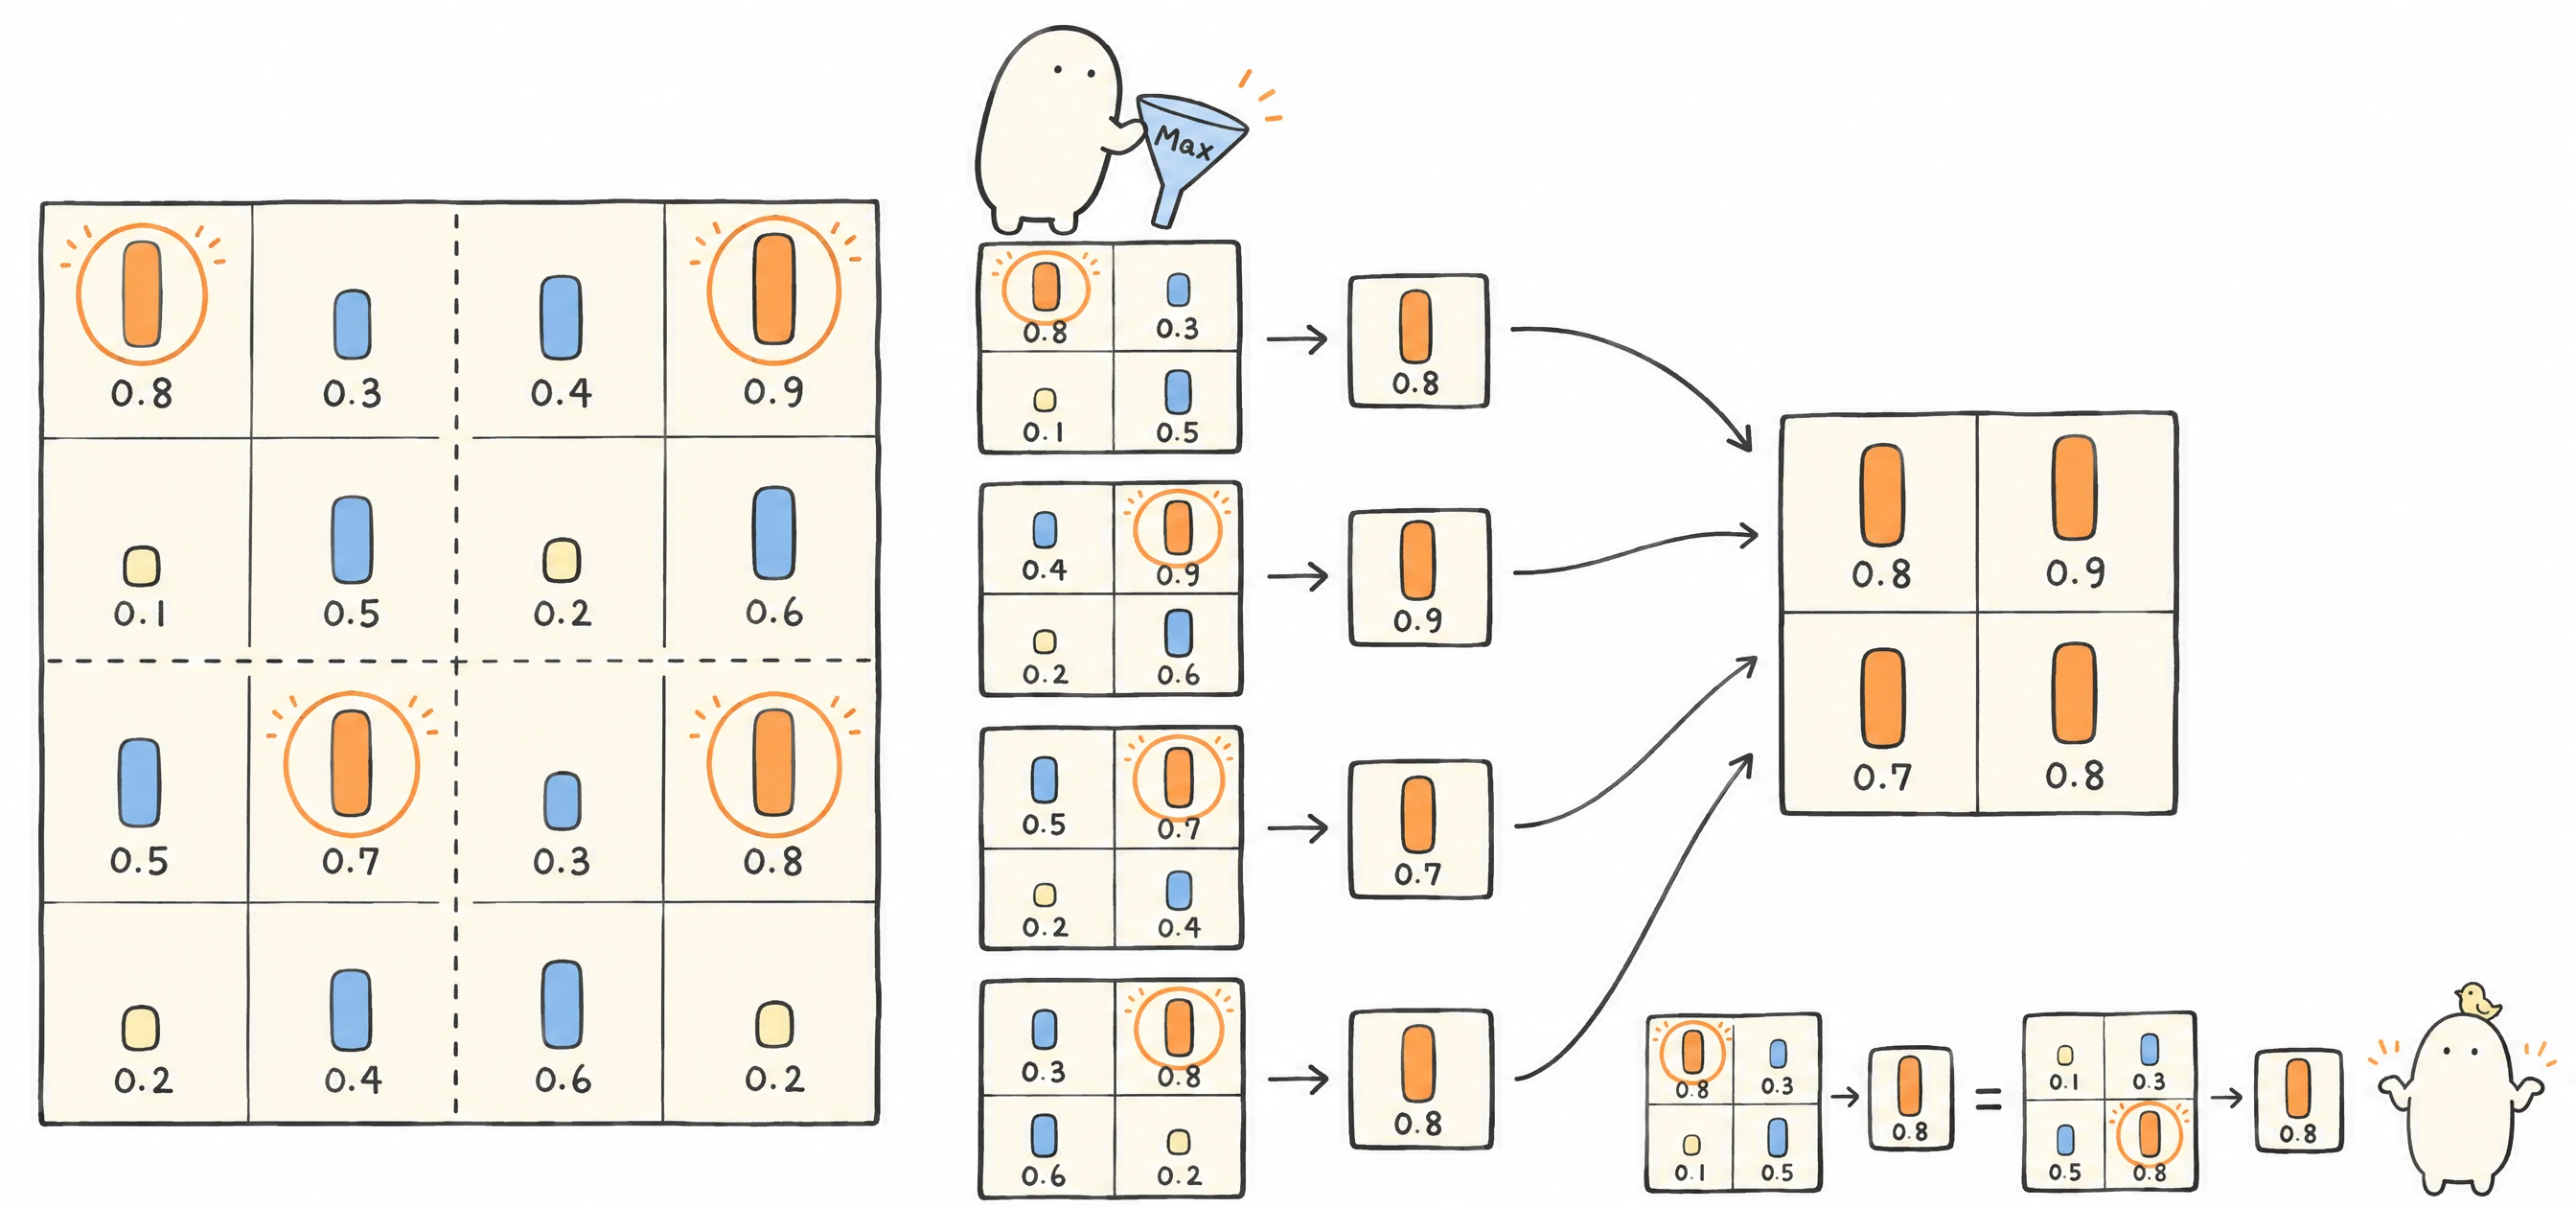
最大池化有三个作用:
- 降低特征图的分辨率,减少后续计算和存储;
- 如第 4.3.3 节所述,使后续卷积层的感受野成倍增大;
- 对窗口内的小扰动不敏感:只要每个窗口的最大值不变,输出就不变,因此对小于窗口尺寸的位移有一定的鲁棒性。
注意:池化会丢失信息 最大池化把四个数压缩成一个,无法从输出恢复输入。它对窗口内的随机噪声也并非天然免疫:一个异常大的噪声点恰好会成为窗口的最大值。此外,降采样可能造成混叠(高频信息被错误地折叠成低频),普通的步长卷积同样有这个问题。对定位精度要求高的任务,可以考虑先低通滤波再下采样 [24],或使用保留高分辨率信息的跳跃连接(如 U-Net [21])。
4.4.2 池化的反向传播
池化本身没有权重,但它前面的卷积层需要训练,所以梯度仍要经过池化层传回去。本小节先把计算方法放在这里,便于查询;第一次阅读时可以先记住“最大值留下,梯度也回到该位置”,到第 4.6 节再结合完整的训练过程阅读公式。
假设窗口内有唯一的最大值。只要最大值的位置不变,稍微改变其他输入就不会改变池化输出;改变最大值,则会等量改变输出。因此,梯度只传给最大值所在的位置。记这个位置为 ,则窗口 对输入梯度的贡献为
用导数表达就是: 对唯一最大值变量的偏导数为 1,对其余变量的偏导数为 0。若窗口有重叠(),同一个输入位置可能收到多个窗口传来的梯度,需要把它们相加。
并列最大值是一个特殊情况:此处没有通常意义下的导数。任选一个最大值位置接收梯度,或在并列位置间按总和为 1 的非负权重分配,都对应合法的“次梯度”。本章代码采用最直接的约定:前向时记录扫描到的第一个最大值位置,反向时按这份记录传递梯度。
对于最常用的不重叠 池化,每个窗口的梯度只流向四个位置中的一个,其余三个位置的梯度为零。
均值池化的反向传播
**均值池化(mean pooling)**对窗口内的所有元素取算术平均:
它对窗口内每个输入的偏导数都是常数 。设窗口为 ,记损失对池化输出的梯度为 ,则每个窗口把梯度平均分给窗口内的所有输入:
对于 的均值池化,一个窗口的输出梯度就被平均分成四份。理解这一点,已经能够按式 (38) 编写代码。若希望把整张图的操作写成一个式子,在窗口不重叠(步长等于 )、不补零、输入尺寸能被 整除时,可以使用下面的克罗内克积:
其中 表示元素全为 的 矩阵,克罗内克积把 的每个元素“放大”成一个 的常数块。图 14 对比了两种池化的梯度分配方式。
查看一个输出对应的梯度,再比较所有输出的重叠贡献。
输入与当前窗口
1320421501322416
池化输出
4546
当前输出的梯度
0000100000000000
全部输出的累加梯度
0000100100000101
第 1/4 个窗口;“全部梯度”对应 L=ΣY。
思考与说明
思考步长为 1 时,同一格子的梯度为什么可能大于 1?
每个输出的上游梯度设为 1;并列最大值选行优先第一个位置。
4.4.3 激活函数:为什么选 ReLU
现在再看卷积层输出的数值怎样交给下一层。如果仅把卷积层直接串起来,中间不做其他处理,整体仍然只是对输入加权求和并加上偏置。为了表示更复杂的关系,通常会在卷积层后逐元素应用一个非线性函数。
常用的**整流线性单元(ReLU)**规则很直接:正值保留,负值改成 0。它不改变特征图的形状,只改变其中的数值。前面介绍的最大池化本身也具有非线性,但它还会汇总窗口;这里的 ReLU 则对每个位置分别处理:
ReLU 在 处不可导,代码中约定此处导数取 0。与 Sigmoid 函数 和双曲正切 相比,ReLU 有三个优点。
计算简单。 Sigmoid 和 tanh 需要计算指数和除法,ReLU 只需与零比较一次。在一幅特征图有上万个元素、网络有几十层的情况下,这一差别相当可观。
缓解梯度消失。 Sigmoid 的导数为
最大值只有 0.25(在 处),当 较大时更是趋近于零(饱和)。反向传播时梯度要逐层乘以激活函数的导数,多个小于 0.25 的因子相乘会使梯度迅速变小。ReLU 在正半轴的导数恒为 1,消除了激活函数自身造成的衰减。当然,梯度还要乘以各层的权重矩阵,ReLU 并不能单独保证深层网络的梯度稳定,第 4.7.5 节将进一步讨论。
稀疏激活。 负输入被置零,因此输出中可能有许多零值,这称为稀疏激活。具体有多少位置为零,取决于数据、偏置和初始化,并没有固定的比例。
ReLU 也有缺点:如果某个神经元的输入总是负的,它的梯度永远为零,参数不再更新(俗称“死亡 ReLU”)。Leaky ReLU、GELU 等变体可以缓解这一问题。
4.4.4 常用网络组件
卷积、ReLU 和池化已经可以组成一个基本网络。阅读实际模型时,还会遇到下面几种组件。先了解每种组件解决什么问题,后面在代码中遇到它们时再对照具体计算。
- 全局平均池化(global average pooling, GAP):对每个通道的整张特征图求平均,把 的张量压缩为 维向量 [14]。它可以代替网络末端参数众多的全连接层,并减少分类结果对位置的依赖(第 4.3.2 节)。
- 批归一化(batch normalization):训练时对每个通道,在一个小批量的所有样本和所有空间位置上计算均值和方差并做标准化,再乘以可学习的缩放系数、加上可学习的偏移;推理时改用训练中累积的统计量 [15]。它通常能让训练更快、更稳定。
- Dropout:训练时随机把一部分激活置零,并对其余激活相应放大,是一种正则化手段,用于减轻过拟合 [16]。
- 残差连接(residual connection):把某几层的输入直接加到它们的输出上,即 ,为梯度提供一条“直通”路径,使很深的网络也能有效训练 [12]。
- 空洞卷积(dilated convolution):在卷积核的采样点之间插入间隔,在不增加参数的情况下扩大感受野 [17]。
第 4.8 节的纯 Python 实现只包含最基本的 Conv2D、MaxPool2D、ReLU、Flatten、GlobalAvgPool 和 Dense 六种层,以便把注意力集中在核心运算和梯度推导上;第 4.9.1.2 节的 PyTorch 例子则会用到批归一化、Dropout 和全局平均池化。
4.5 前向传播
各个组件已经准备好了。现在跟着一张图像走一遍:它先变成多张局部响应图,再缩小、再组合,最后得到几个类别的预测概率。按照当前参数从输入一路算到输出,这个过程就叫作前向传播。
跟踪时先关注每一步剩下几张图、每张图多大。这就是检查张量形状。通道数、池化后的尺寸和全连接层的输入长度需要相互匹配;只看网络名称而不核对形状,很容易把层接错。
4.5.1 网络结构与形状跟踪
沿用前面的小图像,输入是一张 的灰度图,最终需要判断它属于三类中的哪一类。下面所有三元组都按“通道数、高度、宽度”排列。例如, 表示 4 张 的特征图。这个网络也会用于第 4.9.1 节的形状分类实验:
- 输入:。
- 第一卷积块:
Conv2D(1→4, k=3, s=1, P=1):参数量 ;由于 ,尺寸不变,输出 ;ReLU:形状不变,;MaxPool2D(k=2, s=2):高、宽减半,输出 。
- 第二卷积块:
Conv2D(4→8, k=3, s=1, P=1):参数量 ,输出 ;ReLU:;MaxPool2D(k=2, s=2):输出 。
- 分类头:
Flatten:展平为长度 的向量;Dense(72→3):参数量 ,输出 3 个类别得分(logits);Softmax:把得分转换为概率。
全网络共有 个参数。作为对比,一个两层 MLP(144 个输入 → 48 个隐藏单元 → 3 个输出)有 个参数,约为 CNN 的 13 倍。
4.5.2 前向公式
上面的流程可以用一组统一符号记录。 记录加权求和并加上偏置后的数值, 记录经过激活函数后的数值;上标 表示第几层。把卷积或全连接这类带参数的计算记为 ,就有
其中 表示这一层的权重与偏置, 就是原始输入。式 (42) 概括了带参数层和激活的计算,池化与展平仍按上一小节的顺序插入。最后一层输出的是类别得分,称为 logits;本例在它后面使用 Softmax 得到概率,不再使用 ReLU。
得到概率后,还需要一个数来衡量预测与真实标签的差距。本例使用交叉熵损失:
其中 是样本的真实类别编号, 是模型赋予真实类别的概率。模型越确信正确答案, 越接近 1,损失越接近 0。
4.5.3 Softmax 的数值稳定性
前面把类别得分转换成了概率。写代码时,这一步还有一个需要处理的细节:指数计算的结果可能超出计算机能表示的范围。先看 Softmax 的定义,它把 个得分 转换成概率:
直接按定义计算有溢出风险:双精度浮点数在 时 就会溢出为 inf。由于分子分母同乘 不改变结果,实际计算时先减去最大值 :
这样每个指数都不超过 1,且至少有一个等于 1,从而避免了上溢。但很小的概率仍可能下溢为 0,此时再取对数会得到 。因此,计算交叉熵时不应该“先算概率再取对数”,而应直接从 logits 出发:
这就是常说的 log-sum-exp 技巧,它在数学上严格等于 。举一个极端的例子:,真实类别为 1(从 0 编号),式 (46) 给出损失约 2000,第 4.6.1 节将推导出相应的梯度约为 ——即使预测错得离谱,损失和梯度仍然是有限且有意义的。第 4.8 节代码中的训练循环和梯度检查都使用这种写法(函数 cross_entropy_logits);PyTorch 的 CrossEntropyLoss 同样直接接收 logits [42]。
4.6 反向传播:完整的数学推导
前向传播已经给出了预测和损失,但还没有告诉我们权重应该怎样改。训练要继续计算:某个权重稍微增加一点,损失会增大还是减小,变化有多快?这些变化率就是损失对参数的梯度。
求法仍然是上一章的链式法则。卷积层的特别之处在于,同一个权重会使用很多次,同一个输入也可能进入多个窗口。因此,要把同一变量通过不同计算路径产生的影响加起来。
下面先用一个一维小例子看清累加,再从输出层沿网络反向计算。第一次阅读时,重点理解第 4.6.0 节的两种累加、第 4.6.3 节的三个梯度,以及第 4.6.5 节的完整流程。矩阵推导用于对照实现,有限差分则用于检查求导结果。
4.6.0 核心直觉:两种“复用”与梯度累加
回顾窗口滑动的过程,可以找到两种需要累加的情况:
- 同一个权重用于许多位置。 卷积核在所有窗口位置共享,所以一个权重的梯度要把它在所有位置的贡献加起来。
- 同一个输入像素出现在多个窗口中。 相邻窗口相互重叠,所以一个输入像素的梯度要把所有覆盖它的窗口的贡献加起来。
这两条都是多元微积分链式法则的直接推论:如果一个变量通过多条路径影响损失,它的梯度就是各条路径贡献之和。下面先用一个最小的一维例子体会这一点。
设一段谱线有 3 个采样点 ,卷积核为 。步长为 1 的互相关输出两个值:
中间的 同时参与了 和 的计算。因此,改变 会通过两个输出影响最后的损失。设后面的层已经算出了损失对这两个输出的梯度,分别记为 、。由链式法则:
两条路径的贡献相加。同理,,。图 15 代入具体数值演示了这一过程。
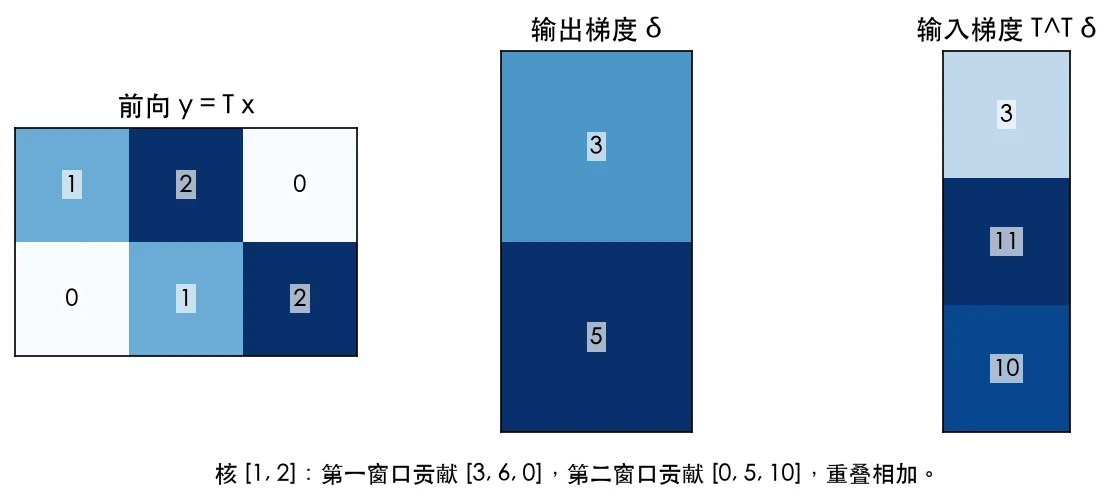
这个例子揭示了一个普遍规律:前向计算把一个窗口内的输入“收集”成一个输出,反向计算则把每个输出的梯度乘以对应的权重,“分发”回该窗口内的每个输入位置,重叠处累加。在矩阵语言中,前向是乘以 ,反向是乘以 。
回到完整网络,需要先从损失算出输出层的梯度,经过全连接层,再传回卷积层。到了卷积层,我们先分析单通道、步长为 1 的小例子,再推广到多通道和任意步长。第 4.6.4 节会把同样的计算改写成矩阵形式,与代码中的 col2im 累加对应起来。
4.6.1 起点:Softmax 与交叉熵的梯度
先求损失对最终类别得分 的梯度,这是反向传播的起点。由于一个得分会同时影响多个类别的概率,需要先求出各概率对各得分的偏导数;把这些偏导数排成矩阵,就是 Softmax 的雅可比矩阵。
下面分别计算两个得分下标不同和相同的情况。当 时,由商的求导法则:
当 时:
用克罗内克符号 ( 时为 1,否则为 0)可以统一写成
再代入交叉熵 :
把各类别的结果放回一个向量,得到:
其中 是真实类别的独热(one-hot)向量:真实类别对应的位置为 1,其余位置为 0。因此,损失对输出得分的梯度就是预测概率与这个标签向量之差。正确类别的预测概率越接近 1,这个向量就越接近零。它还需要继续经过前面的层,才能得到各权重的梯度。
回到第 4.5.3 节的极端例子,、,梯度约为 。代码中只需两行:
python
d = list(probs)
d[label] -= 1.0 # 即 p - onehot(y)4.6.2 全连接层的梯度
在进入卷积层之前,先回顾全连接层。为与第 4.8 节代码一致,把权重存为 ,前向计算写作 ,其中 、 都是列向量。写成分量形式 ,各局部偏导数为:,,。由链式法则:
写成矩阵形式:
权重梯度是输入向量与输出梯度的外积;输入梯度是用权重矩阵把输出梯度“传回”输入空间。这与第 03 章的结果相同,只是此处权重矩阵存储为转置形式。
4.6.3 卷积层的梯度
交互图表 卷积互相关前向与转置反向传播。 点击节点锁定关键算子,拖动参数滑块检验公式中的定量权衡。
查看的梯度
数据
偏置梯度 ∂L/∂b = Σδ6
∂L/∂W(0, 0)0
参与求和的项数9总是 M² = 9
有限差分(+1 扰动)0 ✓L = Σ Y⊙δ 是线性的
形状3×3 = W
卷积层的反向传播橙框标出参与当前元素求和的全部项
到了卷积层,需要完成三项计算:偏置的梯度用于调整偏置,卷积核的梯度用于调整权重,输入的梯度用于继续传给前一层。这里“求输入的梯度”是在追踪误差怎样传递,并不意味着训练时要修改原始实验数据。
设后面的层已经算好损失对本层输出的梯度,记为 :
前向计算即式 (16):
4.6.3.1 对偏置的梯度
先看偏置。同一个 被加到第 张输出图的每一个位置上,所以它发生变化时,这张图的所有输出都会受到影响,其他通道不受影响:
由链式法则,偏置的梯度等于该通道所有位置的输出梯度之和:
4.6.3.2 对卷积核的梯度
再固定卷积核中的某一个权重 。窗口每移动一次,这个权重就与一个新的输入数值相乘;它在所有窗口位置上的使用都要计入梯度。具体到窗口 ,与它相乘的是 ,所以
对所有位置求和:
这正是第 4.6.0 节所说的第一种复用:同一个权重在 个位置上都被使用,梯度要把这些位置的贡献全部加起来。对比式 (16) 可以发现,式 (61) 本身也是一个“滑动窗口乘加”:步长为 1 时,它就是输入 与梯度图 的互相关。因此代码中可以复用同一套滑窗逻辑。
4.6.3.3 对输入的梯度
最后固定输入中的一个位置,求 。这次要找的是:哪些窗口曾经用到它?每个这样的窗口都会传回一份梯度,把这些贡献相加,就是该位置的输入梯度。下面先比较一个小矩阵的角点、边点和中心点,再写一般公式。
一个 的例子。 设输入为单通道 矩阵 ,卷积核为 矩阵 ,步长为 1,不补零,偏置为 。为了书写方便,本小节的下标从 1 开始。前向计算输出 的 :
记 。由链式法则 ,考察三个有代表性的位置:
角点 只出现在 中:
边点 出现在 和 中:
中心点 出现在全部 4 个输出中:
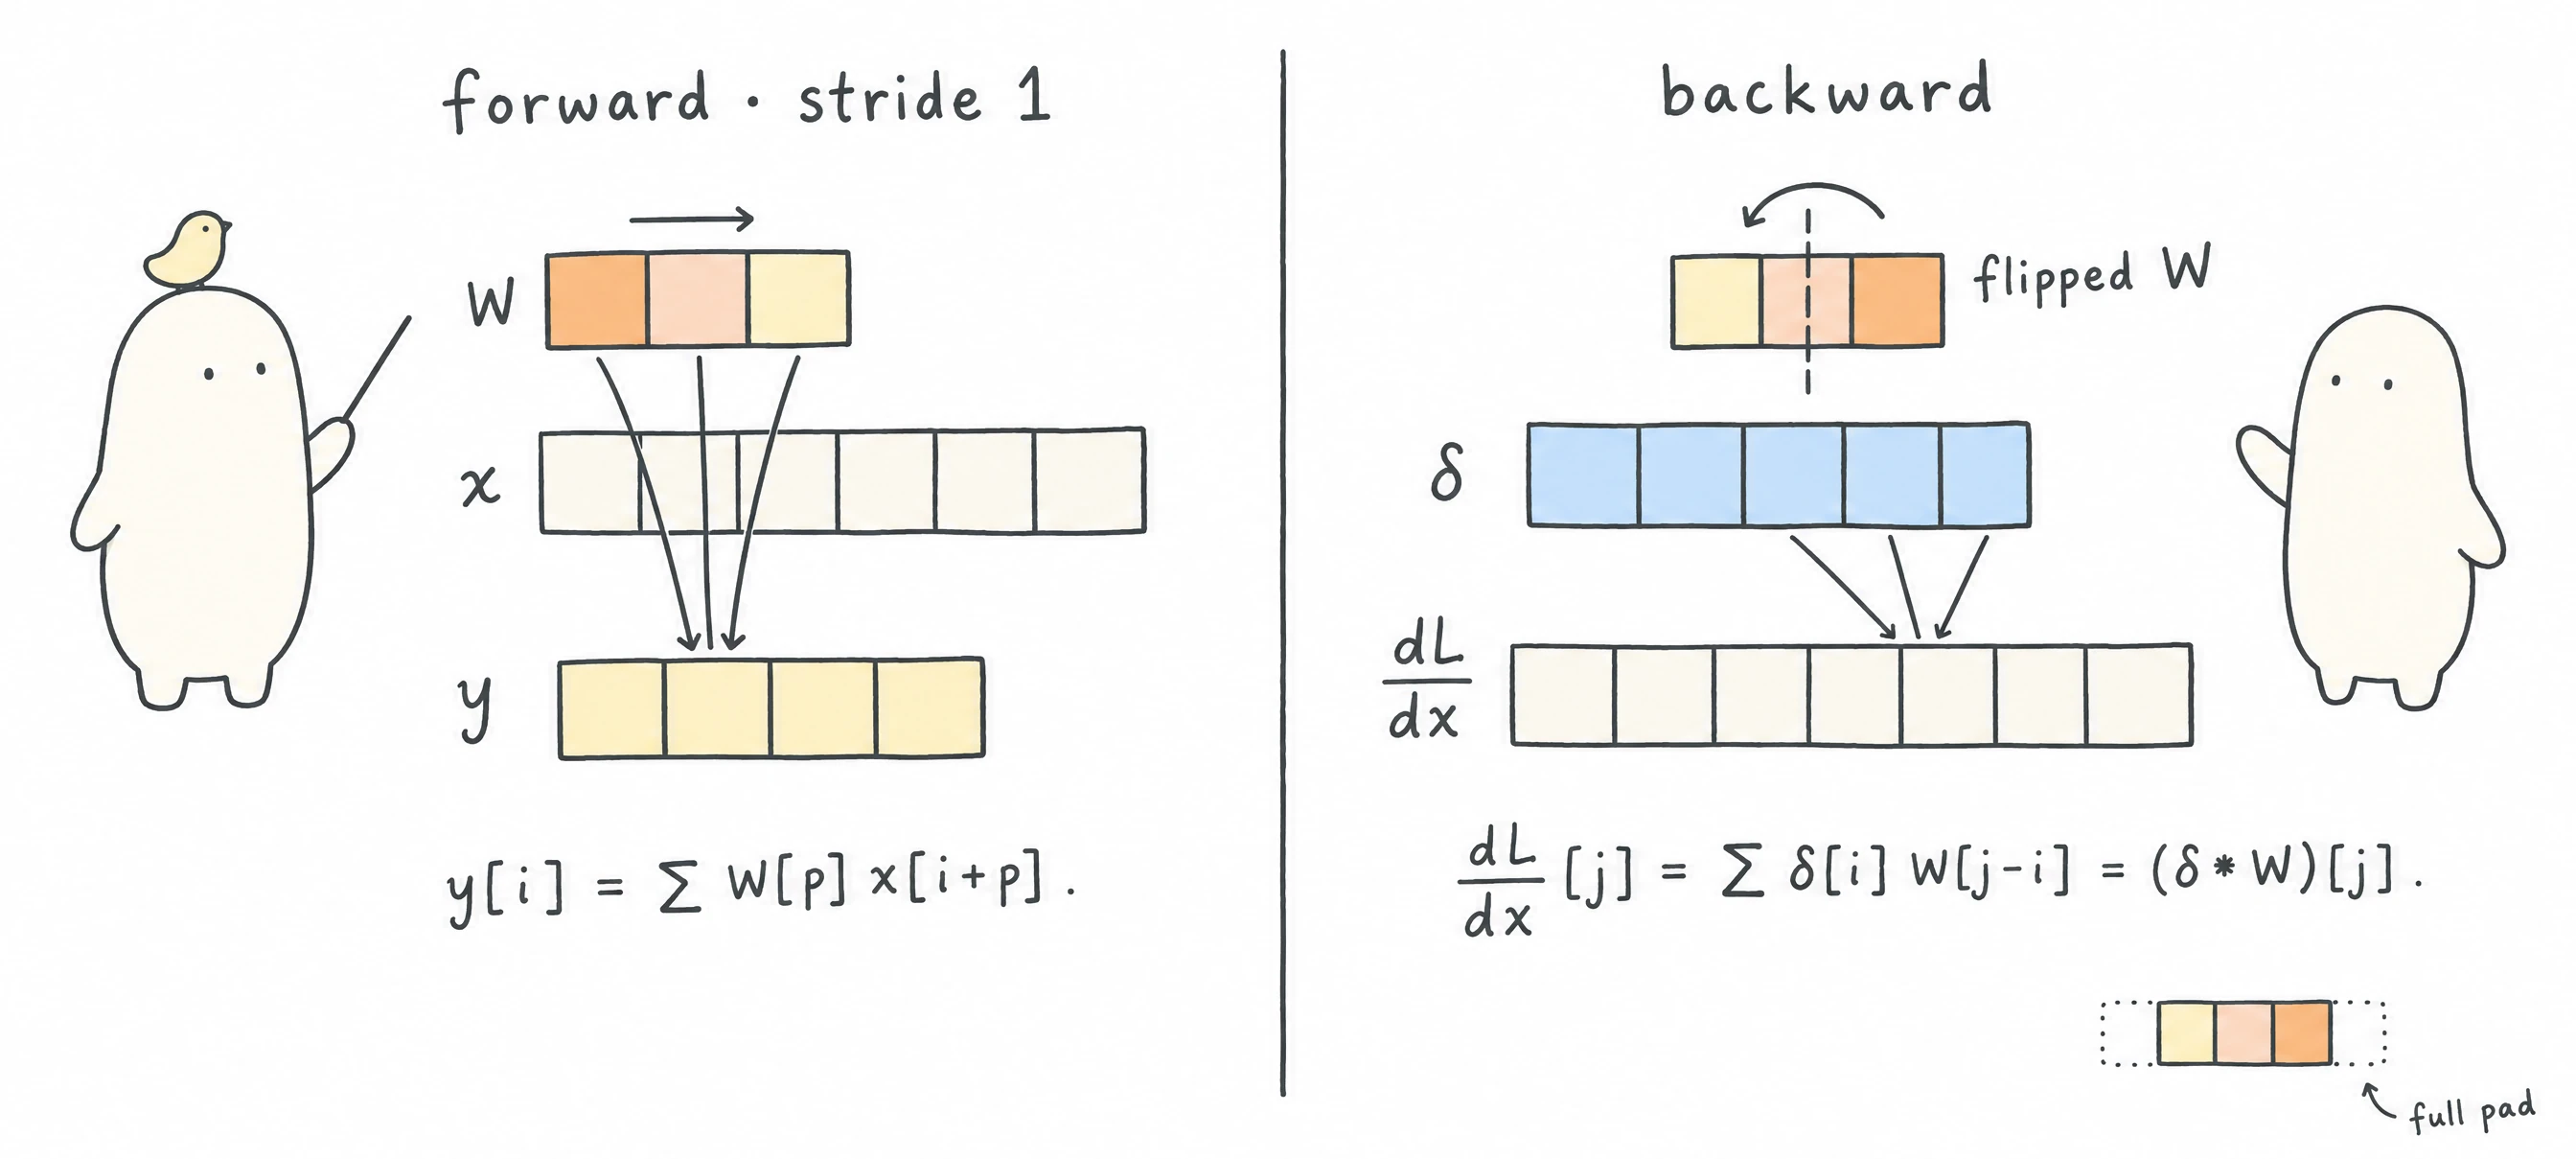
卷积核翻转了 180°。 仔细看式 (65): 按 的顺序排列时,与之相乘的权重依次是 ,正好是把 上下翻转再左右翻转,即旋转 180°,记为 。如果在 的梯度图 四周各补一圈零,得到 的矩阵,再用 在其上做步长为 1 的互相关,得到的 结果与链式法则逐项求出的 完全一致。读者可以用式 (63) 和式 (64) 验证这一点。
回忆第 4.2.2 节:“先翻转核、再做互相关”对应数学卷积。因此,刚才逐位置累加的输入梯度还可以写成:
卷积层对输入的梯度,等于输出梯度图与原卷积核的“全”数学卷积(full convolution,即输出尺寸为 ,相当于四周补 圈零);等价地,也等于补零后的梯度图与旋转 180° 的卷积核做互相关。
这两种说法描述的是同一个计算,只是记号不同。图 16 总结了这一约定,使用时要注意不要“重复翻转”。
步长 的情形。 步长大于 1 时,输出梯度图 比步长为 1 时稀疏:只有窗口起点位于 的整数倍处才有输出。处理方法是在 的相邻元素之间插入 个零(称为“膨胀”或“插零”),把它还原到步长为 1 时的网格上,记为 ,然后按步长为 1 的公式计算。若式 (18) 中的除法有余数,输入末端的若干行或列从未被任何窗口覆盖,它们的梯度为零,需要补齐到原输入尺寸。
多通道情形。 输入的第 个通道参与了全部 个输出通道的计算,所以它的梯度是 个卷积核各自反传结果之和:
其中 是第 4.2.2 节的数学卷积(全卷积), 是第 个通道插零后的梯度图, 是第 个卷积核的第 个切片;结果需与 的范围对齐。若这一卷积层前面紧接着一个逐元素激活函数 (中间没有池化),还要再逐元素乘以 才得到对上一层激活前变量的梯度;若中间有池化层,则先按第 4.4.2 节通过池化层反传。
逐元素写法。 用下标写出式 (66),可以避免任何关于“翻转”的歧义:
其中求和范围 是满足以下条件的核内位置 : 与 都是整数,且分别落在 和 之内。直观地说, 列举了“哪些窗口覆盖了输入位置 ,以及在这些窗口里它对应卷积核的哪个位置”。步长 时,条件简化为下标不越界:
前向与反向的对偶。 把卷积层的前向计算(不含偏置)看作一个线性映射 ,则输入梯度就是 ,这与图 15 中的一维例子完全一致。深度学习框架中的“转置卷积(transposed convolution)”实现的正是这个 :
- 前向:卷积把输入的局部窗口汇聚为特征图,;
- 反向:转置卷积把特征图上的梯度分发回输入,。
注意 是转置而不是逆矩阵 :转置卷积并不能把特征图“还原”成输入,前向计算中丢失的信息无法找回。
4.6.3.4 去掉补零区域
补零区域并不属于原始输入,因此求出 后,只需截去四周各 圈,就得到对真实输入的梯度:
这是因为补的零是常数,不随输入变化,它们的梯度直接丢弃即可。若使用反射补边或周期补边,补边区域的值来自原始输入,其梯度就必须加回到对应的原始位置上。
4.6.4 矩阵形式:im2col
交互图表 im2col 矩阵展开与 col2im 重叠累加。 点击节点锁定关键算子,拖动参数滑块检验公式中的定量权衡。
输入通道数 C
输入视图
数据
X_col 形状9 × 9窗口数 × Ck²
内存膨胀3.24×81 vs 25 个数
乘加次数 (GEMM)162
与直接卷积对照完全一致 ✓
im2col:把卷积改写成一次矩阵乘法5×5 输入,3×3 核,2 个滤波器,步幅 1
当前窗口 / 行
前面的推导逐个处理窗口,容易与手算对应。写程序时,还可以先把所有窗口整理到一起,再一次完成它们与卷积核的乘法。这就是 im2col(image to column):把每个窗口展开成一列,组成一个大矩阵。计算内容没有变,只是重新排列了数据,便于调用经过优化的矩阵乘法(如 BLAS 中的 GEMM)。
上面的交互演示采用“一个窗口排成一行”的约定;下面的推导和配套 Python 代码采用“一个窗口排成一列”的约定。两者相差一次转置,矩阵乘法的次序也相应改变。对照时先看窗口沿哪个方向排列,不要直接混用两套矩阵形状。
第一步:把所有窗口展开成矩阵。 定义展开矩阵 ,它的每一列是一个窗口内的全部输入元素:
行下标 按“通道、核的行、核的列”的顺序遍历窗口内的元素;列下标 对应输出位置 。
第二步:把卷积核展平成矩阵。 按与式 (70) 相同的顺序,把 个卷积核各展平成一行,得到 :
第三步:矩阵乘法。 的第 行与 的第 列做内积,正好是式 (16) 中去掉偏置的部分:
于是整个卷积层可以写成
其中 是把输出展平后的矩阵,, 是全 1 向量, 表示把偏置加到每一列上。
梯度的矩阵形式。 把输出梯度按相同顺序整理成 ,就可以用矩阵运算同时计算所有窗口的贡献。下面给出推导,第一次阅读可以先看式 (75) 的结果,再与前面逐元素的梯度比较。对式 (73) 取全微分,并利用 ,得
由此直接读出三个梯度:
前两个结果分别对应卷积核梯度和偏置梯度,与式 (61)、式 (59) 相同。第三个结果是对展开矩阵 的梯度,还没有回到原始图像的位置。最后需要把每个窗口收到的梯度放回原处,并在窗口重叠的地方相加。这一步称为 col2im:
col2im 把展开矩阵的每一列按原来的位置“散射”回图像。由于窗口相互重叠,同一个像素在 中出现了多次,它的梯度必须是所有这些位置的梯度之和——代码中必须用累加 +=,而不能用赋值 =。这就是第 4.6.0 节第二种复用在代码层面的体现。用线性代数的语言,col2im 是 im2col 的伴随算子,满足内积恒等式
第 4.8.9 节的单元测试会直接检验这个恒等式。本章代码中的 im2col 在展开时直接把越界位置当作零处理,col2im 也直接跳过补零区域,因此 col2im 的输出形状就是原始输入的 ,式 (69) 的裁剪已经隐含在其中。
4.6.5 完整的反向传播流程
把各层的计算按顺序接起来,就回到了第 4.5.1 节的小网络。前向时保存预测和反向计算所需的中间结果;反向时从损失出发,按相反顺序经过各层,得到权重与偏置的梯度。梯度算完后,优化器才能更新参数,开始下一次计算。图 17 把这些步骤放在了同一张图里。
4.6.6 梯度检查:用有限差分验证
推导完成后,还需要检查代码是否真的按公式计算。网络能降低训练误差,并不表示每个梯度都正确:漏加一个窗口的贡献,程序也可能继续运行。
一种直接的检查方法是暂时不用反向传播,把某个参数分别调大一点和调小一点,重新计算两次损失,再用损失的变化估计导数。把这个数值结果与反向传播的结果比较,就是梯度检查(gradient check)。下面先写出差分公式,再解释扰动为什么不能取得过大或过小。
中心差分公式。 对待检查的某个标量参数 ,把损失在 处做泰勒展开:
两式相减,偶数阶项相互抵消:
整理得中心差分公式:
中心差分的截断误差为 ,比单侧差分 的 精确得多。
如何选择 。 不是越小越好。计算机计算 时会有相对舍入误差,双精度浮点数的单位舍入误差约为 ,两个相近的数相减后再除以 ,舍入误差被放大到约 。总误差近似为
第一项随 减小而增大,第二项随 减小而减小。对 求导并令其为零,得最优步长 。当 和 的量级都约为 1 时,,因此实践中常取 左右,此时相对误差可达 –。实际最优值与参数和损失的尺度有关,可以多试几个步长。
比较的标准。 通常计算相对误差
其中 是中心差分的结果, 是反向传播的结果。在数值尺度合适、没有跨越不可导点的双精度测试中,正确实现通常能给出 以下的相对误差。若达到 甚至更大,应检查下标、累加和差分步长,并先排除下面的不可导点问题。
两点注意。 第一,ReLU 在 0 处、最大池化在并列最大值处不可导;如果某个扰动恰好跨过了这样的切换点,差分结果会出现较大偏差,这并不说明代码有错,换一个随机输入重试即可。第二,测试时应使用随机的输出梯度,而不是全为 1 的梯度。下面这个“单层隔离测试”技巧很常用:取一个待测层,把标量损失定义为输出的加权和 ,其中 是固定的随机张量,则 。如果把 取为全 1,所有位置的梯度相同,一些下标写错(如把 和 互换)的错误就无法暴露出来。
第 4.8.9 节将把这些方法写成自动化测试,检验本章代码中每一种层的梯度。
4.7 从线性代数与傅里叶分析看卷积
到这里,已经具备了搭建和训练一个基本 CNN 所需的计算。若想先运行实验,可以接着阅读第 4.8 节。本节保留进一步理解原理所需的数学内容。
我们仍然研究同一个滑动乘加,只是换两种写法:矩阵写法能看清哪些权重重复出现,傅里叶写法能解释滤波怎样改变信号中不同频率的成分。后者也与材料研究中的熟悉工具相联系,例如在 X 射线衍射的运动学近似中,晶胞电子密度的傅里叶分量给出结构因子。理解这些联系后,再看卷积的代数性质、梯度传播和经典滤波核,就有了共同的出发点。
4.7.1 卷积是结构化的矩阵:Toeplitz 矩阵
回忆一维手算:第一个输出用到前三个输入,第二个输出把同一组权重向右移一格。把每个输出所用的权重排成一行,就能把全部计算写成矩阵乘法。
以不含偏置、步长为 1、不补零的一维互相关为例,记这个矩阵为 ,于是 。长度为 3 的卷积核 对应:
矩阵 的每一条对角线上的元素都相同,这种矩阵称为 Toeplitz 矩阵(常对角矩阵)[5];空白处都是零。二维卷积对应的矩阵是“块 Toeplitz、块内也是 Toeplitz”的结构(BTTB 矩阵)。第 4.6 节反复出现的“反向传播乘以 ”,在这里看得一目了然: 仍是 Toeplitz 矩阵,对应的是翻转后的卷积核。
这个视角给出几点认识:
- 卷积层是一种受约束的全连接层。 一个把 维向量映射到 维向量的全连接层有 个自由参数;而 Toeplitz 约束下只剩 个独立参数,且绝大多数元素被强制为零。局部连接对应“带状”的零模式,权值共享对应“沿对角线相等”。换句话说,卷积层是在全连接层的参数空间中,挑出了满足平移对称性的一个低维子空间。
- 不含偏置的卷积是线性映射,加上偏置是仿射映射。 两个线性卷积层直接相连(中间没有激活函数),其复合仍是线性映射。在无限长或周期网格、步长为 1 的条件下,它还可以合并成一个更大的卷积(见第 4.7.3 节)。因此,卷积层之间必须插入非线性激活函数,网络才能表示非线性关系。
- 有限网格上的边界效应。 有限长度、逐层补零或裁剪时,Toeplitz 矩阵的乘积在边界附近不一定还是 Toeplitz 矩阵,这正是第 4.3.2 节所说的边界破坏等变性的代数表现。
4.7.2 卷积定理:频域视角
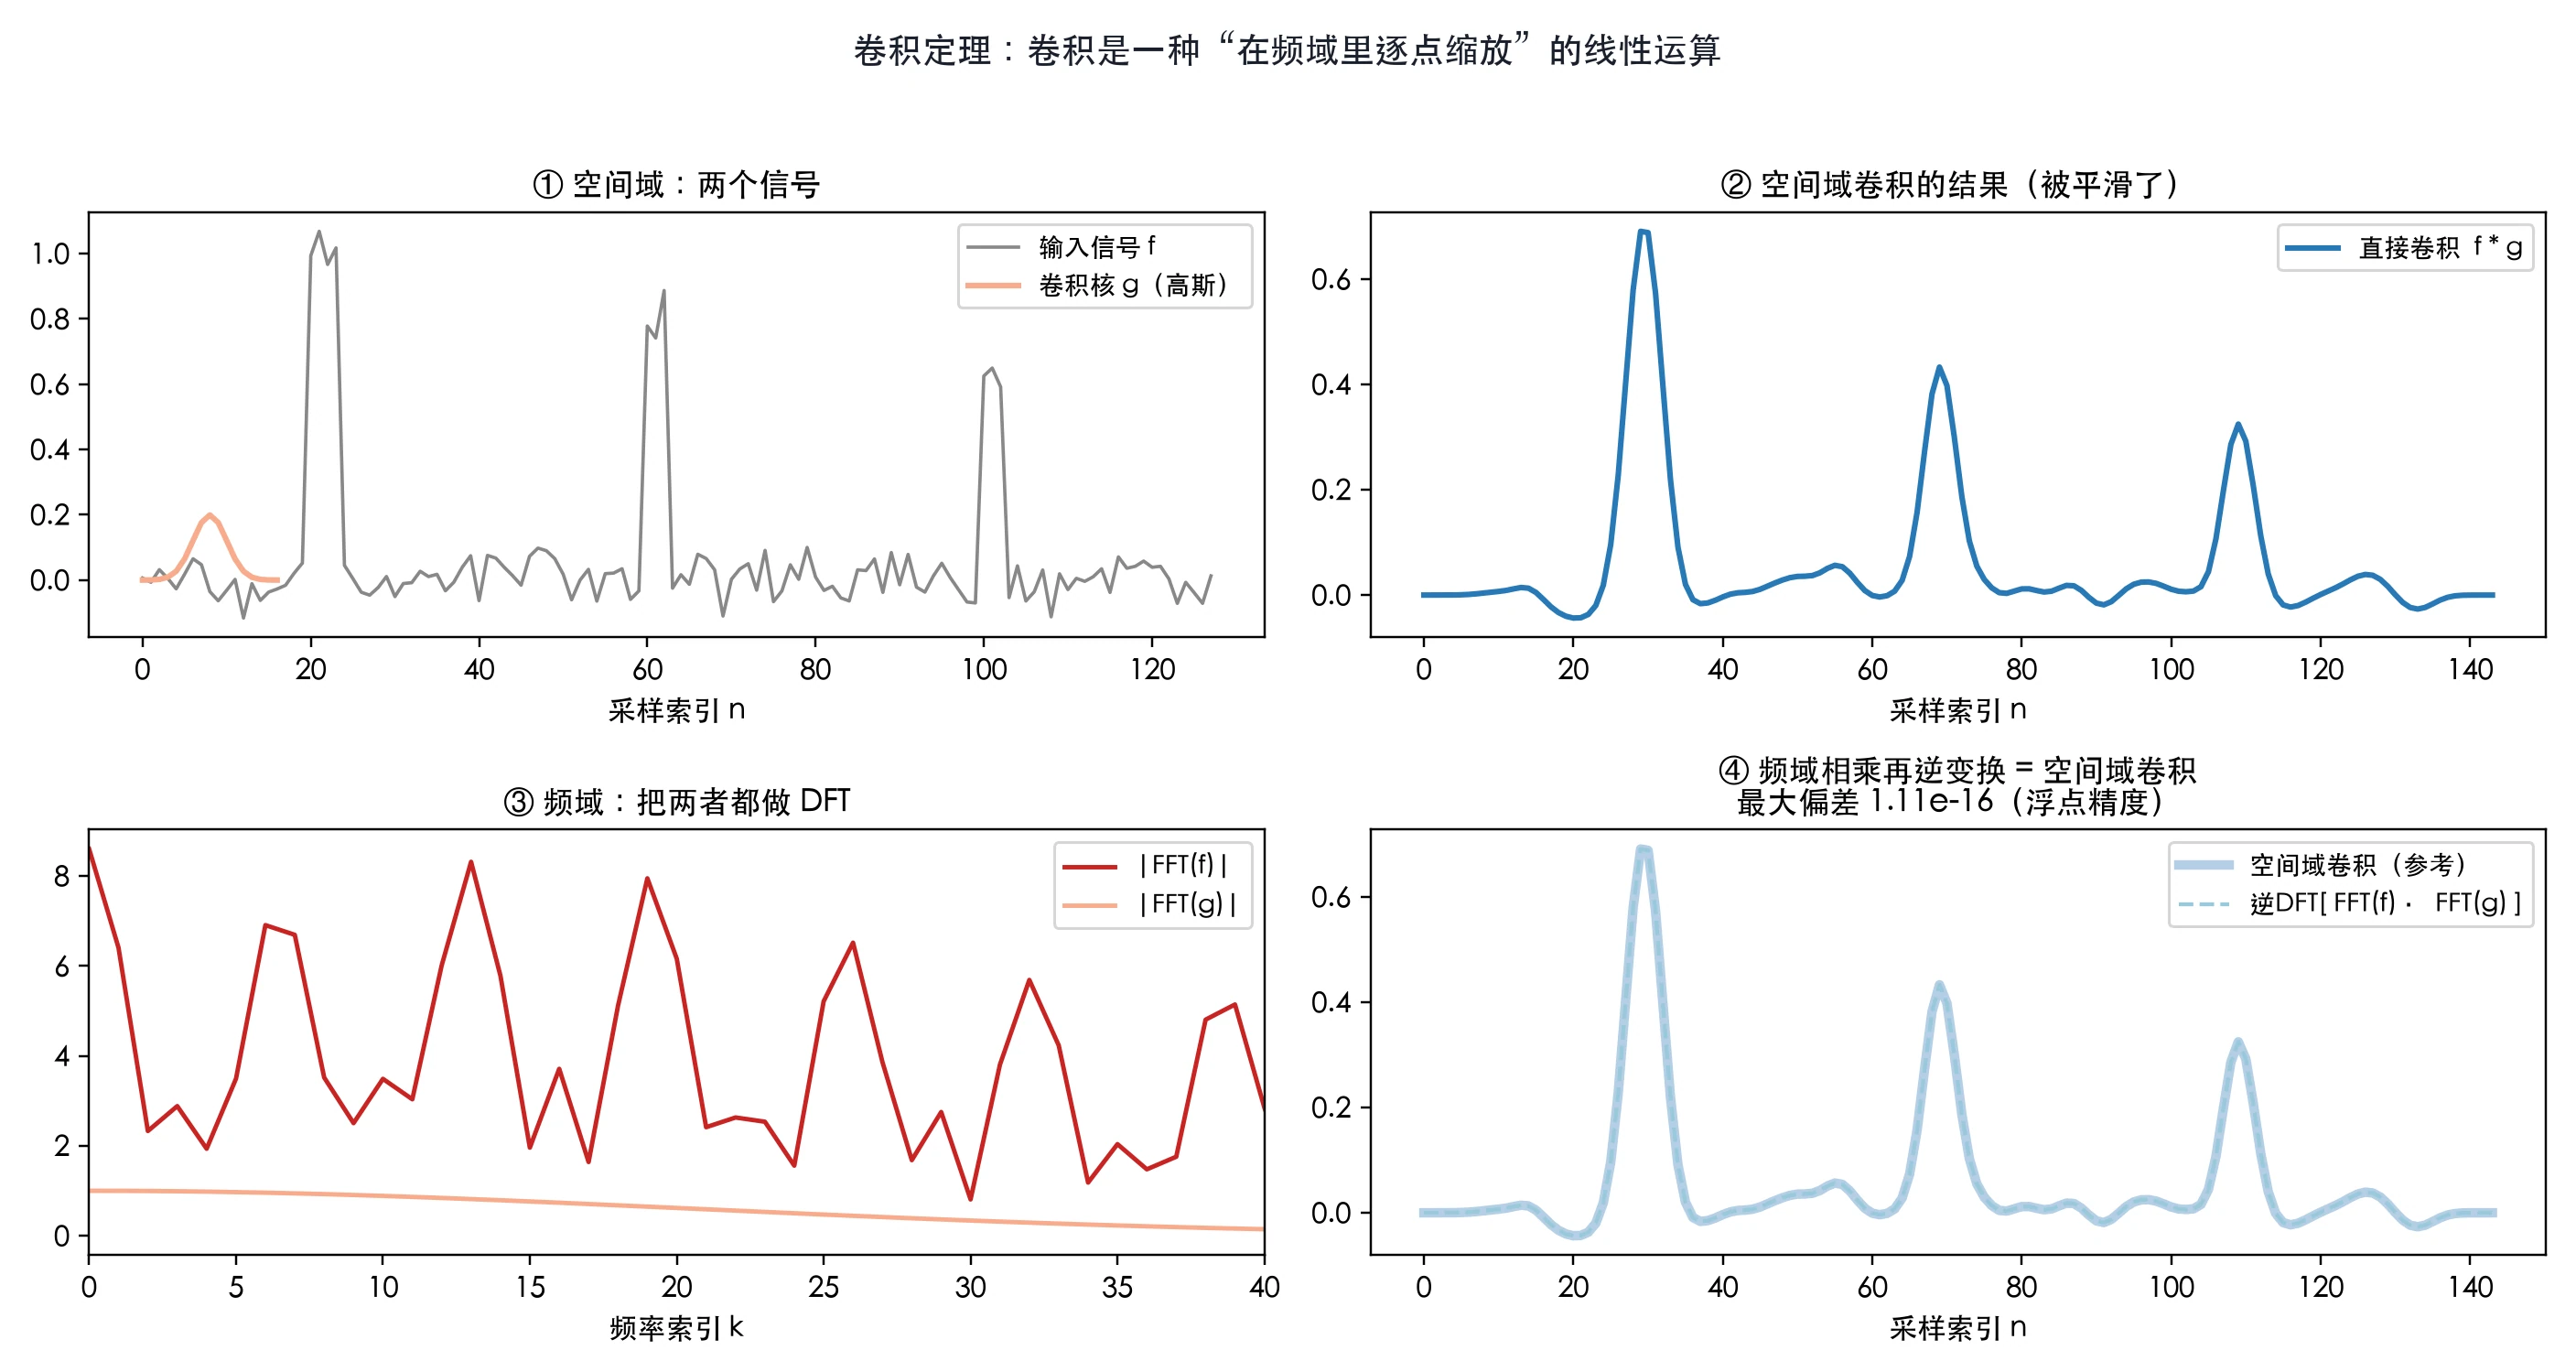
前面在原始采样点上计算卷积。还可以先对信号和卷积核做傅里叶变换,在频域中逐点相乘,再变换回来。连接这两种计算方式的,就是信号处理中的卷积定理 [4]。
这里的“频率”描述数组沿其坐标轴变化的快慢。对红外谱线再次做傅里叶分析时,需要区分这个变换频率与原谱的波数轴,不能把两个坐标直接混为一谈。下面先写出定义,再证明两种计算为什么一致。
先定义离散傅里叶变换(DFT)及其逆变换。对长度为 的序列 ,
再定义下标按模 循环的循环卷积:
卷积定理:。证明只需交换求和次序:
对内层求和作变量代换 。当 取遍 时, 也恰好取遍 ;又因 以 为周期,。于是
这个定理有两个重要推论:
- 线性卷积与循环卷积。 卷积定理直接适用的是循环卷积,它会把序列尾部“绕回”到头部。若要用 FFT 计算普通的(非周期的)线性卷积,需要先把长度为 和 的两个序列都补零到长度 ,以避免首尾回绕造成的混叠。
- 计算效率。 直接计算两个序列的线性卷积需要 次乘法;用快速傅里叶变换(FFT)先变换、再逐点相乘、最后逆变换,总成本为 。当卷积核很大时,FFT 方法快得多。分子模拟中计算长程静电作用的粒子网格 Ewald(PME)方法 [31],以及大尺寸图像滤波,都利用了这一点。对 CNN 中常见的 小核,直接计算通常更快。
图 18 用一个数值例子验证了卷积定理。
这里顺便说明一下卷积定理与衍射的关系,因为二者都用到傅里叶变换,容易混淆。在 X 射线衍射的运动学近似下,晶胞的结构因子是电子密度的傅里叶分量:
其中 是倒易点阵矢量(指数的正负号取决于所用的傅里叶约定)。结构因子是复数,包含振幅和相位;实验测得的衍射强度(经各种校正后)正比于 ,相位信息则丢失了,这就是晶体学中的“相位问题”。式 (89) 说的是“一个函数的傅里叶变换”,而卷积定理说的是“两个函数卷积后的傅里叶变换”,二者是不同的数学关系。不过它们可以结合起来理解一个熟悉的事实:晶体可以看作“一个晶胞的电子密度”与“点阵”的卷积,所以衍射图样是“结构因子”与“倒易点阵”的乘积——这正是卷积定理的体现。
4.7.3 卷积的代数性质
在相关的求和或积分存在、可以交换求和次序的前提下,数学卷积满足交换律 、结合律 、对加法的分配律以及对数乘的齐次性。交换律可以通过变量代换 直接证明,留作习题。
结合律的一个直接推论是:在步长为 1、中间没有非线性激活、边界处理一致的条件下,连续两次卷积可以合并成一次卷积,等效核为两个核的卷积,尺寸为 。
这解释了 VGG 网络的设计思想 [11]:两个连续的 卷积层的感受野与一个 卷积层相同(),但参数更少。设各层的输入、输出通道数都是 ,忽略偏置,两层 卷积共有 个权重,一层 卷积有 个,前者少 28%。而且两层之间还可以插入一个非线性激活函数,表达能力更强。
需要注意,这些代数性质属于数学卷积。互相关一般不满足交换律( 与 互为翻转);多通道卷积还涉及通道之间的矩阵乘法,次序也不能随意交换。
4.7.4 与全连接层的对比:归纳偏置
现在可以用矩阵语言回看第 4.1 节的归纳偏置。全连接层使用稠密权重矩阵,没有专门要求邻近位置优先组合,也没有要求不同位置共享权重。卷积层则对权重作了两项约束,并由此得到一个性质:
- 局部连接:每个输出只与输入的一个局部邻域相连,远处的元素不直接相互作用;
- 权值共享:所有位置使用同一组卷积核;
- 平移等变:作为前两条的结果,在步长为 1、边界处理一致时,输入平移对应输出平移。
当数据确实具有规则的网格结构和近邻相关性时(如显微图像、连续谱线),这些假设与数据相符,模型可以用少得多的参数达到同样甚至更好的效果。反之,当数据是无序的点云或任意拓扑的分子图时,网格卷积的假设与数据不符,强行套用会带来不必要的限制。不过,一个模型是否泛化得好,最终仍需用独立的测试数据来检验。
4.7.5 有效感受野与深层网络的梯度
第 4.3.3 节算出了一个输出最多可能受多大范围的输入影响。进一步还可以问:在这个范围内,改变哪个像素,对输出的影响更大?一种检查方法是计算输出对各输入像素的梯度。
Luo 等人用这类梯度描述有效感受野,发现在所研究的网络中,影响往往集中在理论感受野的中心附近,分布近似为高斯形,且有效范围只占理论范围的一小部分 [22]。从计算路径来看,中心附近的像素可以经过更多路径影响输出。不过,这个解释有特定的结构和假设条件,具体网络仍要实际计算。
有效感受野与梯度在深层网络中的传播密切相关。设网络有 层,第 层的输出 展平后长度为 ,局部雅可比矩阵为 。由链式法则,损失对第一层输出的梯度为
矩阵乘积从右向左作用,次序不能交换。对逐元素的激活函数,局部雅可比矩阵是对角矩阵;对卷积层,它是第 4.7.1 节的 Toeplitz 型矩阵。取欧氏范数,有
其中 是矩阵的谱范数(最大奇异值)。这个不等式说明:如果每一层的谱范数都明显小于 1,梯度会随层数指数衰减(梯度消失);反之则可能指数增长(梯度爆炸)。不过它只是一个上界:即使某层的谱范数大于 1,梯度也未必恰好沿着被放大的方向,因此上界大并不意味着梯度一定爆炸。
实践中有几种手段帮助梯度稳定传播:ReLU 激活(第 4.4.3 节)、残差连接、批归一化(第 4.4.4 节),以及合适的权重初始化。例如 He 初始化 [18] 让卷积核权重服从均值为 0、标准差为 的正态分布,其中 是每个输出神经元的输入个数(fan-in);这一选择的出发点是:在 ReLU 网络中,使各层激活值的方差在前向传播时大致保持不变。第 4.8 节的代码采用的就是这种初始化。
4.7.6 经典滤波核的含义
前面的数学可以回到一组直观结果上:同一张图,换一组权重,哪些细节会被突出,哪些会被平滑?数字图像处理中已有许多手工设计的核,适合用来观察这种差别。它们提供的是理解局部计算的例子,不能直接用来判定一个训练所得卷积核的物理含义。
恒等核:中心为 1,其余为 0,原样复制输入。
均值核与高斯核:权重全为正且和为 1,对邻域做加权平均,起平滑(低通滤波)作用,可以抑制噪声,但也会使边缘和窄峰变得模糊。例 2.1 的 就是一维高斯核的最简单形式。
Sobel 核:在一个方向上设置反对称的正负权重,例如
它近似计算水平方向的一阶偏导数 (同时在竖直方向做轻微平滑),因此对竖直走向的边缘响应最强;其转置 近似 。
Laplacian 核:,是拉普拉斯算子 (梯度的散度)的五点差分近似,对孤立的斑点和细线响应强烈。
锐化核:等于恒等核减去 Laplacian 核,在保留原图的同时增强边缘反差。
Sobel 核和 Laplacian 核的权重之和都为 0,因此在常数区域(不受边界影响的内部)响应为 0,只对强度变化有响应。但要注意,强度变化不一定来自真实的结构界面,也可能来自成像衬度或噪声,滤波响应本身不能作为物理界面的证据。第 4.8.8 节将用代码把这些核作用到一幅测试图像上,直观比较它们的效果。
可分离卷积。 如果一个二维核可以写成两个一维向量的外积 (即秩为 1),二维卷积就可以分解为先沿竖直方向做一维卷积、再沿水平方向做一维卷积,每个位置的计算量从 降为 。Sobel 核和高斯核都是可分离的,例如 。这称为空间可分离卷积。MobileNet 中的深度可分离卷积是另一种分解:先对每个通道单独做空间卷积,再用 卷积混合通道 [20],它并不要求每个空间核的秩为 1。
4.7.7 卷积与自注意力
卷积在预测时使用已经训练好的局部权重,同一个核会被用于不同样本和不同位置。自注意力机制则根据当前输入,动态计算不同位置之间的交互强度;在全局自注意力中,相距很远的两个位置也能直接交互。
这意味着两者对数据施加的约束不同。卷积明确规定了局部性和权值共享,数据较少而这些假设又合适时,这种约束可能有帮助。Vision Transformer 在大规模预训练后可以达到甚至超过 CNN 的性能 [13],但实际比较还取决于数据规模、预训练、位置编码和计算预算。选择模型时,仍需在相同数据划分下充分训练和比较。
4.8 从零实现 CNN
现在把前面的计算写成程序,用来核对窗口下标、权重共享和梯度累加。为了让每一步都能与公式对应,本节只用 Python 标准库(math 和 random):多维数组用嵌套列表存放,运算写成显式循环。这种实现速度较慢,适合学习和检查;实际研究应使用 NumPy 或 PyTorch 等库,第 4.9.1.2 节会给出 PyTorch 的例子。
阅读时可以先看关键函数的说明,再查看第 4.8.8 节的滤波结果。完整代码保留在对应位置,便于展开、复制和运行。理解网络原理不要求一次读完所有工具函数,但复现时需要使用完整版本。
4.8.1 代码的组织
配套程序分成核心计算、数据生成和实验脚本。运行时,把下面这些文件放在同一目录,实验脚本就能导入共同使用的网络层和数据生成器:
cnn.py(第 4.8.6 节):核心库,包括张量工具、im2col/col2im、作为对照的直接循环卷积conv2d_direct、六种网络层(Conv2D、MaxPool2D、ReLU、Flatten、GlobalAvgPool、Dense)、Sequential容器、SGD 与 Adam 优化器、训练循环和梯度检查工具;chemdata.py(第 4.8.7 节):生成本章三个合成数据集——二维斑点图、合成红外曲线和二维纹理;demo_kernels.py(第 4.8.8 节):把经典手工卷积核作用到测试图像上;tests_cnn.py(第 4.8.9 节):单元测试与梯度检查;- 第 4.9 节的实验脚本:形状分类
demo_molecules.py(第 4.9.1.1 节)、ESOL 水溶性预测demo_delaney_cnn.py(第 4.9.1.2 节,需要 PyTorch 与 DeepChem)、红外光谱分类demo_spectra.py(第 4.9.2.1 节)和纹理分类demo_materials.py(第 4.9.3.1 节)。
表2 列出了核心库中的主要函数与类,以及它们对应的公式。
表2 cnn.py 与 chemdata.py 中的主要函数、类及其对应公式
| 模块 | 函数 / 类 | 对应公式 | 输入 → 输出 | 说明 |
|---|---|---|---|---|
| 输出尺寸 | conv_output_size | 式 (18) | 标量 → 标量 | 用整除 // 实现向下取整 |
| 窗口展开 | im2col | 式 (70) | (C, H, W) → (C·kh·kw, OH·OW) | 把卷积变成一次矩阵乘法;越界位置直接取 0(即补零) |
| 梯度散射 | col2im | 式 (76) | (C·kh·kw, OH·OW) → (C, H, W) | im2col 的伴随运算;重叠位置用 += 累加 |
| 卷积层 | Conv2D | 前向式 (73);反向式 (59)、(75) | (C, H, W) → (F, OH, OW) | 卷积核存于 self.W,对应数学符号 |
| 激活 | ReLU | 式 (40) | 形状不变 | 缓存正值掩码供反向使用 |
| 池化 | MaxPool2D | 式 (35)、(36) | (C, H, W) → (C, OH, OW) | 缓存每个窗口最大值的位置 argmax |
| 展平 | Flatten | — | (C, H, W) → (C·H·W,) | 反向时按缓存的形状还原 |
| 全局平均池化 | GlobalAvgPool | 式 (37)、(38)(窗口取整张图) | (C, H, W) → (C,) | 反向时把梯度平均分给 个位置 |
| 全连接 | Dense | 式 (55) | (D_in,) → (D_out,) | 权重形状为 (D_in, D_out),即 |
| 损失 | cross_entropy_logits、softmax_cross_entropy_backward | 式 (46)、(53) | logits、标签 → 损失、梯度 | 直接从 logits 计算,数值稳定 |
| 优化器 | SGD、Adam | — | 原地更新参数 | Adam 见文献 [19] |
| 梯度检查 | check_gradient | 式 (81)、(83) | 模型、样本 → 最大相对误差 | 中心差分, |
| 数据 | make_shape_dataset | — | → [(X, y), …] | 三类二维斑点图,可施加平移 |
| 数据 | make_ir_spectra | — | → [(X, y), …] | 三类合成红外曲线,形状 (1, 1, 64) |
| 数据 | make_micrograph_dataset | — | → [(X, y), …] | 三类 合成纹理 |
下面先解释最容易写错的几步:窗口怎样展开,梯度怎样放回原处,以及卷积层怎样调用这些计算。随后给出完整代码,前面的片段用于阅读,后面的完整版本用于运行。
4.8.2 输出尺寸与 im2col
式 (18) 在代码中只有一行,Python 的整除 // 正好实现了向下取整:
python
def conv_output_size(H, kh, stride, pad):
return (H + 2 * pad - kh) // stride + 1下面的 im2col 实现了式 (70)。为便于阅读,这里的片段假定步长和补零都是标量;第 4.8.6 节的完整实现还支持高、宽方向分别指定。
python
def im2col(X, kh, kw, stride=1, pad=0):
    C, H, W = len(X), len(X[0]), len(X[0][0])
    OH = conv_output_size(H, kh, stride, pad)
    OW = conv_output_size(W, kw, stride, pad)
    cols = [[0.0] * (OH * OW) for _ in range(C * kh * kw)]
    for c in range(C):
        for p in range(kh):
            for q in range(kw):
                row = (c * kh + p) * kw + q      # 行号:与卷积核的展平顺序一致
                for i in range(OH):
                    u = i * stride + p - pad     # 对应原始输入的行坐标
                    if u < 0 or u >= H:          # 落在补零区:保持 0.0
                        continue
                    for j in range(OW):
                        v = j * stride + q - pad
                        if 0 <= v < W:
                            cols[row][i * OW + j] = X[c][u][v]
return cols, OH, OW有两处值得注意。第一,代码并没有真的构造补零后的 ,而是在访问时把坐标减去 pad,越界就跳过(保持 0),效果与补零完全相同。第二,行号 row = (c*kh+p)*kw+q 规定了“通道 → 核的行 → 核的列”的展开顺序,Conv2D._Wcol() 展平卷积核时必须使用完全相同的顺序,否则矩阵乘法的结果就是错的。
4.8.3 col2im:重叠窗口的累加
im2col 把窗口里的数复制到展开矩阵,col2im 则把展开矩阵中的梯度加回对应的输入位置。它实现的就是第 4.6.4 节所说的“放回原处,重叠处相加”,数学上称为 im2col 的伴随运算(式 (77))。两者沿相同的窗口和下标遍历,只是数据流向相反:
python
def col2im(cols, X_shape, kh, kw, stride=1, pad=0):
    C, H, W = X_shape
    OH = conv_output_size(H, kh, stride, pad)
    OW = conv_output_size(W, kw, stride, pad)
    dX = zeros3(C, H, W)
    for c in range(C):
        for p in range(kh):
            for q in range(kw):
                row = (c * kh + p) * kw + q
                for i in range(OH):
                    u = i * stride + p - pad
                    if u < 0 or u >= H:
                        continue
                    for j in range(OW):
                        v = j * stride + q - pad
                        if 0 <= v < W:
                            dX[c][u][v] += cols[row][i * OW + j]   # 必须累加
return dX关键在倒数第二行的 +=。一个输入像素会出现在多个重叠的窗口中,也就在 cols 中出现多次,它的梯度必须是所有这些位置梯度之和(第 4.6.0 节的第二种复用)。如果误写成 =,后面的窗口会覆盖前面窗口的贡献,梯度就错了——而且网络通常仍能勉强训练,很难察觉。这正是第 4.8.9 节梯度检查要防范的错误。另外请注意,col2im 不是 im2col 的逆运算:col2im(im2col(X)) 一般不等于 ,而是 的每个像素乘以“覆盖它的窗口数”。
4.8.4 Conv2D 的前向与反向
把窗口展开后,前向计算就是卷积核矩阵与窗口矩阵相乘,再加偏置。反向时用相同的中间结果求参数梯度,最后通过 col2im 把输入梯度加回原位。下面的两个方法对应这两个方向;初始化、_Wcol() 和 params() 见第 4.8.6 节的完整代码:
python
class Conv2D(Layer):
    def forward(self, X):
        cols, OH, OW = im2col(X, self.kh, self.kw, self.stride, self.pad)
        Wcol = self._Wcol()                       # 展平的卷积核 K_mat,形状 (F, C*kh*kw)
        out_col = matmul(Wcol, cols)              # 式 (73):K_mat · A
        Y = zeros3(self.cout, OH, OW)
        for f in range(self.cout):
            for i in range(OH):
                for j in range(OW):
                    Y[f][i][j] = out_col[f][i * OW + j] + self.b[f]
        self._cache = (X, cols, OH, OW, Wcol)     # 缓存前向变量,供反向使用
        return Y

    def backward(self, dY):
        X, cols, OH, OW, Wcol = self._cache
        dY_col = [[dY[f][i][j] for i in range(OH) for j in range(OW)]
                  for f in range(self.cout)]      # G_mat,形状 (F, OH*OW)
        dW_col = matmul(dY_col, transpose(cols))  # 式 (75):G_mat · Aᵀ
        for f in range(self.cout):
            for c in range(self.cin):
                for p in range(self.kh):
                    for q in range(self.kw):
                        self.dW[f][c][p][q] += dW_col[f][(c*self.kh+p)*self.kw+q]
            self.db[f] += math.fsum(dY_col[f])    # 式 (59):对所有位置求和
        dcols = matmul(transpose(Wcol), dY_col)   # 式 (75):K_matᵀ · G_mat
        return col2im(dcols, shape_of(X), self.kh, self.kw,
self.stride, self.pad) # 式 (76)反向传播中有一个容易被忽视的细节:参数梯度 self.dW、self.db 用的也是 +=。这是因为训练时一个小批量包含多个样本,cnn.train 的做法是:每个批次开始时调用 zero_grad() 把梯度清零,然后对批内每个样本依次做前向和反向,梯度在 dW、db 中逐样本累加,最后除以批大小再更新参数。如果在 backward 中直接赋值,就只会保留批内最后一个样本的梯度。这种错误用单个样本的梯度检查是发现不了的,第 4.8.9 节专门设计了批平均损失的检查。相比之下,输入梯度只属于当前样本,由 col2im 直接返回即可。
4.8.5 公式与代码的对应
把本节的代码与前面的公式对照,可以整理出如下对应关系:
- 输出尺寸公式 (18) ↔
conv_output_size; - 窗口展开 (70) ↔
im2col;卷积核展平 (71) ↔Conv2D._Wcol; - 前向矩阵乘法 (73) ↔
Conv2D.forward中的matmul(Wcol, cols); - 卷积核与偏置的梯度 (75)、(59) ↔
matmul(dY_col, transpose(cols))与math.fsum; - 输入梯度 (76) ↔
matmul(transpose(Wcol), dY_col)再经col2im累加; - 最大池化 (35)、(36) ↔
MaxPool2D.forward记录argmax,MaxPool2D.backward只把梯度送回该位置; - 输出层梯度 (53) ↔
softmax_cross_entropy_backward中的d[label] -= 1.0; - 中心差分 (81) ↔
check_gradient中的(lp - lm) / (2 * eps)。
4.8.6 核心库 cnn.py
下面保留 cnn.py 的完整代码,按“基础工具 → im2col → 直接卷积 → 网络层 → 损失 → 模型与优化器 → 训练循环 → 梯度检查”组织。展开阅读时,可以先定位前面解释过的函数,再按需要查看它调用的工具;保存成文件运行时,则需要保留全部内容。

python
# cnn.py —— 只依赖 Python 标准库的卷积神经网络教学实现
"""一个零依赖的卷积神经网络(CNN)实现。
设计原则
--------
1. 只用 Python 标准库(``math`` / ``random``),不使用 NumPy。
所有张量都是嵌套 ``list``,所有矩阵运算都是显式 ``for`` 循环。
2. 代码结构与教程里的公式一一对应:
卷积前向 -> Conv2D.forward (im2col + 矩阵乘法)
卷积反传 -> Conv2D.backward (三个偏导: dW, db, dX)
池化 -> MaxPool2D (梯度只回到最大值位置)
全局平均池化 -> GlobalAvgPool
全连接 -> Dense
交叉熵+Softmax -> softmax / cross_entropy_logits
3. 提供 ``check_gradient``:用有限差分校验解析梯度。
这是神经网络代码最有效的自检手段。
张量约定
--------
图像/特征图 X : (C, H, W) 三层嵌套 list
一批图像 X : (N, C, H, W) 四层嵌套 list(在 train 里逐样本循环)
卷积核 W : (F, C, kh, kw) 四层嵌套 list
全连接权重 W : (in, out) 两层嵌套 list
面向「人工智能 × 化学」方向研究生的教学代码
"""
from __future__ import annotations
import math
import random
# ==========================================================================
# 第 0 部分:基础工具
# ==========================================================================
def zeros(n):
"""长度为 n 的零向量。"""
return [0.0] * n
def zeros2(r, c):
"""(r, c) 的零矩阵。"""
return [[0.0] * c for _ in range(r)]
def zeros3(c, h, w):
"""(c, h, w) 的零张量,例如一张 C 通道的 H×W 特征图。"""
return [[[0.0] * w for _ in range(h)] for _ in range(c)]
def zeros4(f, c, h, w):
"""(f, c, h, w) 的零张量,例如 f 个 c 通道 kh×kw 卷积核。"""
return [[[[0.0] * w for _ in range(h)] for _ in range(c)] for _ in range(f)]
def shape_of(T):
"""返回嵌套 list 的形状,例如 (3, 8, 8)。"""
s = []
t = T
while isinstance(t, list):
s.append(len(t))
t = t[0]
return tuple(s)
def flatten(T):
"""把嵌套 list 展平成一维(行优先)。"""
out = []
stack = [T]
while stack:
t = stack.pop()
if isinstance(t, list):
# 逆序入栈,保证出栈顺序是行优先
for v in reversed(t):
stack.append(v)
else:
out.append(t)
return out
def deep_copy(T):
"""递归拷贝嵌套 list。"""
if isinstance(T, list):
return [deep_copy(v) for v in T]
return T
def matmul(A, B):
"""矩阵乘法 C = A @ B,A: (n, k),B: (k, m),C: (n, m)。
这是全教程唯一的"重型"运算:卷积会被 im2col 转换成它,
全连接层本身就是它。零元素跳过,快一点点。
"""
n = len(A)
k = len(B)
m = len(B[0]) if k else 0
C = [[0.0] * m for _ in range(n)]
for i in range(n):
Ai = A[i]
Ci = C[i]
for p in range(k):
a = Ai[p]
if a == 0.0:
continue
Bp = B[p]
for j in range(m):
Ci[j] += a * Bp[j]
return C
def transpose(A):
"""矩阵转置。"""
return [list(col) for col in zip(*A)]
def vec_mat(vec, M):
"""行向量 (k,) 乘矩阵 (k, m) -> (m,)。全连接前向用它。"""
m = len(M[0])
out = [0.0] * m
for i, v in enumerate(vec):
if v == 0.0:
continue
Mi = M[i]
for j in range(m):
out[j] += v * Mi[j]
return out
def outer(u, v):
"""外积 (n,) ⊗ (m,) -> (n, m)。全连接反向用它更新 dW。"""
return [[ui * vj for vj in v] for ui in u]
# ==========================================================================
# 第 1 部分:im2col —— 把卷积变成矩阵乘法
# ==========================================================================
def _pair(v):
"""把 int 或 (a, b) 统一成 (a, b)。"""
if isinstance(v, (tuple, list)):
return int(v[0]), int(v[1])
return int(v), int(v)
def conv_output_size(H, kh, stride, pad):
"""卷积输出边长:OH = (H + 2*pad - kh) / stride + 1。"""
return (H + 2 * pad - kh) // stride + 1
def im2col(X, kh, kw, stride=1, pad=0):
"""把 (C, H, W) 的输入展开成卷积矩阵 cols: (C*kh*kw, OH*OW)。
第 r 行对应权重扁平化后的第 r 个分量,其中
r = (c * kh + p) * kw + q
第 s 列对应输出位置 (i, j),其中 s = i * OW + j。
于是"卷积"就变成了一个矩阵乘法:
out_col (F, OH*OW) = W_col (F, C*kh*kw) @ cols
返回 (cols, OH, OW)。
"""
sh, sw = _pair(stride)
ph, pw = _pair(pad)
C, H, W = len(X), len(X[0]), len(X[0][0])
OH = conv_output_size(H, kh, sh, ph)
OW = conv_output_size(W, kw, sw, pw)
cols = [[0.0] * (OH * OW) for _ in range(C * kh * kw)]
for c in range(C):
for p in range(kh):
for q in range(kw):
row = (c * kh + p) * kw + q
row_ref = cols[row]
for i in range(OH):
u = i * sh + p - ph
if u < 0 or u >= H:
continue
Xcu = X[c][u]
base = i * OW
for j in range(OW):
v = j * sw + q - pw
if 0 <= v < W:
row_ref[base + j] = Xcu[v]
return cols, OH, OW
def col2im(cols, X_shape, kh, kw, stride=1, pad=0):
"""im2col 的伴随运算:把 (C*kh*kw, OH*OW) 的梯度累加回 (C, H, W)。
注意:这不是"取逆矩阵",而是做"散射-累加"(scatter-add)。
因为同一个输入像素会被多个滑窗位置覆盖,它的梯度是
**所有覆盖它的位置贡献之和**,所以这里是 ``+=`` 而不是 ``=``。
这一步正是公式 ∂L/∂X 的代码化身。
"""
sh, sw = _pair(stride)
ph, pw = _pair(pad)
C, H, W = X_shape
OH = conv_output_size(H, kh, sh, ph)
OW = conv_output_size(W, kw, sw, pw)
dX = zeros3(C, H, W)
for c in range(C):
for p in range(kh):
for q in range(kw):
row = (c * kh + p) * kw + q
cols_row = cols[row]
for i in range(OH):
u = i * sh + p - ph
if u < 0 or u >= H:
continue
base = i * OW
for j in range(OW):
v = j * sw + q - pw
if 0 <= v < W:
dX[c][u][v] += cols_row[base + j]
return dX
# ==========================================================================
# 第 2 部分:直接法的卷积(用于验证 im2col 的正确性)
# ==========================================================================
def conv2d_direct(X, W, b, stride=1, pad=0):
"""教科书写法的二维互相关:
Y[f,i,j] = b[f] + sum_{c,p,q} W[f,c,p,q] * X[c, i*s+p-P, j*s+q-P]
只用于小规模验证。速度慢,但每个下标都看得见。
"""
C, H, Wd = len(X), len(X[0]), len(X[0][0])
F = len(W)
kh, kw = len(W[0][0]), len(W[0][0][0])
sh, sw = _pair(stride)
ph, pw = _pair(pad)
OH = conv_output_size(H, kh, sh, ph)
OW = conv_output_size(Wd, kw, sw, pw)
Y = zeros3(F, OH, OW)
for f in range(F):
for i in range(OH):
for j in range(OW):
acc = b[f]
for c in range(C):
for p in range(kh):
u = i * sh + p - ph
if u < 0 or u >= H:
continue
for q in range(kw):
v = j * sw + q - pw
if 0 <= v < Wd:
acc += W[f][c][p][q] * X[c][u][v]
Y[f][i][j] = acc
return Y
# ==========================================================================
# 第 3 部分:层
# ==========================================================================
class Layer:
"""所有层的基类。"""
def forward(self, x):
raise NotImplementedError
def backward(self, dy):
raise NotImplementedError
def params(self):
"""返回 [(参数列表, 梯度列表), ...],用于优化器更新。"""
return []
def zero_grad(self):
for p, g in self.params():
for i in range(len(p)):
if isinstance(p[i], list):
_zero_like(p[i], g[i])
else:
g[i] = 0.0
def _zero_like(P, G):
for i in range(len(P)):
if isinstance(P[i], list):
_zero_like(P[i], G[i])
else:
G[i] = 0.0
class Conv2D(Layer):
"""二维卷积层(严格说是互相关,深度学习的"卷积"默认不翻转核)。
``k`` / ``stride`` / ``pad`` 都可以是 int(正方形核)或 (h, w) 二元组。
当图像高度为 1、核高也为 1 时,这层就退化成 **一维卷积**,
正是光谱、色谱、DNA 序列上用的那种卷积。
前向
----
cols = im2col(X) # (C*kh*kw, OH*OW)
Y = W_col @ cols + b # (F, OH*OW) -> (F, OH, OW)
反向(三个偏导,见本章第 4.6.3 节)
----
dW_col = dY_col @ cols^T
db = sum_{i,j} dY[f,i,j]
dX = col2im(W_col^T @ dY_col)
"""
def __init__(self, cin, cout, k, stride=1, pad=0, rng=None):
self.cin = cin
self.cout = cout
self.kh, self.kw = _pair(k)
self.stride = _pair(stride)
self.pad = _pair(pad)
rng = rng or random.Random(0)
# He 初始化:标准差 sqrt(2 / fan_in),fan_in = cin * kh * kw
scale = math.sqrt(2.0 / (cin * self.kh * self.kw))
self.W = [[[[rng.gauss(0.0, scale) for _ in range(self.kw)]
for _ in range(self.kh)] for _ in range(cin)]
for _ in range(cout)]
self.b = zeros(cout)
self.dW = zeros4(cout, cin, self.kh, self.kw)
self.db = zeros(cout)
self._cache = None
def _Wcol(self):
kh, kw = self.kh, self.kw
return [[self.W[f][c][p][q] for c in range(self.cin)
for p in range(kh) for q in range(kw)]
for f in range(self.cout)]
def forward(self, X):
F = self.cout
cols, OH, OW = im2col(X, self.kh, self.kw, self.stride, self.pad)
Wcol = self._Wcol()
out_col = matmul(Wcol, cols) # (F, OH*OW)
Y = zeros3(F, OH, OW)
for f in range(F):
bf = self.b[f]
of = out_col[f]
for i in range(OH):
Yi = Y[f][i]
base = i * OW
for j in range(OW):
Yi[j] = of[base + j] + bf
self._cache = (X, cols, OH, OW, Wcol)
return Y
def backward(self, dY):
X, cols, OH, OW, Wcol = self._cache
F, kh, kw = self.cout, self.kh, self.kw
# 1) 把 dY 拉平成 dY_col: (F, OH*OW)
dY_col = [[dY[f][i][j] for i in range(OH) for j in range(OW)]
for f in range(F)]
# 2) dW_col = dY_col @ cols^T
dW_col = matmul(dY_col, transpose(cols))
for f in range(F):
for c in range(self.cin):
for p in range(kh):
for q in range(kw):
self.dW[f][c][p][q] += dW_col[f][(c * kh + p) * kw + q]
# 3) db[f] = sum_{i,j} dY[f,i,j]
for f in range(F):
self.db[f] += math.fsum(dY_col[f])
# 4) dcols = W_col^T @ dY_col ; dX = col2im(dcols)
dcols = matmul(transpose(Wcol), dY_col)
return col2im(dcols, shape_of(X), kh, kw, self.stride, self.pad)
def params(self):
return [(self.W, self.dW), (self.b, self.db)]
class MaxPool2D(Layer):
"""最大池化。前向取每个窗口的最大值,反向只把梯度送给那个"赢家"。
``size`` / ``stride`` 支持 int 或 (h, w);``size=(1, 2)`` 就是沿一个方向
隔行抽取,光谱里常用。
"""
def __init__(self, size=2, stride=None):
self.kh, self.kw = _pair(size)
self.stride = _pair(stride) if stride is not None else (self.kh, self.kw)
self.argmax = None
self._shape = None
def forward(self, X):
C, H, W = len(X), len(X[0]), len(X[0][0])
kh, kw = self.kh, self.kw
sh, sw = self.stride
OH = (H - kh) // sh + 1
OW = (W - kw) // sw + 1
Y = zeros3(C, OH, OW)
argmax = [[[(0, 0)] * OW for _ in range(OH)] for _ in range(C)]
for c in range(C):
for i in range(OH):
for j in range(OW):
best = -float("inf")
bi = bj = 0
for p in range(kh):
Xc = X[c][i * sh + p]
for q in range(kw):
val = Xc[j * sw + q]
if val > best:
best, bi, bj = val, p, q
Y[c][i][j] = best
argmax[c][i][j] = (bi, bj)
self.argmax = argmax
self._shape = (C, H, W, OH, OW)
return Y
def backward(self, dY):
C, H, W, OH, OW = self._shape
sh, sw = self.stride
dX = zeros3(C, H, W)
for c in range(C):
for i in range(OH):
for j in range(OW):
bi, bj = self.argmax[c][i][j]
dX[c][i * sh + bi][j * sw + bj] += dY[c][i][j]
return dX
class ReLU(Layer):
"""逐元素 max(0, x)。反向是 mask:只有前向为正的位置能过梯度。"""
def __init__(self):
self.mask = None
def forward(self, X):
self.mask = _relu_mask(X)
return _relu_fwd(X)
def backward(self, dY):
return _relu_bwd(self.mask, dY)
def _relu_fwd(T):
if isinstance(T, list):
return [_relu_fwd(v) for v in T]
return T if T > 0.0 else 0.0
def _relu_mask(T):
if isinstance(T, list):
return [_relu_mask(v) for v in T]
return 1.0 if T > 0.0 else 0.0
def _relu_bwd(mask, dT):
if isinstance(mask, list):
return [_relu_bwd(m, d) for m, d in zip(mask, dT)]
return dT if mask else 0.0
class Flatten(Layer):
"""把 (C, H, W) 拉成 (C*H*W,)。反向再折叠回去。"""
def __init__(self):
self._shape = None
def forward(self, X):
self._shape = shape_of(X)
return flatten(X)
def backward(self, dy):
return _unflatten(dy, self._shape)
def _unflatten(vec, shape):
if len(shape) == 1:
return list(vec)
step = 1
for d in shape[1:]:
step *= d
return [_unflatten(vec[i * step:(i + 1) * step], shape[1:])
for i in range(shape[0])]
class GlobalAvgPool(Layer):
"""全局平均池化:(C, H, W) -> (C,),对每个通道的整张特征图取平均。
反向时把每个通道的梯度平均分给该通道的 H*W 个位置(式 (38) 中窗口取整张图)。
"""
def __init__(self):
self._shape = None
def forward(self, X):
C, H, W = len(X), len(X[0]), len(X[0][0])
self._shape = (C, H, W)
n = H * W
return [math.fsum(math.fsum(row) for row in plane) / n for plane in X]
def backward(self, dy):
C, H, W = self._shape
n = H * W
return [[[dy[c] / n] * W for _ in range(H)] for c in range(C)]
class Dense(Layer):
"""全连接层:y = W^T x + b,W: (in, out)。"""
def __init__(self, nin, nout, rng=None):
rng = rng or random.Random(0)
scale = math.sqrt(2.0 / nin)
self.W = [[rng.gauss(0.0, scale) for _ in range(nout)] for _ in range(nin)]
self.b = zeros(nout)
self.dW = zeros2(nin, nout)
self.db = zeros(nout)
self._x = None
def forward(self, x):
self._x = x
out = list(self.b)
for i, xi in enumerate(x):
if xi == 0.0:
continue
Wi = self.W[i]
for j in range(len(out)):
out[j] += xi * Wi[j]
return out
def backward(self, dy):
x = self._x
dx = [0.0] * len(x)
for i, xi in enumerate(x):
Wi = self.W[i]
s = 0.0
dWi = self.dW[i]
for j, gj in enumerate(dy):
dWi[j] += xi * gj
s += Wi[j] * gj
dx[i] = s
for j, gj in enumerate(dy):
self.db[j] += gj
return dx
def params(self):
return [(self.W, self.dW), (self.b, self.db)]
# ==========================================================================
# 第 4 部分:损失函数
# ==========================================================================
def softmax(z):
"""数值稳定的 softmax。"""
m = max(z)
e = [math.exp(v - m) for v in z]
s = sum(e)
return [v / s for v in e]
def cross_entropy(probs, label):
"""单样本交叉熵 L = -log p[label]。"""
if probs[label] <= 0.0:
raise ValueError("概率下溢;请使用 cross_entropy_logits")
return -math.log(probs[label])
def cross_entropy_logits(logits, label):
"""log-sum-exp 形式的稳定交叉熵。"""
m = max(logits)
return (m - logits[label]) + math.log(sum(math.exp(z-m) for z in logits))
def softmax_cross_entropy_backward(probs, label):
"""dL/dz = p - onehot(y)。这是整条反传链的起点。"""
d = list(probs)
d[label] -= 1.0
return d
# ==========================================================================
# 第 5 部分:模型与优化器
# ==========================================================================
class Sequential(Layer):
"""按顺序堆叠的层。forward 依次调用,backward 逆序调用。"""
def __init__(self, *layers):
self.layers = list(layers)
def forward(self, x):
for layer in self.layers:
x = layer.forward(x)
return x
def backward(self, dy):
for layer in reversed(self.layers):
dy = layer.backward(dy)
return dy
def params(self):
out = []
for layer in self.layers:
out.extend(layer.params())
return out
def zero_grad(self):
for layer in self.layers:
layer.zero_grad()
def num_params(self):
n = 0
for p, _ in self.params():
n += _count(p)
return n
def _count(T):
if isinstance(T, list):
return sum(_count(v) for v in T)
return 1
class SGD:
"""随机梯度下降,可选动量。
v <- mu * v - lr * g
w <- w + v
"""
def __init__(self, params, lr=0.05, momentum=0.0):
self.params = params
self.lr = lr
self.momentum = momentum
self.velocity = [deep_copy(p) for p, _ in params]
for v in self.velocity:
_fill_zero(v)
def step(self):
for idx, (p, g) in enumerate(self.params):
_sgd_update(p, g, self.velocity[idx], self.lr, self.momentum)
def _fill_zero(T):
for i in range(len(T)):
if isinstance(T[i], list):
_fill_zero(T[i])
else:
T[i] = 0.0
def _sgd_update(P, G, V, lr, mu):
for i in range(len(P)):
if isinstance(P[i], list):
_sgd_update(P[i], G[i], V[i], lr, mu)
else:
v = mu * V[i] - lr * G[i]
V[i] = v
P[i] += v
class Adam:
"""Adam 优化器(Kingma & Ba, 2015)。
m <- b1*m + (1-b1)*g
v <- b2*v + (1-b2)*g^2
m_hat = m / (1-b1^t), v_hat = v / (1-b2^t)
w <- w - lr * m_hat / (sqrt(v_hat) + eps)
"""
def __init__(self, params, lr=0.005, b1=0.9, b2=0.999, eps=1e-8):
self.params = params
self.lr, self.b1, self.b2, self.eps = lr, b1, b2, eps
self.m = [_zero_like_of(p) for p, _ in params]
self.v = [_zero_like_of(p) for p, _ in params]
self.t = 0
def step(self):
self.t += 1
bc1 = 1.0 - self.b1 ** self.t
bc2 = 1.0 - self.b2 ** self.t
for idx, (p, g) in enumerate(self.params):
_adam_update(p, g, self.m[idx], self.v[idx],
self.lr, self.b1, self.b2, self.eps, bc1, bc2)
def _zero_like_of(T):
if isinstance(T, list):
return [_zero_like_of(v) for v in T]
return 0.0
def _adam_update(P, G, M, V, lr, b1, b2, eps, bc1, bc2):
for i in range(len(P)):
if isinstance(P[i], list):
_adam_update(P[i], G[i], M[i], V[i], lr, b1, b2, eps, bc1, bc2)
else:
g = G[i]
m = b1 * M[i] + (1 - b1) * g
v = b2 * V[i] + (1 - b2) * g * g
M[i], V[i] = m, v
P[i] -= lr * (m / bc1) / (math.sqrt(v / bc2) + eps)
# ==========================================================================
# 第 6 部分:训练循环
# ==========================================================================
def iterate_minibatches(data, batch_size, rng):
"""把数据集切成随机 mini-batch。"""
idx = list(range(len(data)))
rng.shuffle(idx)
for start in range(0, len(idx), batch_size):
chunk = idx[start:start + batch_size]
yield [data[k] for k in chunk]
def train(model, opt, data, epochs=10, batch_size=8, rng=None, log_every=10):
"""训练一个分类器。
data: [(X, label), ...],X 是 (C, H, W) 图像,label 是整数类别。
返回每个 epoch 的平均损失。
"""
rng = rng or random.Random(0)
history = []
for epoch in range(epochs):
total, n = 0.0, 0
for batch in iterate_minibatches(data, batch_size, rng):
model.zero_grad()
batch_loss = 0.0
for X, y in batch:
logits = model.forward(X)
probs = softmax(logits)
batch_loss += cross_entropy_logits(logits, y)
dz = softmax_cross_entropy_backward(probs, y)
model.backward(dz)
nb = len(batch)
# 梯度取 mini-batch 平均
_scale_grads(model, 1.0 / nb)
opt.step()
total += batch_loss
n += nb
history.append(total / max(n, 1))
if log_every and (epoch + 1) % log_every == 0:
print(f" epoch {epoch + 1:3d} loss = {history[-1]:.6f}")
return history
def _scale_grads(model, factor):
for p, g in model.params():
_scale_in_place(g, factor)
def _scale_in_place(T, f):
for i in range(len(T)):
if isinstance(T[i], list):
_scale_in_place(T[i], f)
else:
T[i] *= f
def predict(model, X):
"""返回预测类别。"""
probs = softmax(model.forward(X))
return max(range(len(probs)), key=lambda k: probs[k])
def accuracy(model, data):
if not data:
return 0.0
correct = sum(1 for X, y in data if predict(model, X) == y)
return correct / len(data)
def confusion_matrix(model, data, n_class):
M = [[0] * n_class for _ in range(n_class)]
for X, y in data:
M[y][predict(model, X)] += 1
return M
# ==========================================================================
# 第 7 部分:梯度检查 —— 用有限差分校验解析梯度
# ==========================================================================
def scalar_loss_of(model, X, y):
"""把 (模型, 单样本) 映射成一个标量损失,供有限差分使用。"""
return cross_entropy_logits(flatten(model.forward(X)), y)
def check_gradient(model, X, y, eps=1e-5, seed=0):
"""比较解析梯度与中心差分梯度,返回最大相对误差。
中心差分: dL/dw ≈ (L(w+eps) - L(w-eps)) / (2*eps)
光滑条件下截断误差为 O(eps^2);还需考虑舍入、切换点和梯度尺度。
"""
rng = random.Random(seed)
# 1) 解析梯度
model.zero_grad()
logits = model.forward(X)
out_shape = shape_of(logits)
probs = softmax(flatten(logits))
dvec = softmax_cross_entropy_backward(probs, y)
model.backward(_unflatten(dvec, out_shape))
max_rel = 0.0
worst = None
for name, (p, g) in _named_params(model):
refs = _leaf_refs(p) # [(父容器, 下标), ...]
grad_refs = _leaf_refs(g)
n = len(refs)
sample_idx = list(range(n))
if n > 40:
sample_idx = rng.sample(sample_idx, 40)
for k in sample_idx:
parent, idx = refs[k]
orig = parent[idx]
parent[idx] = orig + eps
lp = scalar_loss_of(model, X, y)
parent[idx] = orig - eps
lm = scalar_loss_of(model, X, y)
parent[idx] = orig
num = (lp - lm) / (2 * eps)
ga, gi = grad_refs[k]
ana = ga[gi]
denom = max(abs(num) + abs(ana), 1e-12)
rel = abs(num - ana) / denom
if rel > max_rel:
max_rel = rel
worst = (name, k, ana, num)
return max_rel, worst
def _leaf_refs(T):
"""收集嵌套 list 中所有标量的 (父容器, 下标),用于原地读写。"""
refs = []
def rec(node):
if isinstance(node, list):
for i, v in enumerate(node):
if isinstance(v, list):
rec(v)
else:
refs.append((node, i))
rec(T)
return refs
def _named_params(model):
out = []
layers = getattr(model, "layers", None)
if layers is None:
return list(enumerate(model.params()))
for li, layer in enumerate(layers):
for pi, pair in enumerate(layer.params()):
tag = "W" if pi == 0 else "b"
out.append((f"layer{li}.{tag}", pair))
return out
# 在同一个 Python 会话(例如 Jupyter)中逐段运行本章代码时,下面几行把当前代码注册为
# 模块 cnn,后续代码块可以直接 import cnn。保存为 cnn.py 再导入时,这几行不起作用,也无副作用。
import sys
if "cnn" not in sys.modules:
import types
_mod = types.ModuleType("cnn")
for _k, _v in list(globals().items()):
if not _k.startswith("__"):
setattr(_mod, _k, _v)
sys.modules["cnn"] = _mod4.8.7 合成数据生成器
网络代码准备好后,还需要一批能检查它是否正常工作的输入。chemdata.py 生成三组教学数据,分别用于检查图样平移、谱线分类和纹理分类。生成规则已知,随机种子可以固定,因此容易复查结果,也容易控制某一种变化。后面的实验会说明每组数据检验了什么;在这些数据上分类成功,并不等于已经解决了真实化学或材料问题。
- 二维斑点图(
make_shape_dataset):每张 的图由三个点渲染而成,每个点贡献一个高斯斑块。三类图样分别是“直线形”、“弯折形”和“三角形”(代码中第三类的标签名为ring)。三类都恰好有三个点,所以点的数目不能用来区分类别。可以对点坐标施加逐点的随机扰动jitter,以及整体的随机平移shift。 - 合成红外曲线(
make_ir_spectra):在 4000–620 cm⁻¹ 范围内取 64 个等间隔采样点,按“烷烃、羰基化合物、醇”三类的代表性峰位、相对强度和宽度叠加高斯形吸收峰,再加入峰位抖动、强度抖动和噪声,最后归一化到 。 - 合成纹理(
make_micrograph_dataset):三类 的程序化纹理:由到随机中心点的距离生成的环状纹理、方向和周期随机的余弦条纹,以及逐像素独立的随机噪声。
python
# chemdata.py —— 本章三个合成数据集的生成器(只依赖标准库)
"""为教程准备的合成化学数据集(仅用标准库)。

为什么用合成数据?
------------------
1. 生成过程和随机种子明确,便于复查。
2. 可控制位置、峰模板与纹理,但不能由此判断模型学到了真实化学。
3. 用简化数据检查算法,真实任务仍需实验数据验证。

三个数据集
----------
1. ``make_shape_dataset``  二维高斯斑点 -> 形状分类(直线 / 弯曲 / 三角形)
                            比较平移后的分类表现。
2. ``make_ir_spectra``     合成红外样式曲线 -> 三类模板分类(烷烃 / 羰基 / 醇)
                            用来演示 **1D 卷积**在谱学里的用法。
3. ``make_micrograph_dataset``  程序生成纹理 -> 纹理分类
                            不对应具体材料物相。
"""

from __future__ import annotations

import math
import random


# --------------------------------------------------------------------------
# 通用工具
# --------------------------------------------------------------------------


def gaussian(x, mu, sigma):
    z = (x - mu) / sigma
    return math.exp(-0.5 * z * z)


def normalize_image(img):
    """把图像线性归一化到 [0, 1]。"""
    lo = min(min(row) for row in img)
    hi = max(max(row) for row in img)
    span = hi - lo
    if span < 1e-12:
        return [[0.0] * len(img[0]) for _ in range(len(img))]
    return [[(v - lo) / span for v in row] for row in img]


def add_noise(img, sigma, rng):
    return [[max(0.0, v + rng.gauss(0.0, sigma)) for v in row] for row in img]


# --------------------------------------------------------------------------
# 数据集 1:二维高斯斑点图
# --------------------------------------------------------------------------

# 三个"形状类"。坐标已归一化到 [0, 1]×[0, 1]。
# 每类有三个点;仍需检查强度分布、重叠及裁剪等可能的分类线索。
SHAPES = {
    "linear": [(0.50, 0.26), (0.50, 0.50), (0.50, 0.74)],        # 直线型
    "bent":   [(0.26, 0.66), (0.50, 0.46), (0.74, 0.66)],        # 弯曲型
    "ring":   [(0.50, 0.26), (0.30, 0.62), (0.70, 0.62)],        # 环/三角形
}
SHAPE_NAMES = ["linear", "bent", "ring"]


def render_density(atoms, size=12, sigma=0.085, noise=0.0, rng=None):
    """把一组二维点坐标渲染成一张 (1, size, size) 的高斯斑点灰度图。

    每个点贡献一个各向同性的高斯斑块:
        I(x, y) = sum_a exp( -((x-x_a)^2 + (y-y_a)^2) / (2 sigma^2) )
    这里只是点坐标的平滑表示,不是计算得到的电子密度。
    """
    rng = rng or random.Random(0)
    grid = [[0.0] * size for _ in range(size)]
    for i in range(size):
        y = (i + 0.5) / size
        for j in range(size):
            x = (j + 0.5) / size
            acc = 0.0
            for (ax, ay) in atoms:
                dx, dy = x - ax, y - ay
                acc += math.exp(-(dx * dx + dy * dy) / (2.0 * sigma * sigma))
            grid[i][j] = acc
    img = normalize_image(grid)
    if noise > 0.0:
        img = add_noise(img, noise, rng)
        img = normalize_image(img)
    return [img]


def make_shape_dataset(n_per_class=20, size=12, jitter=0.035, shift=0.0,
                       noise=0.05, seed=0):
    """生成 (X, label) 数据集。

    shift > 0 时对归一化点坐标施加连续随机位移,再渲染图像。
    训练集用 shift=0,测试集用 shift>0;它检验位置变化下的表现,
    不能单独证明模型只使用位置或形状。
    """
    rng = random.Random(seed)
    data = []
    for label, name in enumerate(SHAPE_NAMES):
        base = SHAPES[name]
        for _ in range(n_per_class):
            atoms = []
            for (ax, ay) in base:
                atoms.append((ax + rng.uniform(-jitter, jitter),
                              ay + rng.uniform(-jitter, jitter)))
            if shift > 0.0:
                dx = rng.uniform(-shift, shift)
                dy = rng.uniform(-shift, shift)
                atoms = [(ax + dx, ay + dy) for (ax, ay) in atoms]
            data.append((render_density(atoms, size=size, noise=noise, rng=rng),
                         label))
    rng.shuffle(data)
    return data


# --------------------------------------------------------------------------
# 数据集 2:合成红外光谱
# --------------------------------------------------------------------------

# 波数轴:4000 -> 620 cm^-1,从高波数到低波数(和实验谱图一致)
WN_HIGH, WN_LOW, WN_POINTS = 4000.0, 620.0, 64
WN_AXIS = [WN_HIGH + (WN_LOW - WN_HIGH) * k / (WN_POINTS - 1)
           for k in range(WN_POINTS)]

# 三个类别的"化学特征峰"(位置 cm^-1, 相对强度, 高斯标准差 sigma / cm^-1)
IR_CLASSES = {
    "alkane": [                       # 烷烃:只有 C-H
        (2925.0, 1.00, 55.0),         # CH2 反对称伸缩
        (2855.0, 0.85, 55.0),         # CH2 对称伸缩
        (1465.0, 0.55, 28.0),         # CH2 弯曲
        (1375.0, 0.35, 22.0),         # CH3 弯曲
    ],
    "carbonyl": [                     # 羰基化合物:C=O 是标志
        (1715.0, 1.00, 28.0),         # C=O 伸缩(尖锐、强)
        (2925.0, 0.30, 55.0),
        (1210.0, 0.45, 40.0),         # C-O 伸缩
    ],
    "alcohol": [                      # 醇:O-H 宽峰是标志
        (3350.0, 0.95, 190.0),        # O-H 伸缩(宽、强)
        (2925.0, 0.40, 55.0),
        (1050.0, 0.80, 45.0),         # C-O 伸缩
    ],
}
IR_NAMES = ["alkane", "carbonyl", "alcohol"]


def spectrum(peaks, rng, jitter=6.0, slope=0.0, noise=0.012):
    """生成向下的高斯谱峰样式曲线;归一化数值不是真实透过率。"""
    y = [1.0] * WN_POINTS
    for (mu, amp, width) in peaks:
        mu_j = mu + rng.uniform(-jitter, jitter)
        amp_j = amp * rng.uniform(0.85, 1.15)
        for k, wn in enumerate(WN_AXIS):
            y[k] -= amp_j * gaussian(wn, mu_j, width)
    if slope:
        for k in range(WN_POINTS):
            y[k] += slope * (k / (WN_POINTS - 1) - 0.5)
    for k in range(WN_POINTS):
        y[k] += rng.gauss(0.0, noise)
    # 归一化到 [0,1],再转成 (1, 1, L) 的"图像"
    lo, hi = min(y), max(y)
    span = max(hi - lo, 1e-9)
    y = [(v - lo) / span for v in y]
    return [[y]]           # (C=1, H=1, W=L)


def make_ir_spectra(n_per_class=20, seed=0):
    rng = random.Random(seed)
    data = []
    for label, name in enumerate(IR_NAMES):
        for _ in range(n_per_class):
            data.append((spectrum(IR_CLASSES[name], rng), label))
    rng.shuffle(data)
    return data


# --------------------------------------------------------------------------
# 数据集 3:程序生成的二维纹理
# --------------------------------------------------------------------------


def make_micrograph(phase, size=14, rng=None):
    """三类程序纹理:

        0: 环状纹理  (rings)
        1: 层状/条纹    (lamellar)
        2: 随机纹理  (random)
    """
    rng = rng or random.Random(0)
    img = [[0.0] * size for _ in range(size)]
    if phase == 0:
        centers = [(rng.uniform(0, size), rng.uniform(0, size))
                   for _ in range(4)]
        for i in range(size):
            for j in range(size):
                d = min(math.hypot(i - ci, j - cj) for ci, cj in centers)
                img[i][j] = math.exp(-((d % 4.0) / 1.1) ** 2)
    elif phase == 1:
        period = rng.uniform(3.0, 5.0)
        theta = rng.uniform(0, math.pi)
        ct, st = math.cos(theta), math.sin(theta)
        for i in range(size):
            for j in range(size):
                u = i * ct + j * st
                img[i][j] = 0.5 + 0.5 * math.cos(2 * math.pi * u / period)
    else:
        for i in range(size):
            for j in range(size):
                img[i][j] = rng.random()
    img = normalize_image(img)
    return [add_noise(img, 0.06, rng) for _ in range(1)]


def make_micrograph_dataset(n_per_class=16, size=14, seed=0):
    rng = random.Random(seed)
    data = []
    for label in range(3):
        for _ in range(n_per_class):
            data.append((make_micrograph(label, size=size, rng=rng), label))
    rng.shuffle(data)
    return data

# 与 cnn.py 相同:在同一会话中逐段运行时,把当前代码注册为模块 chemdata。
import sys
if "chemdata" not in sys.modules:
    import types
    _mod = types.ModuleType("chemdata")
    for _k, _v in list(globals().items()):
        if not _k.startswith("__"):
            setattr(_mod, _k, _v)
sys.modules["chemdata"] = _mod4.8.8 第一个实验:手工卷积核
先固定权重,观察卷积究竟怎样改变一张图。把第 4.7.6 节的七种 核分别作用到同一输入上,比较哪些核使图像变平滑,哪些核突出强度变化。这一步没有训练,适合把公式与可见的输出联系起来。
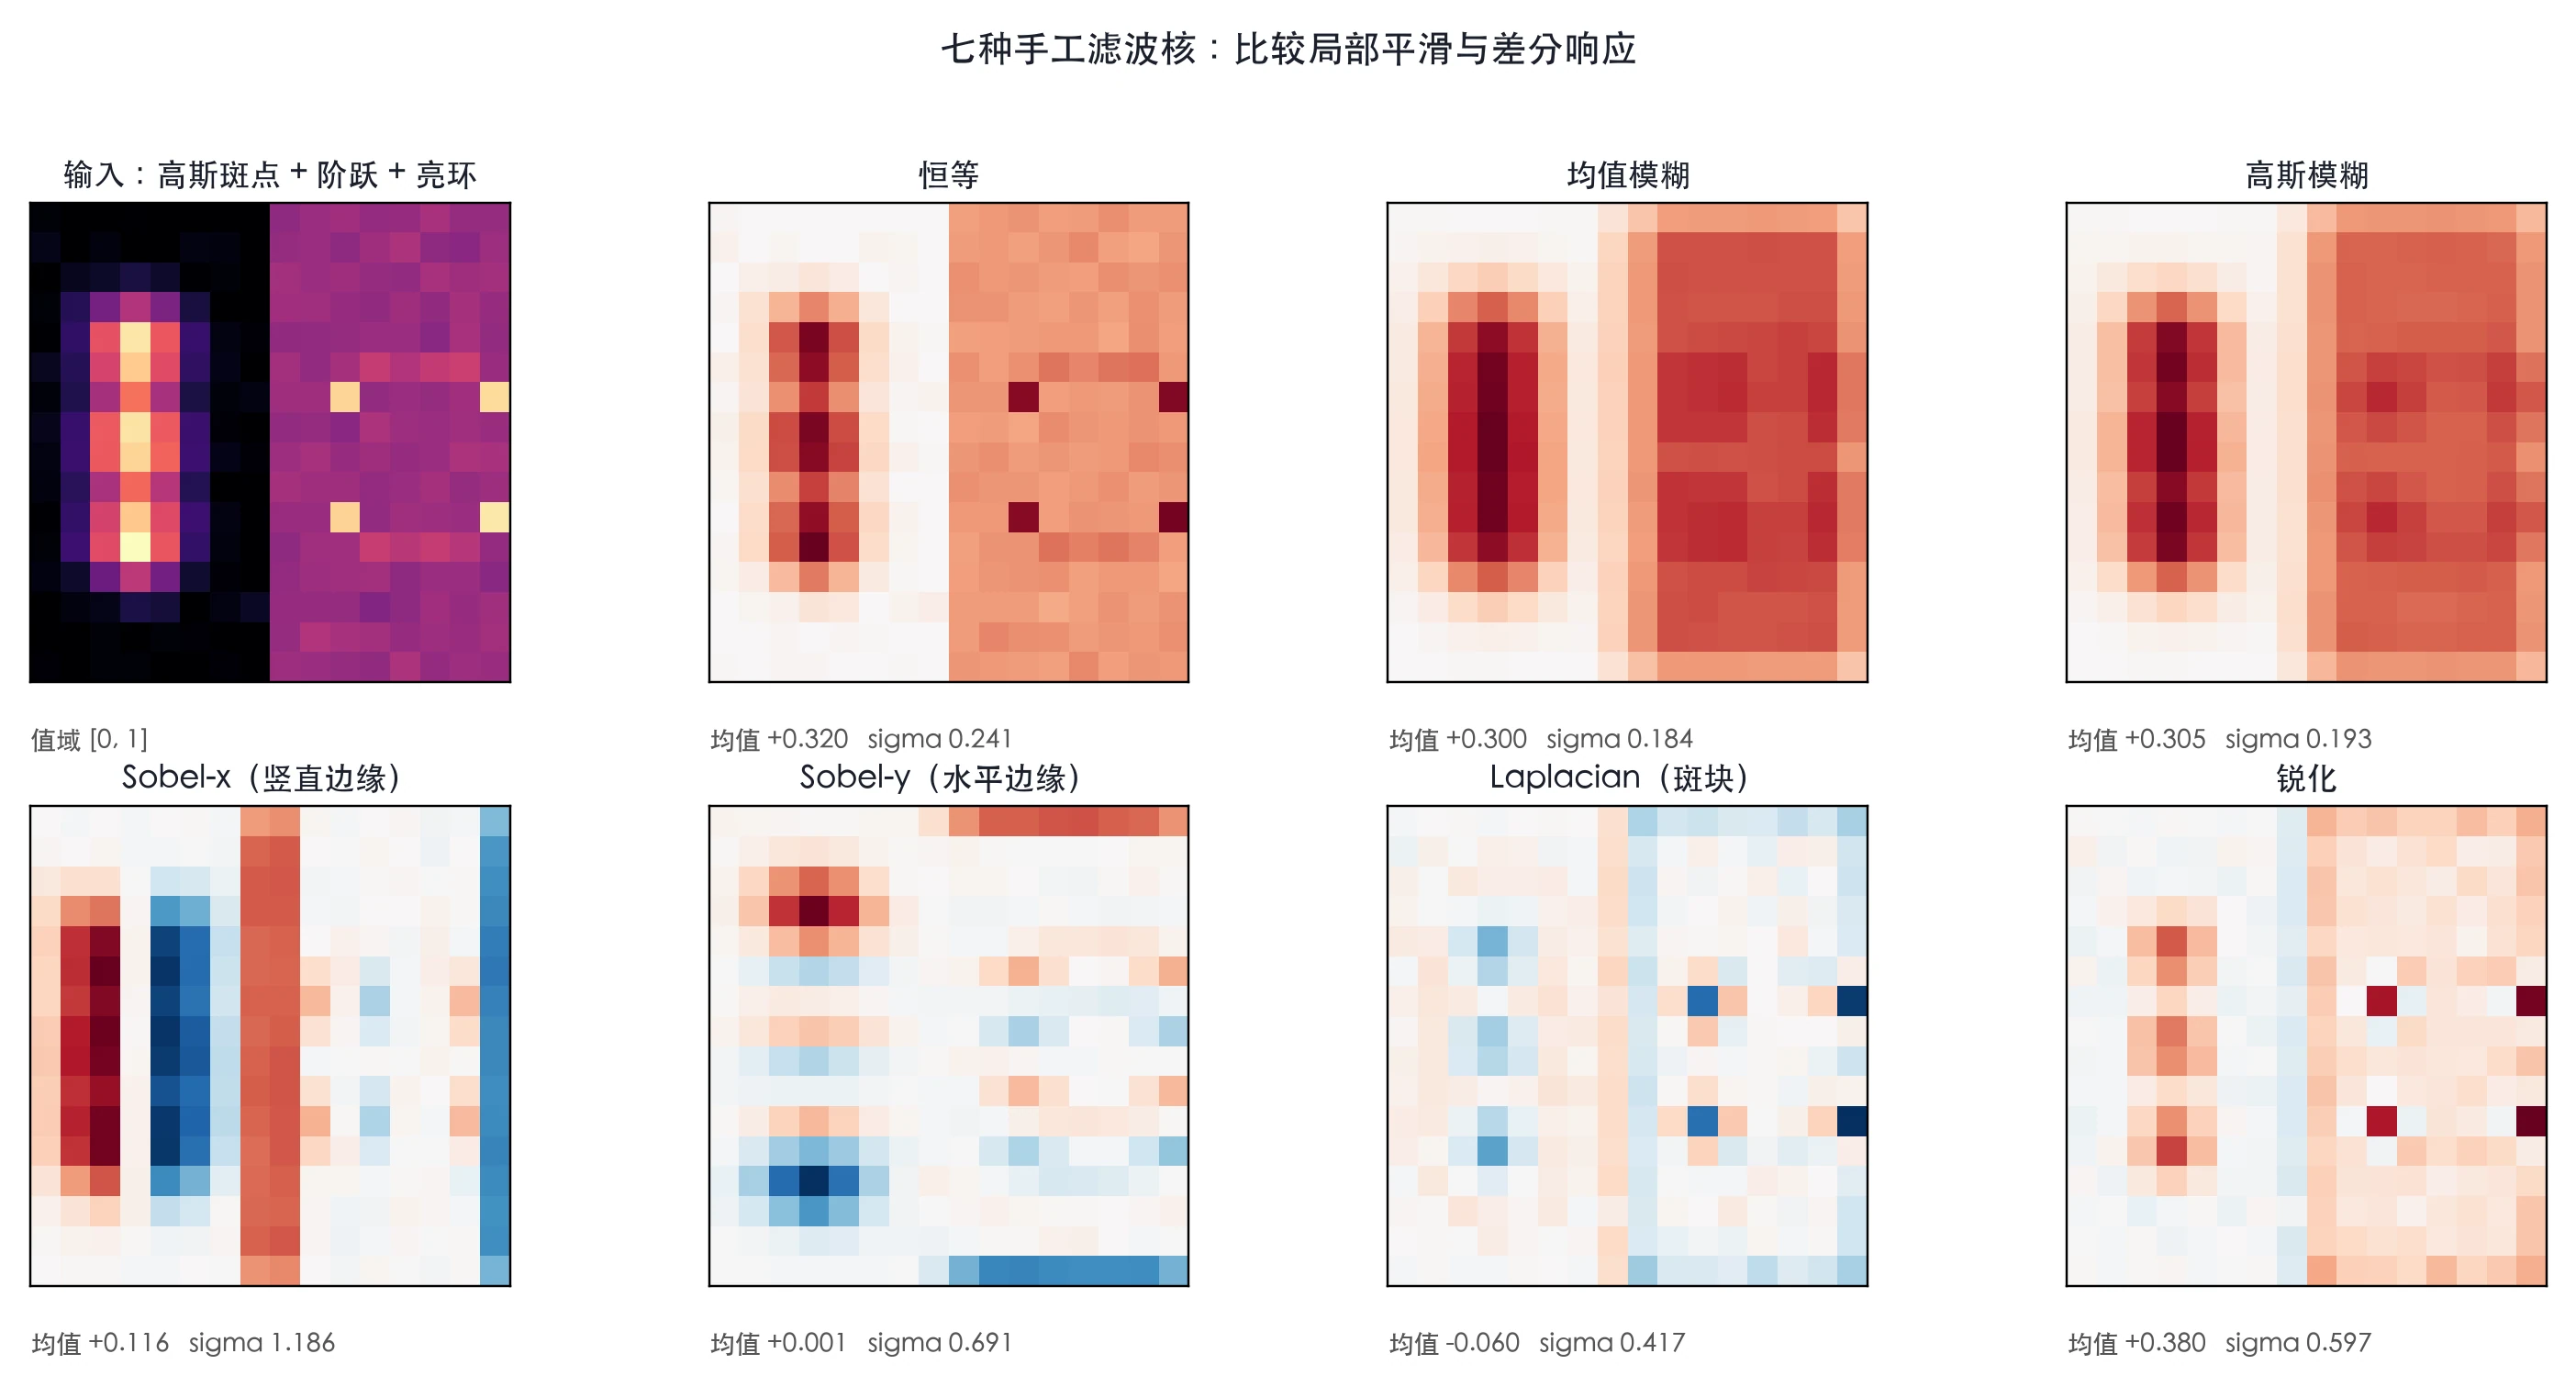
测试图像为 :左侧有三个竖直排列的高斯斑点,右半部分整体较亮,在中线处形成强度阶跃;右侧还有一个亮环,图中加入少量噪声。脚本同时比较 conv2d_direct 的直接循环结果与 Conv2D 的 im2col 结果,检查两种写法是否一致。
python
# demo_kernels.py —— 固定卷积核的滤波实验(无训练)
"""手工卷积核实验:卷积到底在"看"什么。

这一节不讲训练,只讲**一个固定卷积核**作用在图像上会发生什么。
对照不同核的响应,可以理解局部加权和;学习核的实际功能仍需另外分析。

使用的预设核(都是 3x3,不通过训练得到):
    恒等      [[0,0,0],[0,1,0],[0,0,0]]      原样复制
    均值模糊  1/9 * [[1,1,1],[1,1,1],[1,1,1]] 局部平均,去噪
    高斯模糊  1/16*[[1,2,1],[2,4,2],[1,2,1]]  更自然的平滑
    Sobel-x   [[-1,0,1],[-2,0,2],[-1,0,1]]    检测竖直边缘(水平方向求导)
    Sobel-y   [[-1,-2,-1],[0,0,0],[1,2,1]]    检测水平边缘(竖直方向求导)
    Laplacian [[0,1,0],[1,-4,1],[0,1,0]]      检测"斑点",二阶导
    锐化      [[0,-1,0],[-1,5,-1],[0,-1,0]]   原图加边缘

注意:深度学习的"卷积"其实是**互相关**(不翻转核)。
引用固定核时先确认卷积或互相关约定。这里的 Sobel 核中心反对称,
翻转会改变导数响应的符号;不能把这个结论推广到任意核。

运行:
    python3 demo_kernels.py
    python3 demo_kernels.py --out results_kernels.json
"""

import argparse
import json
import math
import os
import random

# 运行前请把 cnn.py、chemdata.py 与本脚本放在同一目录。
from cnn import Conv2D, conv2d_direct, zeros4
from chemdata import normalize_image, render_density


KERNELS = {
    "identity":  [[0.0, 0.0, 0.0], [0.0, 1.0, 0.0], [0.0, 0.0, 0.0]],
    "box_blur":  [[1 / 9, 1 / 9, 1 / 9], [1 / 9, 1 / 9, 1 / 9], [1 / 9, 1 / 9, 1 / 9]],
    "gaussian":  [[1 / 16, 2 / 16, 1 / 16], [2 / 16, 4 / 16, 2 / 16], [1 / 16, 2 / 16, 1 / 16]],
    "sobel_x":   [[-1.0, 0.0, 1.0], [-2.0, 0.0, 2.0], [-1.0, 0.0, 1.0]],
    "sobel_y":   [[-1.0, -2.0, -1.0], [0.0, 0.0, 0.0], [1.0, 2.0, 1.0]],
    "laplacian": [[0.0, 1.0, 0.0], [1.0, -4.0, 1.0], [0.0, 1.0, 0.0]],
    "sharpen":   [[0.0, -1.0, 0.0], [-1.0, 5.0, -1.0], [0.0, -1.0, 0.0]],
}


def build_test_image(size=16, seed=0):
    """左边三个高斯斑点,中间一条竖直阶跃,右边一个亮环。

    图中包含平滑斑点、强度阶跃和细线结构,用于比较滤波响应;
    不对应特定材料样品或电子结构计算。
    """
    rng = random.Random(seed)
    img = [[0.0] * size for _ in range(size)]
    density = render_density([(0.22, 0.30), (0.22, 0.50), (0.22, 0.70)],
                             size=size, sigma=0.07)[0]
    for i in range(size):
        for j in range(size):
            img[i][j] = density[i][j]
    # 中间:竖直阶跃
    for i in range(size):
        for j in range(size // 2, size):
            img[i][j] += 0.45
    # 右侧:一个亮环
    cy, cx, r = size * 0.5, size * 0.78, size * 0.20
    for i in range(size):
        for j in range(size):
            d = math.hypot(i - cy, j - cx)
            img[i][j] += 0.5 * math.exp(-((d - r) / 0.12) ** 2)
    img = normalize_image(img)
    for i in range(size):
        for j in range(size):
            img[i][j] = max(0.0, img[i][j] + rng.gauss(0.0, 0.02))
    return [normalize_image(img)]


def apply_kernel(X, k):
    """用 cnn.Conv2D 施加一个固定核(边界补零,使得输出尺寸不变)。"""
    layer = Conv2D(1, 1, 3, stride=1, pad=1, rng=random.Random(0))
    W = zeros4(1, 1, 3, 3)
    W[0][0] = [row[:] for row in k]
    layer.W = W
    layer.b = [0.0]
    return layer.forward(X)


def stats(T):
    flat = [v for plane in T for row in plane for v in row]
    mean = sum(flat) / len(flat)
    var = sum((v - mean) ** 2 for v in flat) / len(flat)
    return min(flat), max(flat), mean, math.sqrt(var), sum(abs(v) for v in flat)


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--out", default=None)
    args = ap.parse_args()

    X = build_test_image()
    print(f"输入图像:{len(X[0])}x{len(X[0][0])},取值 "
          f"[{stats(X)[0]:.3f}, {stats(X)[1]:.3f}]")
    print()
    print(f"{'卷积核':<11}{'最小':>8}{'最大':>8}{'均值':>8}"
          f"{'标准差':>9}{'绝对值和':>11}")
    print("-" * 56)

    results = {"input": X, "kernels": {}, "order": list(KERNELS)}
    for name, k in KERNELS.items():
        Y = apply_kernel(X, k)
        lo, hi, mean, sd, l1 = stats(Y)
        print(f"{name:<11}{lo:>8.3f}{hi:>8.3f}{mean:>8.3f}{sd:>9.3f}{l1:>11.2f}")
        results["kernels"][name] = {
            "weights": k,
            "output": Y[0],
            "lo": round(lo, 4), "hi": round(hi, 4),
            "mean": round(mean, 4), "sd": round(sd, 4), "l1": round(l1, 3),
        }

    print()
    print("怎么读这张表:")
    print("  * identity 与原图完全一致(标准差 = 原图标准差)。")
    print("  * 模糊核把标准差压低——它在做局部平均,细节被抹掉。")
    print("  * 差分核的权重和为0,因此内部常数区响应为0;")
    print("    有限图像的边界和非均匀输入仍可产生非零全图均值。")

    # 顺便验证:库里的 Conv2D 与教科书写法完全一致
    k = KERNELS["sobel_x"]
    W = zeros4(1, 1, 3, 3)
    W[0][0] = [row[:] for row in k]
    a = apply_kernel(X, k)
    b = conv2d_direct(X, W, [0.0], stride=1, pad=1)
    maxdiff = max(abs(a[0][i][j] - b[0][i][j])
                  for i in range(len(a[0])) for j in range(len(a[0][0])))
    print(f"\n一致性检查:im2col 实现 vs 直接双重循环,最大差异 {maxdiff:.2e}")
    results["max_abs_diff_im2col_vs_direct"] = maxdiff

    if args.out:
        with open(args.out, "w", encoding="utf-8") as f:
            json.dump(results, f, ensure_ascii=False, indent=2)
        print(f"结果已写入 {os.path.abspath(args.out)}")


if __name__ == "__main__":
main()运行 python3 demo_kernels.py,可以得到表3 的统计结果。这个测试输入上,im2col 实现与直接循环的最大差异为 0。读表时可以配合图 19:数值统计概括整张图的变化,响应图显示变化发生在哪里。
表3 七种手工卷积核作用于测试图像后的响应统计(补零 1,输出 )
| 卷积核 | 最小值 | 最大值 | 均值 | 标准差 | 绝对值之和 |
|---|---|---|---|---|---|
| 恒等 | 0.000 | 1.000 | 0.320 | 0.241 | 81.88 |
| 均值模糊 | 0.001 | 0.681 | 0.300 | 0.184 | 76.87 |
| 高斯模糊 | 0.003 | 0.740 | 0.305 | 0.193 | 78.11 |
| Sobel-x | −2.783 | 2.829 | 0.116 | 1.186 | 204.85 |
| Sobel-y | −2.839 | 2.777 | 0.001 | 0.691 | 104.78 |
| Laplacian | −2.520 | 0.693 | −0.060 | 0.417 | 67.68 |
| 锐化 | −0.540 | 3.473 | 0.380 | 0.597 | 124.48 |
可以从表中读出几个规律。恒等核原样输出,标准差 0.241 就是原图的标准差。两个模糊核把标准差压低到 0.18–0.19,说明它们在做局部平均,细节被抹平;均值和最大值也略有下降,这主要来自边界处补的零。Sobel 和 Laplacian 核的权重之和为 0,在内部的平坦区域响应为 0,因此它们的输出均值接近 0;Sobel-x 的标准差和绝对值之和远大于 Sobel-y,说明这幅图中竖直走向的边缘(斑点的左右两侧和中线处的阶跃)比水平走向的边缘多得多。Sobel-x 的均值 0.116 不为零,是因为图像右半部分更亮,补零后的右边界产生了大的负响应、中线阶跃产生了大的正响应,二者并不完全抵消。图 19 直观地展示了这些响应。
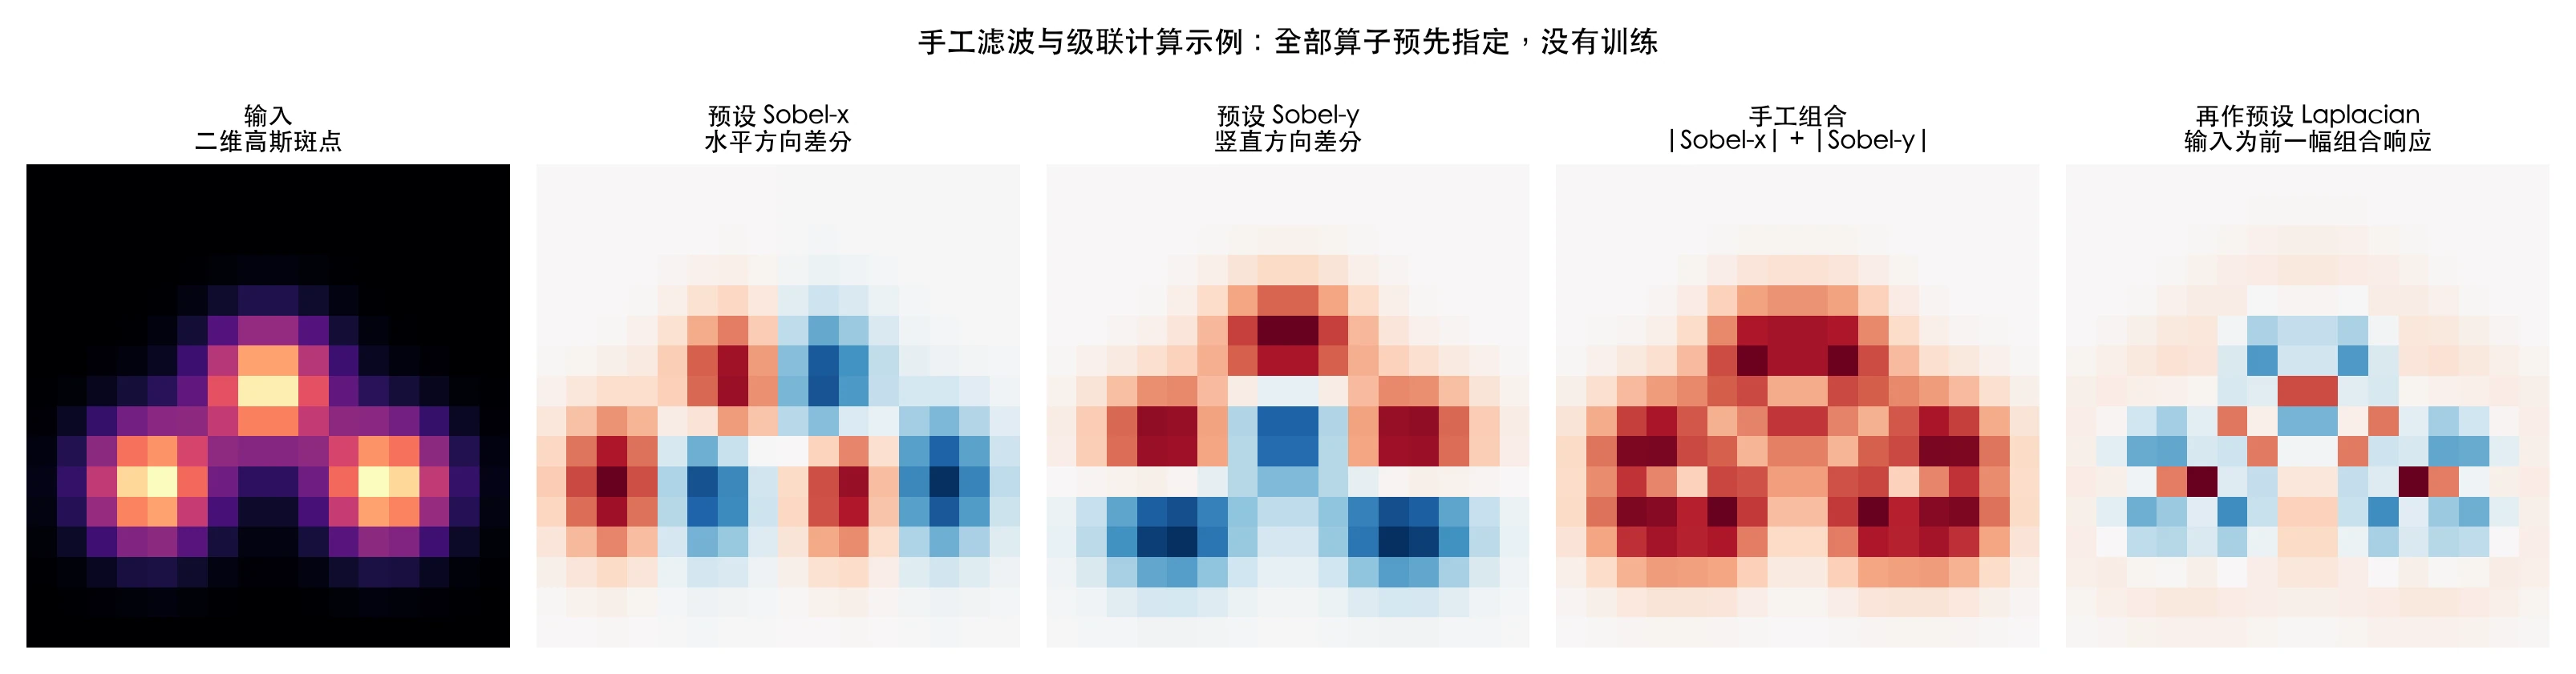
多个卷积核还可以级联使用:前一个核的输出经过非线性处理后,作为下一个核的输入。图 20 演示了这种“滤波—非线性组合—再滤波”的计算结构,这正是 CNN 中“卷积—激活—卷积”的雏形。区别在于,这里的每一个核都是人工指定的,而 CNN 的卷积核是从数据中学出来的。
4.8.9 测试与梯度检查
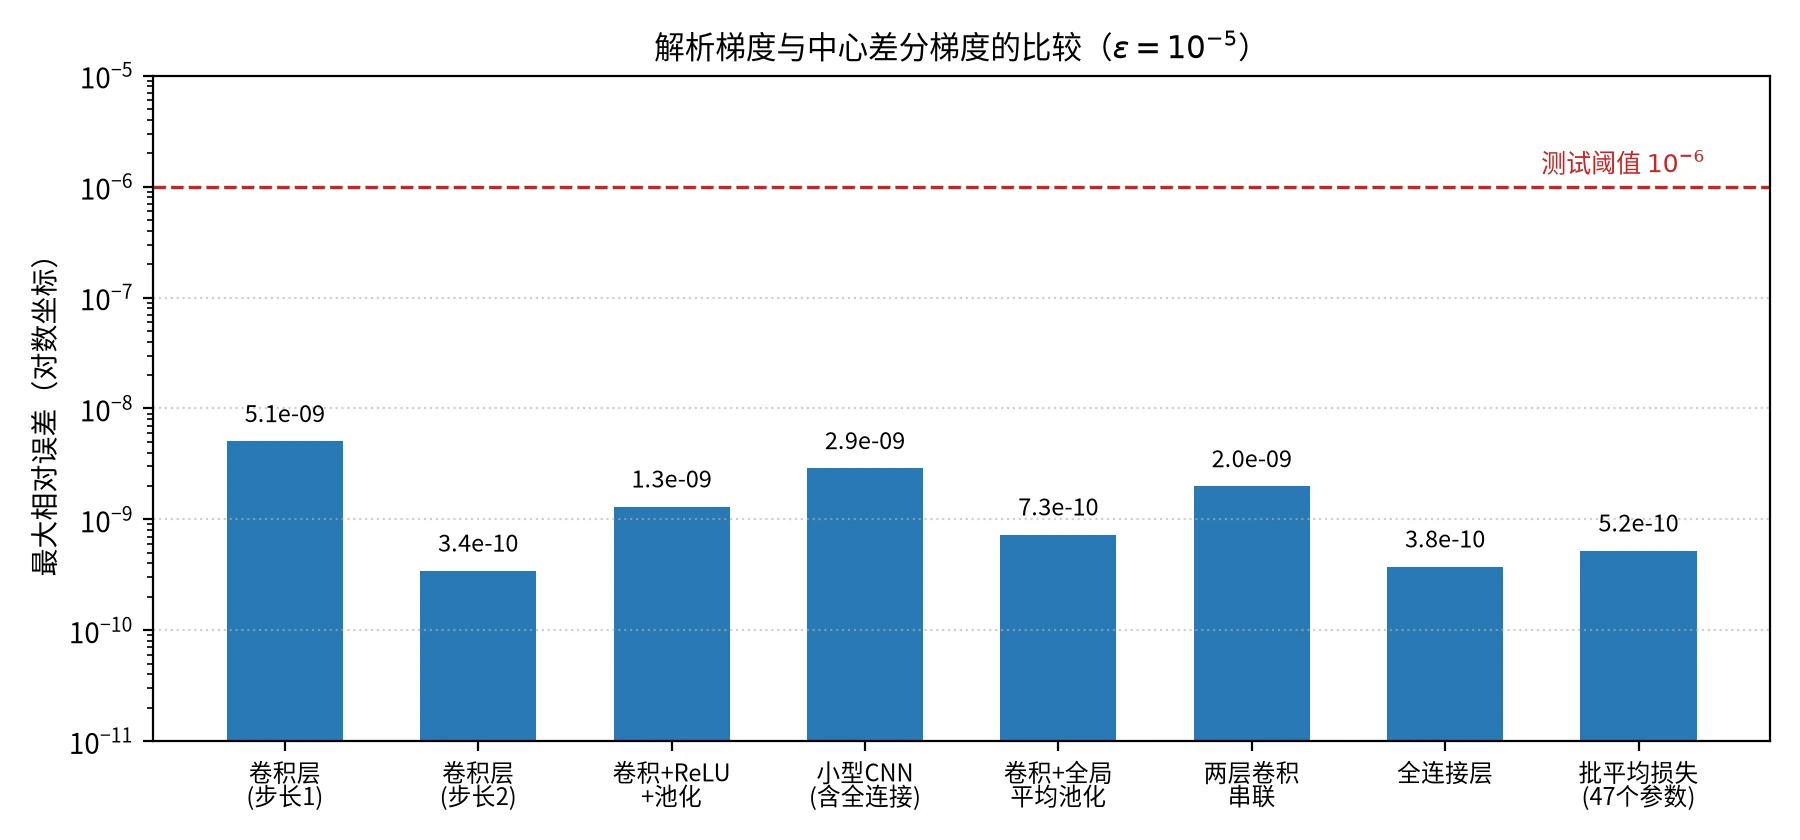
滤波结果检验了前向计算,还需要检查训练所用的反向计算。下面的自动化测试把第 4.6.6 节的有限差分用于单层、小型网络以及批平均损失,比较数值梯度与代码返回的梯度:
表4 梯度检查结果(中心差分 )
| 测试对象 | 最大相对误差 |
|---|---|
| 卷积层(步长 1,补零 1) | |
| 卷积层(步长 2,补零 1) | |
| 卷积 + ReLU + 最大池化 | |
| 小型 CNN(卷积 + 池化 + 全连接) | |
| 卷积 + 全局平均池化 + 全连接 | |
| 两个卷积层串联(第二层步长 2) | |
| 全连接层 | |
| 批平均损失(3 个样本,47 个参数) |
所有相对误差都在 以下,比测试阈值 小两个数量级以上,与第 4.6.6 节的误差估计一致。与 PyTorch 的对照中,前向输出、输入梯度、卷积核梯度和偏置梯度的最大绝对差异分别为 、、 和 0,均在双精度舍入误差的量级。需要说明的是,测试只能证明代码在所测试的配置下是正确的,不能代替对任意配置的数学证明;但它能可靠地捕捉绝大多数下标和累加错误。
4.9 化学与材料中的应用
前面已经知道 CNN 怎样计算和训练,现在要检查它是否解决了我们关心的问题。这里有三个判断始终需要分开:输入保留了什么信息,网络能够利用什么规律,测试结果又支持多大范围的结论。
先从分子的不同表示谈起,用二维斑点图检查平移的影响,再用真实的 ESOL 数据比较分子图像与描述符。随后回到本章开头的两个对象:光谱实验检查打乱采样顺序的影响,纹理实验检查网络能否区分不同的局部图样。每个实验的完整代码都保留在文中,阅读时可以先连贯地看问题、数据、结果和讨论,需要复现时再展开代码。
完成这些实验后,我们再讨论局部计算与共享参数怎样联系到机器学习势函数、逆向设计,以及实际使用时怎样避免数据泄漏和过度解读。
4.9.1 分子:什么时候适合用 CNN
分子的表示与对称性
面对一个分子,首先要决定把什么交给网络。可以使用原子与化学键组成的图、带元素种类的三维坐标、SMILES 字符串,也可以使用二维结构图像。它们描述的是同一个对象,但保留的信息和排列方式不同。只有先选好表示,才能判断滑动窗口是否适合。
还要明确预测值应该怎样随输入变化。例如,把一个孤立分子整体移动或转动,其势能不应改变;交换两个氢原子的编号,也没有改变这个分子。这分别对应平移、旋转和同种原子编号置换的不变性。偶极矩、受力这类矢量则应随分子的旋转一起转动,对它们的要求是等变。
阅读几何模型文献时,还会遇到 和 :前者表示三维真旋转构成的群,后者还包括反射。初次阅读可以先记住它们对应哪些变换。特别是反射,一对对映体在非手性环境中的许多性质相同,但与手性受体作用时可能不同,所以是否要求镜像不变,要由预测的性质和环境决定。
对照第 4.3.2 节的结论,普通 CNN 只具有(有条件的)离散平移等变性,不自动具有旋转等变性:把分子图像旋转 30°,特征图并不会相应地旋转。至于置换对称性,则取决于输入如何构造:如果按元素把所有原子的贡献叠加成密度场再网格化,得到的图像本身就与原子编号无关;但如果直接把原子坐标按编号排成数组输入网络,编号置换就会改变输入。图神经网络(GNN)天然满足节点置换等变,但几何上的旋转等变性仍需专门设计(第 08–09 章将详细讨论)。
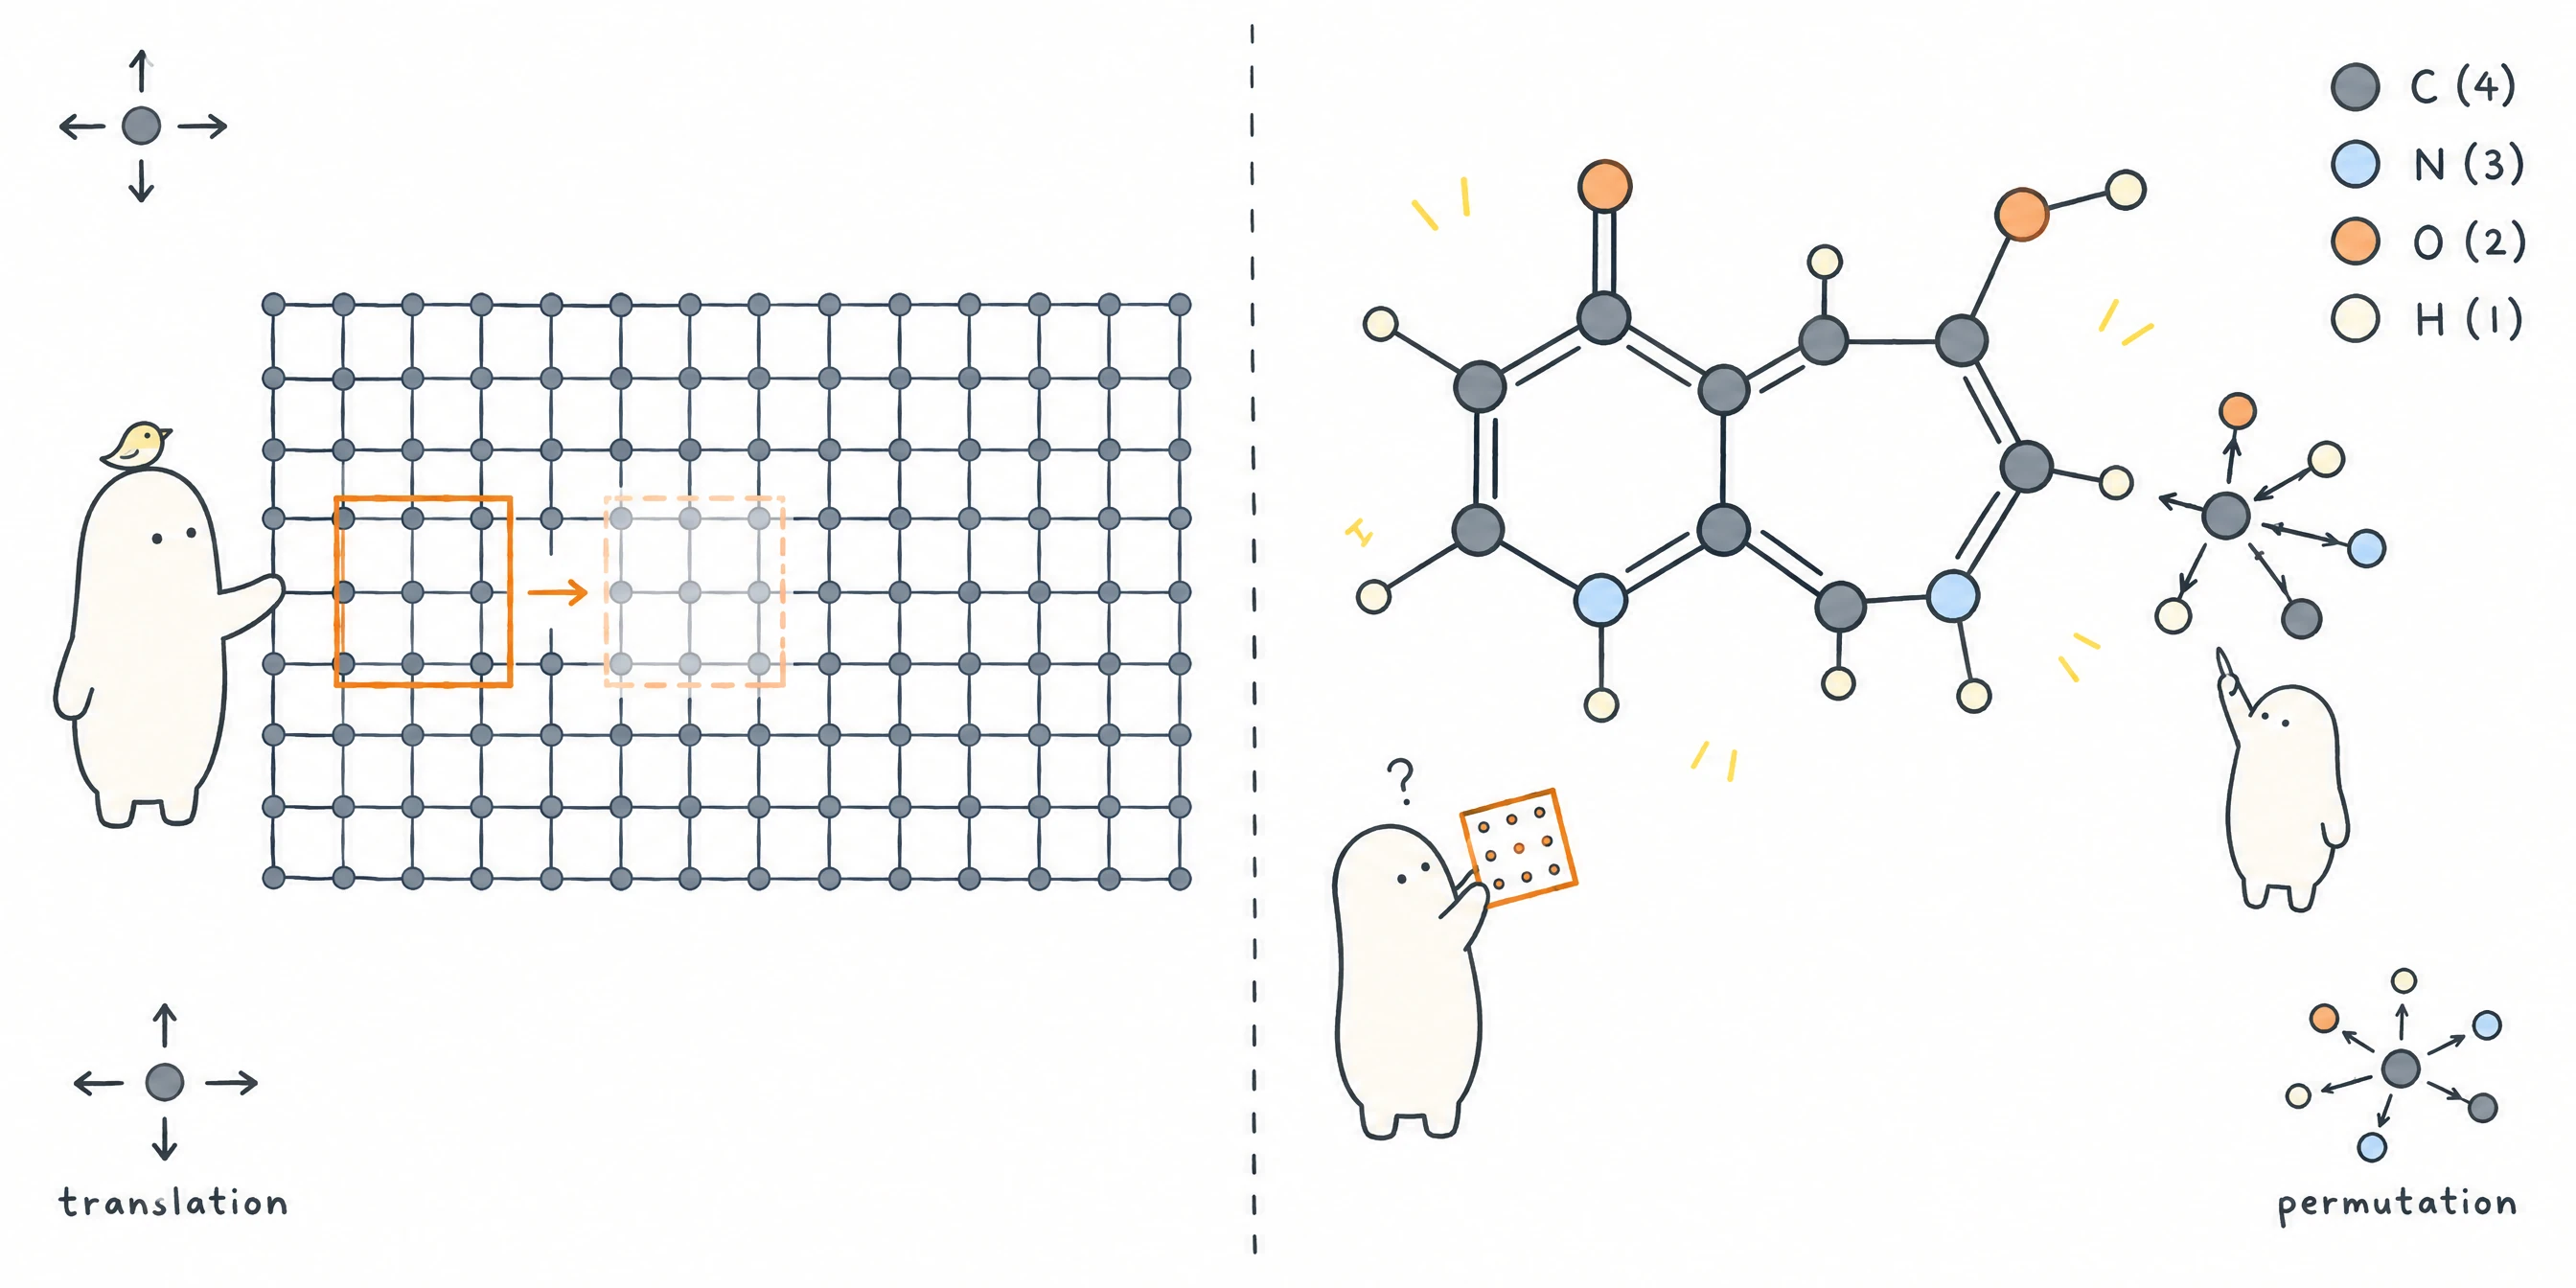
信息损失是另一个需要考虑的问题。二维投影图像丢失了深度信息;二维结构式图像能否反映立体化学,取决于编码方式。三维体素网格能保留空间分布,但存储量随网格边长 按 增长,且大部分体素是空的。网格模型、图模型和等变模型各有所长,应在同一任务上公平比较,而不是预先排除某一类。图 22 对比了规则网格和分子图两种表示。
因此,规则网格上的场或图像可以从 CNN 开始比较;原子坐标、分子图和定长描述符,则还需要考虑几何等变模型、图模型、MLP 和树模型等。下面先用一个简化实验检查“图样换个位置”会怎样影响预测,再把分子结构编码成图像,与描述符模型比较。第一个实验中的斑点只是几何图样,不代表分子的电子密度或真实构型。
4.9.1.1 实验一:二维图样的平移测试
实验问题。 一个模型在图样位于原处时能正确分类,把图样整体移开后,它还能认出来吗?第 4.3.2 节已经说明,卷积层的响应会随图样移动,但最后的类别判断未必保持不变。这里比较 MLP、展平后接全连接层的 CNN,以及使用全局平均池化的 CNN,观察它们对位置变化的敏感程度。
数据。 使用 chemdata.make_shape_dataset 生成三类 的二维斑点图样:三个点排成直线、弯折线或三角形,每个点渲染成一个高斯斑块。图 23 给出了示例。训练集每类 22 张,只对每个点的坐标施加小的随机扰动,不做整体平移。测试时,每类取 12 张,把整个图样沿两个方向各平移一个从 均匀抽取的随机量后重新渲染, 依次取 0、0.08、0.16、0.25、0.33。这里的平移量以归一化坐标(图像边长为 1)计, 约相当于 4 个像素。
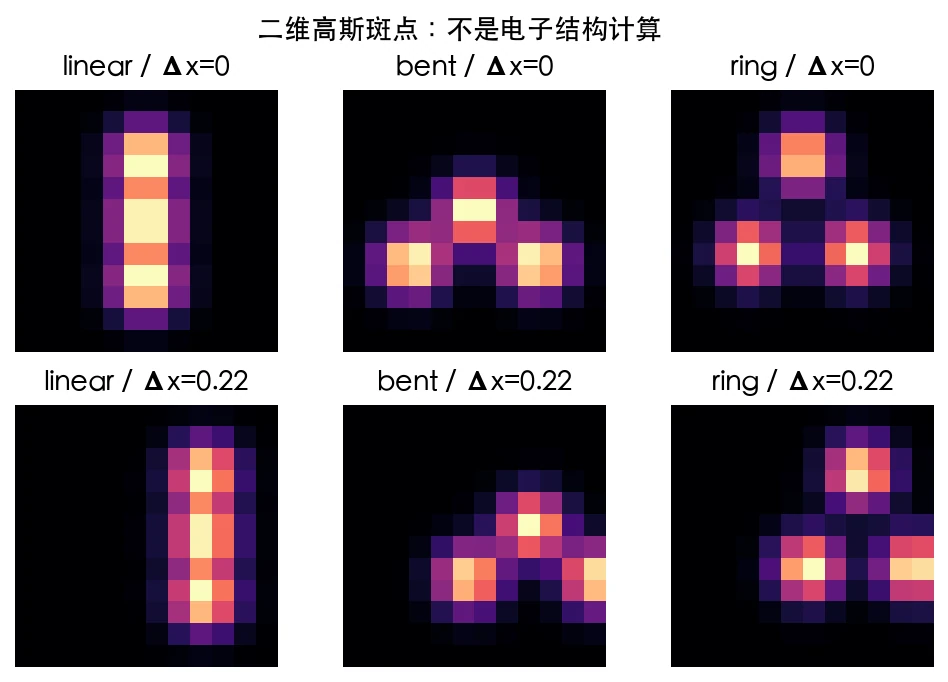
注意这个设计中的两个细节。第一,三类图样都恰好由三个点组成,模型不能靠“数点数”来分类,但斑块的重叠方式、归一化后的亮度分布仍可能提供线索。第二,平移是连续的,并且平移后图样可能部分移出视场,这比第 4.3.2 节的整数平移更接近真实情况,也更苛刻。
模型。 比较三个模型:
- MLP:把 144 个像素展平,经 48 个隐藏单元输出 3 类,共 7107 个参数;
- CNN:第 4.5.1 节的网络,两个卷积块后展平接全连接层,共 555 个参数;
- CNN-GAP:前两个卷积层与 CNN 相同,但第二个卷积层后不再池化和展平,而是做全局平均池化(
GlobalAvgPool),把 的特征图压缩为 8 维向量,再接Dense(8→3),共 363 个参数。
三个模型使用相同的优化器(Adam,学习率 0.01)、批大小(8)和训练轮数(60)。为了避免单次实验的偶然性,整个实验(包括数据生成和参数初始化)用 5 个不同的随机种子重复。
python
# demo_molecules.py —— 二维斑点形状分类:MLP、CNN 与带全局平均池化的 CNN 的平移测试
"""比较三种模型对合成二维斑点形状的分类,以及它们对输入平移的敏感程度。

三个模型
    MLP      :Flatten -> Dense(144->48) -> ReLU -> Dense(48->3),7107 个参数
    CNN      :两个卷积块 -> Flatten -> Dense(72->3),555 个参数
    CNN-GAP  :两个卷积块(第二块不池化)-> 全局平均池化 -> Dense(8->3),363 个参数

训练集只含逐点扰动、不施加整体平移;测试时施加不同幅度的连续随机平移后重新渲染。
每个模型用多个随机种子(同时改变数据和初始化)重复,报告平均准确率与标准差。

运行:python3 demo_molecules.py [--seeds 1,2,3,4,5] [--quick] [--out results.json]
"""

import argparse
import json
import os
import random
import statistics
import time

# 运行前请把 cnn.py、chemdata.py 与本脚本放在同一目录。
import cnn
from cnn import (Conv2D, Dense, Flatten, GlobalAvgPool, MaxPool2D, ReLU,
                 Sequential)
from chemdata import make_shape_dataset

SHIFT_LEVELS = [0.00, 0.08, 0.16, 0.25, 0.33]


def build_mlp(seed=1):
    return Sequential(
        Flatten(),                              # 12*12 = 144
        Dense(144, 48, rng=random.Random(seed)),
        ReLU(),
        Dense(48, 3, rng=random.Random(seed + 1)),
    )


def build_cnn(seed=1):
    return Sequential(
        Conv2D(1, 4, 3, stride=1, pad=1, rng=random.Random(seed)),
        ReLU(),
        MaxPool2D(2),                           # 12x12 -> 6x6
        Conv2D(4, 8, 3, stride=1, pad=1, rng=random.Random(seed + 1)),
        ReLU(),
        MaxPool2D(2),                           # 6x6 -> 3x3
        Flatten(),                              # 8*3*3 = 72
        Dense(72, 3, rng=random.Random(seed + 2)),
    )


def build_cnn_gap(seed=1):
    return Sequential(
        Conv2D(1, 4, 3, stride=1, pad=1, rng=random.Random(seed)),
        ReLU(),
        MaxPool2D(2),                           # 12x12 -> 6x6
        Conv2D(4, 8, 3, stride=1, pad=1, rng=random.Random(seed + 1)),
        ReLU(),
        GlobalAvgPool(),                        # (8, 6, 6) -> (8,)
        Dense(8, 3, rng=random.Random(seed + 2)),
    )


MODELS = [("MLP", build_mlp), ("CNN", build_cnn), ("CNN-GAP", build_cnn_gap)]


def run_one(build, seed, train, test_sets, epochs, lr, batch_size):
    model = build(seed=seed)
    opt = cnn.Adam(model.params(), lr=lr)
    t0 = time.time()
    history = cnn.train(model, opt, train, epochs=epochs, batch_size=batch_size,
                        rng=random.Random(seed), log_every=0)
    accs = [cnn.accuracy(model, data) for data in test_sets]
    return model.num_params(), history, accs, time.time() - t0


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--seeds", default="1,2,3,4,5")
    ap.add_argument("--quick", action="store_true")
    ap.add_argument("--out", default=None, help="把结果写成 JSON")
    args = ap.parse_args()

    seeds = [int(s) for s in args.seeds.split(",")]
    n_per = 12 if args.quick else 22
    epochs = 20 if args.quick else 60
    batch, lr = 8, 0.01

    results = {name: {"accs": [], "histories": []} for name, _ in MODELS}
    for seed in seeds:
        train = make_shape_dataset(n_per_class=n_per, shift=0.00, seed=seed)
        test_sets = [make_shape_dataset(n_per_class=12, shift=s,
                                        seed=1000 * seed + int(s * 100))
                     for s in SHIFT_LEVELS]
        print(f"种子 {seed}:训练 {len(train)} 条(不施加整体平移),"
              f"每个平移幅度测试 {len(test_sets[0])} 条")
        for name, build in MODELS:
            n_params, hist, accs, dt = run_one(build, seed, train, test_sets,
                                               epochs, lr, batch)
            results[name]["params"] = n_params
            results[name]["accs"].append(accs)
            results[name]["histories"].append([round(v, 6) for v in hist])
            print(f"  {name:<8} 参数 {n_params:>5}  最终训练损失 {hist[-1]:.2e}  "
                  + "  ".join(f"{a:.3f}" for a in accs) + f"   ({dt:.1f}s)")

    print("\n" + "=" * 78)
    print(f"{len(seeds)} 个种子的平均测试准确率(括号内为标准差)")
    print(f"{'模型':<9}{'参数':>6}  " + "".join(f"   ±{s:<9.2f}" for s in SHIFT_LEVELS))
    print("-" * 78)
    for name, _ in MODELS:
        cols = list(zip(*results[name]["accs"]))
        cells = []
        for col in cols:
            sd = statistics.stdev(col) if len(col) > 1 else 0.0
            cells.append(f"{statistics.mean(col):.3f}({sd:.3f})")
        results[name]["mean"] = [statistics.mean(c) for c in cols]
        results[name]["std"] = [statistics.stdev(c) if len(c) > 1 else 0.0 for c in cols]
        print(f"{name:<9}{results[name]['params']:>6}  " + "".join(f"{c:>13}" for c in cells))
    print("=" * 78)

    if args.out:
        payload = {"experiment": "shapes", "seeds": seeds, "shifts": SHIFT_LEVELS,
                   "results": results}
        with open(args.out, "w", encoding="utf-8") as f:
            json.dump(payload, f, ensure_ascii=False, indent=2)
        print(f"\n结果已写入 {os.path.abspath(args.out)}")


if __name__ == "__main__":
main()结果。 运行 python3 demo_molecules.py,5 个种子的平均结果见表5 和图 24。
表5 三种模型在不同平移幅度下的测试准确率(5 个随机种子的均值 ± 标准差,每个种子每档 36 个测试样本)
| 模型 | 参数量 | 0.08 | 0.16 | 0.25 | 0.33 | |
|---|---|---|---|---|---|---|
| MLP | 7107 | 1.000 ± 0.000 | 0.983 ± 0.025 | 0.728 ± 0.084 | 0.556 ± 0.102 | 0.450 ± 0.041 |
| CNN(展平 + 全连接) | 555 | 1.000 ± 0.000 | 0.967 ± 0.023 | 0.778 ± 0.076 | 0.644 ± 0.114 | 0.506 ± 0.053 |
| CNN-GAP(全局平均池化) | 363 | 1.000 ± 0.000 | 0.983 ± 0.025 | 0.894 ± 0.087 | 0.794 ± 0.089 | 0.744 ± 0.128 |
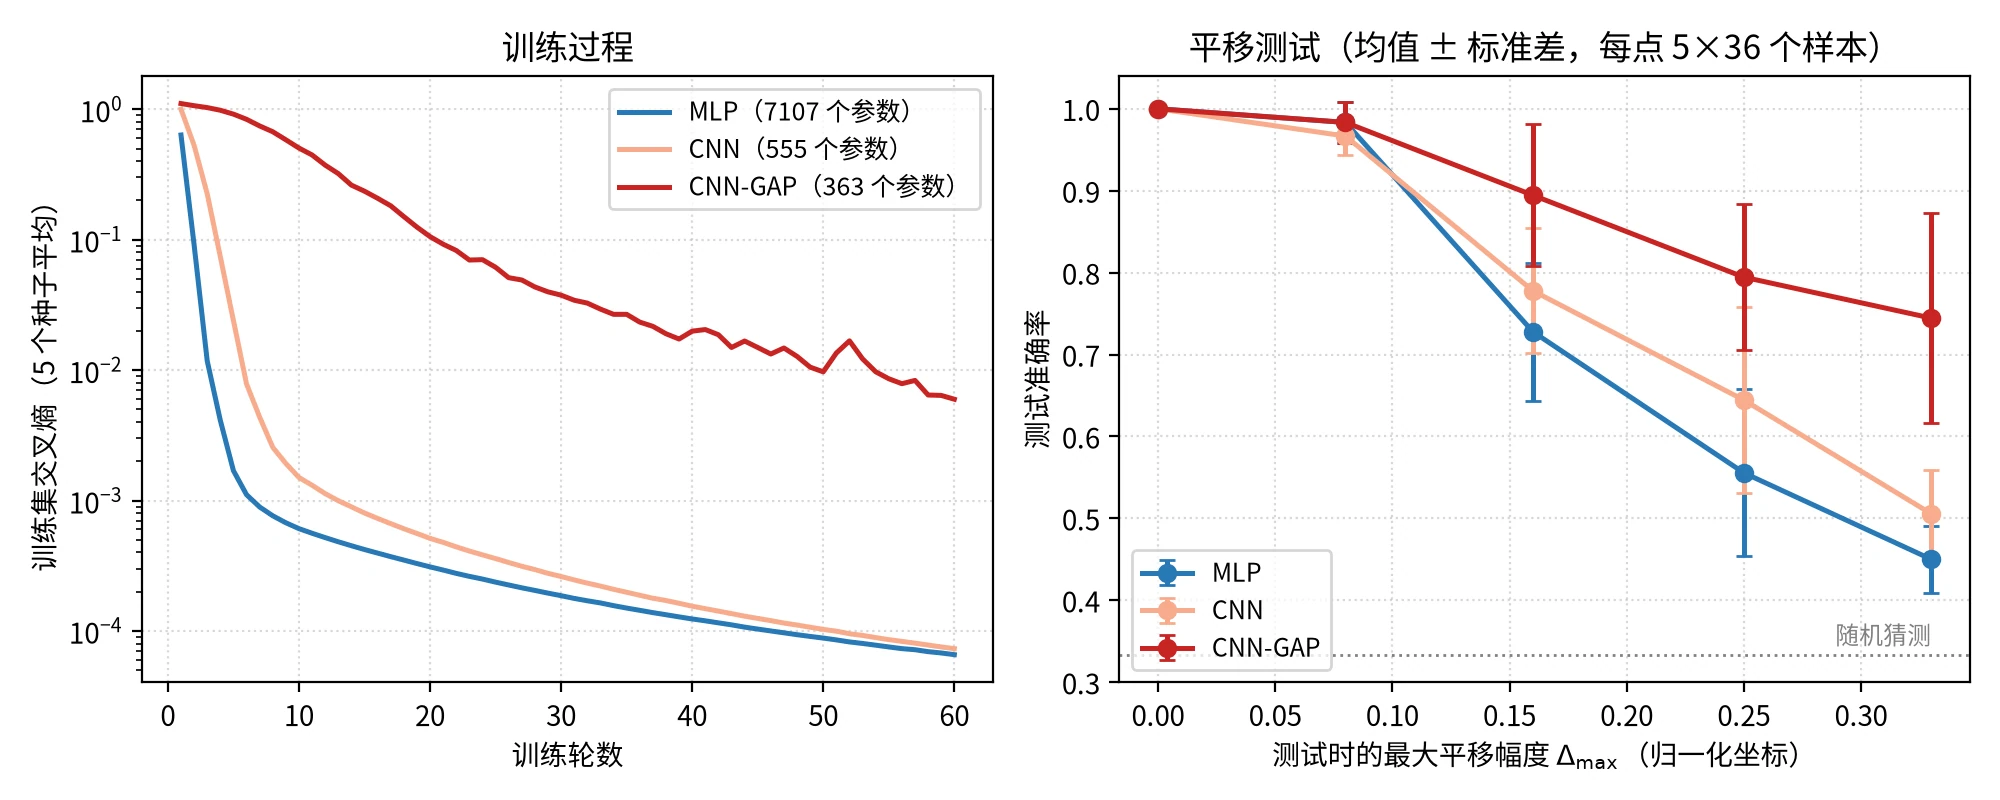
讨论。 先比较未平移的结果,再沿表格向右看平移逐渐增大时的变化。
第一,没有整体平移时,三个模型在本次测试中都把样本分对了。随着平移增大,它们的准确率都下降。因此,在这里包含连续位移和视场裁剪的测试条件下,没有一个模型能始终保持原来的分类表现。
第二,普通 CNN 的改善有限。在 和 0.33 时,它的平均准确率比 MLP 高约 0.06–0.09,但这个差距与种子之间的标准差(0.05–0.11)相当,个别种子上还不如 MLP。
这与前面的分析一致:本例经过两次 池化后,每张特征图只剩 ;展平后的全连接层又对不同位置使用独立权重。因此,局部响应换了位置,最后的判断就可能变化。555 个参数比 7107 个少得多,但参数少本身并不保证预测对平移不敏感。
第三,本例中的 CNN-GAP 对平移更不敏感。它只有 363 个参数,在 时平均准确率为 0.744,比普通 CNN 高约 0.24。全局平均把各位置的响应合到一起;在特征响应仅发生平移、没有丢失或改变的条件下,这个平均值不变。实际测试中还有斑点移出视场、补零和下采样的影响,准确率因此不能被保证保持不变。
CNN-GAP 的训练损失在三者中最高,平移测试却更好。这提示我们,训练集上拟合得更充分,不一定意味着换一种输入条件后仍然预测得更好。本例也同时减少了一次局部池化,因此若要单独判断全局平均池化的作用,还需要控制其他结构差别。
这个实验还有局限:每档测试样本只有 36 个,平移后的输入本身也丢失了部分信息(移出视场的斑点);更严格的比较还可以对同一批样本施加成对的平移,或者在训练时加入平移数据增强。
4.9.1.2 实验二:用分子结构图像预测水溶性
上一个实验只检查图样移动后的分类表现。现在换成真实化学问题:用分子的二维结构图像预测水溶性。我们尤其关心,图像里保留哪些信息,会怎样影响结果;把分子画成图交给 CNN,是否比几个常用描述符组成的模型更好?
数据集。 Delaney 数据集(又称 ESOL)收录了 1128 个有机小分子的实测水溶性 [26]。预测目标是 ,记为 logS,是无量纲数。数据通过 DeepChem 的 MoleculeNet 接口加载 [27]。
划分数据时,我们希望测试模型面对新骨架的分子时表现如何。因此,按 Bemis–Murcko 分子骨架 [28] 分组,使测试集中的骨架不出现在训练集中,再按 8:1:1 分为训练、验证和测试集。这种做法称为骨架划分(scaffold split)。它检验的是对未见过骨架的预测能力;如果研究目标正是筛选新结构,这种评估比只做随机划分更贴近问题。
图像表示。 DeepChem 的 SmilesToImage 特征化器(源自 Chemception [29])先由 RDKit 计算分子的二维布局,再把原子和键画到 的网格上(res=0.5,即每个像素对应二维布局中的 0.5 Å)。它提供两种编码 [43]:
std(单通道):原子所在像素的值为原子序数,化学键所在像素的值为常数 2;键级(单键、双键、三键)不加区分;engd(四通道):除原子与键的位置外,还在不同通道中编码原子的部分电荷、显式价态、杂化方式以及键的类型等信息。
这里得到的是二维结构式的数值编码,不是显微照片或真实三维构象。res 只表示布局坐标与像素之间的比例,与实验空间分辨率无关。绘图程序选择的朝向也不应成为水溶性预测的依据,因此训练时对本例的编码图像做随机的 90° 旋转和翻转,作为数据增强,以减少模型对绘图朝向的依赖。
生成图像时,训练集中有 2 个分子未能成图:含 26 个碳原子的直链烷烃超出了 画布;甲烷没有化学键,特征化器处理时报错。最终使用训练集 900 个、验证集 113 个、测试集 113 个分子。报告结果时,也需要交代这些被排除的样本。
对照基线。 得到一个预测误差,还不足以判断 CNN 是否值得使用。先用两个简单模型作为参照,检查图像网络相对它们改善了多少:
- 均值基线:对任何分子都预测训练集的平均 logS。由于骨架划分使测试集的分布与训练集不同,这个基线在测试集上的 为负。
- Delaney 型线性模型:Delaney 在原始论文中提出用四个描述符的线性组合预测 logS [26]:辛醇–水分配系数 logP、分子量 MW、可旋转键数 RB 和芳香原子比例 AP。我们用 RDKit 计算这四个描述符,在训练集上用最小二乘法拟合系数。
CNN 模型。 MolecularCNN 使用三个卷积块。前两块各包含 卷积、批归一化、ReLU 和 最大池化:通道数依次变为 16、32,图像边长从 64 降到 32、16。第三块输出 64 个通道,再对每张特征图取全局平均,得到 64 个数。最后用两个全连接层输出 logS,中间加入 Dropout。
训练与选模。 输入像素值先除以 10,把数值调整到 的量级;标签标准化为均值 0、标准差 1,预测后再换回 logS。训练共 80 轮,学习率从 按余弦曲线逐渐减小。
每轮结束后,只在验证集上计算 RMSE,最后选取验证误差最小的那一轮用于测试。这样,测试集始终不参与训练和模型选择。每种图像编码用 3 个随机种子重复,观察训练随机性带来的变化。
python
#!/usr/bin/env python3
"""
demo_delaney_cnn.py —— 用二维分子结构图像和 CNN 预测水溶性(Delaney / ESOL)

流程
1. 用 DeepChem 加载 Delaney ESOL 数据集(骨架划分),用 SmilesToImage 把分子画成 64×64 图像;
   --img-spec std  :单通道,原子处像素值为原子序数,键处为 2;
   --img-spec engd :四通道,另外编码部分电荷、价态、杂化等原子与键的信息;
2. 建立两个对照基线:训练集均值预测器、Delaney 型线性描述符模型(logP、分子量、可旋转键数、芳香原子比例);
3. 训练一个小型 CNN(旋转/翻转数据增强 + 标签标准化 + 按验证集选择最佳轮次),可重复多个随机种子;
4. 在测试集上报告 RMSE、MAE、R²,保存预测结果并绘制预测-实测对比图。

运行:
    python3 demo_delaney_cnn.py --img-spec std  --seeds 42,0,1
    python3 demo_delaney_cnn.py --img-spec engd --seeds 42,0,1
"""

import argparse
import copy
import os
import sys

import numpy as np

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

try:
    import torch
    import torch.nn as nn
    import torch.optim as optim
    from torch.utils.data import DataLoader, TensorDataset
except ImportError:
    sys.exit("需要安装 PyTorch。")
try:
    import deepchem as dc
    from rdkit import RDLogger
    from rdkit.Chem import Crippen, Descriptors, Lipinski
    RDLogger.DisableLog("rdApp.*")          # 关闭 RDKit 的弃用警告,不影响计算
except ImportError:
    sys.exit("需要安装 DeepChem 与 RDKit。")


# ----------------------------------------------------------------------------
# 1. 网络结构
# ----------------------------------------------------------------------------
class MolecularCNN(nn.Module):
    """三个卷积块 + 全局平均池化 + 两层回归头。"""

    def __init__(self, in_channels=1):
        super().__init__()

        def block(cin, cout, pool=True):
            layers = [nn.Conv2d(cin, cout, 3, padding=1),
                      nn.BatchNorm2d(cout), nn.ReLU(inplace=True)]
            if pool:
                layers.append(nn.MaxPool2d(2))
            return layers

        self.features = nn.Sequential(
            *block(in_channels, 16),        # 64 -> 32
            *block(16, 32),                 # 32 -> 16
            *block(32, 64, pool=False),
            nn.AdaptiveAvgPool2d(1),        # 全局平均池化 -> 64 维
        )
        self.regressor = nn.Sequential(
            nn.Flatten(), nn.Linear(64, 32), nn.ReLU(inplace=True),
            nn.Dropout(0.2), nn.Linear(32, 1),
        )

    def forward(self, x):
        return self.regressor(self.features(x))


# ----------------------------------------------------------------------------
# 2. 数据:分子图像与 Delaney 型描述符
# ----------------------------------------------------------------------------
PIXEL_SCALE = 10.0   # std 编码中原子像素为原子序数(C=6, O=8, Cl=17 …),除以 10 使数值处于 O(1)


def delaney_descriptors(mol):
    """Delaney (2004) 线性模型使用的四个描述符。"""
    heavy = mol.GetNumHeavyAtoms()
    aromatic = sum(1 for a in mol.GetAtoms() if a.GetIsAromatic())
    return [Crippen.MolLogP(mol), Descriptors.MolWt(mol),
            Lipinski.NumRotatableBonds(mol), aromatic / max(heavy, 1)]


def load_delaney(img_spec="std", img_size=64, res=0.5):
    nch = 1 if img_spec == "std" else 4
    feat = dc.feat.SmilesToImage(img_size=img_size, res=res, img_spec=img_spec)
    # transformers=[]:不做标签标准化,y 保持原始 log10(S / mol L^-1)
    tasks, (train, valid, test), _ = dc.molnet.load_delaney(
        featurizer="Raw", splitter="scaffold", transformers=[], reload=False)

    def prepare(ds, name):
        imgs = [feat.featurize([m])[0] for m in ds.X]
        keep = [i for i, x in enumerate(imgs)
                if isinstance(x, np.ndarray) and x.shape == (img_size, img_size, nch)]
        dropped = [ds.ids[i] for i in range(len(ds)) if i not in set(keep)]
        print(f"  {name}: 保留 {len(keep)}/{len(ds)} 个分子;未能成图的 SMILES:{dropped}")
        X = np.stack([imgs[i] for i in keep]).astype(np.float32) / PIXEL_SCALE
        X = np.transpose(X, (0, 3, 1, 2))                     # (N, C, H, W)
        y = ds.y[keep].astype(np.float32).reshape(-1, 1)
        D = np.array([delaney_descriptors(ds.X[i]) for i in keep], dtype=np.float64)
        return X, y, D

    return [prepare(ds, n) for ds, n in ((train, "训练集"), (valid, "验证集"), (test, "测试集"))]


# ----------------------------------------------------------------------------
# 3. 评估指标
# ----------------------------------------------------------------------------
def metrics(y_true, y_pred):
    y_true, y_pred = np.ravel(y_true), np.ravel(y_pred)
    err = y_pred - y_true
    rmse = float(np.sqrt(np.mean(err ** 2)))
    mae = float(np.mean(np.abs(err)))
    r2 = float(1.0 - np.sum(err ** 2) / np.sum((y_true - y_true.mean()) ** 2))
    return rmse, mae, r2


# ----------------------------------------------------------------------------
# 4. CNN 训练:随机旋转/翻转增强 + 按验证集 RMSE 选择最佳轮次
# ----------------------------------------------------------------------------
def augment(x):
    """二维结构图的朝向是绘图程序任意选定的,随机旋转 90° 倍数并翻转不改变分子。"""
    k = int(torch.randint(0, 4, (1,)))
    x = torch.rot90(x, k, dims=(2, 3))
    if torch.rand(1).item() < 0.5:
        x = torch.flip(x, dims=(3,))
    return x


def predict(model, X, mu, sd):
    model.eval()
    with torch.no_grad():
        return model(torch.from_numpy(X)).numpy() * sd + mu


def train_cnn(Xtr, ytr, Xva, yva, epochs=80, lr=3e-3, seed=42):
    """返回按验证集 RMSE 选出的最佳模型。"""
    torch.manual_seed(seed)
    mu, sd = float(ytr.mean()), float(ytr.std())
    loader = DataLoader(TensorDataset(torch.from_numpy(Xtr),
                                      torch.from_numpy((ytr - mu) / sd)),
                        batch_size=32, shuffle=True)
    model = MolecularCNN(in_channels=Xtr.shape[1])
    opt = optim.Adam(model.parameters(), lr=lr, weight_decay=1e-4)
    sched = optim.lr_scheduler.CosineAnnealingLR(opt, T_max=epochs)   # 学习率按余弦曲线逐渐减小
    loss_fn = nn.MSELoss()
    best = (np.inf, None, 0)
    history = []
    for epoch in range(1, epochs + 1):
        model.train()
        total = 0.0
        for bx, by in loader:
            opt.zero_grad()
            loss = loss_fn(model(augment(bx)), by)
            loss.backward()
            opt.step()
            total += loss.item() * len(bx)
        sched.step()
        val_rmse = metrics(yva, predict(model, Xva, mu, sd))[0]
        history.append((total / len(loader.dataset), val_rmse))
        if val_rmse < best[0]:
            best = (val_rmse, copy.deepcopy(model.state_dict()), epoch)
        if epoch % 10 == 0:
            print(f"  epoch {epoch:3d} | 训练 MSE(标准化) {history[-1][0]:.3f} | 验证 RMSE {val_rmse:.3f}")
    model.load_state_dict(best[1])
    print(f"  按验证集选中第 {best[2]} 轮(验证 RMSE = {best[0]:.3f})")
    return model, mu, sd, history, best[2]


# ----------------------------------------------------------------------------
# 5. 绘图
# ----------------------------------------------------------------------------
def plot_parity(results, y_test, out_path):
    fig, axes = plt.subplots(1, len(results), figsize=(4.6 * len(results), 4.4), dpi=200,
                             sharex=True, sharey=True)
    lo, hi = float(y_test.min()) - 0.8, float(y_test.max()) + 0.8
    for ax, (name, pred) in zip(axes, results):
        rmse, mae, r2 = metrics(y_test, pred)
        ax.fill_between([lo, hi], [lo - 1, hi - 1], [lo + 1, hi + 1],
                        color="#9AC9DB", alpha=0.3, label="|error| ≤ 1")
        ax.plot([lo, hi], [lo, hi], "--", color="#C82423", lw=1.4, label="y = x")
        ax.scatter(y_test, pred, s=16, color="#2878B5", alpha=0.8, edgecolors="none")
        ax.set_title(f"{name}\nRMSE={rmse:.2f}, R²={r2:.2f}", fontsize=10)
        ax.set_xlim(lo, hi); ax.set_ylim(lo, hi)
        ax.set_xlabel("measured log10(S / mol L$^{-1}$)")
        ax.grid(ls=":", alpha=0.5)
    axes[0].set_ylabel("predicted log10(S / mol L$^{-1}$)")
    axes[0].legend(loc="upper left", fontsize=8)
    fig.tight_layout()
    fig.savefig(out_path)
    print(f"  图已保存:{out_path}")


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--img-spec", choices=["std", "engd"], default="std")
    ap.add_argument("--seeds", default="42", help="逗号分隔的随机种子,例如 42,0,1")
    args = ap.parse_args()

    torch.set_num_threads(2)
    np.random.seed(42)
    print(f"加载并特征化 Delaney ESOL(骨架划分,图像编码 {args.img_spec})……")
    (Xtr, ytr, Dtr), (Xva, yva, Dva), (Xte, yte, Dte) = load_delaney(args.img_spec)

    # 基线 1:总是预测训练集均值
    base_mean = np.full_like(yte, ytr.mean())
    # 基线 2:Delaney 型线性模型 logS = c0 + c1 logP + c2 MW + c3 RB + c4 AP
    A = np.hstack([np.ones((len(Dtr), 1)), Dtr])
    coef, *_ = np.linalg.lstsq(A, ytr.ravel().astype(np.float64), rcond=None)
    base_lin = (np.hstack([np.ones((len(Dte), 1)), Dte]) @ coef).reshape(-1, 1)
    print("  线性模型系数 [c0, logP, MW, RB, AP] =", np.round(coef, 4))

    seeds = [int(v) for v in args.seeds.split(",")]
    preds = []
    for seed in seeds:
        print(f"训练 CNN(随机种子 {seed})……")
        model, mu, sd, history, best_epoch = train_cnn(Xtr, ytr, Xva, yva, seed=seed)
        preds.append(predict(model, Xte, mu, sd))
        print("  测试集 RMSE={:.3f}  MAE={:.3f}  R²={:.3f}".format(*metrics(yte, preds[-1])))
    if len(seeds) > 1:
        m = np.array([metrics(yte, p) for p in preds])
        print("  {} 个种子:RMSE {:.3f} ± {:.3f},R² {:.3f} ± {:.3f}".format(
            len(seeds), m[:, 0].mean(), m[:, 0].std(ddof=1), m[:, 2].mean(), m[:, 2].std(ddof=1)))
    pred_cnn = np.mean(preds, axis=0)          # 多个种子的预测取平均(集成)

    print("\n测试集结果(单位:log10(S / mol L^-1))")
    rows = [("均值基线", base_mean), ("Delaney 型线性模型", base_lin),
            (f"CNN({args.img_spec},{len(seeds)} 个种子平均)", pred_cnn)]
    for name, pred in rows:
        rmse, mae, r2 = metrics(yte, pred)
        print(f"  {name:<14} RMSE={rmse:.3f}  MAE={mae:.3f}  R²={r2:.3f}")

    out_dir = os.path.join(os.path.dirname(os.path.abspath(__file__)), "outputs")
    os.makedirs(out_dir, exist_ok=True)
    np.savez(os.path.join(out_dir, f"esol_predictions_{args.img_spec}.npz"), y_test=yte,
             mean=base_mean, linear=base_lin, cnn=pred_cnn, cnn_each=np.array(preds))
    plot_parity([("Mean baseline", base_mean), ("Delaney-type linear model", base_lin),
                 (f"CNN ({args.img_spec})", pred_cnn)], yte,
                os.path.join(out_dir, f"esol_parity_{args.img_spec}.png"))


if __name__ == "__main__":
main()结果。 分别运行 python3 demo_delaney_cnn.py --img-spec std --seeds 42,0,1 和 --img-spec engd,测试集上的结果见表6 和图 25。
表6 ESOL 测试集(骨架划分,113 个分子)上的预测误差。 RMSE 和 MAE 的单位为 。CNN 一栏为 3 个随机种子的均值 ± 标准差,括号内为 3 个模型预测取平均(集成)后的结果。
| 模型 | RMSE | MAE | |
|---|---|---|---|
| 均值基线 | 2.32 | 1.78 | −0.19 |
| Delaney 型线性模型(4 个描述符) | 1.21 | 0.95 | 0.67 |
CNN,std 单通道图像 | 1.77 ± 0.01(1.74) | 1.32 ± 0.03(1.30) | 0.31 ± 0.01(0.33) |
CNN,engd 四通道图像 | 0.99 ± 0.02(0.96) | 0.80 ± 0.02(0.78) | 0.78 ± 0.01(0.80) |
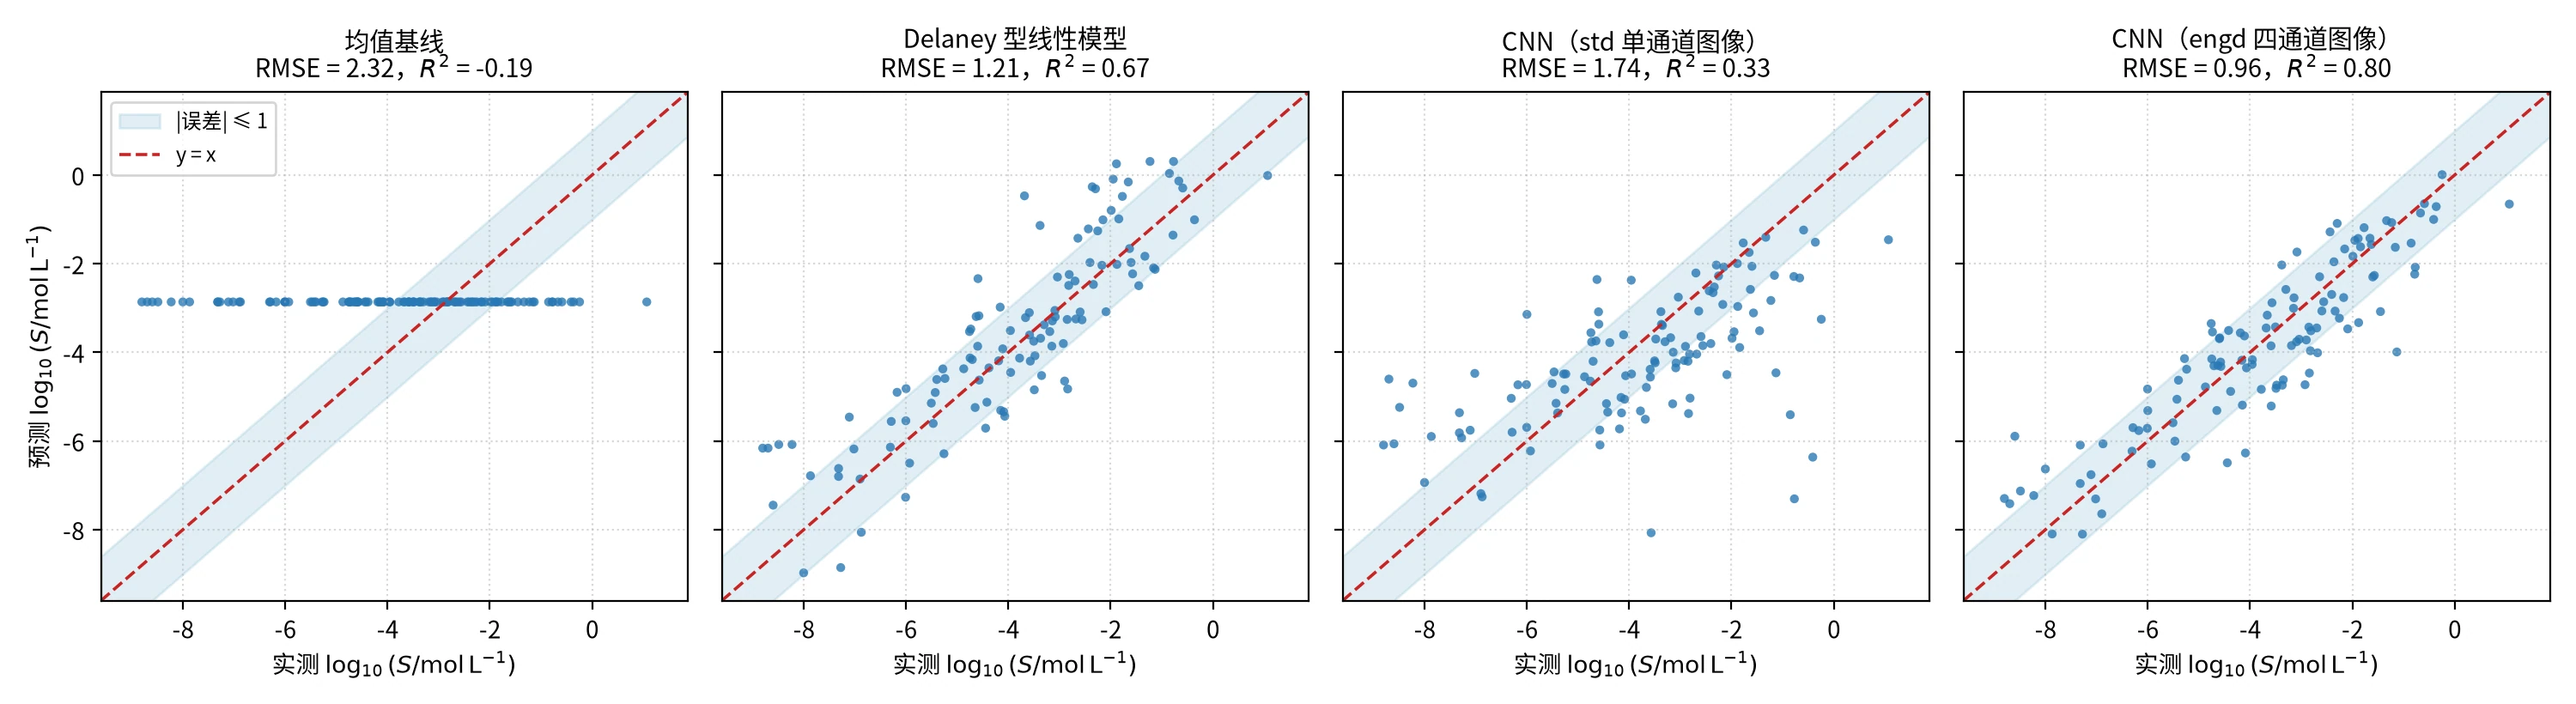
std 单通道图像的 CNN;使用 engd 四通道图像的 CNN(后两者均为 3 个种子的集成预测)。讨论。 先比较两种图像编码,再把它们与线性模型放在一起看:
- 输入表示显著影响了本例的结果。 保持相同的主体网络设计,把输入从单通道换成四通道,测试 RMSE 从 1.77 降到 0.99, 从 0.31 升到 0.78。单通道图像用 6、7、8 等原子序数区分碳、氮、氧,没有区分键级;四通道图像则直接提供部分电荷、杂化等信息。前者需要网络从较少的输入信息中学习与极性、氢键能力等相关的关系。这个比较说明,评价模型前必须先交代它实际得到了哪些信息。
- 一定要和简单基线比较。 只用 4 个描述符的线性模型(RMSE 1.21)明显优于单通道图像 CNN,四通道 CNN 也只比它好约 0.2 个对数单位。logP 本身就是一个高度凝练的溶解度相关描述符,这提醒我们:在小数据集上,有物理意义的描述符往往是很强的基线,“用了深度学习”本身不能说明任何问题。
- 验证集帮助选择训练轮次。
engd编码下,个别轮次的验证 RMSE 甚至超过 10。批归一化在这种大部分像素为零的图像上可能出现统计量不稳定,这是一个需要进一步检查的解释,不能仅凭误差曲线确认原因。这里按验证误差选取模型,避免直接采用最后一轮;测试集不参与这个选择。 - 结果的适用范围。 113 个测试分子的样本量不大,3 个种子的标准差只反映了训练随机性,没有反映数据划分的不确定性。CNN 学到的图像特征是否对应具体的官能团或溶解机理,需要另外的分析才能判断。
一个反面教训 如果采用更朴素的训练设置——原始像素值、不做数据增强、不标准化标签、以 的学习率固定训练 25 轮并直接使用最后一轮的模型——同样结构的单通道 CNN 在同一测试集上的 RMSE 高达 2.70,,比均值基线还差。模型结构相同,结论却截然相反。报告深度学习结果时,必须完整说明这些训练细节,并给出基线对照。
4.9.2 光谱:一维卷积与局部峰形
谱图数据的特点
回到本章最初的光谱例子。这里仍然是在规则数组上滑动窗口,不过窗口位置对应的是谱轴坐标。红外光谱的横轴是波数,NMR 是化学位移,XRD 是衍射角;信号分别来自吸收、共振和衍射,物理解释不能混用。
对网络而言,峰位、峰宽、峰强以及相邻峰的组合都可能有用。卷积先计算各处的局部响应,后面的层再把这些响应用于预测。展平后接全连接层,可以让不同位置使用不同的权重;全局池化则会弱化位置的影响。因此,前面在图像平移实验中有帮助的处理,不能直接照搬到谱图上:红外谱中的绝对峰位本身具有化学含义,通常希望把它保留下来。
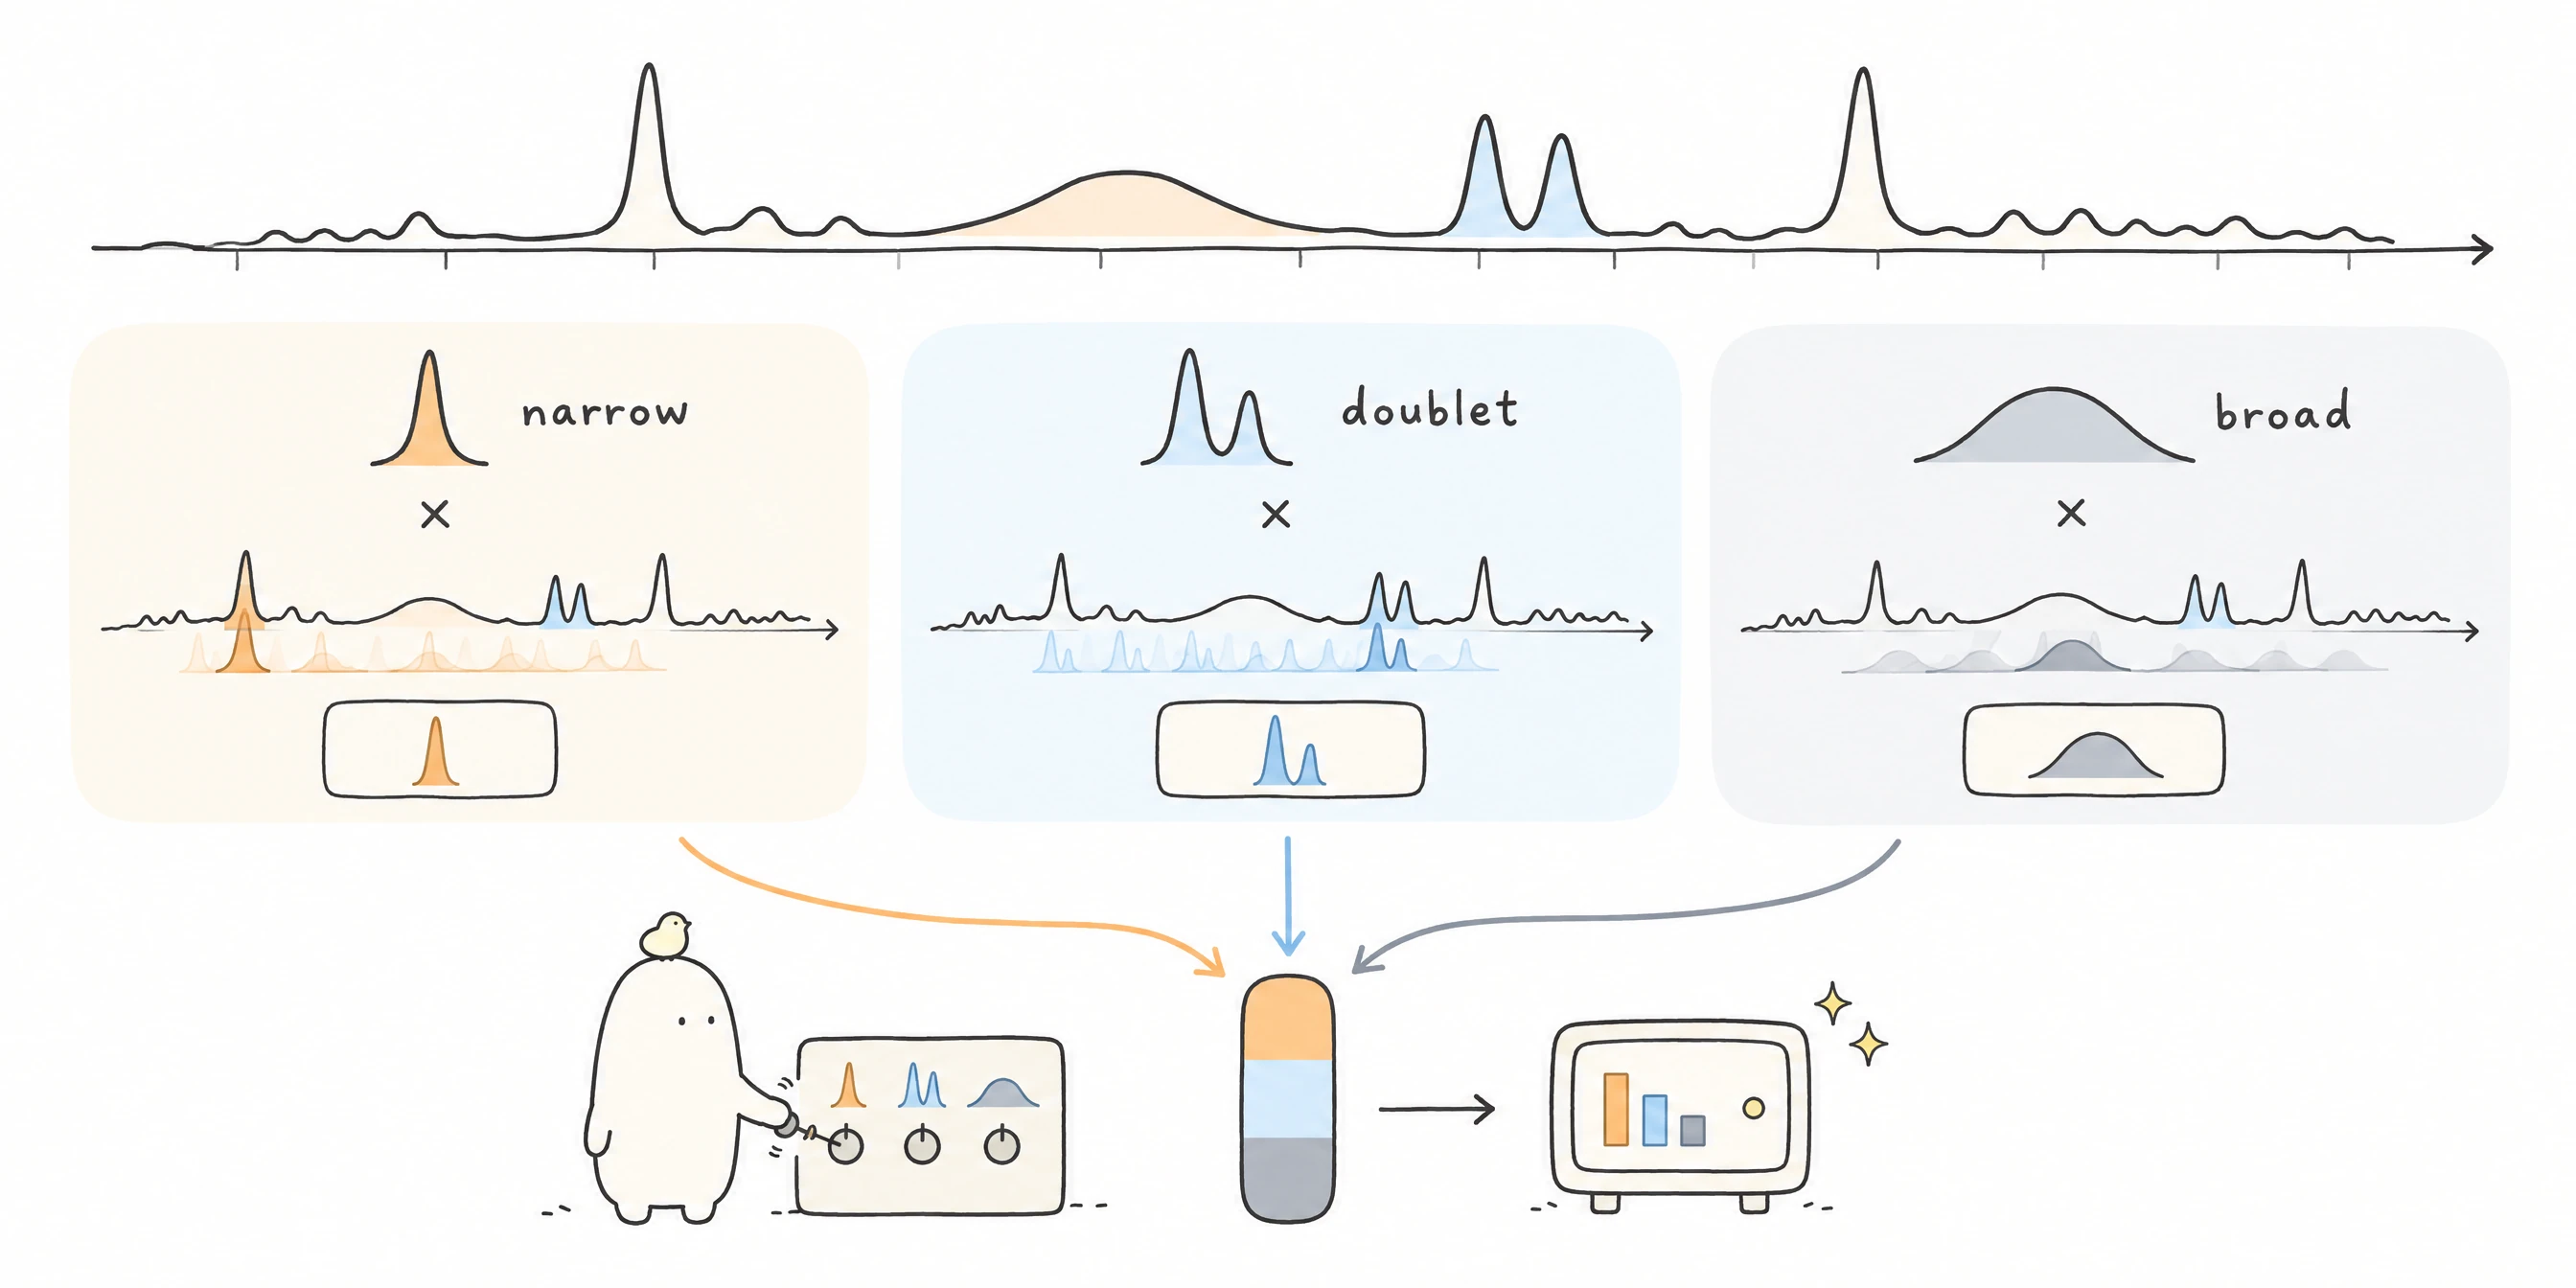
4.9.2.1 实验三:合成红外光谱的分类与打乱对照
实验问题。 前面一直把相邻采样点组成的峰形作为卷积可以利用的信息。现在保留每条谱线中的全部强度值,打乱它们的排列顺序,再重新训练网络,比较分类结果。这个操作同时改变局部峰形和强度与波数的对应关系,后面解释结果时需要把两者一起考虑。
数据。 chemdata.make_ir_spectra 按三类化合物的代表性红外特征生成合成曲线(图 27):
- 烷烃:2925、2855 cm⁻¹ 的 C–H 伸缩峰,1465、1375 cm⁻¹ 的 C–H 弯曲峰;
- 羰基化合物:1715 cm⁻¹ 尖锐的强 C=O 伸缩峰,以及 C–H、C–O 峰;
- 醇:约 3350 cm⁻¹ 由氢键展宽的强 O–H 宽峰,以及 1050 cm⁻¹ 附近的 C–O 伸缩峰。
每条曲线在 4000–620 cm⁻¹ 范围内等间隔取 64 个点,相邻采样点相距 cm⁻¹。每个峰是一个向下的高斯函数,峰位随机抖动 ±6 cm⁻¹,强度随机缩放 0.85–1.15 倍,再加入高斯噪声,最后归一化到 。训练集每类 18 条,测试集每类 12 条,由不同的随机种子生成。
这里有一个与谱学密切相关的细节。代码中的峰宽参数是高斯函数的标准差 ,而谱学中常用半高全宽(FWHM)描述峰宽,二者的关系为 。例如 cm⁻¹ 对应 FWHM 约 130 cm⁻¹,在 64 点的采样下约占 2–3 个点;而 1375 cm⁻¹ 处的峰 cm⁻¹,FWHM 约 52 cm⁻¹,比采样间隔还窄,峰顶很可能落在两个采样点之间,在曲线上只表现为一两个点的凹陷(图 27 中 1715 cm⁻¹ 的 C=O 峰也是如此)。真实的红外谱通常以 1–4 cm⁻¹ 的间隔采样,这里的粗采样只是为了让纯 Python 代码能在几秒内运行完。
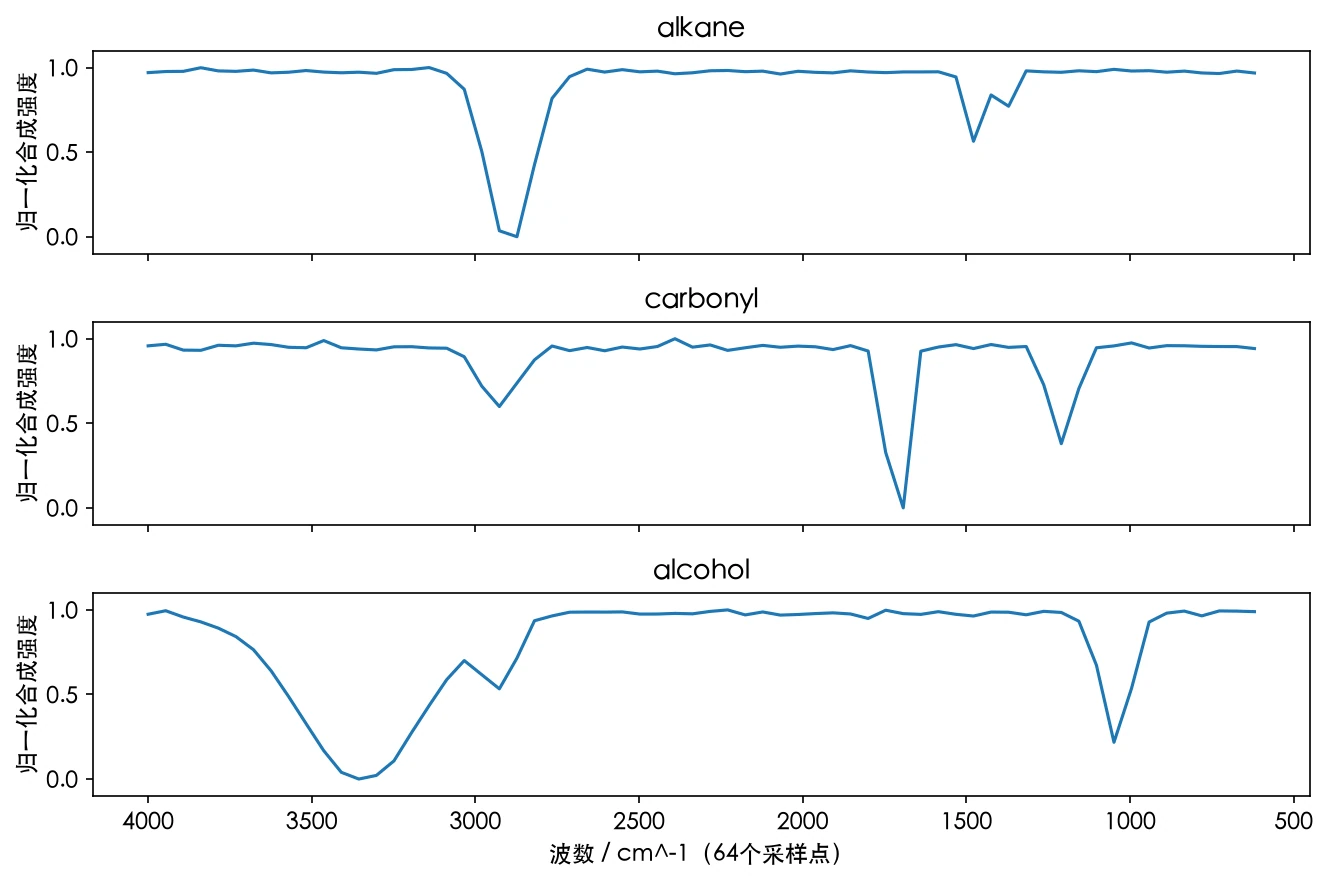
模型。 为了复用本章的二维卷积代码,把一条 64 点谱线存成 :一个通道、一行、64 列。窗口的高度也取 1,就只会沿谱线方向计算,相当于一维卷积。第一层窗口覆盖 7 个相邻采样点,约 320 cm⁻¹ 的范围。
完整顺序是:Conv2D(1→6, 核 1×7, 补零 (0,3)) → ReLU → MaxPool2D(1×2) → Conv2D(6→10, 核 1×5, 补零 (0,2)) → ReLU → MaxPool2D(1×2) → Flatten → Dense(160→3)。其中三个带参数层分别有 、、 个参数,共 841 个。训练使用 Adam,学习率为 0.01,共 45 轮。
对照实验:打乱波数顺序。 对每条谱线,把 64 个强度值按随机排列重新排序,再用相同设置从头训练另一个模型。每条谱线采用不同的排列,因此原来相邻的点被分开,不同样本的同一下标也不再对应同一个波数。所有强度值仍然存在,但它们原有的排列信息已经被破坏。这个对照不能单独区分峰形和绝对峰位各自的作用。
python
# demo_spectra.py —— 一维卷积分类合成红外光谱,以及打乱波数顺序的对照实验
"""1D 卷积在谱线建模中的用法:区分三种合成峰模板。

任务
----
合成红外光谱(64 个波数点,4000 -> 620 cm^-1)分成三类:
    0 = 烷烃(只有 C-H 伸缩/弯曲)
    1 = 羰基化合物(C=O ~1715 cm^-1 尖锐强峰)
    2 = 醇(O-H ~3350 cm^-1 宽峰 + C-O ~1050 cm^-1)

网络
----
把光谱看成高度为 1 的"图像",于是二维卷积自动退化成一维卷积:

    Conv2D(1 -> 6,  kernel=(1,7), pad=(0,3))   # 7 个波数点的局部窗口
    ReLU, MaxPool2D((1,2))
    Conv2D(6 -> 10, kernel=(1,5), pad=(0,2))
    ReLU, MaxPool2D((1,2))
    Flatten, Dense(160 -> 3)

每个第一层卷积核有7个权重,并在所有位置共享。
权重可用于查看局部响应,但不自动对应特定官能团或绝对波数。

运行:
    python3 demo_spectra.py
    python3 demo_spectra.py --out results_spectra.json
"""

import argparse
import json
import os
import random
import time

# 运行前请把 cnn.py、chemdata.py 与本脚本放在同一目录。
import cnn
from cnn import Conv2D, Dense, Flatten, MaxPool2D, ReLU, Sequential
from chemdata import IR_NAMES, WN_AXIS, make_ir_spectra


def build_cnn(seed=1):
    return Sequential(
        Conv2D(1, 6, (1, 7), stride=1, pad=(0, 3), rng=random.Random(seed)),
        ReLU(),
        MaxPool2D((1, 2)),                       # 64 -> 32
        Conv2D(6, 10, (1, 5), stride=1, pad=(0, 2), rng=random.Random(seed + 1)),
        ReLU(),
        MaxPool2D((1, 2)),                       # 32 -> 16
        Flatten(),                               # 10 * 16 = 160
        Dense(160, 3, rng=random.Random(seed + 2)),
    )


def peak_position_of(kernel_row):
    """返回核权重绝对值的相对位置重心;单位为采样点,不是波数。"""
    weights = kernel_row[0]              # (1, 7) -> 7 个权重
    k = len(weights)
    # 核窗口的中心索引
    center = k // 2
    # 相对于窗口中心的索引重心;不识别绝对化学波段
    total = sum(abs(w) for w in weights) or 1e-9
    offset = sum((idx - center) * abs(w) for idx, w in enumerate(weights)) / total
    return offset, weights


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--out", default=None)
    ap.add_argument("--epochs", type=int, default=45)
    ap.add_argument("--decoy", action="store_true",
                    help="把波数轴随机打乱,做对照实验")
    args = ap.parse_args()

    train = make_ir_spectra(n_per_class=18, seed=1)
    test = make_ir_spectra(n_per_class=12, seed=2)

    if args.decoy:
        # 对照实验:对**每条光谱**独立地随机打乱波数轴。
        # 保留数值集合,但破坏峰位、连通峰形、峰宽及峰的个数。
        # 这里重新训练另一个模型,不能据此排除原模型使用绝对峰位。
        rng = random.Random(7)

        def destroy_local_structure(dataset):
            out = []
            for X, y in dataset:
                row = X[0][0]
                perm = list(range(len(row)))
                rng.shuffle(perm)
                out.append(([[[row[p] for p in perm]]], y))
            return out

        train = destroy_local_structure(train)
        test = destroy_local_structure(test)
        print("对照实验:每条光谱的波数轴被独立随机打乱(局部结构已破坏)。")

    print(f"训练 {len(train)} 条 | 测试 {len(test)} 条 | 每条 {len(WN_AXIS)} 个波数点")
    print(f"波数范围 {WN_AXIS[0]:.0f} -> {WN_AXIS[-1]:.0f} cm^-1,类别 {IR_NAMES}")

    model = build_cnn()
    print(f"参数量:{model.num_params()}")
    opt = cnn.Adam(model.params(), lr=0.01)
    t0 = time.time()
    history = cnn.train(model, opt, train, epochs=args.epochs, batch_size=8,
                        rng=random.Random(0), log_every=max(args.epochs // 5, 1))
    dt = time.time() - t0

    acc_train = cnn.accuracy(model, train)
    acc_test = cnn.accuracy(model, test)
    cm = cnn.confusion_matrix(model, test, 3)

    print(f"\n训练用时 {dt:.1f}s")
    print(f"训练集准确率 {acc_train:.4f}")
    print(f"测试集准确率 {acc_test:.4f}")
    print("混淆矩阵(行 = 真实,列 = 预测)")
    print("            " + "".join(f"{n:>10}" for n in IR_NAMES))
    for i, name in enumerate(IR_NAMES):
        print(f"  {name:<10}" + "".join(f"{v:>10}" for v in cm[i]))

    # 第一层学到的"关注波段"
    conv1 = model.layers[0]
    print("\n第一层卷积核(6 个 7 点滤波器)学到的权重:")
    for f in range(conv1.cout):
        w = conv1.W[f][0][0]
        s = " ".join(f"{v:+.2f}" for v in w)
        print(f"  filter {f}: {s}")
    print("  正权重 = 该局部位置的强度会激活;负权重 = 该位置的强度会抑制。")

    if args.out:
        payload = {
            "experiment": "spectra",
            "decoy": args.decoy,
            "params": model.num_params(),
            "seconds": round(dt, 1),
            "loss_history": [round(v, 5) for v in history],
            "acc_train": round(acc_train, 4),
            "acc_test": round(acc_test, 4),
            "confusion": cm,
            "names": IR_NAMES,
            "wn_axis": [round(v, 1) for v in WN_AXIS],
            "filters": [[round(v, 4) for v in conv1.W[f][0][0]]
                        for f in range(conv1.cout)],
        }
        with open(args.out, "w", encoding="utf-8") as f:
            json.dump(payload, f, ensure_ascii=False, indent=2)
        print(f"\n结果已写入 {os.path.abspath(args.out)}")


if __name__ == "__main__":
main()结果。 分别运行 python3 demo_spectra.py 和 python3 demo_spectra.py --decoy,结果见表7 和图 28。
表7 合成红外光谱分类结果(训练 54 条,测试 36 条)
| 输入 | 参数量 | 第 45 轮训练损失 | 训练准确率 | 测试准确率 |
|---|---|---|---|---|
| 原始波数顺序 | 841 | 1.000 | 1.000(36/36) | |
| 每条谱线独立打乱 | 841 | 1.000 | 0.556(20/36) |
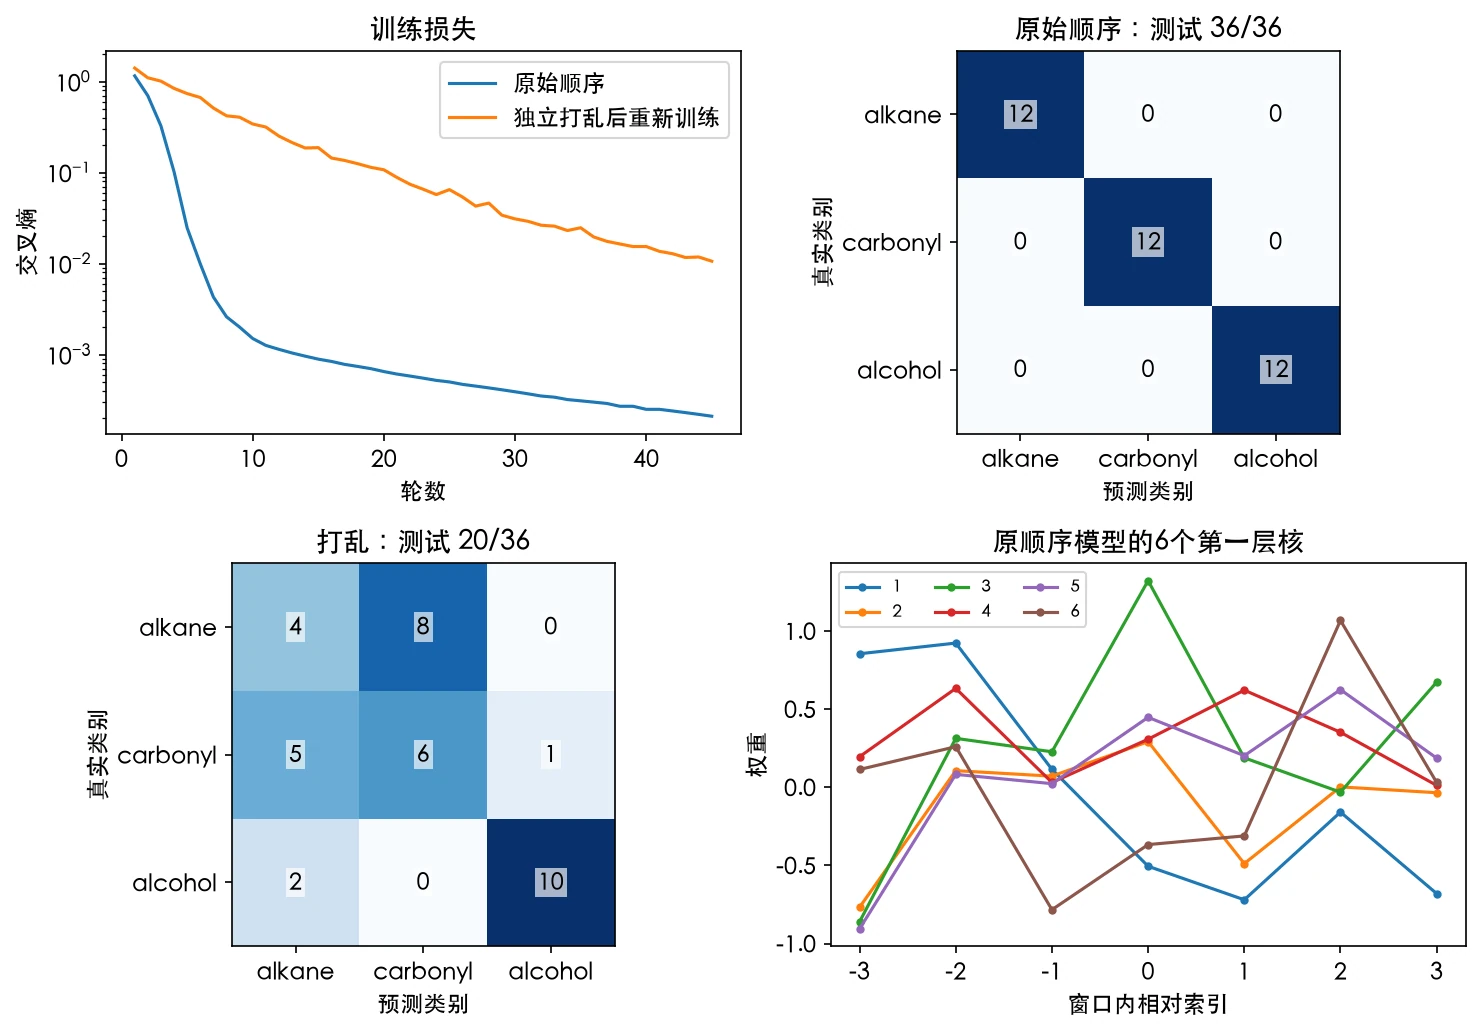
讨论。 保持原始顺序时,36 条测试谱线全部分对;每条谱线独立打乱后,重新训练的网络分对了 20 条,准确率为 0.556,随机猜测的参照水平为 0.333。两个模型在训练集上的准确率都是 1,但测试表现不同。这支持了一个范围明确的结论:在本组数据和训练设置下,保留原始排列的信息有助于预测新的样本。由于峰形和波数对应关系同时被破坏,不能把差别只归因于其中一项。
打乱后仍高于随机猜测,可能与强度分布中保留下来的类别线索有关。例如,合成醇类曲线中的宽 O–H 峰带来较多低强度值,打乱顺序后这些数值仍然存在,醇类也仍有较多样本被分对。不过,要确认模型是否利用了这一线索,还需要进一步对照。
解读这个对照实验时要注意两点。第一,打乱后的结果来自一个重新训练的模型,它说明的是“这种输入表示含有多少可利用的信息”,而不是原始模型究竟依赖了哪些特征;若要分析原始模型,可以对固定的模型做扰动测试,例如只平移某一个峰,观察预测如何变化。第二,第一层卷积核的权重(图 28 右下)横轴是窗口内的相对位置,而不是绝对波数——同一个卷积核在整个谱线上滑动使用,因此不能把某个卷积核直接命名为“羰基探针”或“羟基探针”。
扫描合成吸收谱,观察手工峰形核对峰位与峰宽的响应。
吸光度当前采样
响应当前输出
位置 4000 cm⁻¹,响应 0.16;采样间隔 30 cm⁻¹。
思考与说明
思考仅平移主峰时,响应峰是否也随之移动?
合成高斯峰;固定核 [−1,−1,0,4,0,−1,−1],不是官能团分类模型。两端补零。
4.9.3 显微图像:合成纹理分类
显微图像的特点
谱线的相邻关系沿一个方向展开,图像则需要同时考虑横向和纵向。对材料研究来说,我们希望从这些局部变化中描述颗粒、边界、条纹或缺陷。
解释图像时还要知道亮暗来自什么。SEM 的衬度主要与二次电子或背散射电子的产额有关;TEM 中有质厚、衍射和相位衬度;STM 反映局域电子态密度。不同显微方法的图像不能统一理解为三维结构的简单二维投影。CNN 可以辅助分类、分割和缺陷检测,但把某块区域认定为特定物相,通常还需要衍射、能谱等独立证据。
4.9.3.1 实验四:三类合成纹理的分类
实验问题。 先把真实显微成像中的复杂因素放开,只检查网络能否区分三种局部结构不同的图样:环状、条纹和随机纹理。这样可以观察二维卷积怎样用于分类,又不会把合成图样的标签误当作真实物相。
数据。 chemdata.make_micrograph_dataset 生成三类 的程序化纹理(图 29):
- 环状纹理:随机放置 4 个中心点,每个像素的亮度由它到最近中心点的距离按周期函数确定,形成同心环(在 的小图上表现为若干段弧);
- 条纹纹理:方向和周期(3–5 个像素)都随机的余弦条纹,类似层片状组织;
- 随机纹理:每个像素的亮度独立随机,没有空间结构。
三类图像都加入了少量高斯噪声。训练集每类 16 张,测试集每类 10 张,用不同的随机种子生成。它们只是用来演示局部图像特征的计算示例,并不对应真实的大晶粒组织、珠光体或非晶相。
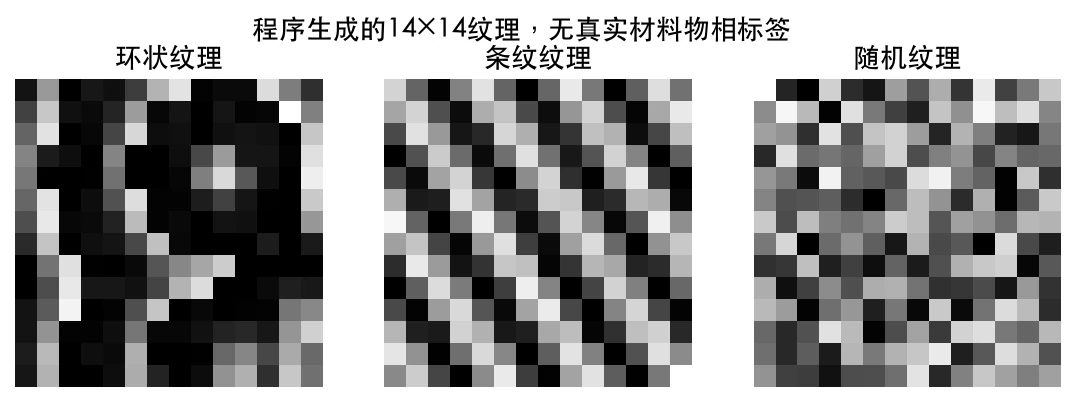
模型。 使用两个卷积块,通道数依次从 、,都采用 核和补零 1。每次卷积后接 ReLU,再做 最大池化,图像边长按 14 → 7 → 3 变化。第二次池化遇到奇数尺寸,向下取整,最后一行和一列被舍弃。
最后留下 10 张 特征图,展平成 90 个数,接 Dense(90→3) 输出三类得分。三个带参数层共有 个参数。使用 Adam,学习率 0.008,训练 40 轮。这个教学实验只设训练集和测试集,学习率与轮数事先确定,没有根据测试集调整。
python
# demo_materials.py —— 合成二维纹理分类
"""用CNN区分14×14程序纹理:环状、条纹、随机。

这是同生成分布下的教学分类任务,不对应真实物相识别。
运行:python3 demo_materials.py
"""

import argparse
import json
import os
import random
import time

# 运行前请把 cnn.py、chemdata.py 与本脚本放在同一目录。
import cnn
from cnn import Conv2D, Dense, Flatten, MaxPool2D, ReLU, Sequential
from chemdata import make_micrograph_dataset


PHASE_NAMES = ["rings", "lamellar", "random"]


def build_cnn(seed=1):
    return Sequential(
        Conv2D(1, 6, 3, stride=1, pad=1, rng=random.Random(seed)),
        ReLU(),
        MaxPool2D(2),                       # 14 -> 7
        Conv2D(6, 10, 3, stride=1, pad=1, rng=random.Random(seed + 1)),
        ReLU(),
        MaxPool2D(2),                       # 7 -> 3
        Flatten(),                          # 10 * 3 * 3 = 90
        Dense(90, 3, rng=random.Random(seed + 2)),
    )


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--out", default=None)
    ap.add_argument("--epochs", type=int, default=40)
    args = ap.parse_args()

    train = make_micrograph_dataset(n_per_class=16, seed=1)
    test = make_micrograph_dataset(n_per_class=10, seed=2)
    print(f"训练 {len(train)} 条 | 测试 {len(test)} 条 | 图像 14x14")

    model = build_cnn()
    print(f"参数量:{model.num_params()}(作为参照:把 196 个像素直接连到 3 个类别的"
          f"单层线性分类器有 {196 * 3 + 3} 个参数,但它没有隐藏层,也不利用邻域结构)")
    opt = cnn.Adam(model.params(), lr=0.008)
    t0 = time.time()
    history = cnn.train(model, opt, train, epochs=args.epochs, batch_size=8,
                        rng=random.Random(0), log_every=max(args.epochs // 4, 1))
    dt = time.time() - t0

    acc_train = cnn.accuracy(model, train)
    acc_test = cnn.accuracy(model, test)
    cm = cnn.confusion_matrix(model, test, 3)
    print(f"\n训练用时 {dt:.1f}s | 训练准确率 {acc_train:.4f} | "
          f"测试准确率 {acc_test:.4f}")
    print("混淆矩阵(行 = 真实,列 = 预测)")
    print("                  " + "".join(f"{n[:8]:>11}" for n in PHASE_NAMES))
    for i, name in enumerate(PHASE_NAMES):
        print(f"  {name:<14}" + "".join(f"{v:>11}" for v in cm[i]))

    # 第一层卷积核可视化(数值形式)
    conv1 = model.layers[0]
    print("\n第一层 6 个 3x3 卷积核(每组三行):")
    for f in range(conv1.cout):
        print(f"  filter {f}:")
        for row in conv1.W[f][0]:
            print("    " + " ".join(f"{v:+.2f}" for v in row))

    if args.out:
        payload = {
            "experiment": "materials",
            "params": model.num_params(),
            "seconds": round(dt, 1),
            "loss_history": [round(v, 5) for v in history],
            "acc_train": round(acc_train, 4),
            "acc_test": round(acc_test, 4),
            "confusion": cm,
            "names": PHASE_NAMES,
            "filters": [[row[:] for row in conv1.W[f][0]] for f in range(conv1.cout)],
        }
        with open(args.out, "w", encoding="utf-8") as f:
            json.dump(payload, f, ensure_ascii=False, indent=2)
        print(f"\n结果已写入 {os.path.abspath(args.out)}")


if __name__ == "__main__":
main()结果与讨论。 运行 python3 demo_materials.py,训练 40 轮后训练损失降到约 ,训练集和测试集的准确率都是 1.000(测试 30/30),结果如图 30 所示。
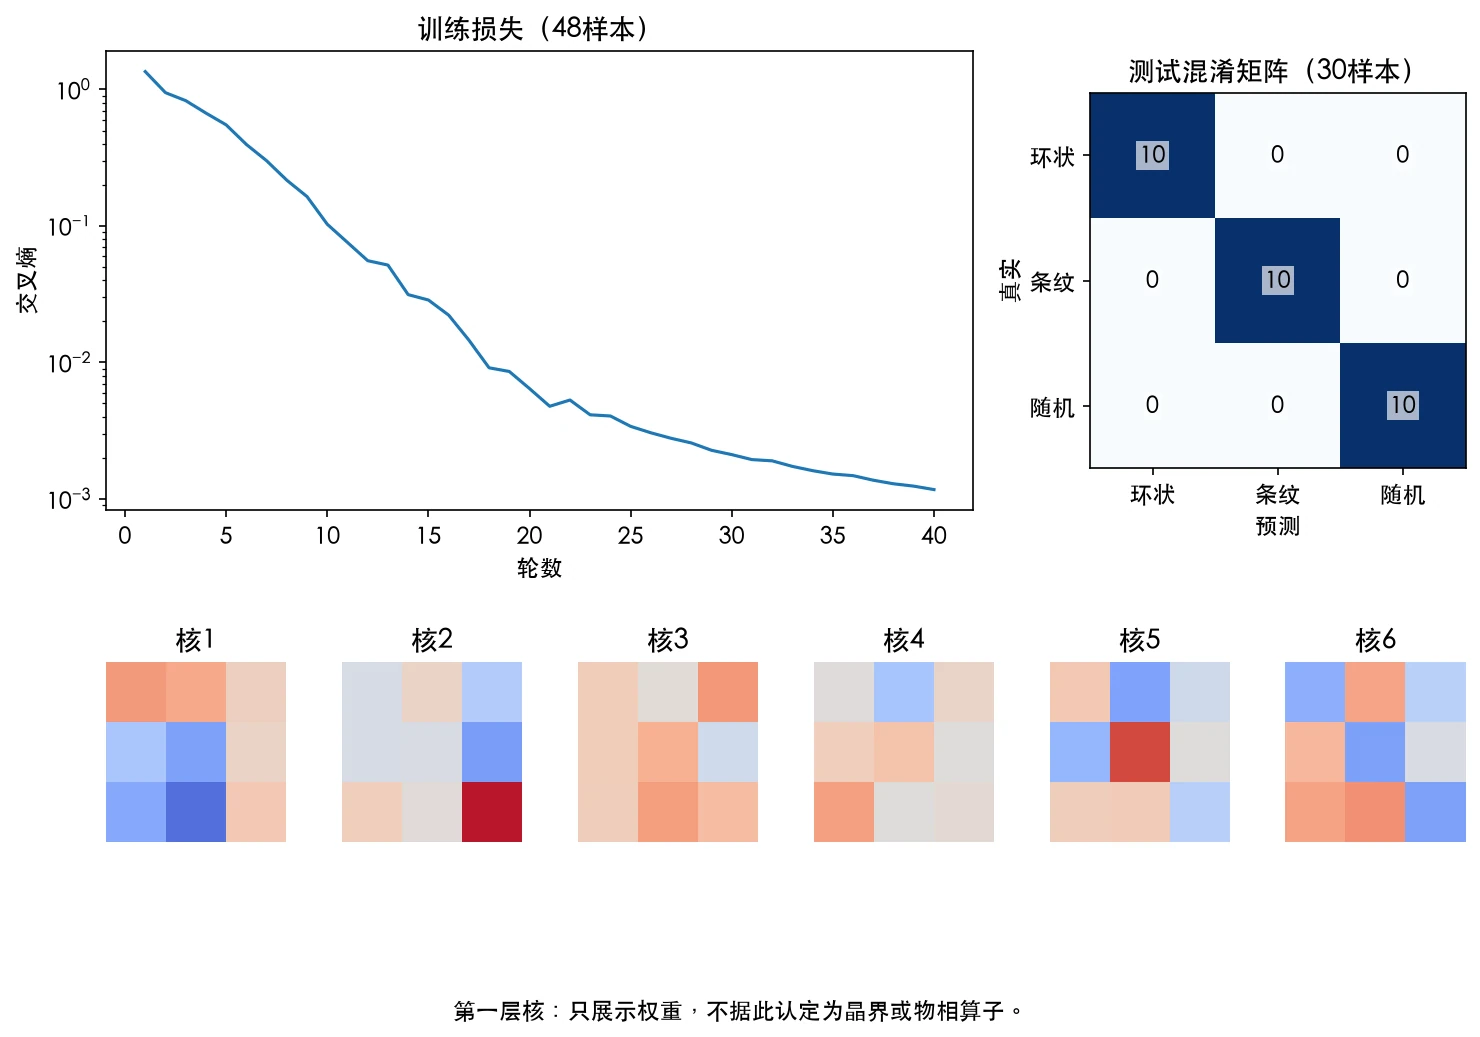
这三类纹理的局部统计差别较大,本次测试的 30 张图像全部分对,说明这个小网络能够区分同一生成规则下的新样本。但实验还没有涉及新的材料样品、实验批次或仪器。将方法用于真实的组织分割、粒径统计或缺陷追踪时,还需要检查图像分辨率、标注质量、仪器差异和测试数据的覆盖范围。合成图样上的结果提供了计算练习,真实应用的可靠性要另外验证。
4.9.4 延伸:机器学习势函数中的“局部环境”
前面的例子都在规则网格上使用同一组局部权重。离开网格后,“对不同局部环境复用参数”的思路仍然有用。分子模拟中的许多机器学习势函数(machine learning interatomic potentials, MLIP)就把体系总能量写成各原子能量之和 [32]:
其中每个原子的能量 由同一个(或同一元素共享的)神经网络根据该原子截断半径内的局部环境计算。这与卷积层用同一个核处理每个窗口如出一辙:共享参数使模型可以推广到不同大小的体系,局部性使计算量随原子数线性增长。Behler–Parrinello 网络 [32]、ANI [33]、DeePMD [35] 及其改进版 DeepPot-SE [34] 等模型的区别主要在于如何描述局部环境。局域分解是一种近似:长程静电、极化和色散作用不一定能被截断半径内的环境完全描述,有时需要显式加入长程项。
与 CNN 不同的是,原子的局部环境不在规则网格上,而且必须满足旋转和置换对称性。因此这些模型使用专门设计的描述符或网络结构,而不是网格卷积。SchNet 把卷积推广为以原子间距离为自变量的“连续滤波器卷积” [36];DimeNet [37]、MACE [38] 等模型则进一步引入键角和高阶等变特征。第 08 章(图神经网络)和第 09 章(等变图神经网络)将系统讨论这一路线。
4.9.5 延伸:逆向设计中的卷积解码器
前面的网络从结构或图像出发预测性质。逆向设计则从期望的性质(如禁带宽度、吸附能)出发,寻找满足条件的结构 [39]。如果生成的对象用网格表示,网络就需要逐步构造出一张图或一个三维场。在这类模型中,卷积网络可以承担解码器的工作:
- 在变分自编码器(VAE)和生成对抗网络(GAN)中,用转置卷积(第 4.6.3.3 节)从低维隐空间逐级上采样,重构显微组织、多孔结构或相场分布 [40];
- 在扩散模型中,去噪网络通常采用 U-Net 结构 [21]:由卷积下采样路径、上采样路径和二者之间的跳跃连接组成,同时保留全局信息和局部细节 [41]。
对于分子,也可以直接生成分子图、原子坐标或 SMILES 字符串。若先生成连续的网格场再重建结构,从连续场到化学上合法的结构并不是自动完成的,往往需要额外的后处理和校验。
4.9.6 实践中的常见陷阱
回看几个实验,一个较高的测试准确率还不足以结束研究。还要检查测试样本是否独立、预测是否符合所需的对称性,以及网络是否利用了与目标无关的线索。下面把这些问题放回实际数据中讨论。
陷阱一:数据泄漏
在分子动力学模拟或高通量计算中,常常从同一条轨迹中采样多帧构型,或对同一结构施加不同的微扰。如果把这些高度相似的样本随机划分到训练集和测试集,模型只需“记住”见过的体系就能在测试集上取得很低的误差,从而严重高估真实的泛化能力。实验数据也有类似的问题,例如同一样品的多张显微照片。应采用与研究目的相符的划分方式:
- 骨架划分:小分子研究中按分子骨架分组(第 4.9.1.2 节),检验对新化学结构的预测能力;
- 时间划分:按数据产生的时间先后划分,模拟“用过去的数据预测未来”的实际场景;
- 体系划分:材料研究中按化学体系、成分或样品分组,避免同一体系的衍生样本同时出现在训练集和测试集中。
陷阱二:误读 CNN 的对称性
第 4.3.2 节的平移等变性只在规定的网格、步长和边界条件下成立;第 4.9.1.1 节的实验也表明,“卷积 + 展平 + 全连接”的网络整体上并不具有平移不变性。普通 CNN 也没有旋转等变性。如果目标性质要求旋转不变或等变,可以选择:用旋转后的数据做增强(第 4.9.1.2 节)、改用图表示,或使用几何等变网络。在描述对称性时要准确:图神经网络的节点置换等变性并不自动带来旋转等变性; 包括平移和真旋转, 还包括反射。势能、受力、偶极矩和手性相关性质各有不同的变换规律,应先弄清目标的变换规律,再选择相应的模型结构。
陷阱三:分布外预测与捷径学习
一个模型在现有测试集上表现良好,不代表换成新的成分、仪器或实验批次后仍然有效。即使测试数据看起来相似,也可能存在捷径学习(shortcut learning) [25]:模型借助与标签偶然相关的线索分类,例如仪器特有的噪声、某批次样品的基线漂移,或照片角落里的标尺。可以从以下几个方面检查:
- 构建独立的分布外测试集,例如新的成分体系、新的仪器或新的实验批次,评估模型性能下降的程度;
- 设计破坏某种结构的对照实验,如第 4.9.2.1 节的打乱实验。如果破坏了你认为关键的结构后模型性能并没有明显下降,就要警惕模型是否在利用其他线索;
- 始终与简单基线比较,如第 4.9.1.2 节的均值基线和线性描述符模型。
4.10 CNN 的优势、局限与模型选择
做完实验,再回到最初的模型选择问题:自己的数据是否适合 CNN?判断时先看数据怎样排列、哪些局部关系值得利用,再看预测需要保留哪些位置与对称性信息。下面把本章出现过的优势和限制放在一起,表8 则用于遇到具体问题时查找原因。
4.10.1 核心优势
- 卷积层可以在更大的图上复用同一组参数。 固定核尺寸和通道数后,卷积层的参数量不随输入高、宽增加(式 (20))。这有利于减少需要学习的参数,但不能据此保证一定需要更少的样本。还要区分卷积层与整个网络:若末端采用展平后接固定输入长度的全连接层,就仍然需要匹配规定的特征图尺寸。
- 内置平移等变性。 在步长与边界条件允许时,同一个局部图样无论出现在哪里,都由同一个卷积核以同样的方式检测(第 4.3.2 节),模型无需为每个位置分别学习;配合全局平均池化,还能显著减少对位置的依赖(第 4.9.1.1 节)。
- 天然的多尺度结构。 随着层数增加和逐级下采样,感受野迅速扩大(第 4.3.3 节),浅层描述局部图样,深层组合出更大尺度的结构,适合图像纹理和谱峰组合的建模。不过,网络的层级并不自动对应微观、介观、宏观等物理层级,具体解释需要另外验证。
4.10.2 局限与失效模式
- 没有旋转对称性。 普通卷积只有(有条件的)离散平移等变性。若目标要求旋转不变或等变,需借助数据增强或专门设计的等变网络。
- 依赖规则网格。 对于分子图、无序点云或金属有机框架(MOF)等多孔结构,体素化会带来存储量激增、离散化误差和取向依赖等问题,图神经网络往往是更自然的选择。
- 长程信息需要额外设计。 固定尺寸的卷积核、步长为 1 时,感受野只随深度线性增长;下采样和空洞卷积可以加快增长,全局池化或注意力模块可以引入全局交互。对于长程静电等有明确物理形式的作用,也可以直接加入解析或数值计算的长程项。
- 下采样损失定位信息。 池化和步长卷积无法恢复窗口内各响应的完整位置与数值,可能影响边缘、窄峰或微小缺陷的定位(第 4.4.1 节)。
- 小数据集上未必优于简单模型。 第 4.9.1.2 节的实验表明,表示选择不当时,CNN 可能不如几个物理描述符组成的线性模型。
表8 网格数据建模的常见问题与排查思路
| 现象 | 可能的原因 | 排查与处理思路 |
|---|---|---|
| 预测结果随分子图像的朝向改变 | 表示本身依赖朝向;网络没有旋转对称性 | 旋转/翻转数据增强(第 4.9.1.2 节);比较图模型或几何等变模型;按目标性质决定是否要求镜像不变 |
| 打乱输入顺序后模型仍能分类 | 数值的整体分布本身含有类别信息;也可能存在批次差异等捷径 | 与只用统计量(均值、方差等)的基线比较;对固定模型做扰动测试;按批次划分数据 |
| 平移后准确率明显下降 | 展平 + 全连接层保留了位置依赖;图样移出视场 | 改用全局平均池化(第 4.9.1.1 节);训练时加入平移增强;检查视场裁剪 |
| 下采样后丢失细节 | 步长或池化尺度与目标特征尺度不匹配;混叠 | 推迟下采样;先低通滤波再下采样;使用跳跃连接保留高分辨率特征 |
| 梯度检查失败或训练异常 | col2im 或参数梯度用了赋值而非累加;展开顺序不一致 | 运行第 4.8.9 节的单元测试,尤其是伴随恒等式和批平均损失的梯度检查 |
| 感受野不足以覆盖相关结构 | 层数太少、下采样太晚 | 按式 (34) 计算感受野;增加下采样或空洞卷积;引入全局模块 |
| 边界附近的预测异常 | 补零与数据的物理边界条件不符 | 按物理含义选择周期补边(周期晶胞)、反射补边或常数补边 |
| 验证误差剧烈波动 | 学习率过大;批归一化统计量不稳定;验证集太小 | 降低学习率或使用学习率衰减;按验证误差保存最佳模型;多个随机种子重复 |
4.10.3 模型选择
模型名称可以放在数据形式之后考虑。先明确输入是规则网格、原子与键的关系、符号序列,还是一组描述符,再选择适合这种输入的候选模型。下面是比较的起点,最终仍要在同一数据划分下检验:
- 二维或三维规则网格数据(显微图像、CT 断层扫描、网格化的电子密度):2D 或 3D CNN;需要逐像素输出(如分割)时,可用 U-Net 等全卷积结构;
- 一维谱图(红外、拉曼、XRD):1D CNN;
- 分子图或晶体结构(原子坐标与成键关系):图神经网络;预测受力、势能面等对几何对称性要求严格的性质时,优先考虑 等变网络;
- 变长符号序列(SMILES、蛋白质序列):Transformer、循环神经网络或一维卷积;
- 定长描述符(分子指纹、ACSF 等):MLP 或梯度提升树(如 XGBoost、LightGBM);
- 样本很少(例如几十到几百个):先尝试物理描述符加高斯过程回归或核岭回归,它们还能给出不确定性估计。究竟多少样本算“少”,没有通用的分界线,应通过学习曲线判断。
图 31 把上述思路画成了决策流程。
实验设计清单 在用 CNN 做研究之前,不妨逐条检查:输入表示保留了哪些信息、丢失了哪些信息?边界条件和对称性是否与物理问题相符?梯度实现是否通过了检查?是否与简单基线做了比较?数据划分是否避免了泄漏?“模型学会了分类”“模型捕捉了化学机理”“模型能推广到新体系”是三个不同层次的结论,需要分别验证。
4.11 本章小结与后续学习
4.11.1 本章小结
回看开头的一段谱线和一张显微图像,本章已经完成了从局部计算到训练与评估的过程。可以用下面六点检查自己是否理解了主线:
- 一个窗口怎样计算。 数据与权重逐项相乘再相加,窗口移动后继续使用同一组权重。这就是局部连接与权值共享。它们把局部性和平移相关的结构假设写进模型,使固定核尺寸和通道数的卷积层不必随图像增大而增加参数(第 4.1–4.3 节)。
- 一层会输出多少数。 输出尺寸取决于窗口能放多少次:。每组卷积核合并全部输入通道,生成一张特征图,参数量为 。本章和深度学习代码中的“卷积”使用不翻转核的互相关约定;可学习的核使两种约定能够表示相同的函数(第 4.2 节)。
- 局部信息怎样组成整体判断。 多层组合让感受野按 增长,下采样增大后续层在原始输入上的间隔。步长为 1、边界条件合适时,图样移动会带动卷积响应移动,这叫等变;最终类别是否不变,还取决于池化、边界和分类头。全局平均池化可以减少位置依赖,但不保证所有平移下的结果都相同(第 4.3–4.5 节)。
- 权重怎样学出来。 先计算预测误差,再用链式法则求梯度。同一个权重用于多个窗口、同一个输入进入多个窗口,它们的梯度都需要累加。步长为 1 时,卷积核梯度可写成输入与输出梯度的互相关,输入梯度可写成输出梯度与原卷积核的全卷积;更一般的情况还要处理通道求和、步长和边界。矩阵写法中,前向乘以 ,反向乘以 ;im2col 与 col2im 互为伴随,col2im 回写时必须相加(第 4.6 节)。
- 怎样检查程序。 小幅改变参数,用有限差分估计损失的导数,再与反向传播比较。检查还要覆盖随机输出梯度和批平均损失,才能发现不同类型的下标与累加错误(第 4.6.6 节、第 4.8.9 节)。
- 怎样判断模型是否有用。 先检查输入保留了哪些信息,再与简单模型比较,并使用符合研究目标的数据划分。本章的 ESOL 实验中,换用信息更丰富的图像编码后,CNN 的 从 0.31 提高到 0.78;只用 4 个描述符的线性模型也达到 0.67。这个结果说明,模型名称之外,输入表示和基线同样需要认真检查(第 4.9–4.10 节)。
4.11.2 习题
- (手算) 对例 2.2 的输入 和卷积核 ,补零 、步长 ,求输出的尺寸以及第一行的三个元素。
- (输出尺寸) 输入为 ,依次经过: 卷积(64 个核,步长 2,补零 3)、 最大池化(步长 2,补零 1)。求每一步的输出形状和卷积层的参数量。
- (感受野) 若把表1 中的两个池化层都换成步长为 2 的 卷积,最深一层的感受野变为多少?
- (证明) 证明数学卷积满足交换律 ,并举一个反例说明互相关 。
- (反向传播) 对第 4.6.3.3 节的 输入、 核的例子,写出 和 ,并用“补零后与旋转 180° 的核做互相关”的方法验证。
- (编程) 在
cnn.py中实现均值池化层AvgPool2D(前向用式 (37),反向用式 (38)),并仿照tests_cnn.py为它写一个梯度检查。 - (编程) 故意把
col2im中的+=改成=,运行tests_cnn.py,哪些测试会失败?再把Conv2D.backward中self.dW[...] +=改成=,又有哪些测试会失败?解释原因。 - (实验设计) 在第 4.9.2.1 节的光谱实验中,设计一个只把某一个峰平移 2 个采样点的扰动测试,用来判断训练好的模型是否依赖该峰的绝对位置。
- (讨论) 第 4.9.1.2 节中,Delaney 型线性模型的 logP 系数为负(约 −0.85)。从溶解的热力学角度解释这一符号;并讨论:为什么单通道
std图像很难让 CNN 学到与 logP 相当的信息?
4.11.3 从规则网格到序列与图
本章从相邻像素和相邻采样点的关系出发,用共享窗口处理图像与谱图。继续看化学与材料数据,还会遇到长度可变、需要联系较远位置的信息:
- 时间序列。 反应动力学曲线、分子动力学轨迹和材料的弛豫过程都沿时间演化,当前状态依赖于历史,序列长度也不固定。
- 符号序列。 SMILES [30] 把分子写成一维字符串,分支用括号表示,成环用配对的数字表示。环闭合的两个数字在字符串中可能相距很远,固定窗口的卷积难以直接捕捉这种长程配对关系。
这些数据需要我们重新考虑,信息应按什么顺序组合,较早或较远位置的信息怎样参与当前预测。下一章(第 05 章)的循环神经网络(RNN)会在每个时间步重复使用同一组参数,把当前输入与此前积累的信息结合起来。之后,第 08 章的图神经网络将进一步处理没有固定“上下左右”的分子图,按照原子之间的邻接关系汇总信息。图 32 展示了这些章节如何沿着“局部关系”和“参数共享”继续展开。
表9 从输入形式、对称性和参数共享三个方面,对比了本书前几章和后续章节的几类网络。
表9 几类神经网络结构的对比
| 多层感知机(MLP) | 卷积神经网络(CNN) | 循环神经网络(RNN) | 图神经网络(GNN) | |
|---|---|---|---|---|
| 输入形式 | 定长特征向量 | 规则网格(图像、谱图、体素场) | 变长序列 | 任意拓扑的图、点云 |
| 内置对称性 | 无 | 离散平移等变(有条件) | 沿时间的平移(参数共享) | 节点置换等变;几何等变需专门设计 |
| 参数共享方式 | 无 | 卷积核在空间各位置共享 | 参数在各时间步共享 | 消息函数在各条边、各节点共享 |
| 典型化学应用 | 描述符的定量构效关系(QSAR) | 谱图分类、显微图像分析、网格化密度场 | 反应动力学、SMILES 生成 | 分子性质预测、机器学习势函数 |
4.12 参考文献与延伸阅读
教材与综述
- [1] Goodfellow, I., Bengio, Y., Courville, A. Deep Learning. MIT Press, 2016.(第 9 章系统论述卷积网络)
- [2] LeCun, Y., Bengio, Y., Hinton, G. Deep learning. Nature 521, 436–444, 2015.
- [3] Dumoulin, V., Visin, F. A guide to convolution arithmetic for deep learning. arXiv:1603.07285, 2016.(用图解说明步长、补零与转置卷积的尺寸关系)
- [4] Oppenheim, A. V., Schafer, R. W. Discrete-Time Signal Processing, 3rd ed. Prentice Hall, 2010.(第 8 章讲述离散傅里叶变换与卷积定理)
- [5] Gray, R. M. Toeplitz and circulant matrices: A review. Foundations and Trends in Communications and Information Theory 2(3), 155–239, 2006.
卷积网络的历史与经典结构
- [6] Hubel, D. H., Wiesel, T. N. Receptive fields of single neurones in the cat's striate cortex. The Journal of Physiology 148, 574–591, 1959.
- [7] Fukushima, K. Neocognitron: A self-organizing neural network model for a mechanism of pattern recognition unaffected by shift in position. Biological Cybernetics 36, 193–202, 1980.
- [8] LeCun, Y. et al. Backpropagation applied to handwritten zip code recognition. Neural Computation 1(4), 541–551, 1989.
- [9] LeCun, Y., Bottou, L., Bengio, Y., Haffner, P. Gradient-based learning applied to document recognition. Proceedings of the IEEE 86(11), 2278–2324, 1998.
- [10] Krizhevsky, A., Sutskever, I., Hinton, G. E. ImageNet classification with deep convolutional neural networks. NeurIPS, 2012.
- [11] Simonyan, K., Zisserman, A. Very deep convolutional networks for large-scale image recognition. ICLR, 2015.
- [12] He, K., Zhang, X., Ren, S., Sun, J. Deep residual learning for image recognition. CVPR, 2016.
- [13] Dosovitskiy, A. et al. An image is worth 16×16 words: Transformers for image recognition at scale. ICLR, 2021.
网络组件、训练与分析
- [14] Lin, M., Chen, Q., Yan, S. Network in network. ICLR, 2014.(提出全局平均池化)
- [15] Ioffe, S., Szegedy, C. Batch normalization: Accelerating deep network training by reducing internal covariate shift. ICML, 2015.
- [16] Srivastava, N. et al. Dropout: A simple way to prevent neural networks from overfitting. Journal of Machine Learning Research 15, 1929–1958, 2014.
- [17] Yu, F., Koltun, V. Multi-scale context aggregation by dilated convolutions. ICLR, 2016.
- [18] He, K., Zhang, X., Ren, S., Sun, J. Delving deep into rectifiers: Surpassing human-level performance on ImageNet classification. ICCV, 2015.(He 初始化)
- [19] Kingma, D. P., Ba, J. Adam: A method for stochastic optimization. ICLR, 2015.
- [20] Howard, A. G. et al. MobileNets: Efficient convolutional neural networks for mobile vision applications. arXiv:1704.04861, 2017.(深度可分离卷积)
- [21] Ronneberger, O., Fischer, P., Brox, T. U-Net: Convolutional networks for biomedical image segmentation. MICCAI, 2015.
- [22] Luo, W., Li, Y., Urtasun, R., Zemel, R. Understanding the effective receptive field in deep convolutional neural networks. NeurIPS, 2016.
- [23] Araujo, A., Norris, W., Sim, J. Computing receptive fields of convolutional neural networks. Distill, 2019. 原文
- [24] Zhang, R. Making convolutional networks shift-invariant again. ICML, PMLR 97, 7324–7334, 2019. 原文(降采样、混叠与平移敏感性)
- [25] Geirhos, R. et al. Shortcut learning in deep neural networks. Nature Machine Intelligence 2, 665–673, 2020.
化学与材料中的应用
- [26] Delaney, J. S. ESOL: Estimating aqueous solubility directly from molecular structure. Journal of Chemical Information and Computer Sciences 44(3), 1000–1005, 2004.
- [27] Wu, Z. et al. MoleculeNet: A benchmark for molecular machine learning. Chemical Science 9, 513–530, 2018.
- [28] Bemis, G. W., Murcko, M. A. The properties of known drugs. 1. Molecular frameworks. Journal of Medicinal Chemistry 39(15), 2887–2893, 1996.
- [29] Goh, G. B., Siegel, C., Vishnu, A., Hodas, N. O., Baker, N. Chemception: A deep neural network with minimal chemistry knowledge matches the performance of expert-developed QSAR/QSPR models. arXiv:1706.06689, 2017.
- [30] Weininger, D. SMILES, a chemical language and information system. 1. Introduction to methodology and encoding rules. Journal of Chemical Information and Computer Sciences 28(1), 31–36, 1988.
- [31] Essmann, U. et al. A smooth particle mesh Ewald method. The Journal of Chemical Physics 103, 8577–8593, 1995.
- [32] Behler, J., Parrinello, M. Generalized neural-network representation of high-dimensional potential-energy surfaces. Physical Review Letters 98, 146401, 2007.
- [33] Smith, J. S., Isayev, O., Roitberg, A. E. ANI-1: An extensible neural network potential with DFT accuracy at force field computational cost. Chemical Science 8, 3192–3203, 2017.
- [34] Zhang, L., Han, J., Wang, H., Saidi, W. A., Car, R., E, W. End-to-end symmetry preserving inter-atomic potential energy model for finite and extended systems. NeurIPS 31, 2018. arXiv:1805.09003
- [35] Zhang, L., Han, J., Wang, H., Car, R., E, W. Deep potential molecular dynamics: A scalable model with the accuracy of quantum mechanics. Physical Review Letters 120, 143001, 2018. DOI:10.1103/PhysRevLett.120.143001
- [36] Schütt, K. T. et al. SchNet: A continuous-filter convolutional neural network for modeling quantum interactions. NeurIPS, 2017.
- [37] Gasteiger, J., Groß, J., Günnemann, S. Directional message passing for molecular graphs. ICLR, 2020.
- [38] Batatia, I. et al. MACE: Higher order equivariant message passing neural networks for fast and accurate force fields. NeurIPS 35, 11423–11436, 2022. arXiv:2206.07697
- [39] Sanchez-Lengeling, B., Aspuru-Guzik, A. Inverse molecular design using machine learning: Generative models for matter engineering. Science 361, 360–365, 2018.
- [40] Gómez-Bombarelli, R. et al. Automatic chemical design using a data-driven continuous representation of molecules. ACS Central Science 4(2), 268–276, 2018.
- [41] Ho, J., Jain, A., Abbeel, P. Denoising diffusion probabilistic models. NeurIPS, 2020.
软件文档
- [42] PyTorch 官方文档:Conv2d;CrossEntropyLoss。(前向计算为互相关;交叉熵直接接收 logits)
- [43] DeepChem 2.8.0 文档:MoleculeNet 数据集接口;SmilesToImage 源码。(
load_delaney的划分与标签变换、两种图像编码的定义)
附录 A. 符号表
查表时还要结合所在公式的定义。例如, 在一维卷积和离散傅里叶变换中表示序列长度,在式 (3) 中表示连续卷积层的个数,在批处理语境下才表示批大小;各小节已分别说明。张量的形状则按正文约定逐项读取。
表10 本章主要符号
| 符号 | 含义 | 类型或形状 |
|---|---|---|
| 批大小(一个小批量中的样本数) | 正整数 | |
| 输入的通道数、高度、宽度 | 正整数 | |
| 输出通道数,即卷积核的个数 | 正整数 | |
| (或 ) | 卷积核(或池化窗口)的高度、宽度 | 正整数 |
| 步长 | 正整数 | |
| 每侧补零的圈数 | 非负整数 | |
| 输出的高度、宽度(式 (18)) | 正整数 | |
| 输入张量;补零后的输入张量 | ; | |
卷积核张量(代码中为 Conv2D.W);偏置向量 | ; | |
| 卷积层输出 | ||
| 损失对卷积层输出的梯度 | ||
| im2col 展开矩阵 | ||
| 展平的卷积核矩阵 | ||
| 互相关;数学卷积;循环卷积 | 二元运算 | |
| 平移 个网格点的算子 | 线性算子 | |
| 第 层的理论感受野;累积步长 | 正整数 | |
| 逐元素激活函数(如 ReLU) | 标量函数 | |
| 输出层得分(logits);Softmax 概率;真实类别的独热向量 | 维向量( 为类别数) | |
| 损失函数(交叉熵或均方误差) | 标量 | |
| 克罗内克符号 | 0 或 1 | |
| 有限差分步长;浮点单位舍入误差(双精度约 ) | 正实数 | |
| 序列 的离散傅里叶变换(式 (85)) | 复数序列 | |
| 均方根误差、平均绝对误差、决定系数 | 实数 |
附录 B. 部分习题提示与答案
- 习题 1:输出为 ;第一行为 。注意窗口中落在补零区的位置贡献为 0。
- 习题 2:卷积层输出 ,形状为 ,参数量 ;池化后为 ,形状为 。
- 习题 3:按式 (34) 依次为 3、5、7()、11、15、19()、27,最深一层的感受野为 27。
- 习题 4:在 中令 即得 。互相关的反例:取 、,按“全”互相关计算二者结果互为翻转。
- 习题 7:把
col2im的+=改为=后,伴随恒等式测试、“两个卷积层串联”的梯度测试以及与 PyTorch 的对照会失败;其余只含一个卷积层的梯度测试仍能通过,因为第一层卷积的输入梯度不参与任何参数梯度的计算。把参数梯度的+=改为=后,所有单样本的梯度测试都能通过(每个样本只调用一次backward),只有批平均损失的测试会失败。这说明测试必须有针对性地覆盖每一种累加。