Appearance
第 02 章 线性单元与梯度下降
2.0 本章导读
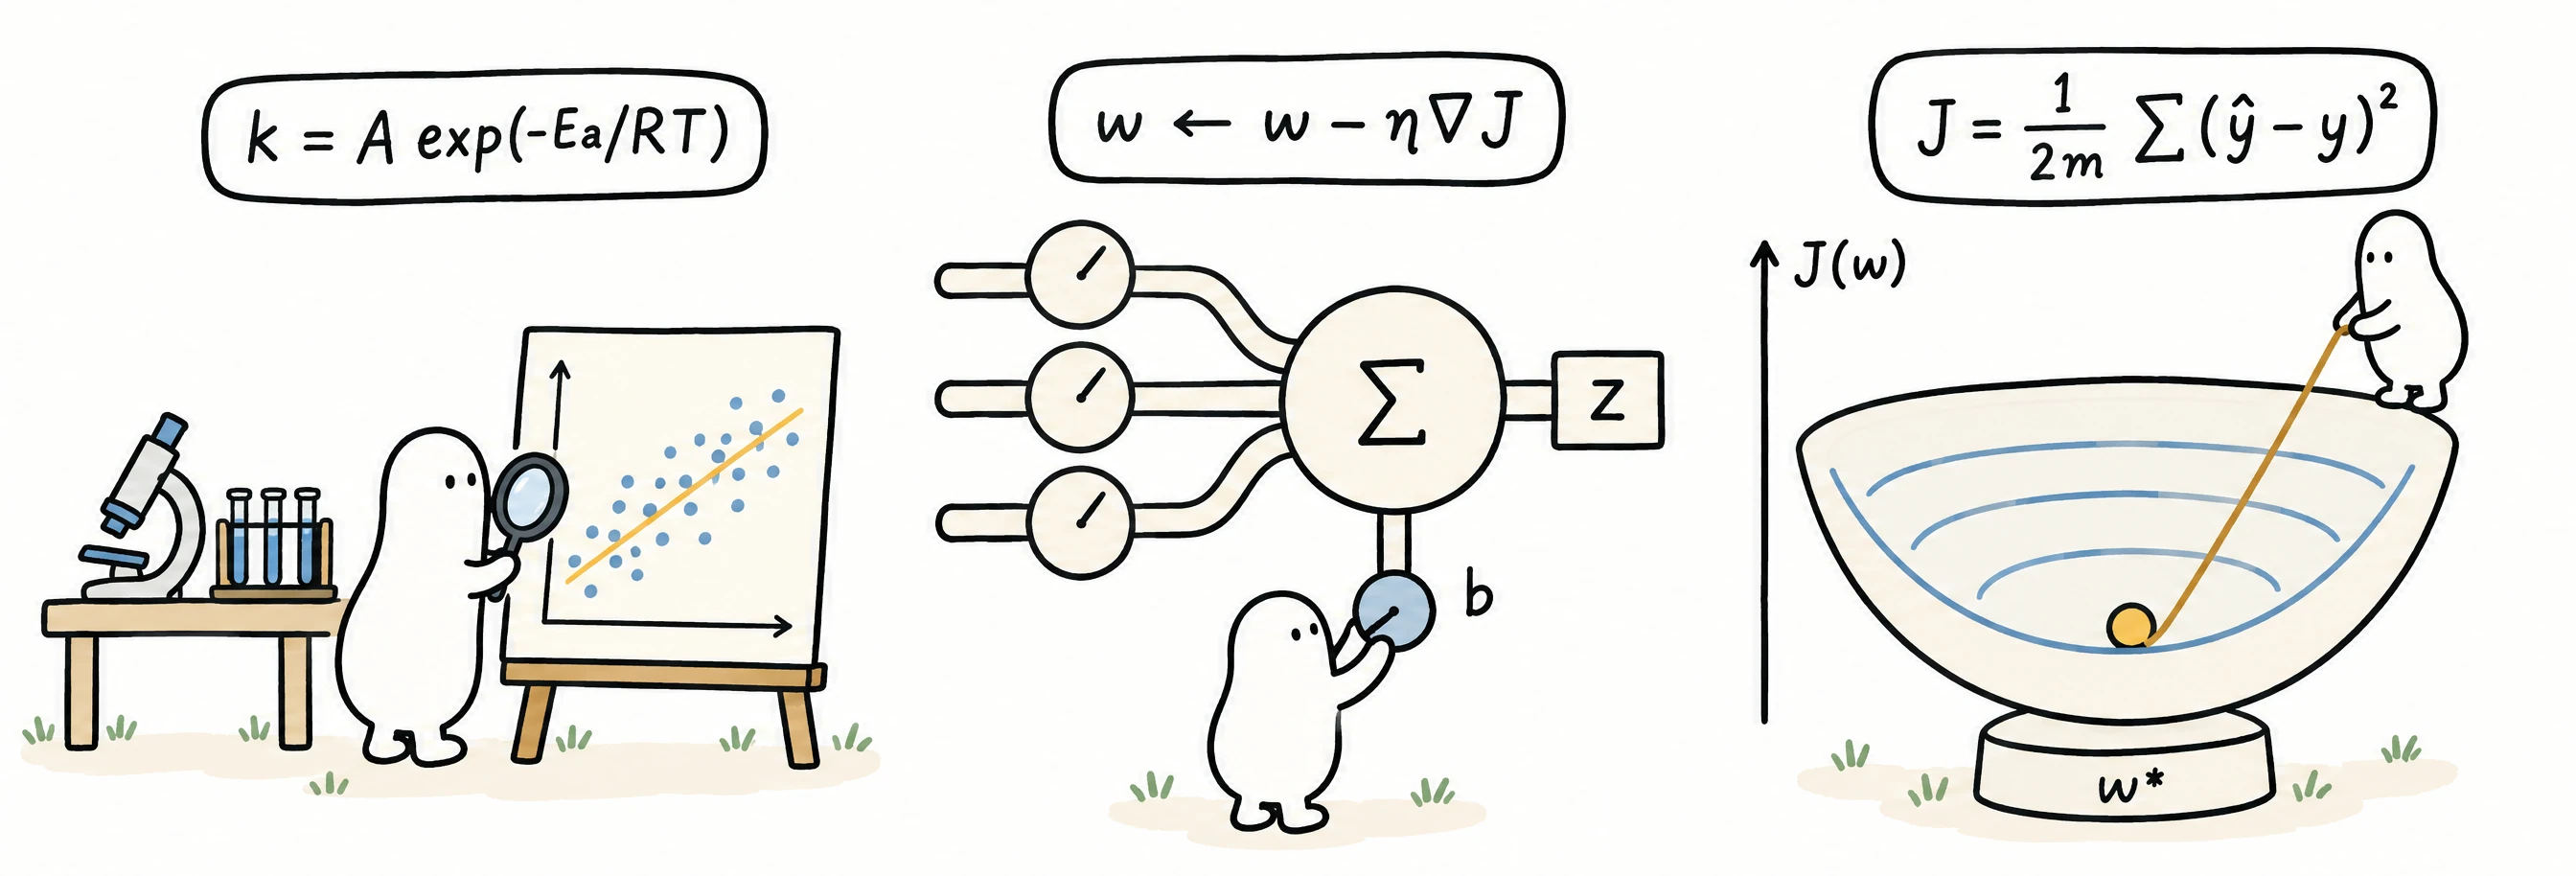
如果你做过标准曲线,或用 Arrhenius 图求过活化能,就已经接触过本章的基本问题:给定一组实验点,怎样找到一条合适的直线?本章从这个问题出发,解释机器学习中的“模型”“损失”和“训练”分别在做什么。
我们先用 N₂O₅ 分解反应的速率常数认识线性单元,再根据预测误差调整斜率和截距。等这一步看懂后,再讨论学习率、特征标准化和多个输入。后半章用带隙预测检查模型遗漏了什么,用烷烃沸点检验模型能否预测训练范围以外的数据。
2.0.1 学习目标与阅读方式
第一次阅读时,重点是能完成以下四件事:
- 区分实验数据、模型参数和预测值,说明线性单元与上一章感知器的输出有何不同。
- 用残差和平方误差比较拟合结果,并看懂一次梯度下降更新。
- 解释学习率与特征标准化为什么会影响训练,运行一个完整的拟合程序。
- 区分“训练已经收敛”和“预测值得信任”,用残差、测试集与外推实验检查模型。
读正文只需要直线方程、求平均和基本求导。矩阵写法在多特征问题出现时再引入。想进一步理解平方误差的统计来源、损失曲面的曲率和学习率的稳定界限,可以读附录 B;严格证明集中在附录 A。完整 Python 工具与案例放在 配套代码目录说明 中,正文先展示能独立运行的最小程序。
2.1 从感知器到直线拟合
2.1.1 从“是不是”到“是多少”
上一章的感知器先对输入加权求和,再通过阶跃函数输出 0 或 1。它适合回答分类问题,例如“这种材料是不是超导体”。如果要预测超导转变温度、带隙或沸点,我们需要的则是一个具体数值。这类任务称为回归。
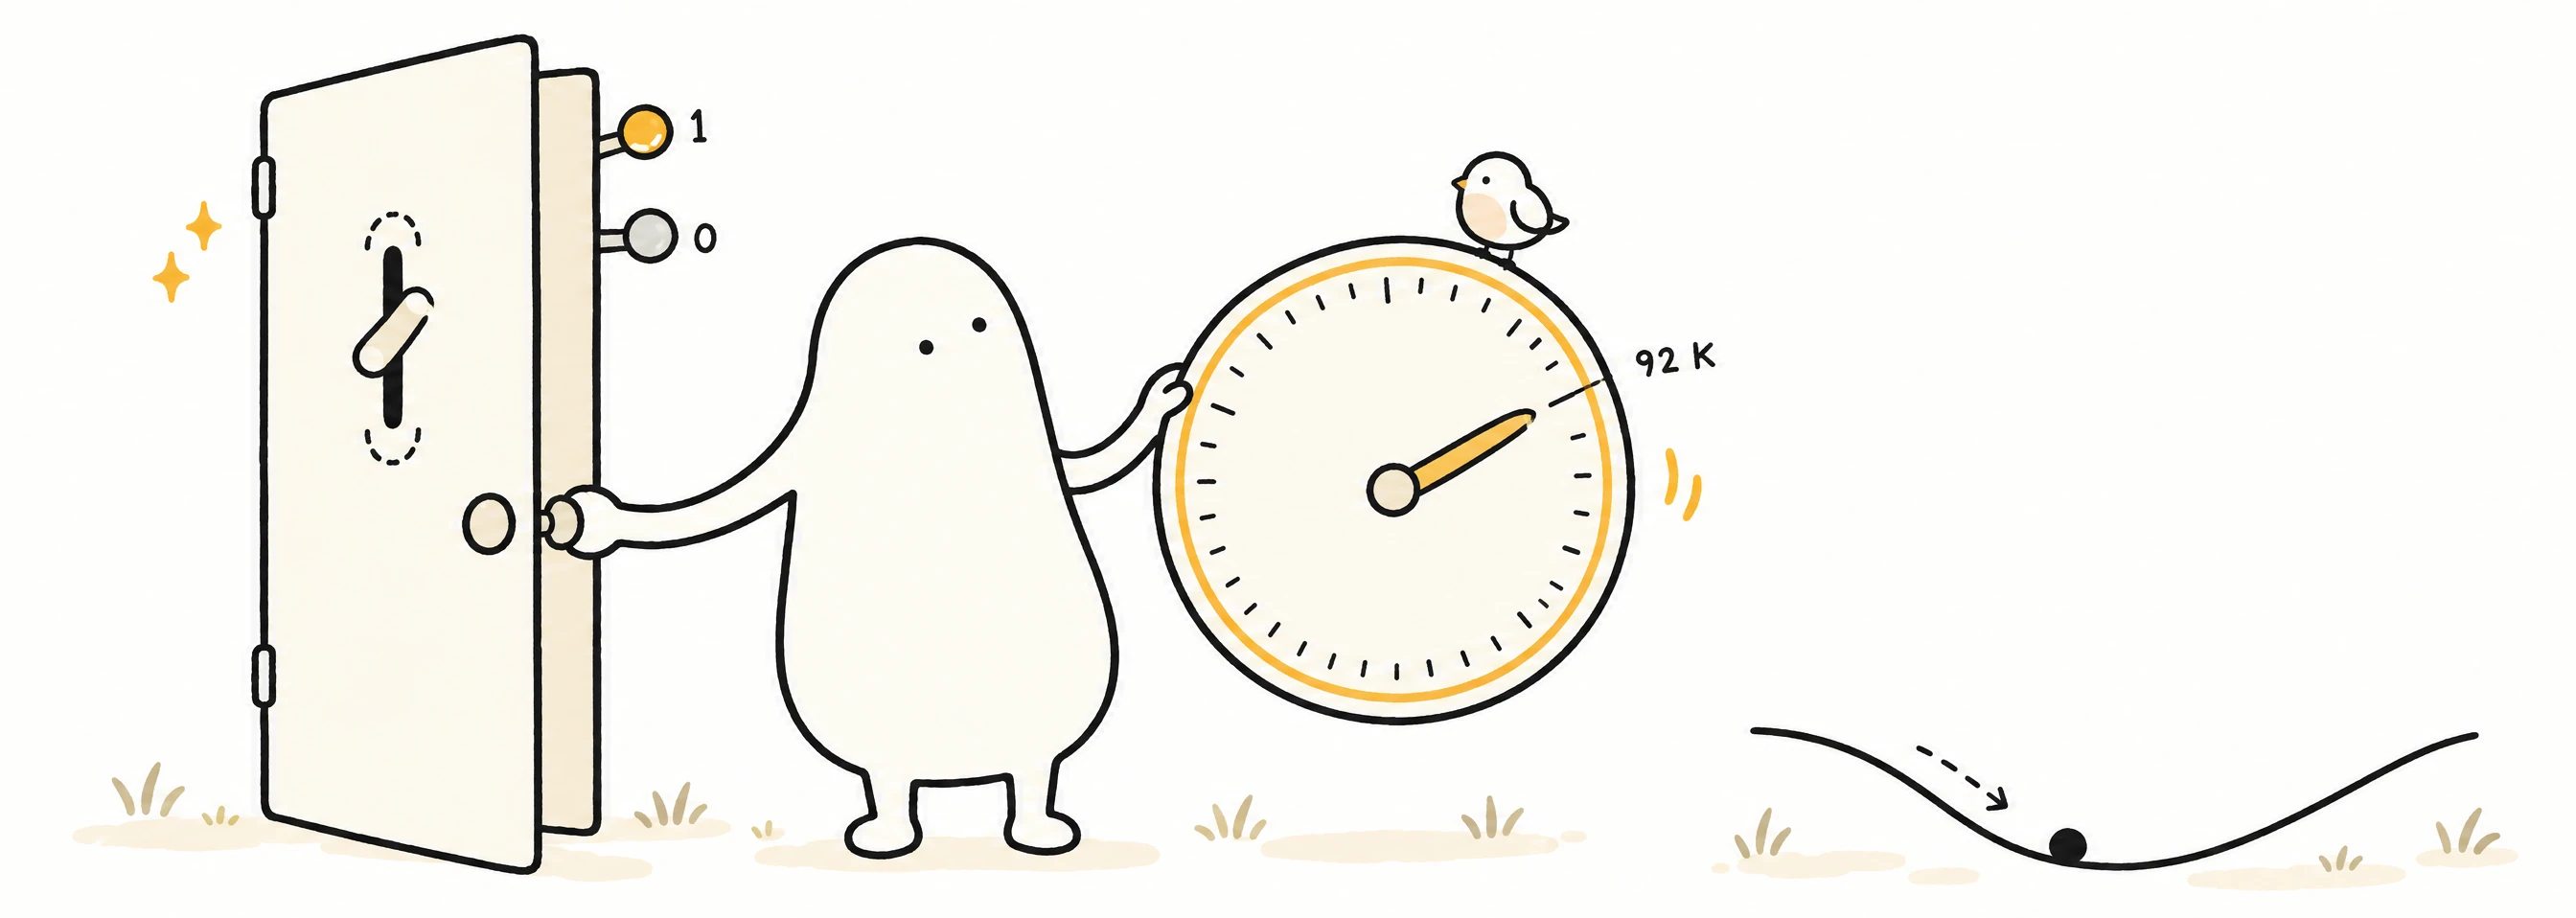
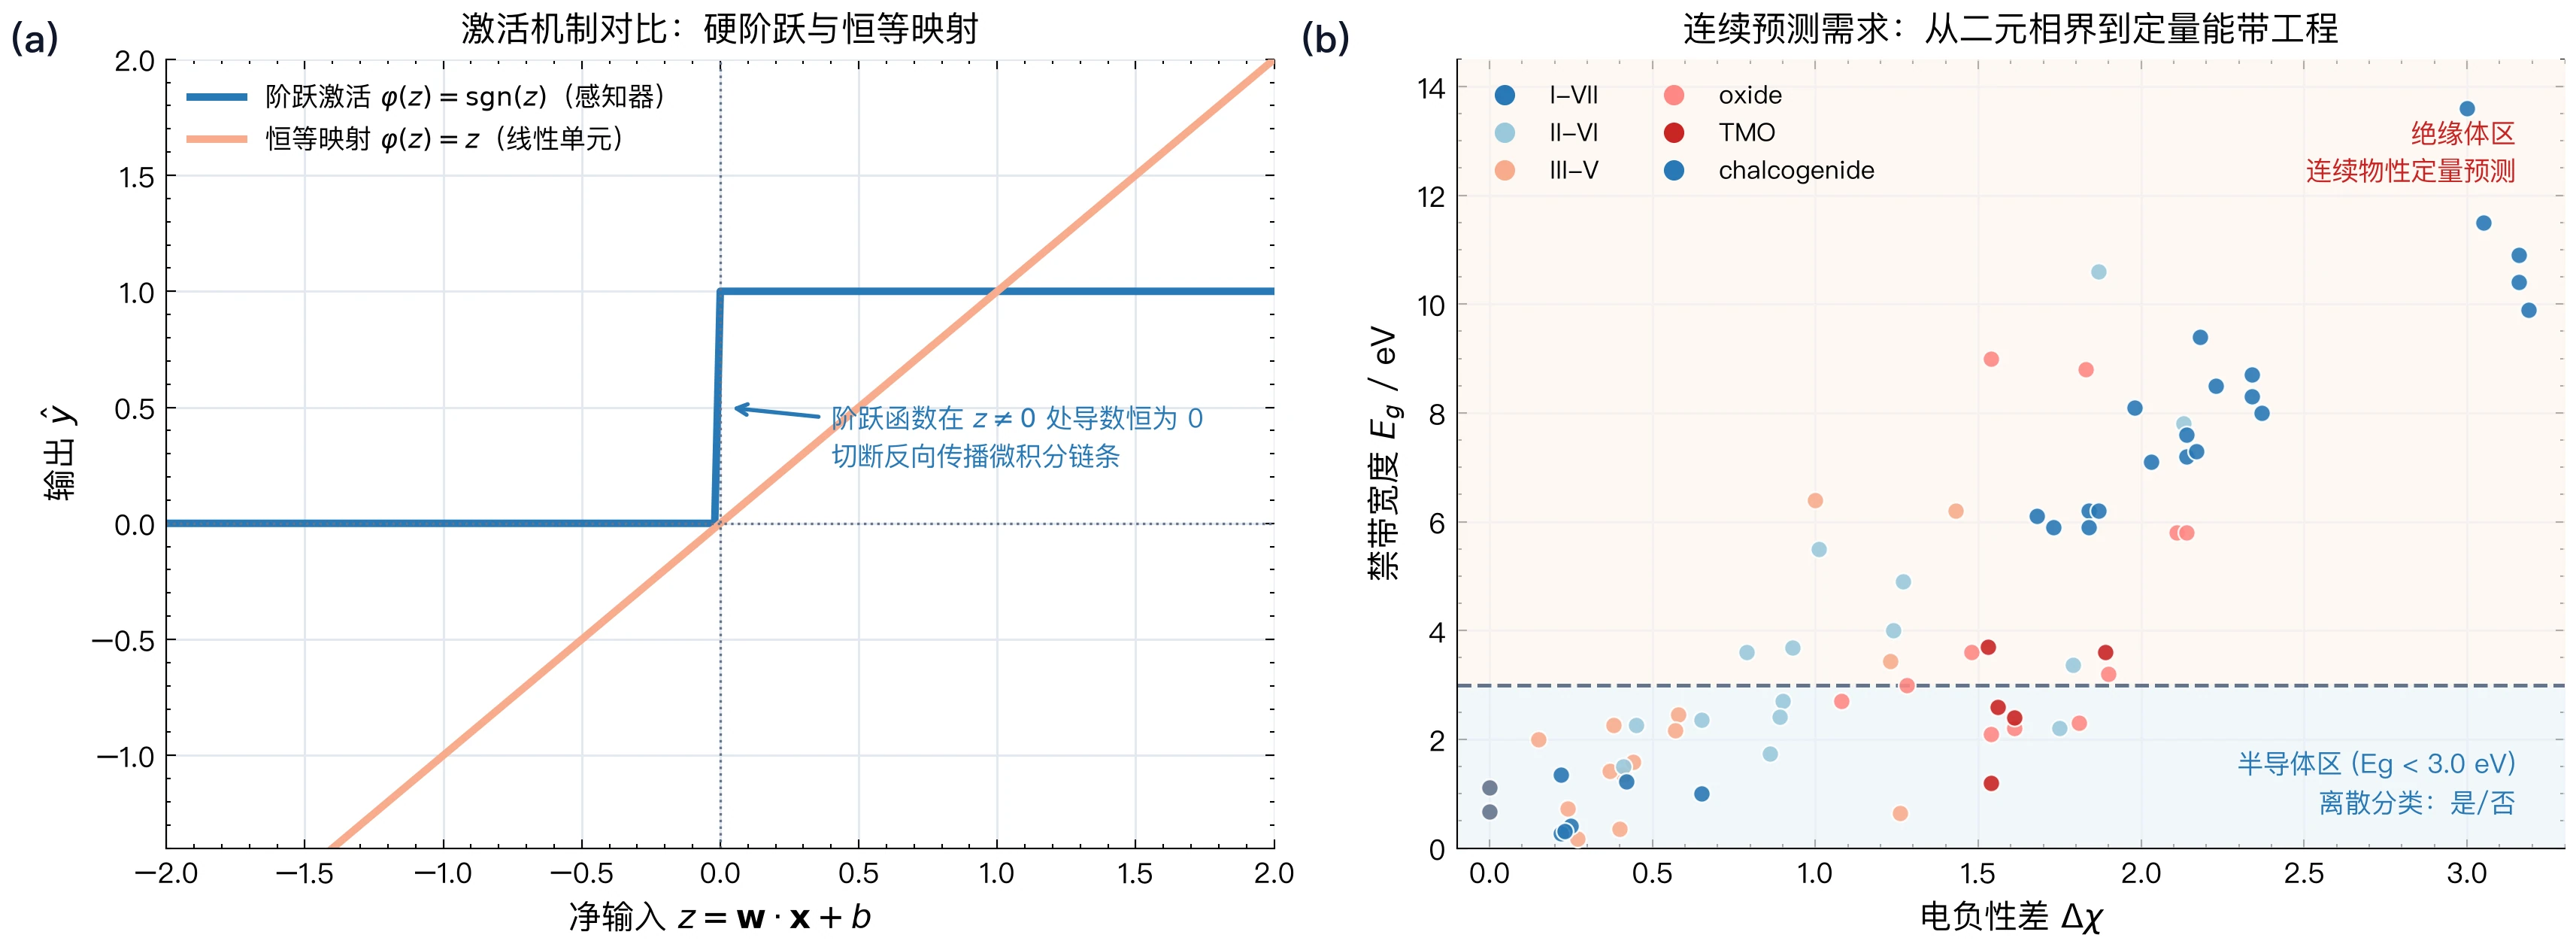
去掉末端的阶跃函数,把加权和直接作为预测值,就得到了本章的线性单元。这样做还有一个好处:当参数稍微变化时,预测值和平方误差也会平滑变化,我们可以通过求导判断参数该往哪个方向调整。这里关注的是损失对参数的变化;感知器的阶跃函数几乎处处导数为零,无法直接提供这种调整信息。感知器原有的纠错规则与线性单元的历史联系见附录 B.1。
2.1.2 从 Arrhenius 图认识输入与参数
先看一个熟悉的实验问题:测得 N₂O₅ 在不同温度下的分解速率常数,怎样求活化能?本章使用的五个数值如下,数据来源与拟合结果在 2.5.1 节说明。
表 1 N₂O₅ 分解反应的温度与速率常数
| 温度 / K | 速率常数 / s⁻¹ |
|---|---|
| 298.15 | |
| 308.15 | |
| 318.15 | |
| 328.15 | |
| 338.15 |
在适用的温度范围内,Arrhenius 方程为 。对它取自然对数,得到
这就是直线方程。若用 作横坐标、 作纵坐标,模型的预测值可以写成
是斜率, 是截距;在这个化学问题中,,。求出斜率后,就能换算活化能。
这里有三类量需要分清: 是输入, 是实测目标, 是模型给出的预测。拟合时,数据 、 保持不变,我们调整的是 和 。 在一元模型里,机器学习所说的“权重”就是熟悉的斜率,“偏置”就是截距。
化学教材常把横坐标写成 ,这样数值约为 3,读图更方便。换了横坐标,斜率也随之改变:此时 ,所以 。后面的程序统一使用 ;读斜率时必须同时看横坐标的定义。
2.1.3 线性单元怎样给出预测
先给斜率和截距各取一个值,将一个温度对应的 代入 ,就得到该温度下的预测。这一步称为前向计算,意思是从输入算到输出。调整 会改变直线的倾斜程度,调整 会让直线整体上下移动。
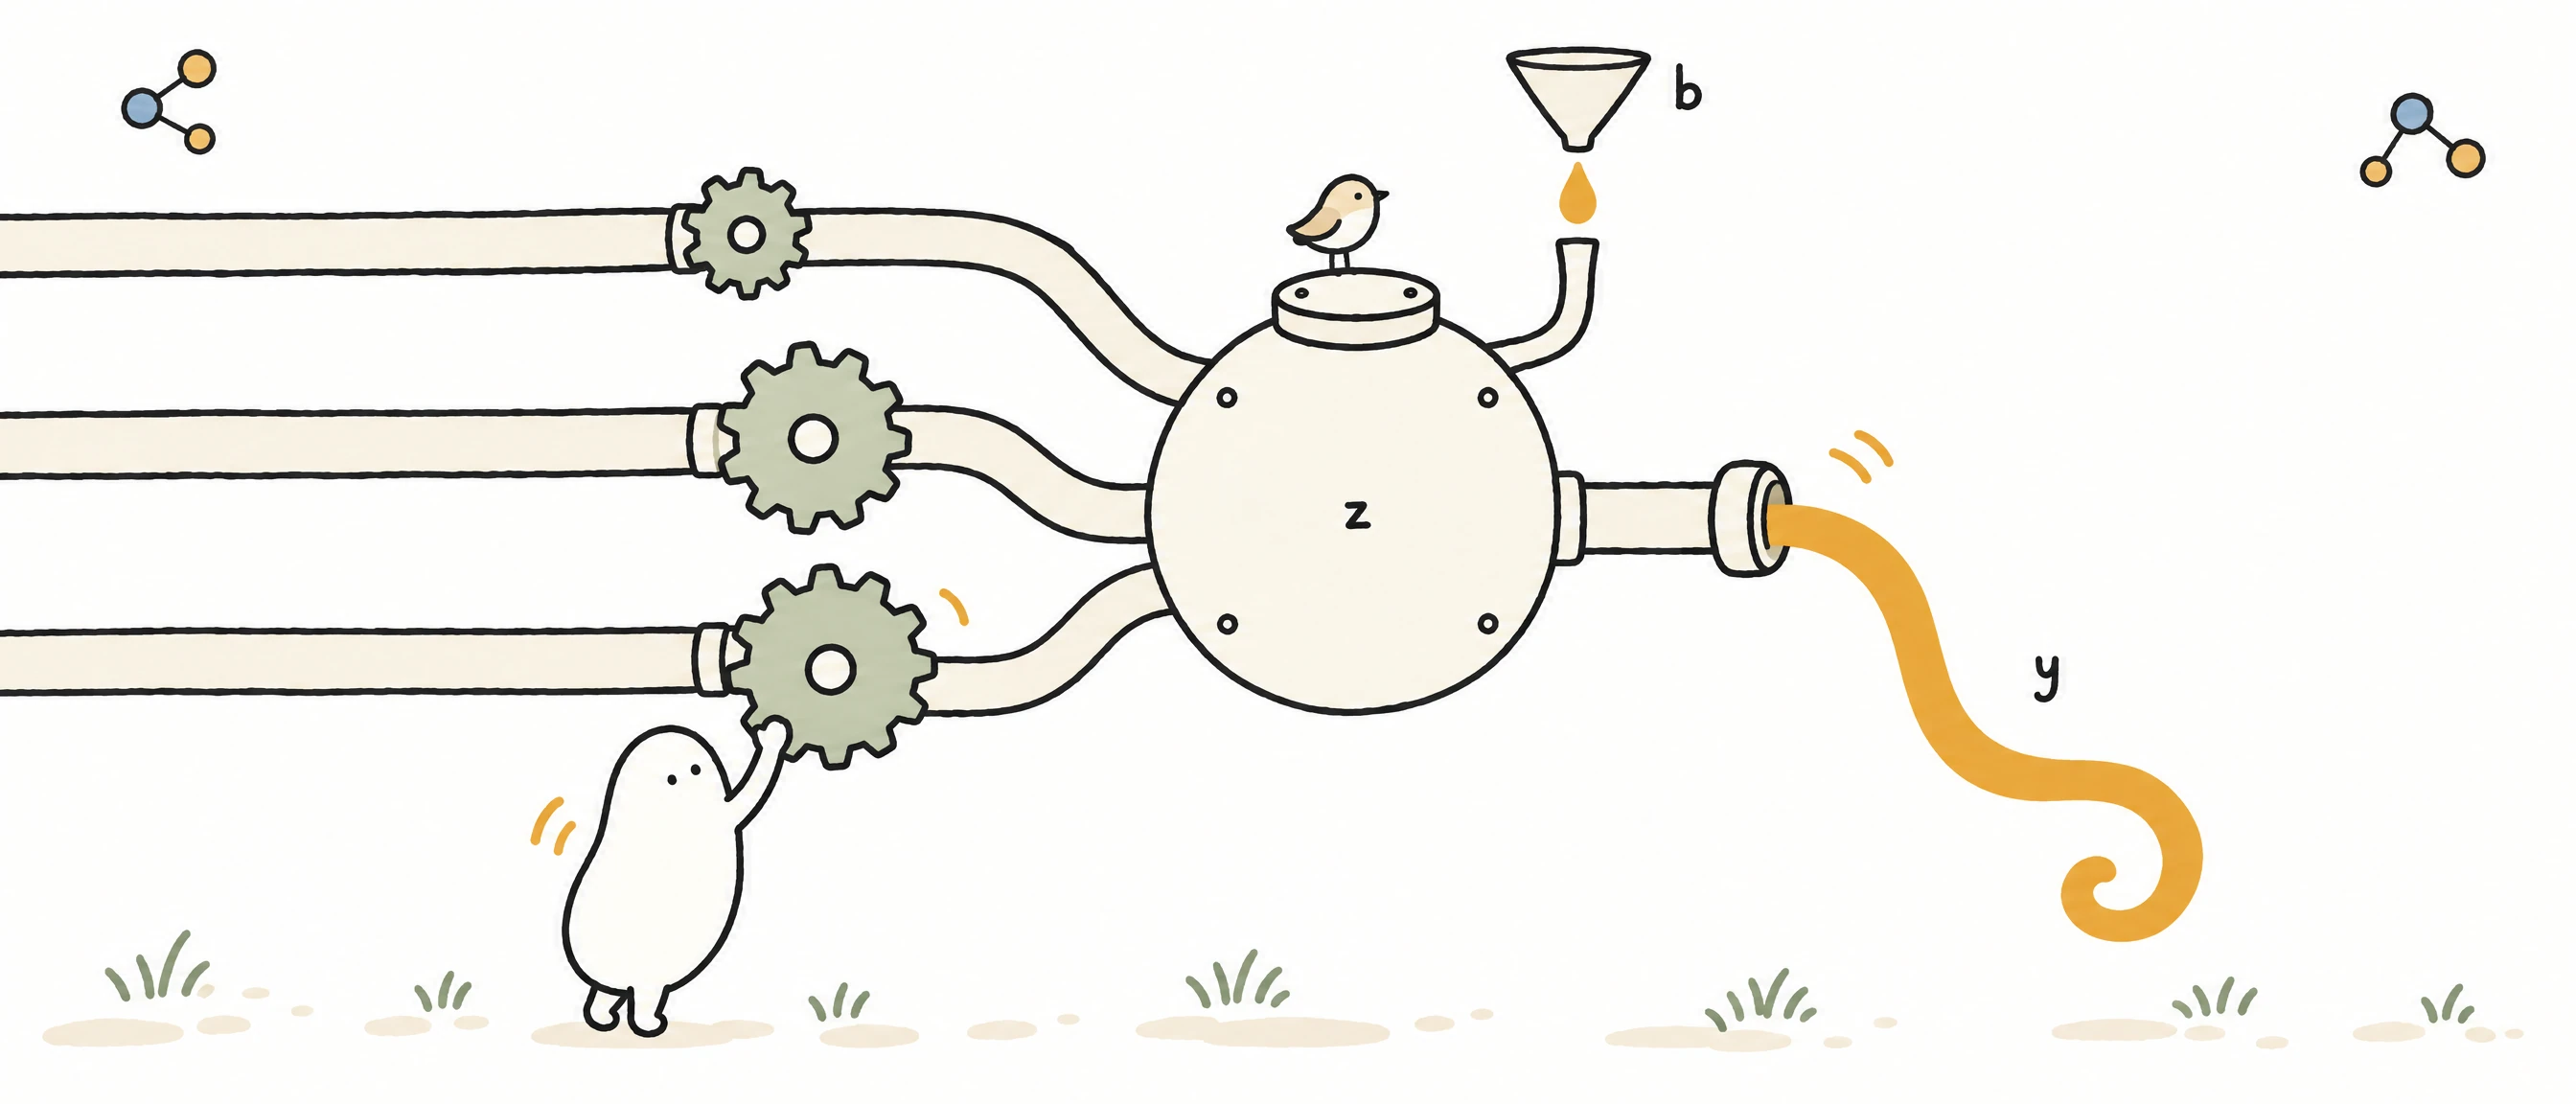
“训练线性单元”就是根据实验数据选择这些参数。我们目前已经能画出一条直线,但还没有回答怎样判断它是否合适。这需要先定义拟合误差,下一节就从实验点到直线的距离讲起。
2.1.4 其他化学定律中的直线
Arrhenius 方程只是一个例子。取对数、取倒数等变量变换,也能把其他化学关系写成直线。先认出其中熟悉的一两项即可,其余可以在需要时查阅。
表 2 常见化学定律的线性化形式及其与线性单元的对应关系
| 定律 | 原始形式 | 线性化形式 | 与 的对应 | 主要假设 |
|---|---|---|---|---|
| Arrhenius 方程 | ,,, | 、 在所研究温度范围内不随温度变化 | ||
| Clausius–Clapeyron 方程 | ,,, | 蒸气为理想气体,液相体积可忽略, 为常数 | ||
| Beer–Lambert 定律 | ,,, | 稀溶液、单色光、无散射与缔合 | ||
| Hammett 方程 | ,,, | 同一反应系列,间位或对位取代 | ||
| Langmuir 吸附等温式 | ,,, | 单分子层吸附,表面均匀,吸附质之间无相互作用 |
从表 2 可以看出两点。第一,直线的斜率和截距往往直接对应着有明确物理意义的量:活化能、汽化焓、摩尔吸光系数、反应常数 、饱和吸附量等。因此“求出最合适的直线”不只是数据处理,更是在测定物理量。第二,Beer–Lambert 与 Hammett 两行的理论截距为零;实际拟合时通常仍保留截距 ,并检验它是否与零在误差范围内一致——这是检查基线漂移或参考体系选择是否合理的简便方法。
表 2 中的对应关系说明,选择什么作为输入,常常来自领域知识。活化能、汽化焓等物理量能够从斜率中读出,是因为我们已经有相应的物理模型。后面用描述符预测带隙时,没有这样的已知方程,权重的物理解读就需要更加谨慎。
变量变换也会改变我们衡量误差的方式。例如,对 做普通最小二乘,更适合描述 的相对误差大致稳定的情形;对 Langmuir 方程做线性化,也会改变不同测量点在拟合中的影响。附录 B.2 会从统计角度解释这一点。
2.2 从预测误差到一次参数更新
2.2.1 用残差描述一个点的偏差
给定一条直线后,我们可以算出每个实验点的预测值。第 个实验点的实测值减去预测值,称为残差:
下标 表示“第几个实验点”。按本章的符号约定,残差为正表示预测偏低,为负表示预测偏高。残差的绝对值越大,这个点的预测偏差越大。
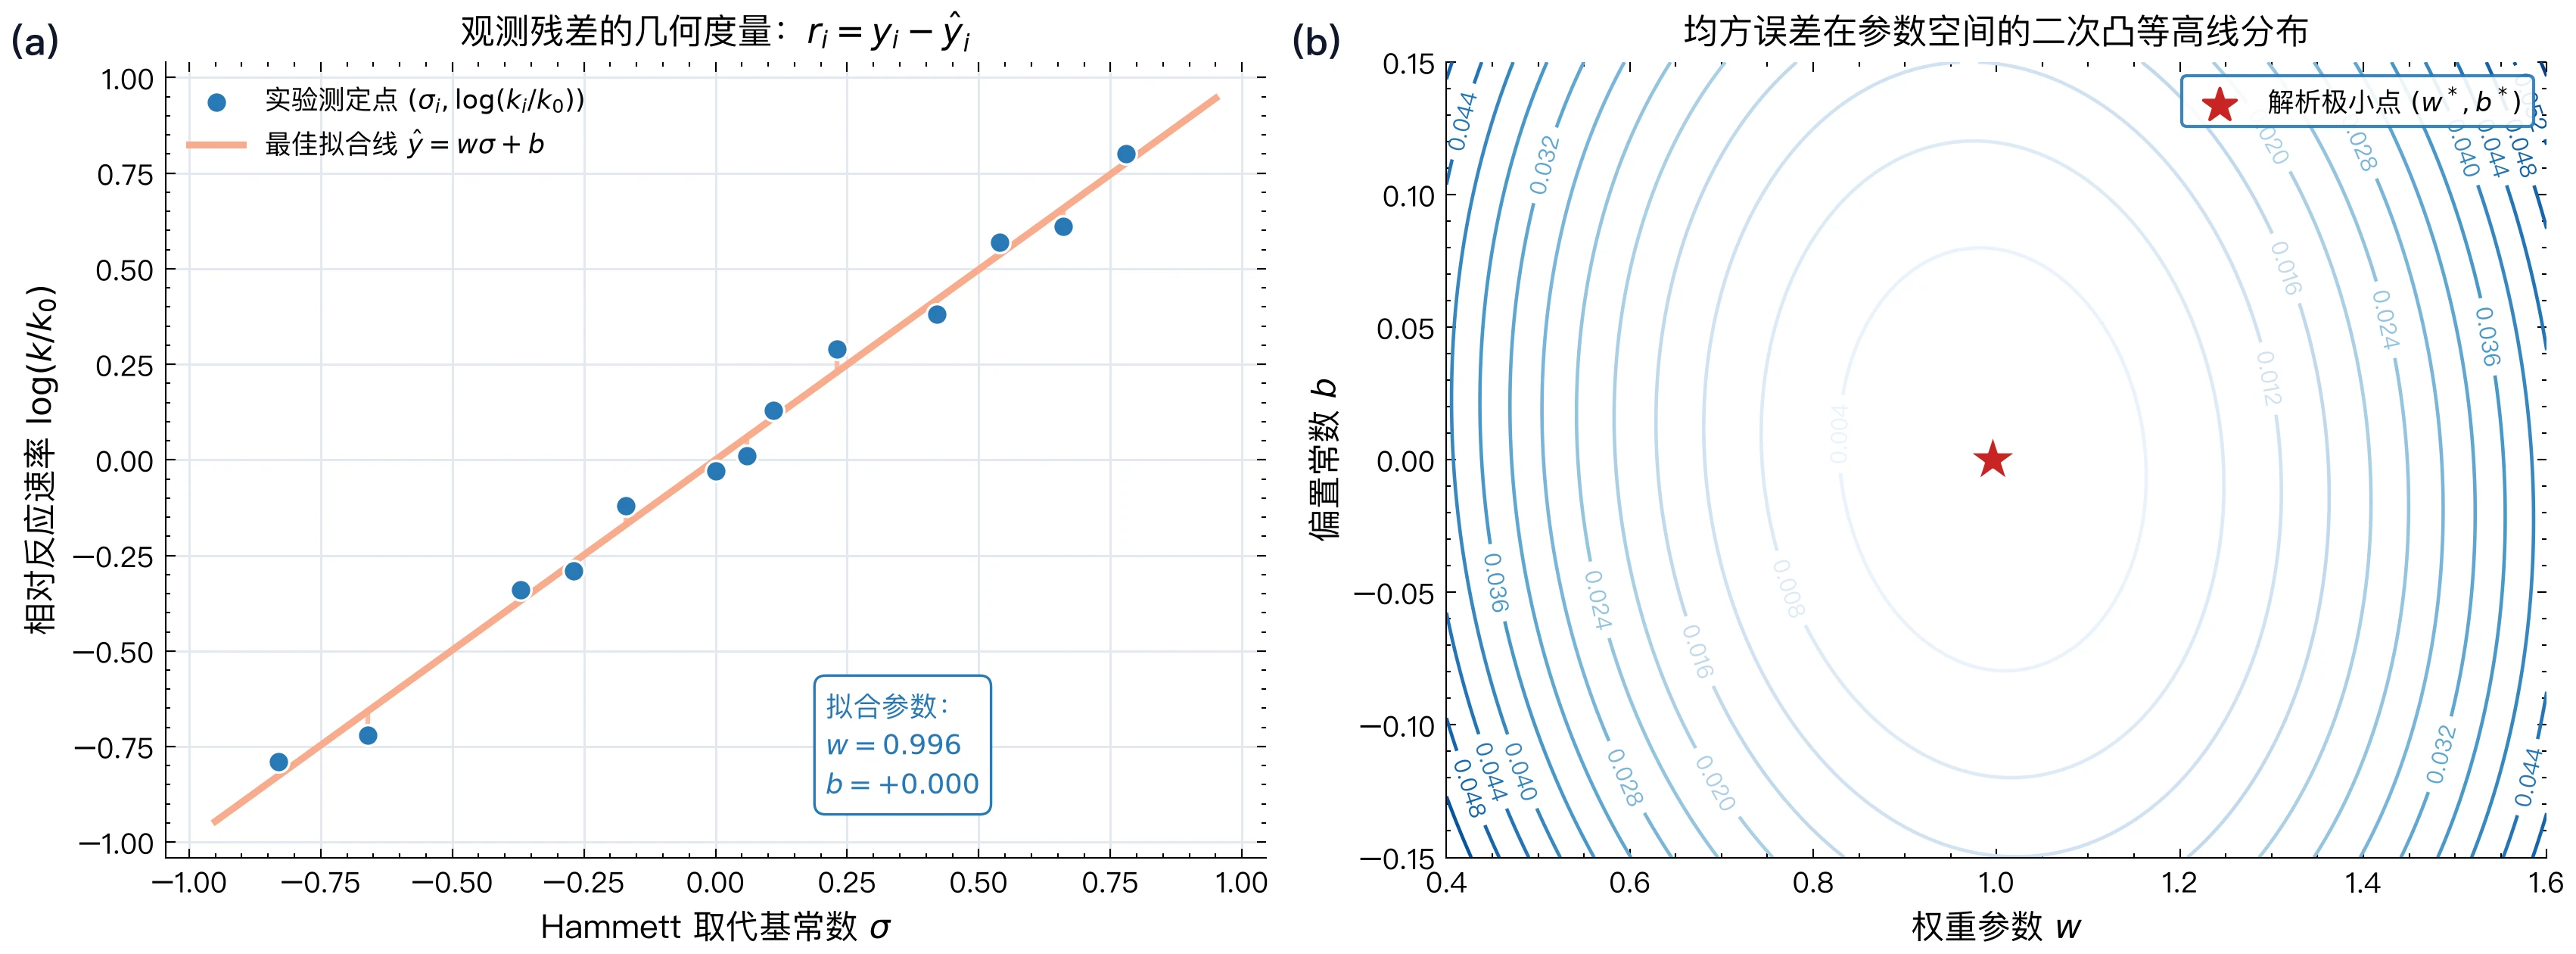
先看图 5(a)。需要注意,残差是沿纵轴方向测量的竖直距离,而不是数据点到直线的垂直(最短)距离。这背后的假设是:自变量(如取代基常数、温度、配比)被认为是准确已知的,测量误差主要出现在因变量上。如果自变量本身也有不可忽略的误差,就需要采用“正交回归”或“总体最小二乘”等其他方法,本章不展开讨论。
2.2.2 用损失比较整组数据的拟合
一条线可能在这个点上偏高,在另一个点上偏低。要比较两条直线,需要把所有点的偏差合成一个数。直接相加会让正负残差互相抵消,所以这里先把残差平方,再取平均:
是样本数, 表示把各点的结果加起来, 称为损失函数。对同一组数据, 越小,残差平方和越小。平方还会让大偏差受到更重的惩罚,因此拟合结果可能受到离群点的明显影响。
通常报告的均方误差(MSE)没有前面的 ,因此这里 。这个系数只是为了求导方便,不改变最优参数的位置。它与学习率之间的关系见附录 A.1。
平方误差是一种可用的比较标准。附录 B.2 还会说明:如果误差独立且服从方差相同的高斯分布,最小化平方误差恰好对应最大似然估计。这是它的一种统计解释,不是理解下面更新过程的前提。
现在,每一组 都有一个对应的损失值。训练的目标就明确了:从当前这条线出发,调整两个参数,让整组数据的损失变小。
2.2.3 偏导数告诉我们往哪边调
先固定截距,只把斜率增加一点,损失会怎样变化?偏导数 描述的就是这种局部变化。它为正时,斜率小幅增加会使损失增大,因此应朝减小斜率的方向调整;它为负时,则朝增大斜率的方向调整。截距也可以用同样的方法判断。
为了算出这个方向,先看一个残差:。固定数据和截距时,斜率每增加一点,残差就按 的比例变化。因此
这两个式子来自链式法则:先求“损失随残差怎样变化”,再乘上“残差随参数怎样变化”。平方求导产生的 2 与损失中的 正好相消。
偏置的式子尤其容易理解:如果模型整体预测偏低,平均残差为正,偏置的偏导数就为负;把偏置增大一些,就会把整条线向上抬。斜率的调整还要考虑每个点的横坐标,所以残差要乘上 。不同样本可能提出不同的调整方向,求和后得到整组数据的共同结果。
把所有参数的偏导数排列在一起,就得到梯度。本节只有两个参数,梯度只有两个分量。梯度并不等于残差:残差描述预测偏了多少,梯度描述调整参数会怎样改变整体损失。
2.2.4 手算一次梯度下降
沿梯度的相反方向小幅调整参数,就得到梯度下降的更新规则:
正数 称为学习率,控制调整的幅度。两个偏导数都要用更新前的同一组 计算,再一起更新参数。
先用一个人为设定的无量纲数据点看清算术过程:、。它只用于演示一次更新,不是实验数据,也不足以唯一确定一条直线。令初始参数 ,学习率为 :
- 预测值为 ,残差为 ,损失为 。
- 两个偏导数都是 。
- 更新后,,。
- 新预测为 ,新损失为 。
这一步让损失从 2 降到了 1.28。真实拟合时,只需把第 2 步换成对全部实验点求和,再重复“计算预测—计算梯度—更新参数”。2.4 节会用表 1 的五个点完成这件事。
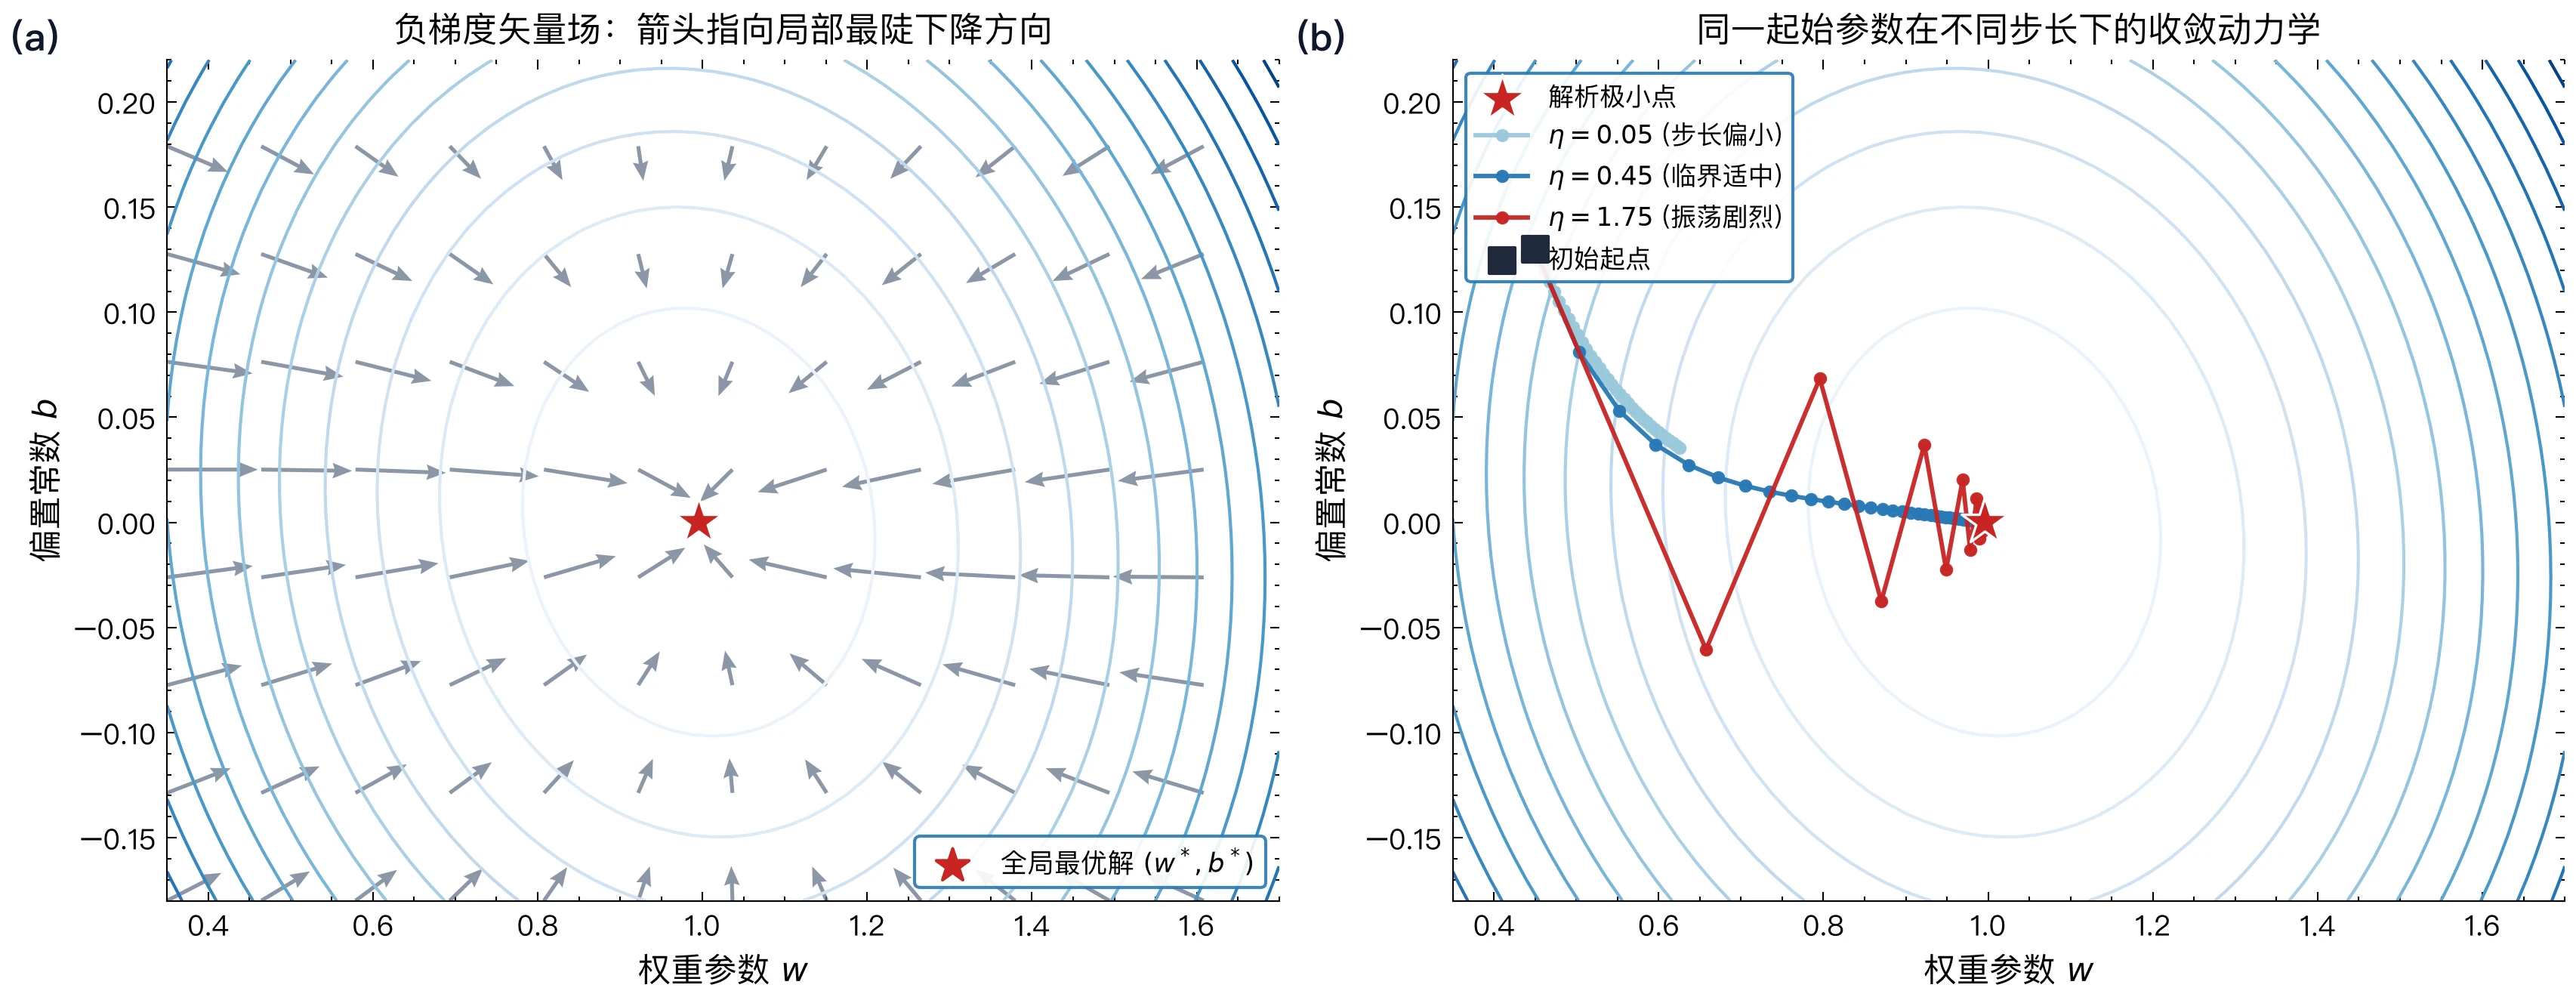
一次更新只利用当前位置附近的信息,并不知道最优参数在哪里。图 7 的“浓雾中下山”可以帮助理解这一点,但比喻不能替我们决定步长;下一节要观察学习率过小和过大时分别发生什么。
2.3 让训练稳定进行
2.3.1 学习率:一次调整多少
同样的梯度,乘上不同的学习率,会得到不同幅度的参数更新。学习率很小时,每一步变化不大,训练可能需要很久;适当增大它,通常能更快接近最优参数;再增大到超过稳定范围,就可能在两侧越跳越远。
初始点
快捷设置
数据:64 个样本,参数 (w, b)
η · λ_max0.90单调收敛
收缩因子 |1−ηλ|0.10 / 0.89陡岭 / 平缓方向
Hessian 特征值3.39 / 0.41κ = 8.3
超额损失降到 10⁻⁶60 步
均方误差的参数曲面椭圆为等损失线,前 60 步轨迹
梯度下降轨迹 特征方向
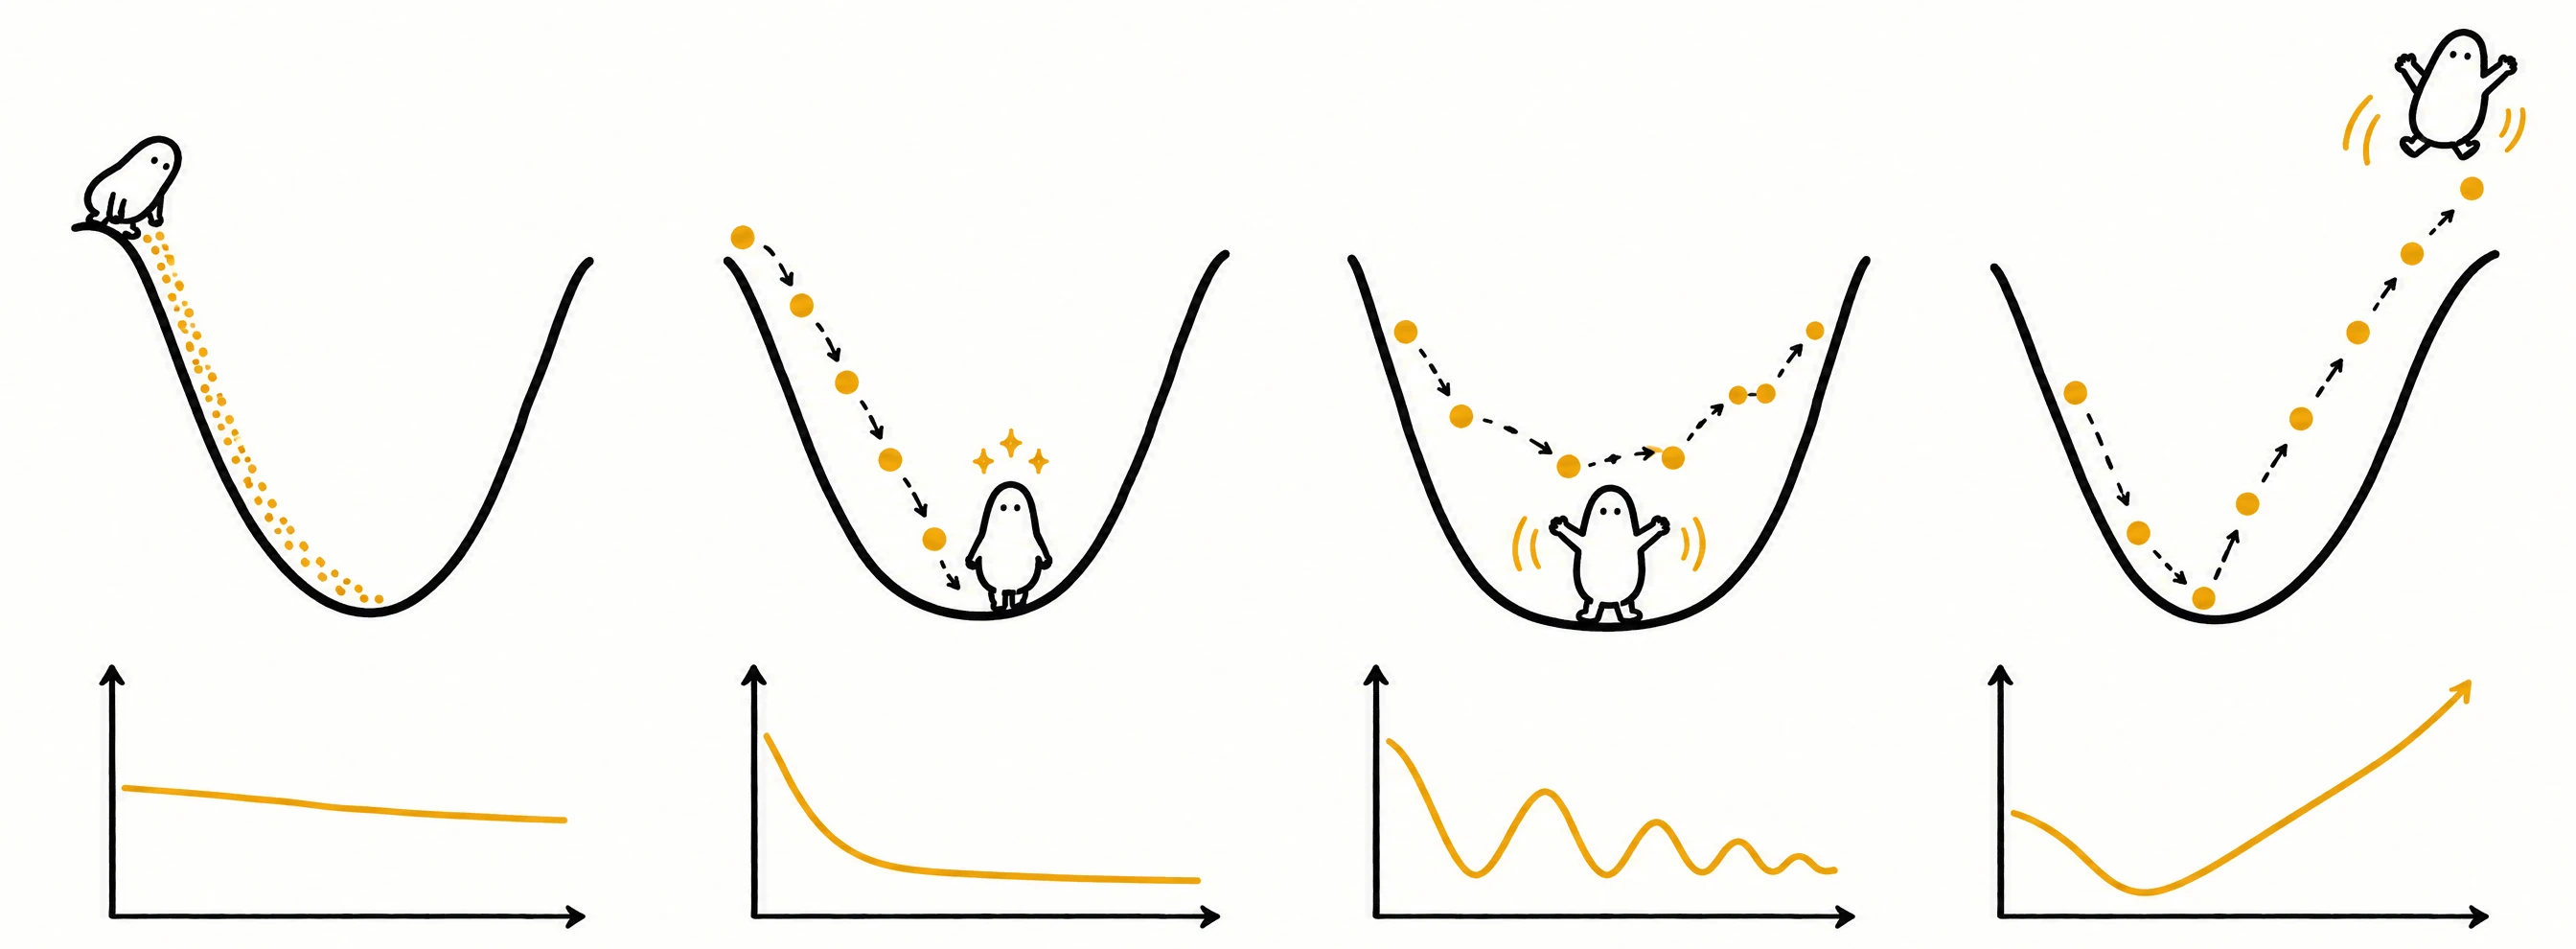
回到 Arrhenius 拟合,我们可以记录每一步的损失。若损失快速增大或出现数值溢出,应先检查公式与数据,再减小学习率;若损失缓慢下降,需要结合输入的数值范围判断原因;若损失基本不再下降,还要检查梯度是否已接近零,不能仅凭“变化很小”就认定已经求到最优解。
“来回跨过最优点”和“损失上下波动”是两件不同的事。对于本章的批量线性最小二乘,在合适的学习率下,参数可以左右摆动,而每一步的损失仍然下降。附录 B.4 用一个可计算的例子解释这种现象。
同时观察预测直线和平方损失,跟随同一组参数更新。
观测当前预测
平方损失
w=-0.5,b=-1;L=8.271。
思考与说明
思考学习率变大后,前几步残差是否仍然逐步减小?
五个无量纲合成观测;L=Σ(wx+b−y)²/(2N),使用全批量梯度。
2.3.2 标准化:让输入更适合计算
学习率已经调小,训练却仍然很慢,这时要检查输入的数值范围。Arrhenius 拟合中的 约为 0.003;它每次都乘在斜率的梯度里,而截距的梯度没有这一因子。同一个学习率因此不容易让两个参数都调整得合适。
把横坐标改为 会改善数值尺度,但这些数仍聚集在 3 左右,变化范围很窄。此时斜率和截距的变化容易互相抵消:略微改变斜率,再调整截距,也可能得到一条差不多的线。仅仅把数值放大,还没有充分改善这个问题。
常用的处理是 Z-score 标准化:对一列输入先减去均值,再除以标准差:
是这一列的平均值, 是它的标准差。减去均值后,数据围绕零分布;除以标准差后,输入的变化幅度被调整到相近尺度。有多个特征时,对每一列分别计算自己的均值和标准差。常数特征的标准差为零,需要单独处理,不能直接相除。
标准化是在改变计算所用的坐标。对于带截距、没有正则化的线性拟合,它不改变能够表示的预测关系,但会改变参数的数值和梯度下降的路径。
如果在标准化坐标 中拟合到 ,代回原始坐标便得到
计算活化能之前,必须先把斜率还原到实际采用的横坐标。 若原始横坐标为 ,还原后再使用 。2.4 节的程序会把这两步明确写出来。
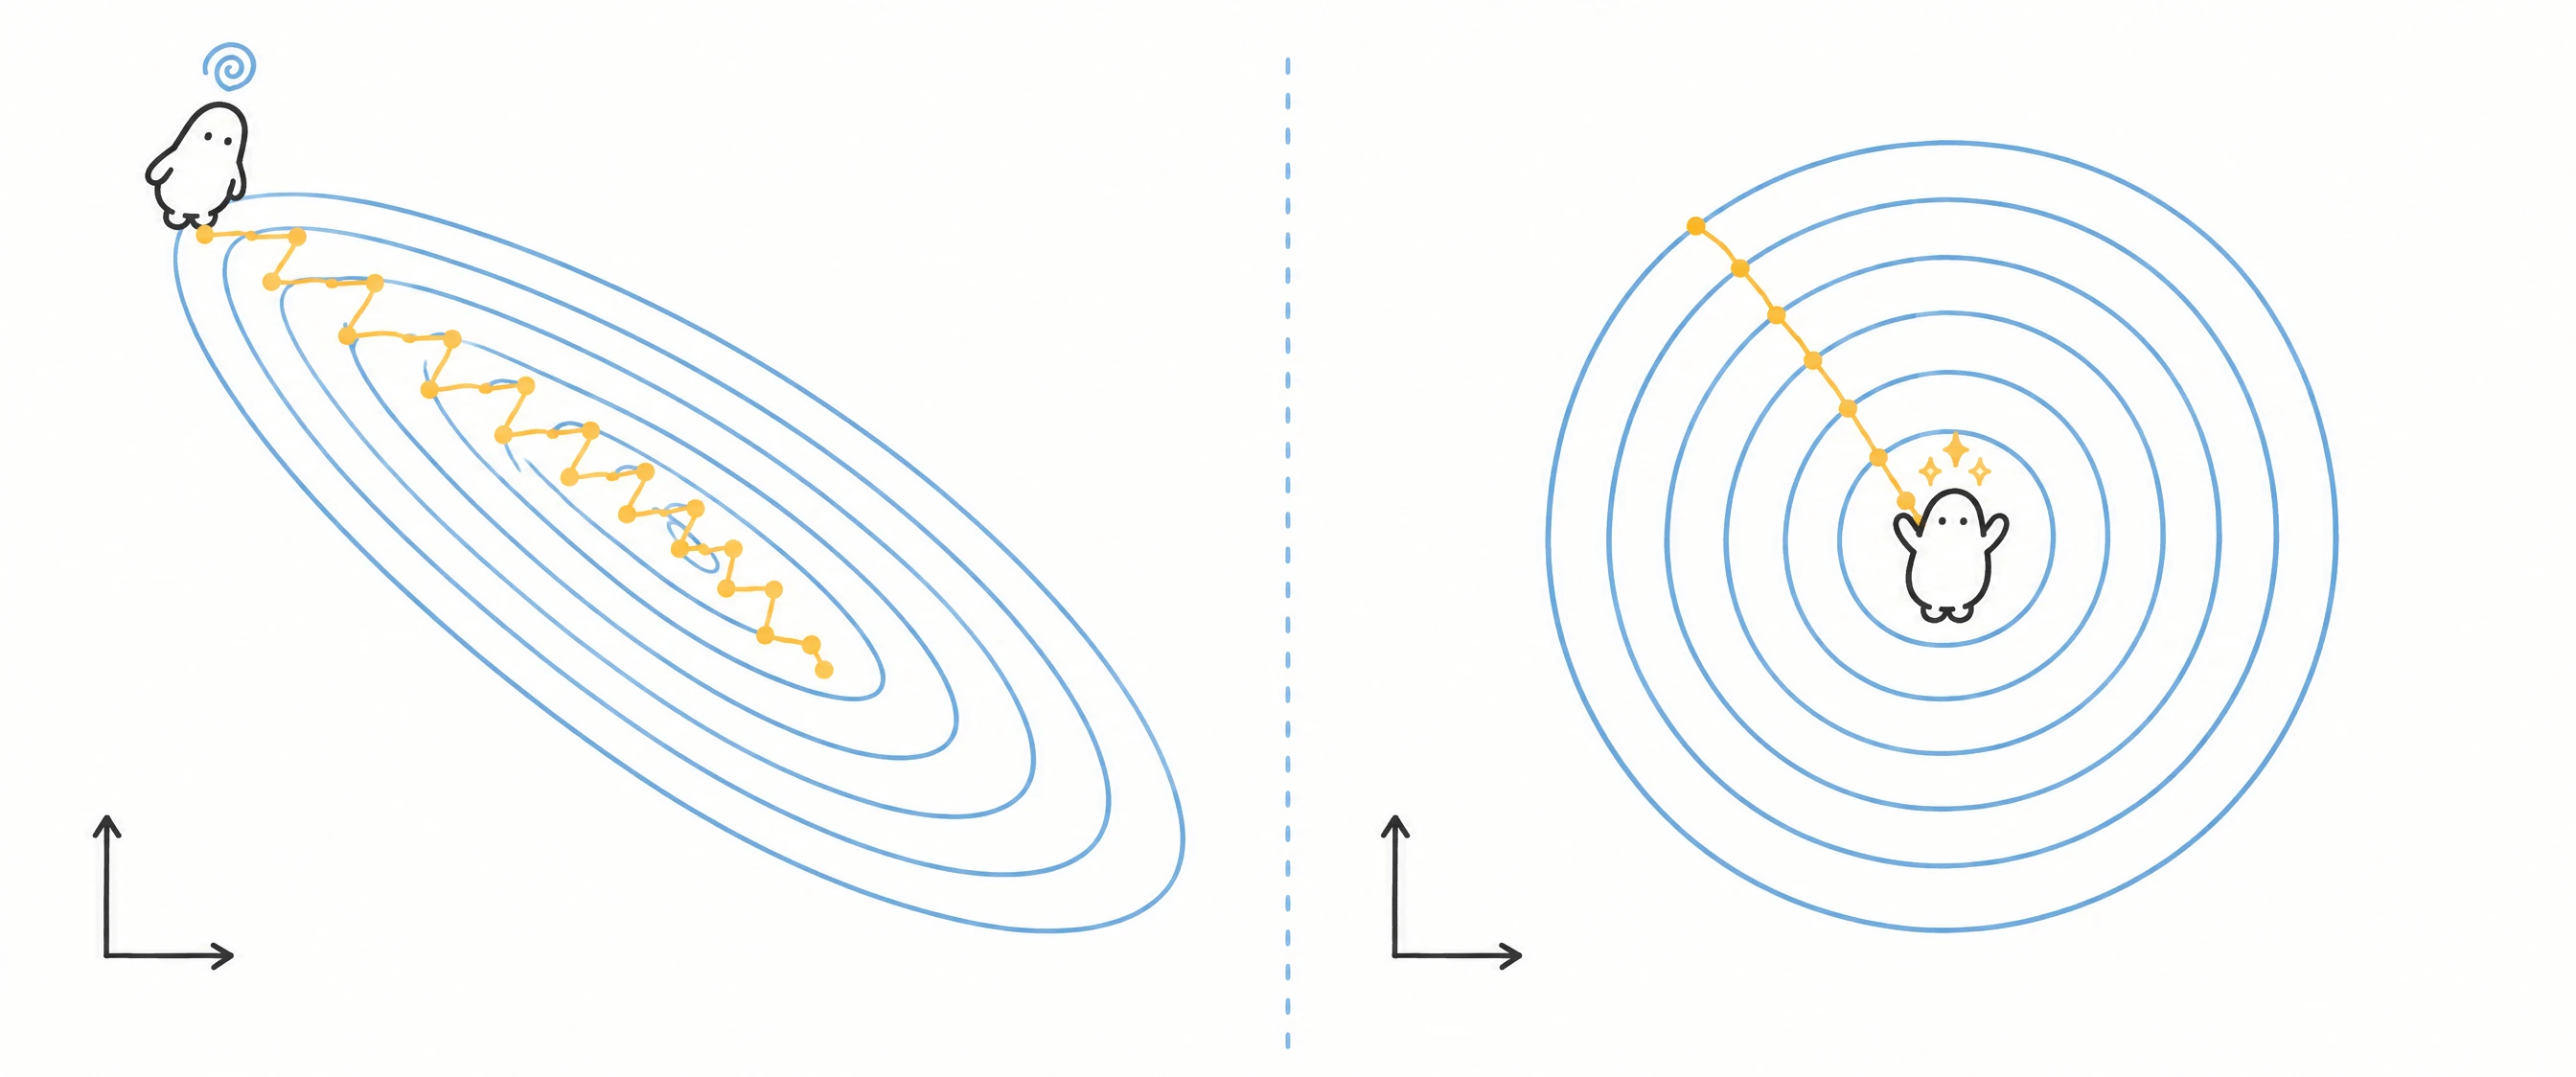
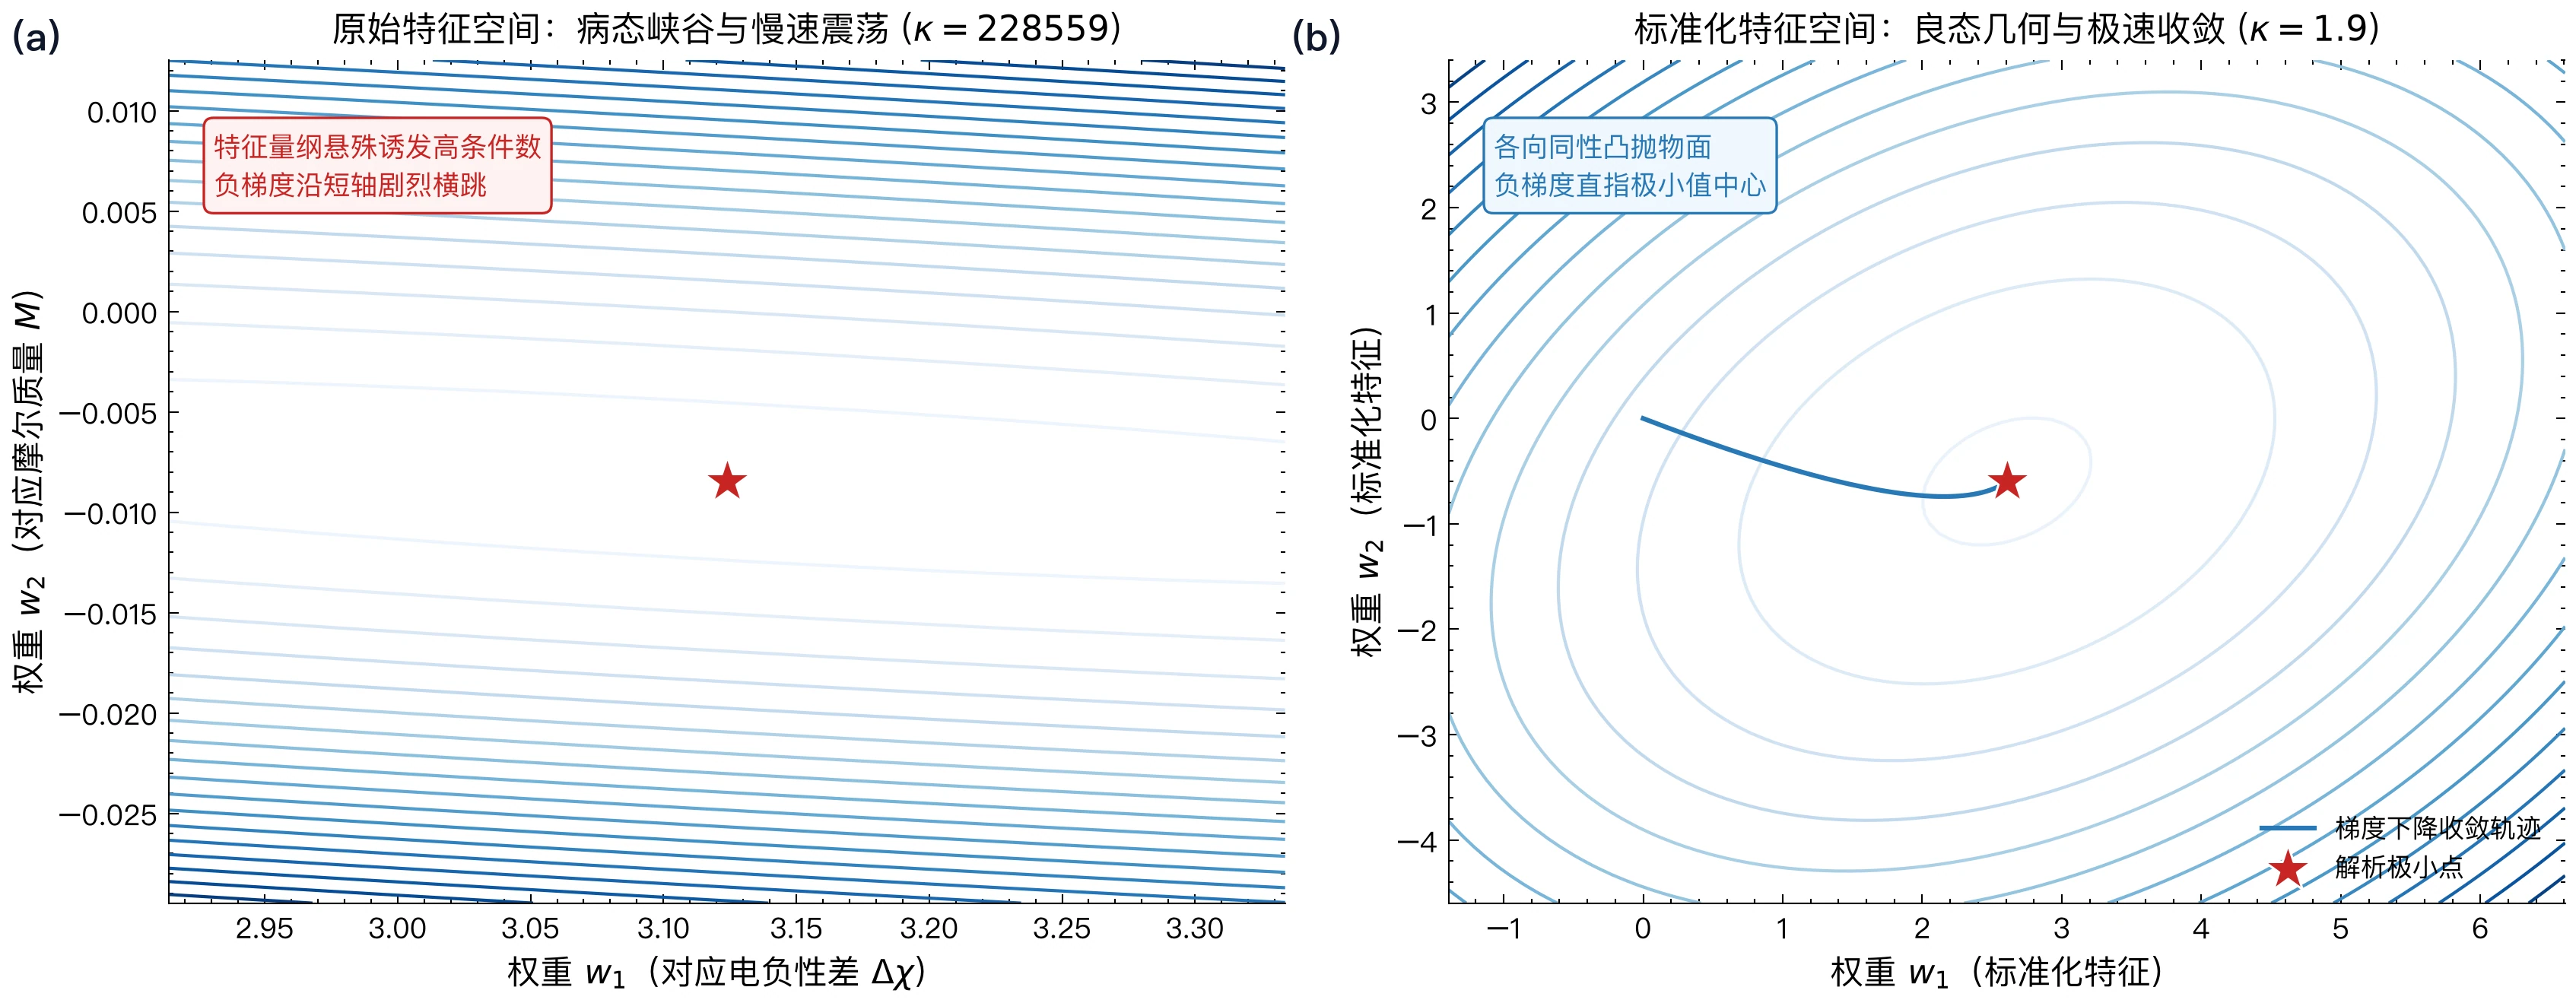
在这组带隙数据中,电负性差的数值为 0~3.2,摩尔质量约为 25~335 g/mol。两个特征直接一起使用时,损失曲面很狭长;标准化后,两个方向的计算尺度更接近。但如果两个描述符几乎提供同一条信息,即使标准化也无法消除这种重复,后面的岭回归会处理这类问题。
特征预处理
数据:80 个样本
κ(原始)452
κ(标准化)2.11只剩相关性贡献
误差降到 10⁻⁶ 所需迭代3,120 → 14原始 → 标准化
最优学习率 2/(λ₁+λ₂)2.56e-3
原始特征的损失曲面等比例坐标,从原点出发,使用最优学习率
原始 标准化
划分训练集和测试集后,均值与标准差只能从训练集计算,再原样用于测试集。这样才能模拟实际预测:遇到新材料时,我们使用已经确定的数据处理步骤。
2.3.3 多个描述符:从直线到矩阵写法
一个输入已经足以表示 Arrhenius 关系。预测带隙时,我们可能同时使用电负性差、平均电负性、平均共价半径和摩尔质量。将每个输入乘以各自的权重,再相加,便得到多元线性单元:
其中 称为权重向量(weight vector),标量 称为**偏置(bias)**或截距。图 3 把式 (9) 画成了一张计算流程图。
这里 是特征数, 是第 个输入, 是它对应的系数。 只是 的紧凑写法。给定一份数据,训练时仍然只调整各个权重与截距。
把所有样本整理成一张表:每行是一种材料,每列是一个描述符。这张表在数学上叫设计矩阵,记为 ;它有 行、 列。所有实测值组成向量 ,全部预测便可以一起写成
其中 是元素全为 1 的 维列向量。式中第二个等号用到了一个常用技巧:在设计矩阵右侧补上一列 1,得到增广设计矩阵 ,同时把偏置并入参数向量,得到增广参数向量 :
这样,偏置 就可以看作一个“输入恒为 1 的特征”所对应的权重,后面的推导因此可以统一处理 和 。
引入 后,只是把原来的所有权重与截距合在一个参数向量里,并没有增加新的待拟合量。残差与损失也可以用同样紧凑的方式表示:
其中 就是把所有残差平方后相加。先前的一元问题与这里使用的是同一种损失。
求梯度时,仍然沿用 2.2.3 节的链式法则,只需把横坐标换成第 个特征:
由于 ,它对 的偏导数为 。代入上式得
同理,偏置 对应的“输入”恒为 1,于是
即偏置的梯度等于平均残差的相反数。由此可以得到一个有用的推论:在损失的极小点处 ,即平均残差为零——带截距的最小二乘拟合,其预测值在训练集上的平均值恰好等于实测值的平均值。
把 个偏导数写成一个向量,就得到梯度的矩阵形式:
式 (17) 可以按“计算残差,再把残差与对应特征相乘、求平均,最后取相反数”来读。单个样本的贡献既取决于残差,也取决于特征值,不能只凭残差大小判断它对参数的影响。
用参数向量表示更新规则,就是
上标 表示第几次更新。这个式子把 2.2.4 节对斜率和截距的两次更新写在了一起,算法本身没有改变。
2.3.4 损失曲面:训练在什么地方寻找最优解
图 5 已经区分了数据图和参数图。现在把每组参数的损失值画成高度,就得到了损失曲面。一元模型有斜率和截距两个参数,因此可以画成三维图;更多参数时,含义相同,只是无法直接完整画出来。
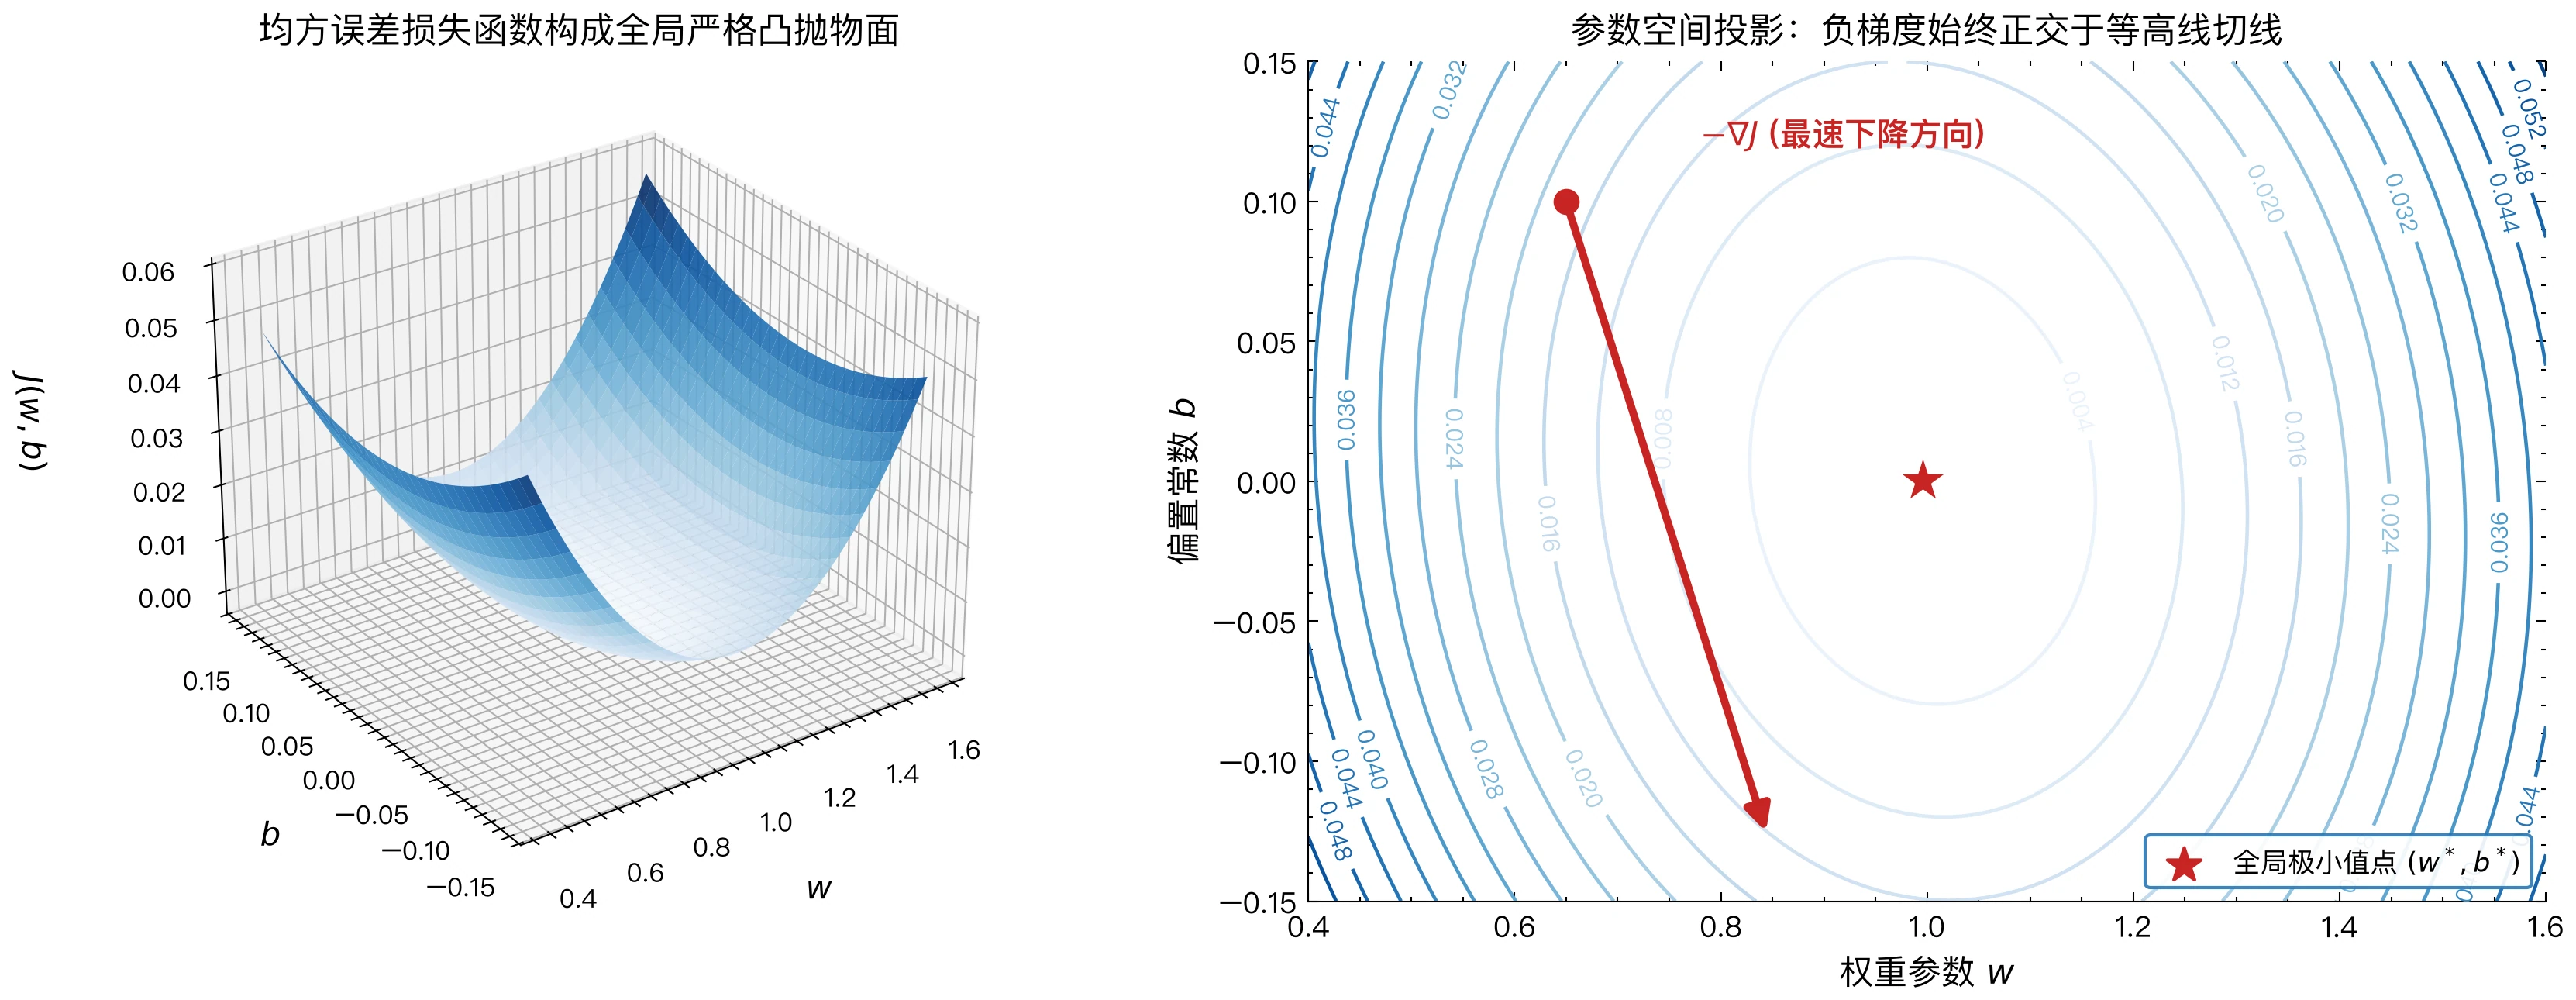
对本章的线性模型和平方误差,这个曲面是凸的:不会出现一个较浅的局部最低点,把优化过程困在那里,而其他地方还藏着更低的点。只要学习率合适,批量梯度下降就能逼近全局最小损失;如果特征和常数项之间不存在严格的线性依赖,最优参数还是唯一的。
有两点需要分开理解。第一,最小损失不一定为零,因为实验噪声或模型形式的局限都可能留下残差。第二,找到最小损失只说明这组训练数据已经拟合到位,并不保证对新材料预测准确。后面的带隙和烷烃案例会检验第二点。
如果把同一个特征输入两次,两个权重可以互相补偿,因此可能有多组参数给出同样的预测。2.5.3 节中指数取 的情况就是这样。用 Hessian 矩阵描述这些曲率和唯一性问题的推导放在附录 B.3。
2.3.5 每次使用多少数据:批量、随机与小批量
式 (17) 的梯度需要对全部 个样本求和。当数据量很大时,每走一步都要遍历全部数据,代价很高。根据每次更新所用的样本数,梯度下降可以分为三种形式:
批量大小 B
数据:64 个样本
每轮更新次数16共 192 次
梯度噪声 trΣ/B0.219
最后一轮平均超额损失7.8e-3噪声平台
η · λ_max0.34
小批量梯度的随机轨迹每步用 B 个样本估计梯度
参数轨迹 / 超额损失
- 批量梯度下降(batch gradient descent,BGD):每次用全部 个样本计算梯度。方向准确,但每轮(遍历一次数据,称为一个 epoch)只更新一次参数。
- 随机梯度下降(stochastic gradient descent,SGD):每次随机取 1 个样本,用它的梯度近似全体的梯度。每轮更新 次,单次计算便宜,但方向噪声大。附录 B.1 的式 (44) 就是这种形式。
- 小批量梯度下降(mini-batch gradient descent):每次取 个样本(常取 16~256),每轮更新约 次,在方向准确性与更新频率之间折中。
在每步独立、均匀抽样的条件下,单样本或小批量梯度的平均结果等于全量梯度,称为无偏估计,但每次估计会有波动。配套程序采用每轮打乱数据再分批的方式,目的同样是避免总按固定顺序更新。图 13 直观地展示了三者路径的差异,图 14 则概括了三者的数据流。
那么在实际问题中谁更省?图 15 和表 3 给出了在 73 种化合物带隙数据(4 个标准化特征)上的实测结果,对应附录 B.7 的批量大小实验。评价时需要先明确“省”的含义,这里同时统计两个量:参数更新次数,以及单样本梯度计算量(计算一个样本的梯度记为 1 次;批量梯度下降更新一次需要 次)。
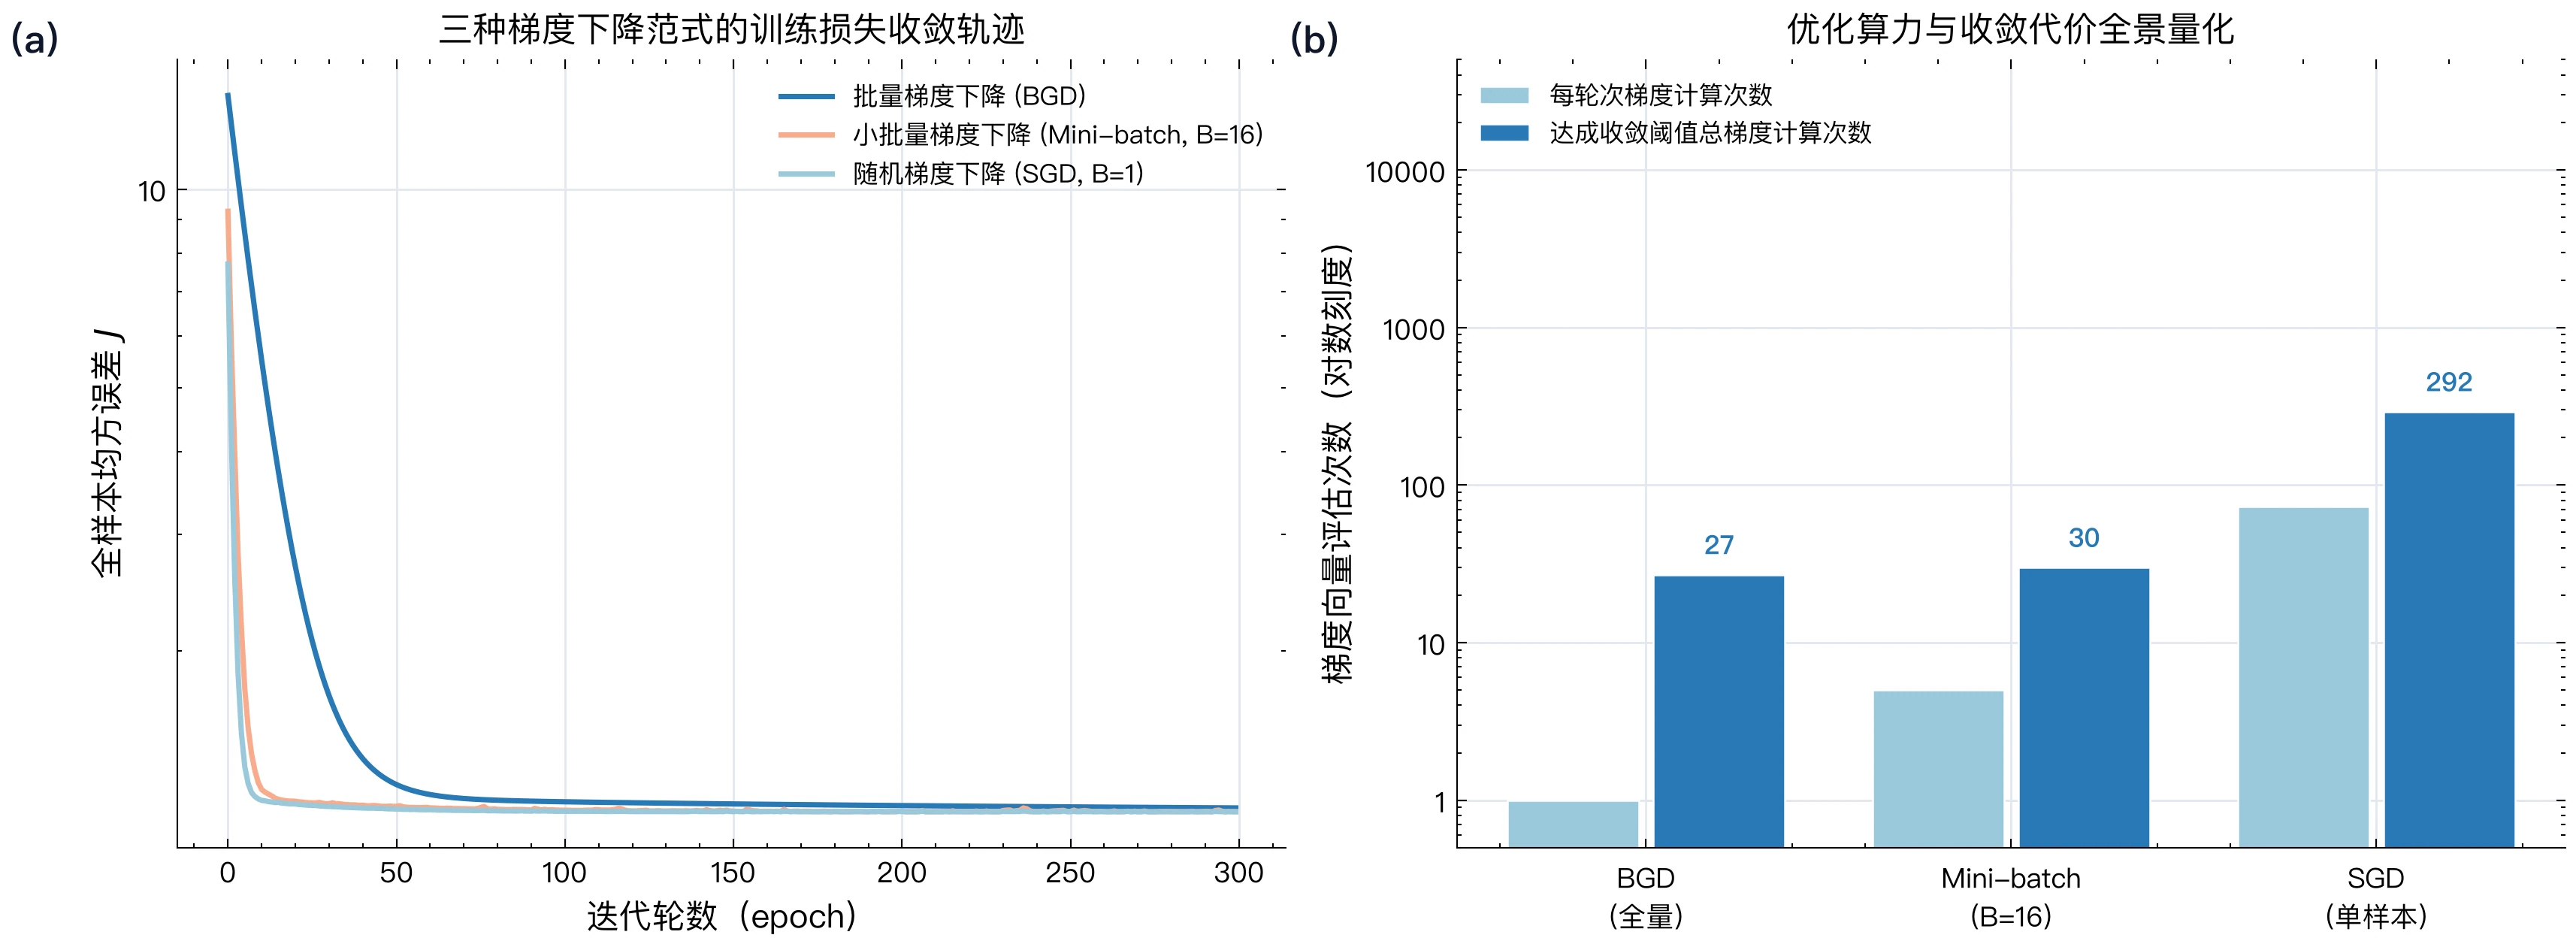
表 3 带隙数据上三种梯度下降达到 所需的开销
| 方法 | 每轮更新次数 | 达标所需轮数 | 参数更新次数 | 单样本梯度计算量 | 300 轮后的损失 |
|---|---|---|---|---|---|
| 批量() | 1 | 27 | 27 | 1971 | 1.1577 |
| 小批量() | 5 | 6 | 30 | 438 | 1.1428 |
| 随机() | 73 | 4 | 292 | 292 | 1.1422 |
从表 3 可以读出三点:
- 按遍历数据的次数(或单样本梯度计算量)衡量,随机与小批量方法更省。 它们每轮更新多次,只需 4~6 轮就达到目标,而批量方法需要 27 轮。这是这次实验在给定目标损失与学习率下的结果;换一组数据或更严格的精度要求,比较结果也可能变化。
- 随机方法的代价是噪声。 在这组数据和参数设置下,随机梯度下降使用较小的学习率保持稳定;固定学习率会让参数在极小点附近波动,后期降低学习率可以减小这种波动。
- 计算量不等于实际耗时。 在 NumPy、PyTorch 等向量化数值库中,一次全量梯度可以高度并行,耗时远小于逐个样本计算之和。小批量方法兼顾了“更新频繁”与“充分利用并行硬件”,因此成为深度学习的默认选择。
对于本章这类只有几十到几千个样本、几个到几十个特征的线性问题,直接求解 2.3.6 节的正规方程往往最简单可靠。
2.3.6 已有直接解,为什么还要学梯度下降
对于本章这样的线性最小二乘问题,可以令梯度为零,直接求解一个线性方程组:
式 (19) 称为正规方程(normal equation)。当 可逆时,
正规方程还可以解释最优残差的性质。把式 (19) 移项,得到
即最优残差向量 与 的每一列都正交。换句话说,在 维的“样本空间”中,最小二乘的预测值 恰好是观测向量 在 列空间上的正交投影。由于常数列 是 的一列,式 (21) 也包含了 2.3.3 节的结论:残差之和为零。
“残差与每一列正交”的意思是,在最小二乘解处,残差与任何已有特征列的内积都为零。这个几何解释可以留待理解矩阵后再读。实际使用时,先记住两件事:小规模线性问题可以直接求解;直接解还可以用来核对梯度下降是否已经收敛。
数据
κ(XᵀX)16.0
梯度下降达 10⁻⁶ 的迭代106理论 111
正规方程 flops2.0e+4
梯度下降 flops4.2e+5正规方程更省
迭代解逐步逼近解析解梯度下降使用最优学习率 2/(λ_max+λ_min)
‖wₜ−w*‖/‖w*‖ 正规方程
表 4 正规方程与梯度下降的比较
| 比较项目 | 正规方程 | 梯度下降 |
|---|---|---|
| 求解方式 | 求解式 (19) 的线性方程组 | 按式 (18) 迭代,逐步逼近 |
| 超参数 | 无 | 学习率、迭代次数、批大小等 |
| 计算量 | 构造 需 ,求解需 | 每步 (批量)或 (小批量),共 步 |
| 内存 | 需存储 矩阵, | 除数据外只需存储参数与梯度, |
| 数值稳定性 | ,病态时误差放大;实践中可直接对设计矩阵做 QR 或 SVD 分解 | 病态时收敛很慢,也会受到浮点精度限制 |
| 适用范围 | 仅限线性最小二乘(及岭回归等少数变体) | 可推广到逻辑回归、神经网络等任意可微模型 |
| 适用场景 | 特征数较少(如 在数千以内)的线性回归 | 特征数或样本数很大的问题,以及适合梯度优化的非线性模型 |
从表 4 可以看出:对于本章的化学案例(几个特征、几十个样本),正规方程又快又准,第 2.5.2 节的实测也表明两者给出的参数相差不到 。梯度下降的真正价值在于它的通用性——第 3 章将沿用这种根据梯度迭代更新参数的思路来训练神经网络。
式 (20) 的逆矩阵写法用于说明数学关系。程序中通常求解方程组,不必显式构造逆矩阵。配套代码保留了手写高斯消元,方便检查每一步;面对数值条件较差的数据,应使用成熟数值库中的最小二乘求解器。
2.3.7 动量与正则化:分别解决什么问题
经过标准化,训练仍可能遇到两种困难:一种是参数更新进展缓慢;另一种是许多组相差很大的权重都能给出相近的预测,导致参数不稳定。动量与正则化分别针对这两类问题。
动量保留前几次更新的方向。 如果某个方向连续几步都需要调整,就积累更多变化;如果方向反复变号,累积的变化会部分抵消。Polyak 的重球法 [3] 用一个“速度”变量表示这种记忆:
其中 是动量系数,常用值为 0.9; 时回到普通梯度下降。动量可以加速某些问题,但学习率与动量系数仍需配合选择。它改变参数更新的过程,不改变原来的拟合目标。
L2 正则化(岭回归)。 当特征之间高度相关时, 接近奇异,最小二乘的权重会对数据中的微小扰动极为敏感,甚至出现数值很大、符号相反的一对权重相互抵消。一种常用的补救办法是在损失中加入权重的平方和作为惩罚项:
这就是岭回归(ridge regression)[4], 是正则化强度(注意与特征值的符号 相区别)。通常不对截距 施加惩罚。正则化项有两个效果:
正则化改变了我们的选择标准:在减小拟合误差的同时,也避免权重过大。对于高度相关的描述符,这能减少“大正权重与大负权重相互抵消”的情况。通常先标准化特征,再讨论同一个惩罚系数的作用。
式 (23) 的梯度比原来多出 ,在普通梯度下降中会把权重向零拉回。截距通常不受惩罚。这个做法称为 L2 正则化,对应的线性模型称为岭回归。
惩罚过强会让模型接近始终预测平均值。因此, 应根据验证集或交叉验证来选择。训练集误差本身不能告诉我们哪种惩罚强度更有利于新数据;2.5.2 节给出的权重收缩和训练指标,仅展示正则化如何影响拟合,不等于已经验证了泛化收益。
2.4 Python 实现:先跑通一次拟合
2.4.1 从公式到最小程序
下面的程序只依赖 Python 标准库。它使用表 1 的五个实验点,先标准化横坐标,再重复 2.2 节的四个步骤。读代码时,把 predictions 对应到预测值,把 residuals 对应到残差,把 grad_w、grad_b 对应到两个偏导数即可。
不需要先理解类、矩阵求解器或化学式解析器,就能运行这个程序。完整文件是 minimal_arrhenius.py。
python
"""用五个速率常数拟合 Arrhenius 直线;仅依赖 Python 标准库。"""
import math

temperatures = [298.15, 308.15, 318.15, 328.15, 338.15]  # K
rate_constants = [3.46e-5, 1.35e-4, 4.98e-4, 1.50e-3, 4.87e-3]  # s^-1
x = [1000.0 / T for T in temperatures]
y = [math.log(k) for k in rate_constants]  # k 已按 s^-1 给出数值
m = len(x)

# 先把横坐标标准化,目标值仍使用 ln(k / s^-1)。
mean_x = sum(x) / m
std_x = math.sqrt(sum((xi - mean_x) ** 2 for xi in x) / m)
xs = [(xi - mean_x) / std_x for xi in x]

w_scaled, b_scaled = 0.0, 0.0
learning_rate = 0.1
for step in range(201):
    predictions = [w_scaled * xi + b_scaled for xi in xs]
    residuals = [yi - pi for yi, pi in zip(y, predictions)]
    loss = sum(ri ** 2 for ri in residuals) / (2 * m)
    if step in (0, 1, 2, 10, 50, 200):
        print(f"第 {step:3d} 步:J = {loss:.6f}")
    if step == 200:
        break
    # 两个梯度都用更新前的参数计算。
    grad_w = -sum(ri * xi for ri, xi in zip(residuals, xs)) / m
    grad_b = -sum(residuals) / m
    w_scaled -= learning_rate * grad_w
    b_scaled -= learning_rate * grad_b

# 还原为横坐标 1000/T 下的斜率、截距,再换算物理量。
w = w_scaled / std_x
b = b_scaled - w * mean_x
R = 8.314  # J/(mol K)
Ea_kJ_mol = -1000.0 * R * w / 1000.0  # 最后除以 1000 将 J 换为 kJ
A = math.exp(b)
print(f"斜率 = {w:.3f},截距 = {b:.3f}")
print(f"活化能 = {Ea_kJ_mol:.1f} kJ/mol,指前因子 = {A:.2e} s^-1")2.4.2 怎样读运行结果
运行后,先观察损失是否逐步降低,再看还原后的斜率和截距。最后得到的斜率约为 ,截距约为 31.365,换算出的活化能约为 103.2 kJ/mol,指前因子约为 s⁻¹。
程序中的 w_scaled 是标准化坐标下的系数,不能直接代入活化能公式。还原成 对应的斜率后,才进行物理量换算。这也解释了为什么标准化可以让计算更方便,却不能省略单位与坐标的检查。
可以先保持其他设置不变,只修改 learning_rate,比较损失下降速度。如果再去掉标准化,也要重新考察合适的学习率。比较时应使用同一组数据和明确的迭代次数,避免把算法设置不同造成的差异误认为模型本身不同。
2.4.3 完整实现与案例程序
正文中的最小程序展示了训练的核心。研究案例还需要多个特征、数据划分、指标计算与残差分析,这些工具放在 revised_code/ 中。原有八个完整代码清单已整理为以下文件,所用数据与算法实现一并保留。
表 5 配套代码与阅读入口
| 文件 | 内容 | 建议何时阅读 |
|---|---|---|
| minimal_arrhenius.py | 一元模型的预测、梯度、更新及参数还原 | 第一次学习本章时 |
| linear_unit.py | 原代码清单 2-1~2-3:向量运算、LinearUnit、缩放、直接求解、梯度校验与数据划分 | 理解最小程序后,按需要查函数 |
| chem_data.py | 原代码清单 2-4:元素性质、化学式解析与本章数据 | 阅读带隙与其他案例时 |
| demo_playground.py | 原代码清单 2-5:学习率、缩放与批量大小实验 | 比较不同训练设置时 |
| demo_arrhenius.py | 原代码清单 2-6:活化能、横坐标比较与汽化焓 | 2.5.1 节 |
| demo_bandgap.py | 原代码清单 2-7:带隙拟合、残差、权重与数据划分 | 2.5.2 节 |
| demo_alkane.py | 原代码清单 2-8:沸点拟合与外推 | 2.5.3 节 |
进入 revised_code/ 目录后,可以运行:
bash
python3 minimal_arrhenius.py
python3 demo_arrhenius.py
python3 demo_bandgap.py
python3 demo_alkane.py这些程序仅依赖 Python 标准库。工具函数如何对应公式、如何检查手写梯度,以及数据的使用说明,放在附录 B.7。完整运行方式见 配套代码目录说明。
2.5 案例研究:线性单元在化学与材料问题中的应用
前面已经用五个速率常数跑通一次拟合。现在回到研究问题:拟合出来的数字怎样解释,哪些检查能帮助我们判断结果是否可信?三个案例分别回答一个问题:
- 2.5.1 节是一元问题。经过变量变换,Arrhenius 方程恰好就是一个线性单元,我们借此从速率常数反求活化能,并再次观察特征缩放的作用;
- 2.5.2 节是多元问题。我们只用元素周期表上的描述符预测 73 种无机固体的带隙,重点讨论残差诊断、权重解读和数据划分;
- 2.5.3 节讨论外推。用短链烷烃训练、对长链烷烃预测沸点,比较不同特征的表现。
最后,2.5.4 节在三个案例的基础上,讨论线性基线模型在一项完整研究中所处的位置。
三个案例的完整程序位于 revised_code/,共用同目录下的 linear_unit.py 和 chem_data.py。每个案例先读问题、结果与解释,再按需要运行程序。
2.5.1 案例一:N$_2$O$_5$ 分解反应的 Arrhenius 活化能
2.5.1.1 问题与模型
N$_2$O$_5$ 的热分解:
是物理化学教材中讲解一级反应的经典例子。本案例使用 Daniels 与 Johnston 测定的气相速率常数 [6]:温度从 25 °C 升到 65 °C,速率常数 从 增大到 ,增大了约 140 倍。
2.1.2 节已将 Arrhenius 方程写成式 (1)。这里继续使用 、,因此斜率为 。先标准化输入完成训练,再把参数还原到这个横坐标下;下面报告的都是还原后的参数。
2.5.1.2 拟合结果
用梯度下降拟合 5 个数据点,得到 ,,。由斜率求活化能:
指前因子 。这一活化能与教材中常引用的 103.6 kJ/mol 相差约 0.4%。不过,5 个数据点的拟合本身存在不确定度,这一吻合程度不宜过度解读。图 18 展示了拟合结果。
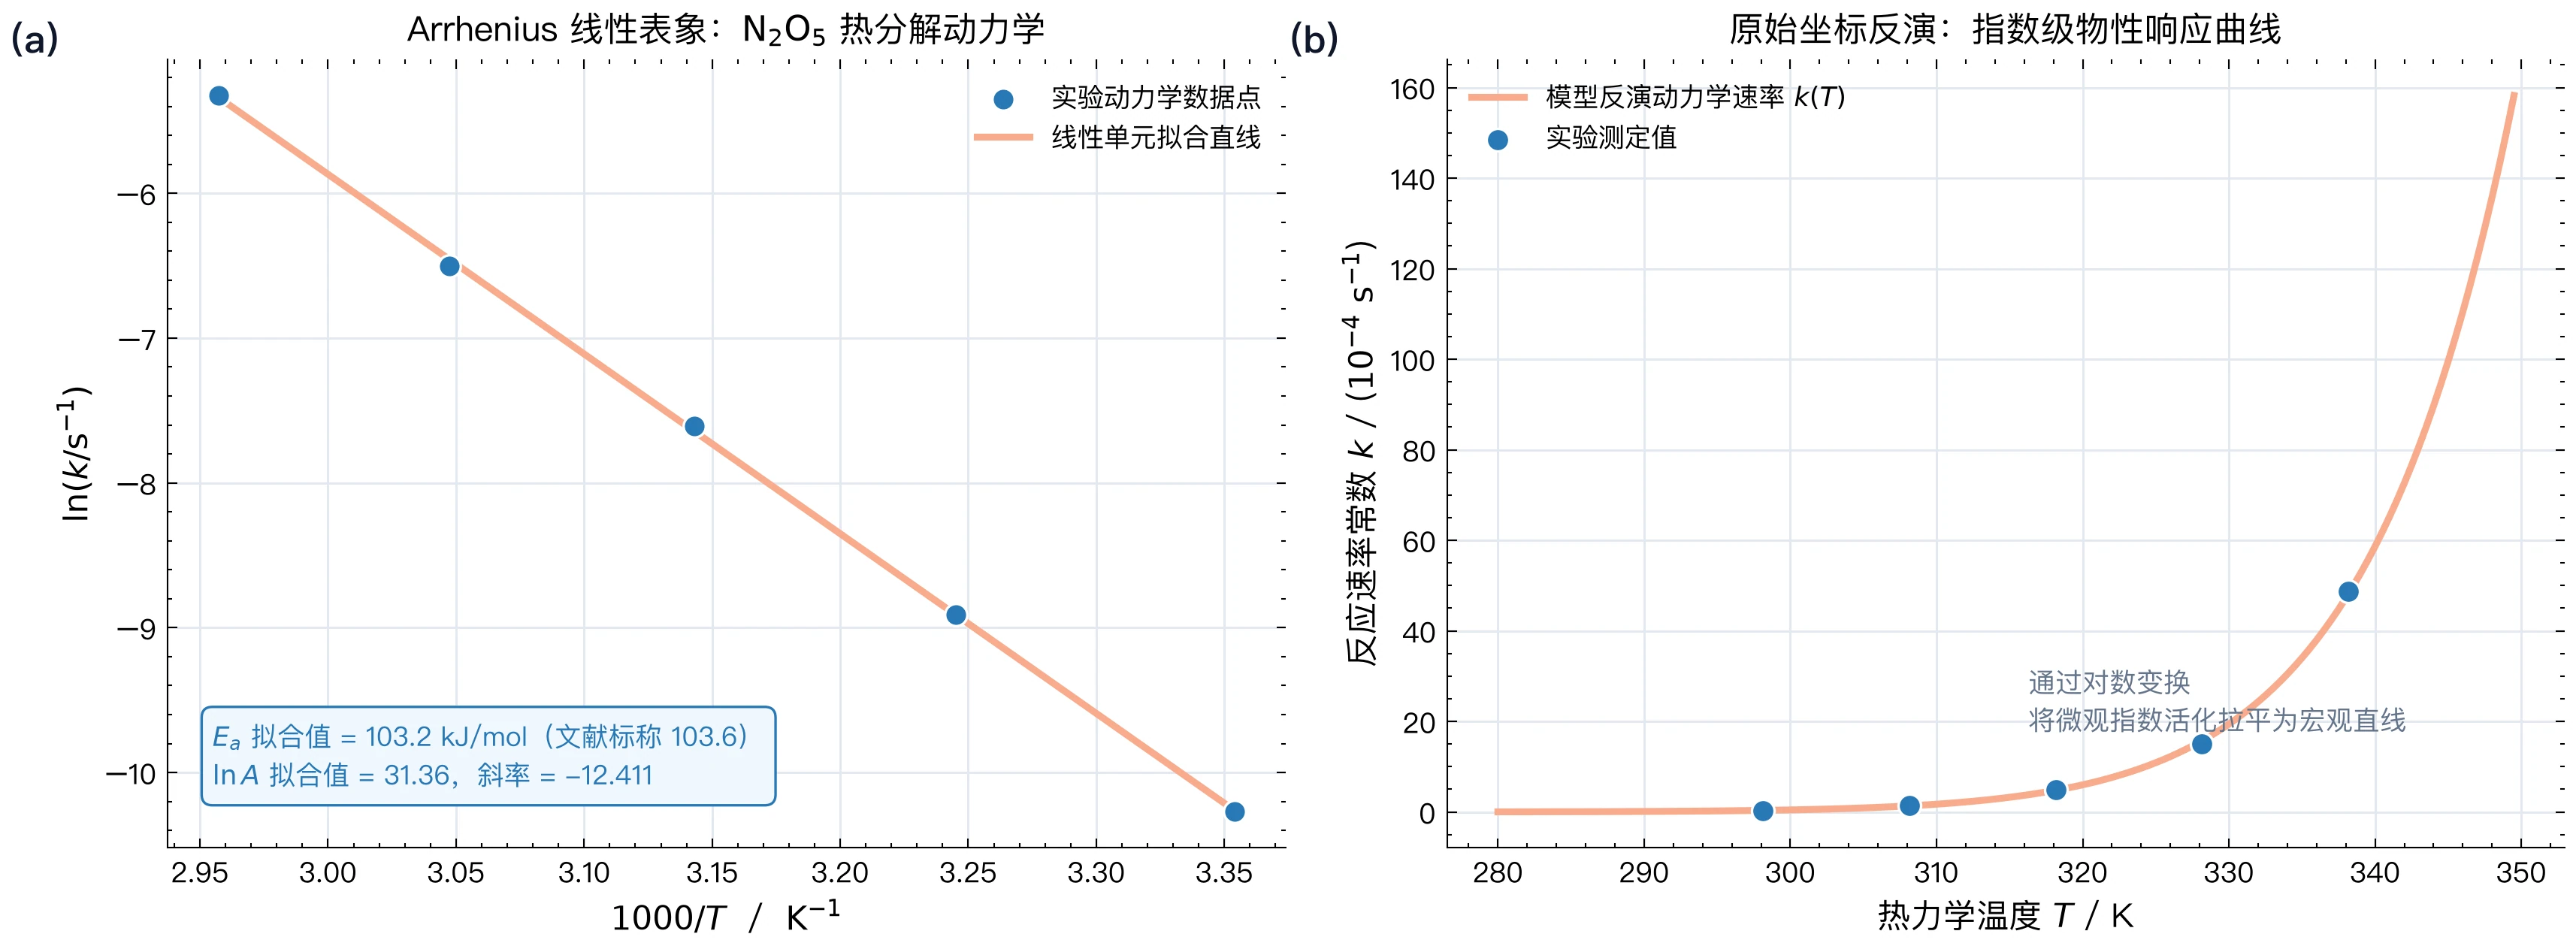
图 18 说明了一个在化学中反复出现的思路:许多看似非线性的规律,经过适当的变量变换后会变成线性关系。取对数、取倒数这类操作,在机器学习中分别称为“目标变换”和“特征变换”。
需要注意的是,取对数也改变了误差的结构。对 做最小二乘,相当于假定各点 的相对误差大致相同;如果实验误差主要是绝对误差(例如低温下 很小时测量误差占比更大),更合理的做法是加权最小二乘,或者直接对 做非线性拟合。
2.5.1.3 横坐标的选择与条件数
为什么化学家习惯用 而不是 作横坐标?最直接的原因是读数方便:,而 。从 2.3.2 节的角度看,这个选择还会影响梯度下降的收敛。表 6 比较了三种横坐标表示:直接用 、用 、以及把 标准化。每种表示都在若干学习率中挑选效果最好的一个,训练 5000 轮。
表 6 Arrhenius 拟合中横坐标表示对梯度下降的影响(5000 轮)
| 横坐标表示 | 条件数 | 最佳学习率 | 5000 轮后的 | |
|---|---|---|---|---|
| 1 | 1.52 | 0.0002 | ||
| 0.1 | 0.169 | 0.889 | ||
| 标准化的 | 1 | 1 | 0.9997 |
标准化后一元问题的学习率取 1 可以一步到达最小二乘解。训练到 5000 轮时,多个学习率会得到浮点精度内相同的损失,因此配套程序扫描时也可能返回 0.5;这不影响表中关于横坐标处理的比较。
这张表把 2.3.2 节的直观解释变成了数值结果。先看损失和 两列,再看条件数如何描述计算难度;需要详细推导时可读附录 B.5~B.6。三种情形分别是:
- 直接用 。 斜率方向的曲率约为 ,截距方向的曲率约为 1,条件数高达 。学习率受截距方向限制,不能超过 2 左右,而在这样的学习率下斜率几乎不动,5000 轮后 仍接近 0。
- 用 。 条件数降到约 ,但仍然很大。 的均值约为 3.15,标准差却只有约 0.14;在这个狭窄范围内,斜率变化很容易被截距变化抵消,因此两个参数仍难以协调调整。5000 轮后 仍不到 0.9。
- 标准化。 减去均值并除以标准差后,这个一元问题的两个参数方向具有相同曲率,条件数恰好为 1,梯度下降迅速接近直接求解的结果。矩阵形式 的推导见附录 B.6。
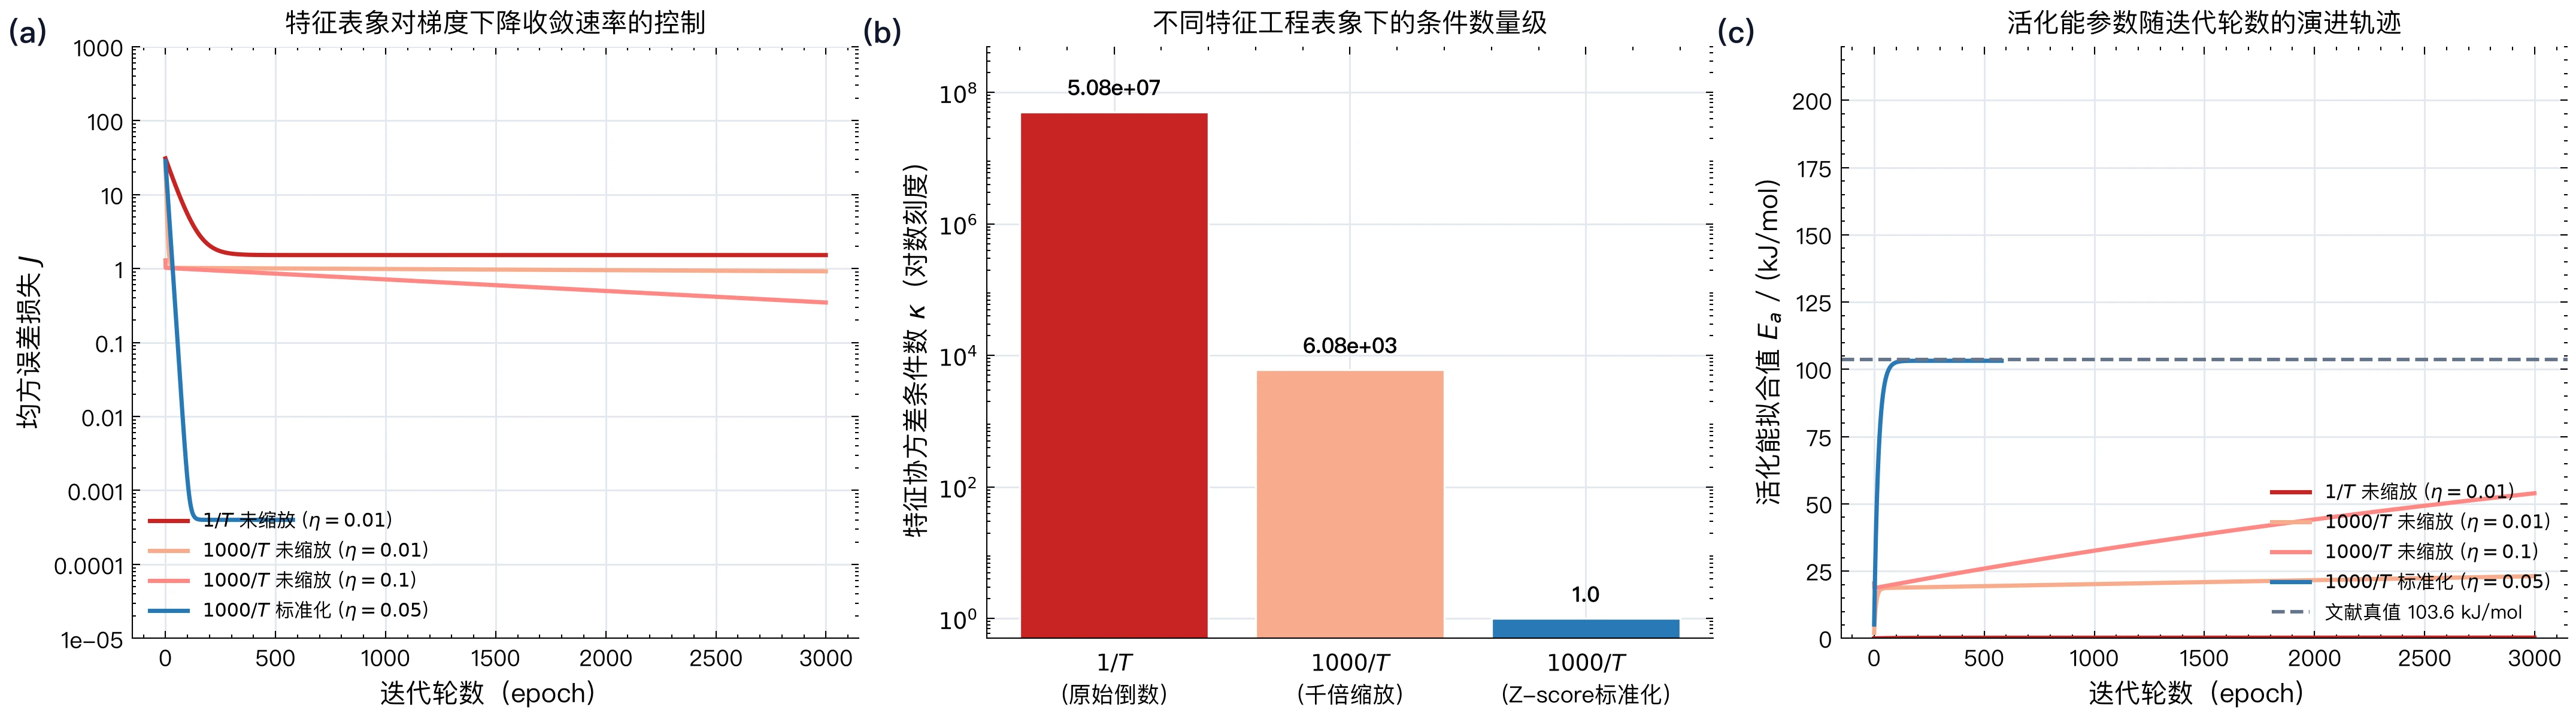
由此得到一个有用的结论:作图时用 是为了读数方便;对梯度下降而言,真正起作用的是中心化与缩放。仅仅乘以 1000 并不能消除病态。
2.5.1.4 推广:水的汽化焓
Clausius–Clapeyron 方程 与式 (1) 形式相同,因此同一段代码不加修改就可以用来由饱和蒸气压求汽化焓。用 0~100 °C 水的饱和蒸气压数据拟合,得到 kJ/mol()。
这个数值应当与什么比较?水的汽化焓随温度升高而减小:25 °C 时为 43.99 kJ/mol,100 °C 时为 40.65 kJ/mol。式 (1) 型的模型假定 与温度无关,因此拟合结果只是该温区内的一个有效平均值。这是“模型假设”与“物理实际”之间差异的一个简单例子,2.5.2 节将看到更显著的情形。
2.5.1.5 小数据集上的批量与随机梯度下降
2.3.5 节在 73 个样本的带隙数据上比较了三种梯度下降。在只有 5 个点的 Arrhenius 数据上,三种方法各训练 500 轮后,损失都在 附近,几乎没有差别。随机方法的优势只有在数据量很大时才会显现;对于如此小的数据集,直接求解正规方程最简单。
2.5.1.6 完整代码
demo_arrhenius.py 依次完成上述四项实验:Arrhenius 拟合与活化能计算、横坐标表示的比较(表 6)、水的汽化焓,以及小数据集上三种梯度下降的比较。
完整程序:代码清单 2-6:demo_arrhenius.py。
2.5.2 案例二:由元素描述符预测无机固体的带隙
Arrhenius 拟合中,我们事先知道输入应当取 ,也知道斜率对应活化能。带隙预测更困难:我们有一些可能相关的描述符,却没有一条已知方程告诉我们怎样组合它们。本节先建立一个简单模型,再用它的误差判断哪些信息还没有被描述。
2.5.2.1 数据与描述符
带隙 是半导体与绝缘体最重要的电子性质之一,决定了材料的光吸收边和导电行为。本节的数据集包含 73 种无机固体(以二元化合物为主,另含 Si、Ge 两种单质),按化学类别分为:I–VII 族(碱金属卤化物等)20 种、III–V 族 14 种、II–VI 族 14 种、主族氧化物 11 种、其他硫族化合物 6 种、3d 过渡金属一氧化物(MnO、FeO、CoO、NiO、CuO)5 种、IV 族单质 2 种、IV–IV 族化合物(SiC)1 种。带隙取文献中常见的室温值。
我们只使用由化学式和元素周期表就能算出的四个描述符,不含任何晶体结构信息:
- 电负性差 :组成元素 Pauling 电负性的最大值减最小值(单质为 0),反映键的离子性;
- 平均电负性 :按化学计量加权;
- 平均共价半径 (pm):反映原子大小与键长;
- 摩尔质量 (g/mol)。
模型为四元线性单元:
评价模型时,除损失 外,我们还使用两个常用指标:
均方根误差 RMSE 与目标量的单位相同(这里是 eV),可以直接与实验精度比较;比较式 (13) 可知 。决定系数 是无量纲量,表示模型解释了目标量方差的多大比例: 表示完美拟合, 相当于始终预测平均值, 则说明模型还不如预测平均值。由于 依赖于数据本身的方差,报告结果时应同时给出 RMSE 或平均绝对误差(MAE)。
2.5.2.2 先建立基线,再逐个加入特征
先用全部 73 个样本观察这个模型能拟合到什么程度,再单独检验新样本上的表现。四个特征全部标准化后训练,得到的训练集指标为 , eV, eV。图 20 给出了预测值与实验值的对比。
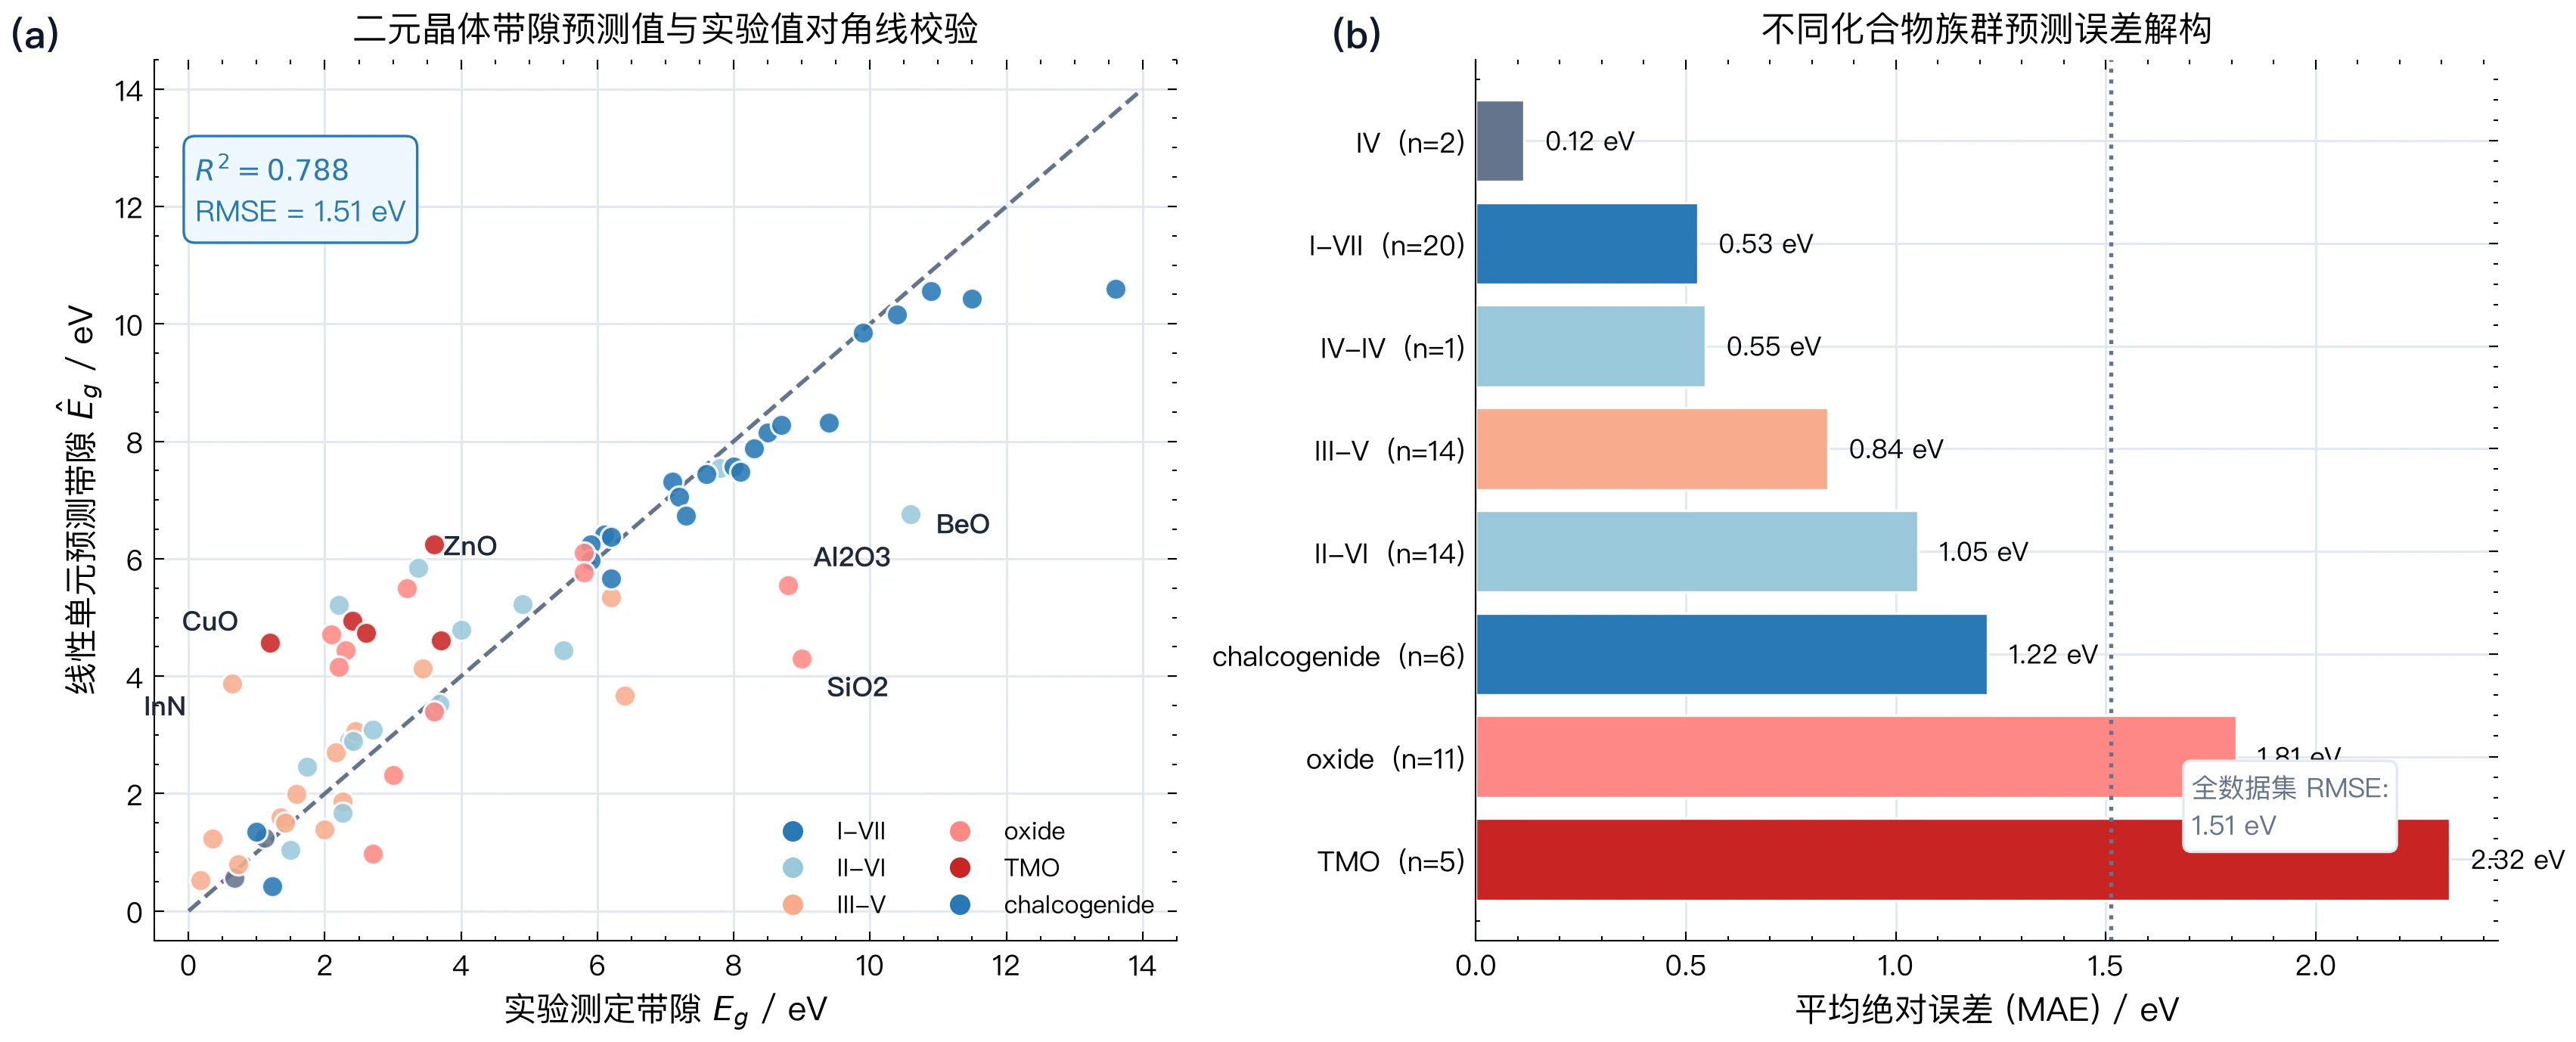
从图 20(b) 可以看出,误差在不同类别之间差别很大:IV 族单质(Si、Ge)的 MAE 仅约 0.12 eV,I–VII 族约 0.53 eV,III–V 族约 0.84 eV,II–VI 族约 1.05 eV;而主族氧化物和过渡金属氧化物分别达到约 1.81 eV 和 2.32 eV。平均的 RMSE 掩盖了这种差异,这正是需要进一步做残差分析的原因。
在分析残差之前,先看每个特征的贡献。表 7 从 开始逐个加入特征,同时列出原始(未标准化)特征矩阵对应的条件数。
表 7 逐个加入特征后的拟合结果
| 特征组合 | RMSE / eV | 条件数 (原始特征) | |
|---|---|---|---|
| 0.723 | 1.73 | 16 | |
| 0.754 | 1.63 | 381 | |
| 0.785 | 1.52 | ||
| 0.788 | 1.51 |
表 7 显示出典型的“收益递减、代价上升”:仅 一个特征就达到 ,此后每加一个特征, 的提升越来越小,而原始特征的条件数却从 16 增大到 。标准化后,四特征模型的条件数降到约 41。对梯度下降而言,这个差别是决定性的:使用原始特征时, 立即发散,必须把学习率降到 ,即使如此也要约 1.9 万轮才能使 ;标准化后, 只需 27 轮。作为验证,梯度下降得到的参数与正规方程(式 (20))的解相差约 。
由于特征之间存在相关性,我们还可以用 2.3.7 节的岭回归观察参数的稳定性。随着 从 0 增大到 0.01、0.1、1、10、100,权重向量的范数 从 3.14 依次收缩到 2.98、2.52、1.44、0.28、0.03,训练集 则从 0.788 降到 0.788、0.778、0.613、0.156、0.018。对这个数据集而言,较小的 ()几乎不损失拟合精度,过大的 则把所有权重压向零,模型退化为预测平均值。
2.5.2.3 残差诊断
训练集上的 还不能告诉我们模型对哪些材料预测得好。要知道模型在哪里失效、为什么失效,需要分析残差 (式 (12))。图 21 给出两种常用的残差图。
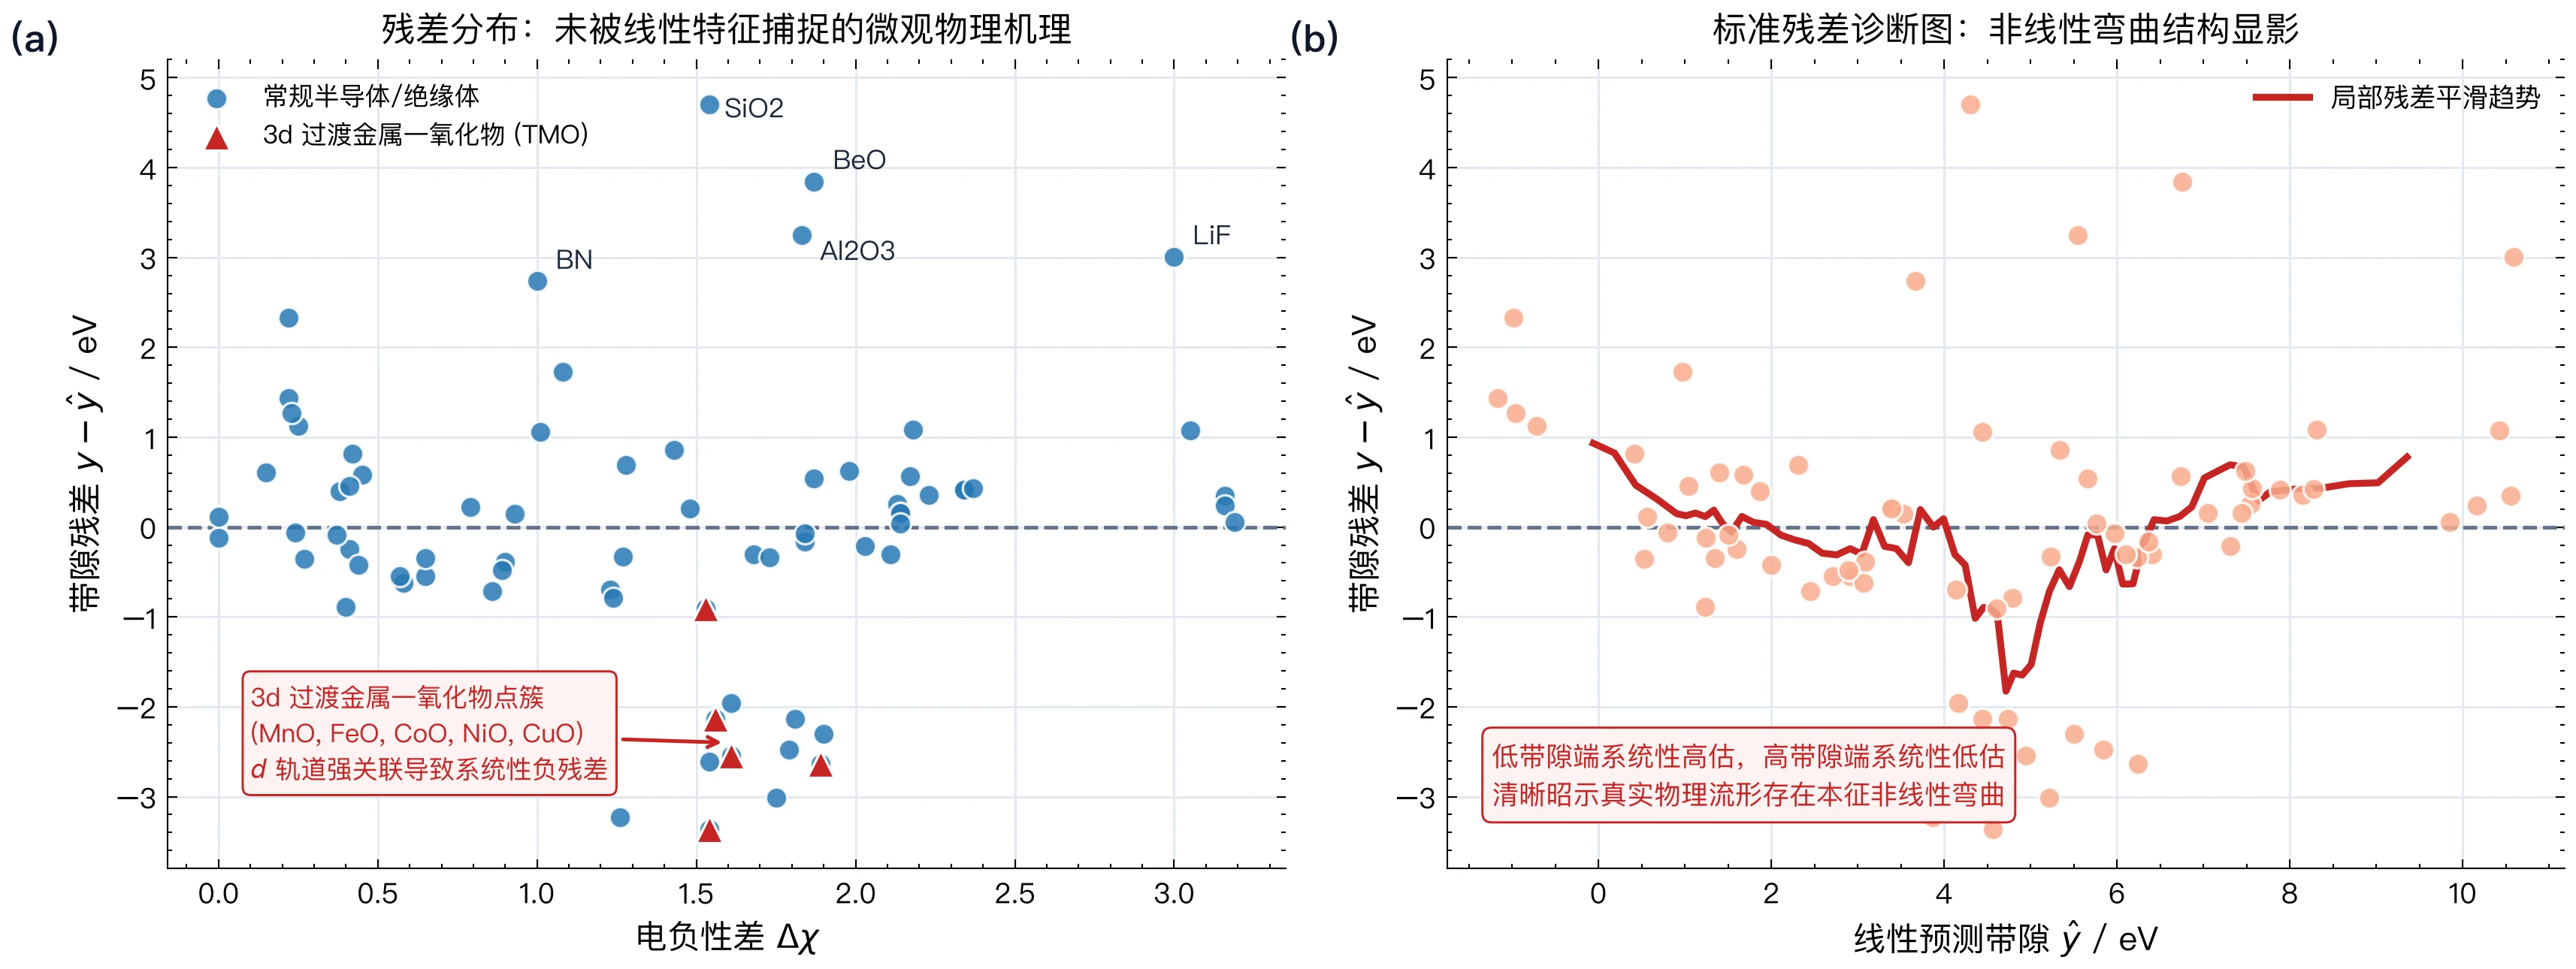
表 8 列出了残差绝对值最大的 8 种化合物。
表 8 带隙模型残差最大的 8 种化合物(单位:eV)
| 化合物 | 实验值 | 预测值 | 残差 | 类别 |
|---|---|---|---|---|
| SiO₂ | 9.00 | 4.30 | +4.70 | 主族氧化物 |
| BeO | 10.60 | 6.76 | +3.84 | 主族氧化物 |
| CuO | 1.20 | 4.56 | −3.36 | 过渡金属氧化物 |
| Al₂O₃ | 8.80 | 5.55 | +3.25 | 主族氧化物 |
| InN | 0.64 | 3.87 | −3.23 | III–V |
| CdO | 2.20 | 5.21 | −3.01 | 主族氧化物 |
| LiF | 13.60 | 10.59 | +3.01 | I–VII |
| BN | 6.40 | 3.67 | +2.73 | III–V |
结合图 21 和表 8,可以归纳出三类系统偏差。
第一类:3d 过渡金属一氧化物被系统性高估。 这五种化合物的残差均为负:MnO −2.64 eV、FeO −2.54 eV、CoO −2.14 eV、NiO −0.91 eV、CuO −3.36 eV。它们偏在同一侧,提示模型可能遗漏了这一类材料共有的影响因素。
从化学上看,过渡金属的 d 电子状态及电子之间的相互作用会影响带隙,而这里的四个描述符没有直接包含这些信息。这为改进描述符提供了一个可检验的方向;仅凭残差,还不能确定每个化合物偏差的具体机制。
进一步理解带隙。 某些主族化合物的带边可以用阴离子 p 态和阳离子 s 态的相对位置作近似解释。过渡金属氧化物还涉及金属 3d 态、电子间排斥,以及氧与金属之间的电荷转移。Mott–Hubbard 型和电荷转移型的区分见文献 [7]。第一次阅读时,先记住“当前输入没有描述这些电子信息”即可。
第二类:宽带隙氧化物与轻元素化合物被低估。 SiO$_2$、BeO、Al$_2$O$_3$、LiF、BN 的残差都是较大的正值。这些样本的实验带隙较宽,当前模型给出的值明显偏低。原子大小、成键方式与结构都值得进一步检查,但这张残差表本身不能把偏差归因于其中某一个因素。这与图 21(b) 中预测值较大时残差偏正的趋势一致。
第三类:残差随预测值弯曲。 图 21(b) 中残差呈系统性弯曲,提示当前特征与线性组合没有充分描述数据中的关系。如果残差图没有明显结构,仅凭这张图就缺少增加模型复杂度的依据;而系统性的结构则提示:应当引入新的描述符(例如 d 电子数、结构信息),或者使用能够表达非线性的模型。
残差分析的价值在于,它把一个笼统的 拆解为具体的、可检验的化学问题。
2.5.2.4 权重的物理解读
在模型中,保持其他输入不变,一个特征每增加一个单位,预测带隙就变化相应的权重值。标准化后,这里的“一个单位”对应原始特征的一个标准差。表 9 列出了标准化坐标和原始量纲下的两种系数。它们说明模型怎样使用输入;描述符彼此相关时,不能仅按系数大小排出物理重要性,更不能据此判断因果关系。
表 9 带隙模型的权重
| 特征 | 标准化权重 / eV | 原始量纲下的权重 |
|---|---|---|
| +2.93 | +3.52 eV(每单位电负性差) | |
| −0.96 | −2.62 eV(每单位平均电负性) | |
| −0.44 | −0.017 eV/pm | |
| −0.38 | −0.0054 eV/(g·mol⁻¹) |
可以把这些系数与已有化学认识作对照,但以下趋势是解释线索,需要另外检验:
- 的权重最大且为正:键的离子性越强,阴、阳离子能级相差越大,带隙越宽。这与化学直觉一致,例如等电子系列中从 GaAs(1.42 eV)到 ZnSe(2.70 eV),带隙随离子性增强而增大。
- 的权重为负:原子越大,键越长,相邻原子轨道之间的相互作用越弱,成键态与反键态的分裂越小,带隙越窄。这与 IV 族中 Si(1.12 eV)到 Ge(0.67 eV)、III–V 族中 AlP(2.45 eV)到 InSb(0.17 eV)的趋势一致。
- 的权重较小,且与 相关(相关系数 0.49),两者都在一定程度上反映“原子有多大、有多重”。去掉 后 只从 0.788 降到 0.785。
- 的权重为负,但它的解释需要格外谨慎。
最后一点值得展开说明:权重反映的是相关,而不是因果。当描述符之间相互关联时,一个特征的权重会随其他特征是否进入模型而改变,甚至改变符号(多重共线性)。因此,应检查权重在不同数据子集和正则化强度下是否稳定。稳定性是讨论物理解读的一个条件,但它本身仍不能证明因果机制。读者可以修改代码清单 2-7,比较不同特征组合下各权重的变化,自行检验这一点(习题 5)。
2.5.2.5 数据划分与适用域
到目前为止,所有指标都是在训练集上计算的。要评估模型对新材料的预测能力,需要留出未参加训练的数据。这里比较两种划分方式,每种使用 6 个随机种子重复计算。配套程序的 test_size=0.35:随机划分时,73 个样本中有 26 个进入测试集;分组划分时,程序按打乱后的类别顺序整组加入测试集,直到样本数达到或超过 26 个。由于不能拆开类别,实际测试集比例可能更大。
- 随机划分:把 73 种化合物随机打乱后划分。测试集平均 , eV,不同种子之间在 0.63~0.86 之间波动。
- 按化学类别划分:以 2.5.2.1 节的类别为单位,同一类别的化合物要么全部进入训练集,要么全部进入测试集。测试集平均 , eV,6 个种子的 在 −0.61~+0.17 之间。
两者差别如此之大,原因在于随机划分时,测试集中的化合物几乎总能在训练集中找到“近亲”——例如 KCl 在测试集中,NaCl、KBr 却在训练集中。此时测试的实际上是同类内的插值能力。按类别划分则要求模型对一类从未见过的化合物做外推,这更接近“预测训练中未覆盖的化学类别”的使用情形,而线性模型在这里基本失效。这一现象在化学与材料机器学习中普遍存在 [8, 9]:如果目标是预测新类别,仅靠随机划分的指标容易高估模型能力。若目标是在已有类别内补测,随机划分则回答了另一种问题;划分方式应与实际用途对应。
与之相关的另一个概念是适用域(applicability domain),即模型在哪类化合物上是可信的。表 10 显示了逐步缩小化合物范围时的拟合结果。
表 10 化合物范围对带隙模型拟合精度的影响(训练集指标)
| 化合物范围 | 数量 | RMSE / eV | |
|---|---|---|---|
| 全部 | 73 | 0.788 | 1.51 |
| 去掉 3d 过渡金属氧化物 | 68 | 0.831 | 1.38 |
| 仅 I–VII、II–VI、III–V 族 | 48 | 0.901 | 1.07 |
| 仅 I–VII 族 | 20 | 0.926 | 0.55 |
这组结果表明,在某些较相似的化合物子集上,模型的训练误差更小。但表 10 全部是训练集指标,只能提出适用范围的候选假设,不能单独证明对新样本也有相同精度。应事先说明目标化合物范围,再用该范围内未参加训练的数据检验。对于这里已出现明显系统偏差的过渡金属氧化物,当前模型尤其需要进一步验证。
2.5.2.6 完整代码
demo_bandgap.py 包含本节的全部实验,共十个部分:数据概览、基线拟合、特征消融(表 7)、特征缩放与学习率、与正规方程对比、岭回归、两种数据划分的比较、残差分析(表 8)、适用域(表 10)以及权重解读(表 9)。
完整程序:代码清单 2-7:demo_bandgap.py。
2.5.3 案例三:正构烷烃沸点的外推
2.5.2.5 节已经看到,模型在外推时可能完全失效。本节用一个更简单、更直观的例子专门讨论外推问题:在短链烷烃上训练模型,预测长链烷烃的沸点。
2.5.3.1 问题设定
正构烷烃 C$n$H$$ 是最简单的同系物,其常压沸点 随碳数 单调升高。我们用 C1–C10(甲烷到癸烷)训练模型,把 C11–C20 完全留作外推测试集。图 22 示意了这种设定。
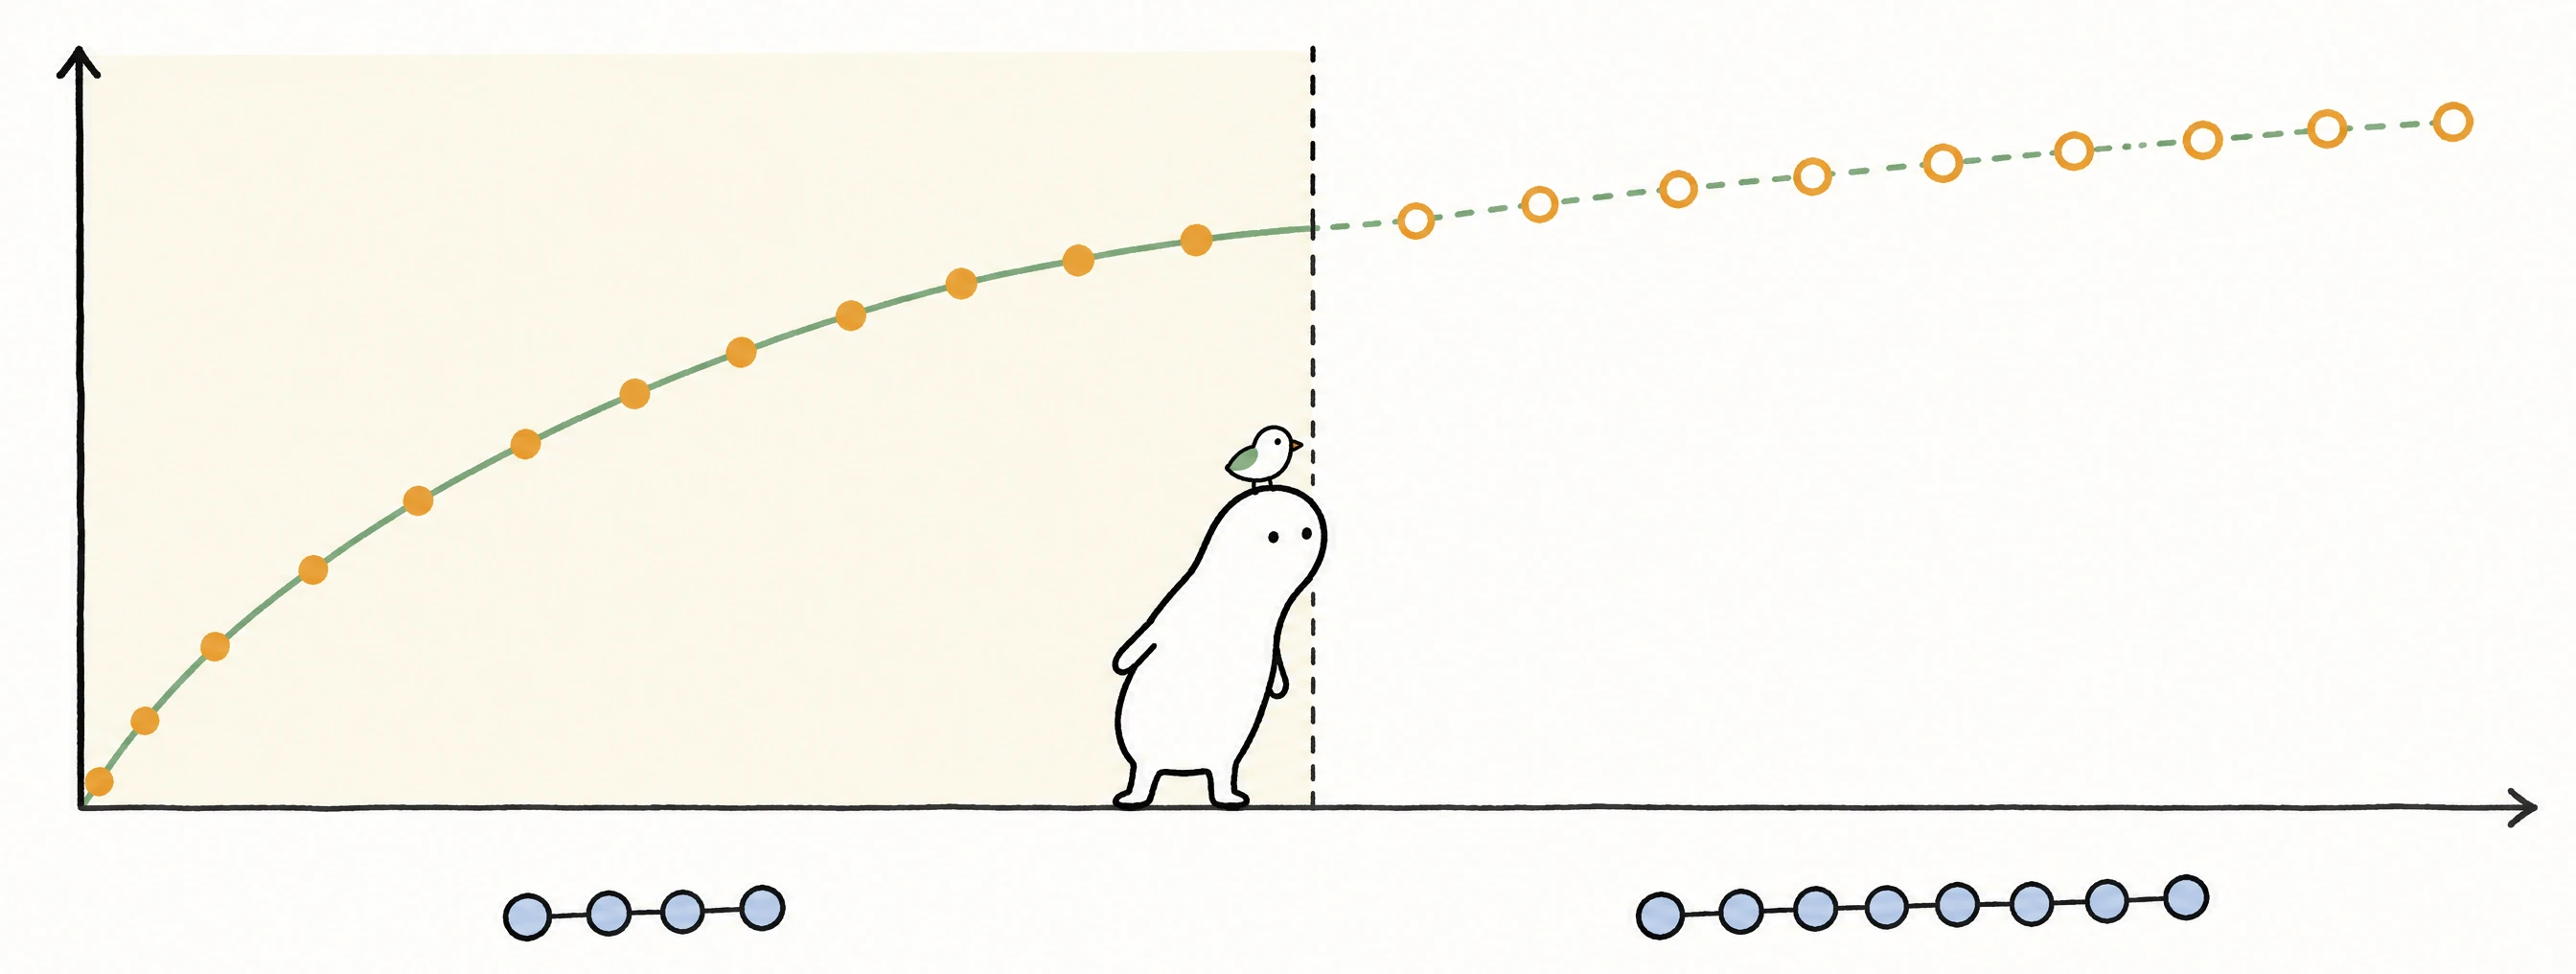
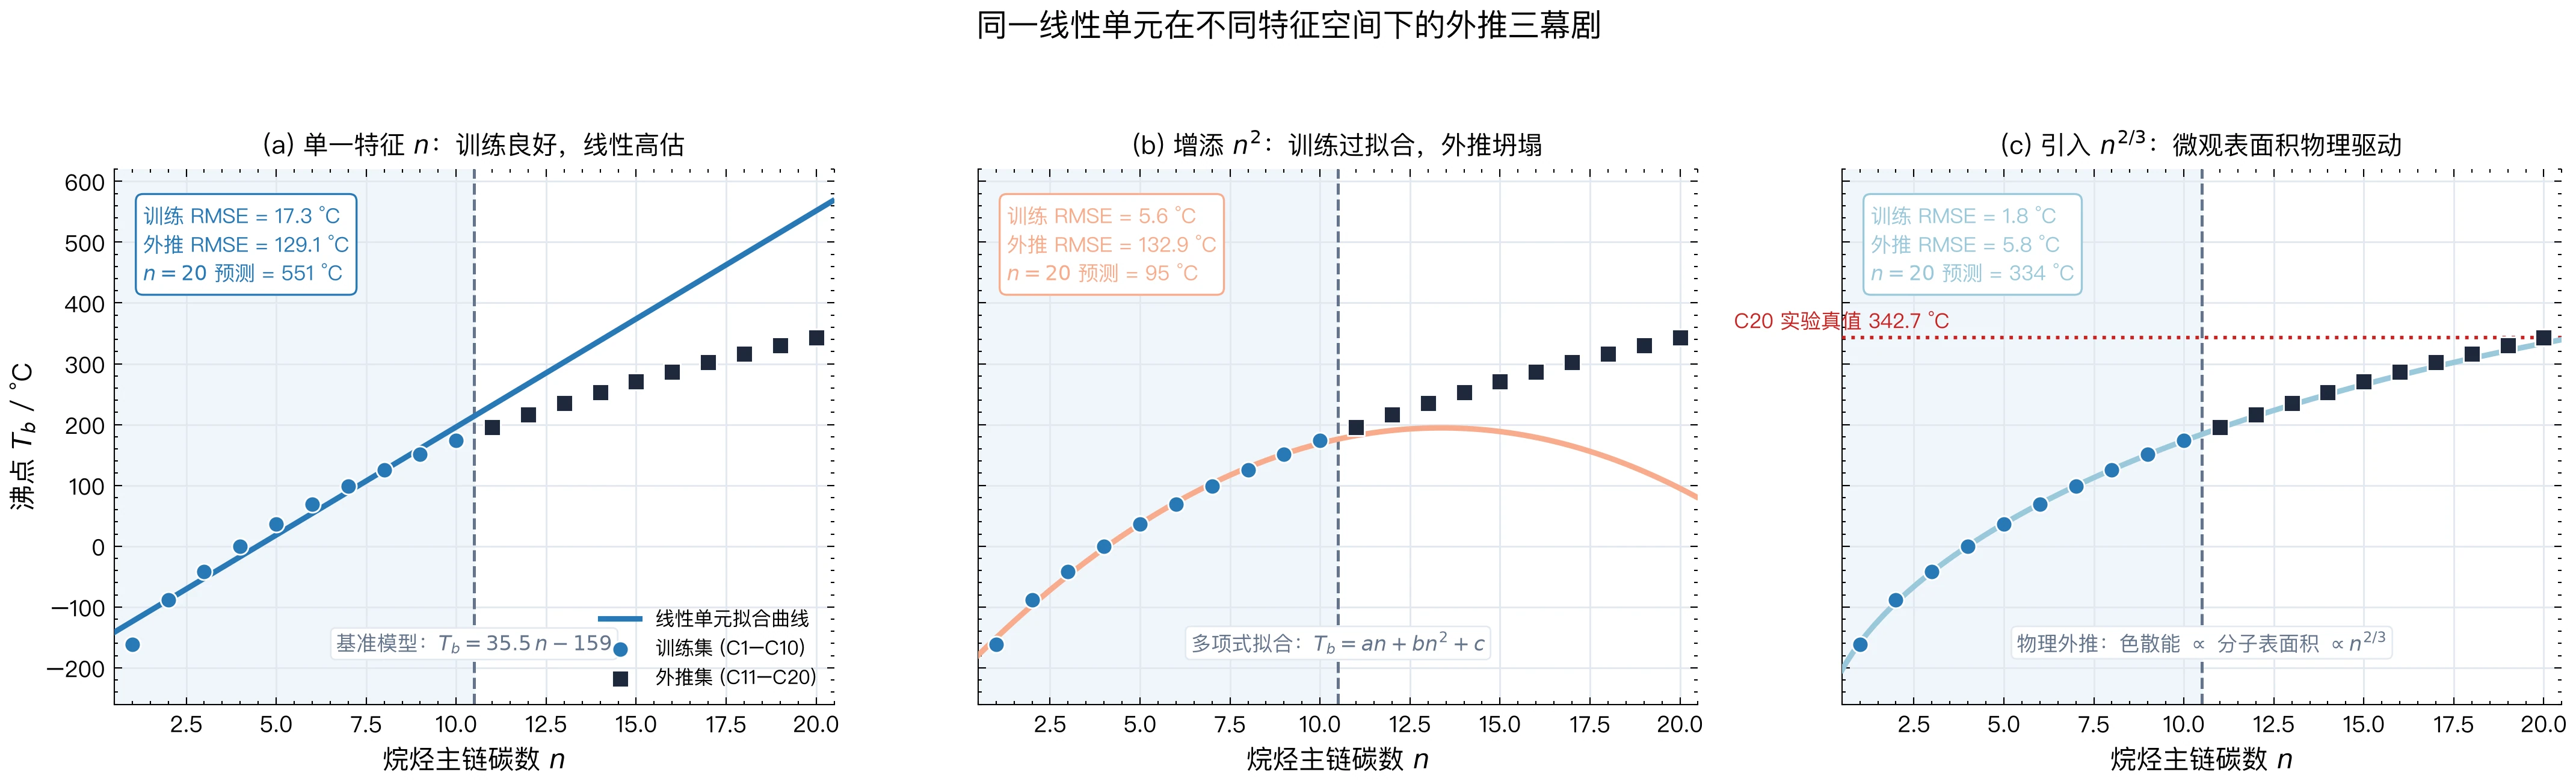
一个需要预先注意的现象是:沸点随碳数增长越来越慢。C1→C2 沸点升高 72.9 $^\circ$C,C9→C10 只升高 23.3 $^\circ$C,而且这一差值仍在继续减小。下面比较三种特征选择,结果汇总于表 11 和图 23。
表 11 三种特征下正构烷烃沸点的训练与外推误差(C1–C10 训练,C11–C20 测试)
| 特征 | 训练 RMSE / $^\circ$C | 外推 RMSE / $^\circ$C | C20 预测值 / $^\circ$C |
|---|---|---|---|
| 17.3 | 129.1 | 551 | |
| 5.6 | 132.9 | 95 | |
| 1.8 | 5.8 | 334 |
注:C20(正二十烷)的实验沸点为 342.7 $^\circ$C。
2.5.3.2 三种特征的比较
特征 。 最自然的想法是直接用碳数作特征。模型学到 (单位 $^\circ$C),训练 RMSE 为 17.3 $^\circ$C。但一条直线只有一个斜率,无法表达“增长越来越慢”,因此外推得越远误差越大:C20 预测为 551 $^\circ$C,比实验值高约 210 $^\circ$C,外推 RMSE 达 129 $^\circ$C。
特征 。 既然曲线是弯的,自然想到加一个平方项。注意这仍然是线性单元:模型对参数 是线性的,我们只是把特征从 换成了 。训练 RMSE 降到 5.6 $^\circ$C,看似进步;但二次项系数为负,抛物线的顶点约在 处,越过顶点后预测值转而下降,C20 只有 95 °C,外推误差比只用 时还大。
这个例子首先暴露了函数形式在外推时的问题:拟合出的二次项系数为负,曲线越过顶点后必然下降,而这些实验数据中的沸点仍随碳数增加。在训练范围内贴合一段曲线,并不能保证延伸出去后仍有合理趋势。仅凭参数个数较少,也不能排除过拟合或其他泛化问题。
特征 。 换一个思路:不问“什么函数拟合得更好”,而问“什么物理量控制沸点”。非极性的正构烷烃分子之间以色散力(London 力)为主,分子间作用的总强度大致随分子间的接触面积增大。对于形状相近的紧凑物体,表面积与体积的 2/3 次方成正比;而每增加一个 CH₂,分子体积增加一个大致固定的量,即体积 ,于是表面积 。真实的烷烃是柔性链,并不是紧凑的球体,长链分子的表面积更接近与 成正比。因此我们同时保留两项,令
由两项的线性组合描述“先快后慢”的增长趋势。拟合得到 $^\circ$C、 $^\circ$C、 $^\circ$C。这一模型的训练 RMSE 只有 1.8 $^\circ$C,外推 RMSE 为 5.8 $^\circ$C,C20 预测值 334 $^\circ$C,与实验值相差约 9 $^\circ$C。
比较表 11 的第二、三行可以看到:两个模型的参数个数相同(都是 3 个),训练代码也完全相同,差别只在于“喂给模型什么特征”。这就是特征工程的含义:用领域知识决定模型“看什么”,往往比单纯增加模型的灵活性更有效。
当然,式 (28) 只是一个由粗略标度论证启发的经验模型,并非严格的物理定律。由于 ,当 足够大时它同样会给出下降的沸点(习题 7),外推范围并非无限。
2.5.3.3 指数扫描:一个关于模型选择的提醒
如果把特征固定为 ,让 从 0.2 扫描到 1.2,会得到表 12。
表 12 特征 中指数 对外推误差的影响
| 0.2 | 0.3 | 0.4 | 0.5 | 0.6 | 0.7 | 0.8 | 0.9 | 1.0 | 1.1 | 1.2 | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 训练 RMSE / °C | 1.1 | 1.1 | 1.2 | 1.3 | 1.6 | 1.8 | 2.1 | 2.5 | 17.3 | 3.2 | 3.3 |
| 外推 RMSE / °C | 22.9 | 17.4 | 11.5 | 5.3 | 1.5 | 8.1 | 15.2 | 16.1 | 129.1 | 28.4 | 47.5 |
外推误差最小的指数是 ,与标度论证给出的 相当接近。但这里有一个方法学问题:我们是按“外推 RMSE 最小”来挑选 的,相当于让本应只用于最终检验的 C11–C20 参与了模型选择,因此 对应的 1.5 $^\circ$C 是偏乐观的估计,不能作为独立的检验结果。规范的做法是在训练集内部再留出一部分数据来选择 ,或者像 2.5.3.2 节那样根据物理论证事先确定 ,再用 C11–C20 做一次性的检验。
表 12 中还有一个值得注意的细节:训练 RMSE 最小的 (0.2~0.3)并不是外推最好的。这再次说明训练误差不能作为选择特征的依据。另外, 一列与只用 的结果完全相同,因为此时两列特征完全重复, 奇异,正规方程没有唯一解;梯度下降从零出发时把权重平均分给两列,得到与只用 等价的模型。这是多重共线性的极端情形:与已有特征重复的特征不提供任何新信息。
2.5.3.4 反向外推与全数据拟合
还可以换一个方向,检查这个特征组合在本组数据上的表现。反过来用 C11–C20 训练、预测 C1–C10:只用 的模型外推 RMSE 为 95.9 $^\circ$C,把甲烷的沸点预测为 39 $^\circ$C;而 模型的外推 RMSE 仅 2.1 $^\circ$C,甲烷预测值为 −160 $^\circ$C(实验值 −161.5 $^\circ$C)。这为它在 C1–C20 范围内描述沸点变化提供了另一项检查,但仍不保证它在更长链的范围内可靠。
若用全部 20 个点训练,三种特征的 分别为 0.954、0.996 和 0.9999,RMSE 分别为 30.8 $^\circ$C、9.5 $^\circ$C 和 1.3 $^\circ$C。在整个范围内, 依然是最准确的。合适的特征使内插和外推同时变好;而 只改善了训练范围内的拟合。
2.5.3.5 完整代码
demo_alkane.py 完成本节的全部实验:三种特征的比较(表 11)、指数扫描(表 12)、反向外推和全数据拟合。
完整程序:代码清单 2-8:demo_alkane.py。
2.5.4 线性基线在研究流程中的位置
三个案例中,线性单元承担了不同任务:在 Arrhenius 问题中,它拟合已有物理方程的参数;在带隙问题中,它提供一个简单预测,并通过残差提出需要进一步检查的问题;在烷烃问题中,它展示了特征选择怎样影响外推。研究中常用这样的简单模型作为基线(baseline),让后续方案有一个明确的比较对象。图 24 示意了这一角色。
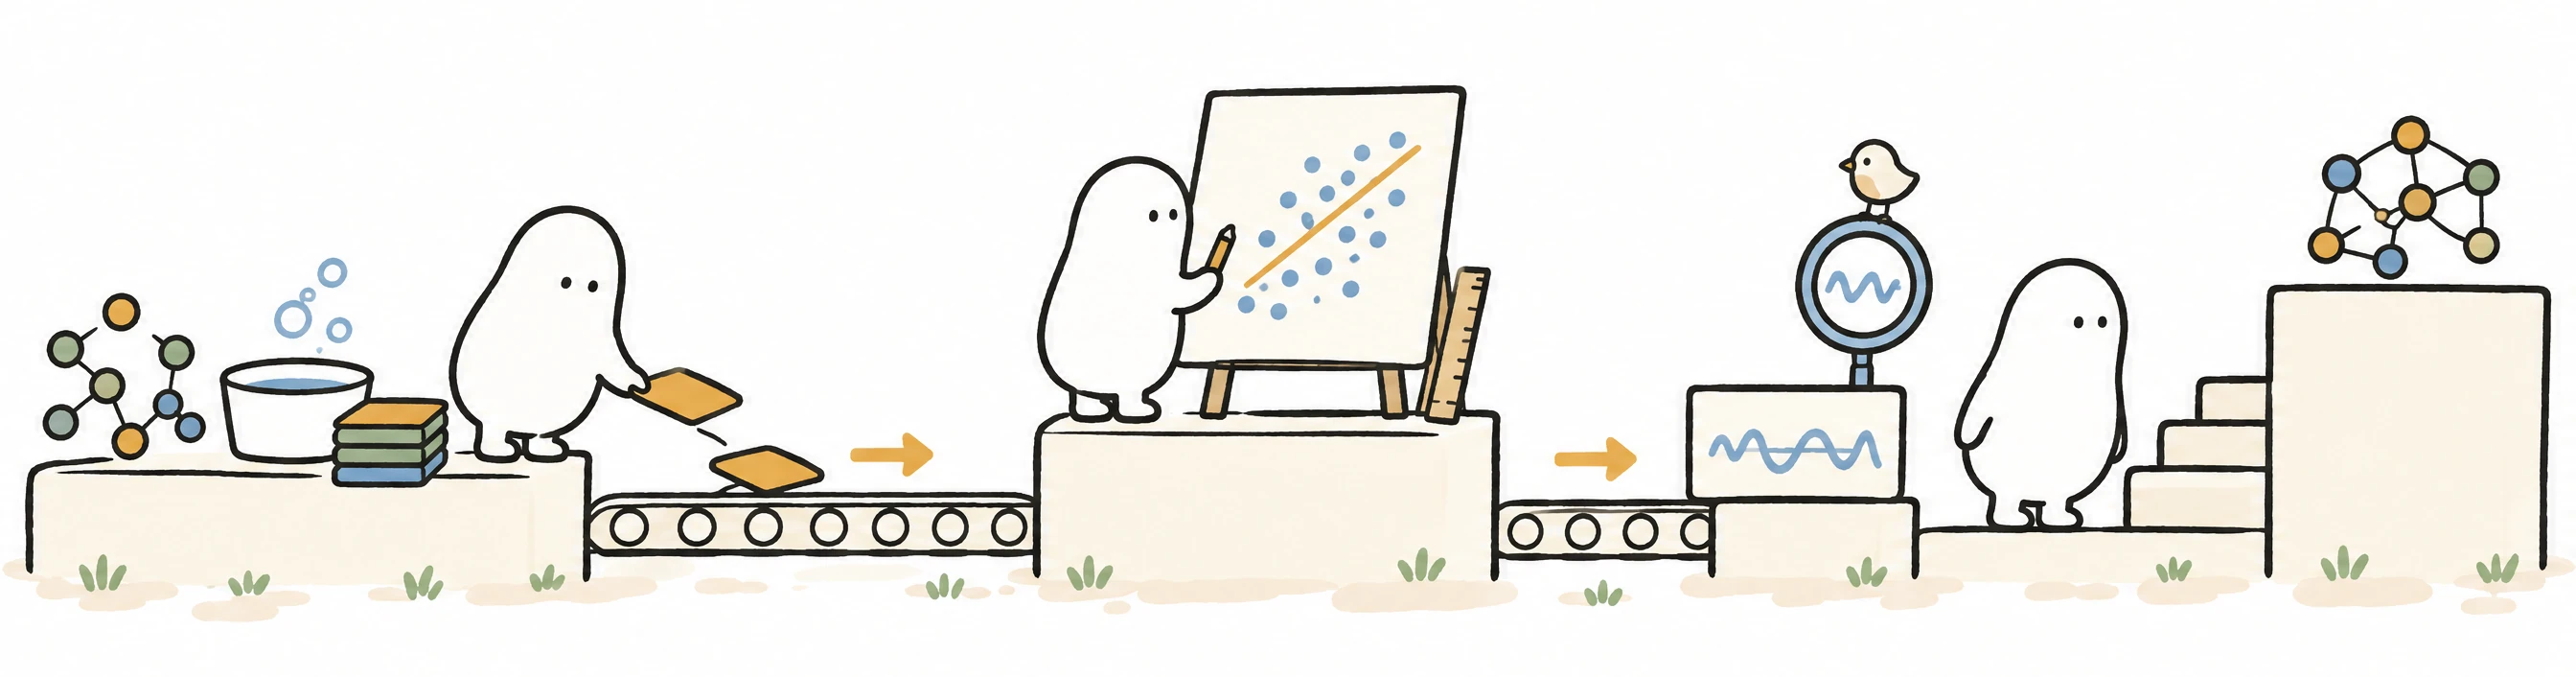
图 25 把这一流程写成决策图。
线性基线提供了一个参照。如果复杂模型(例如第 3 章的多层神经网络)在相同验证划分下没有稳定改善,就缺少增加复杂度的依据。若它表现更好,可以进一步检查改善来自哪些样本,再对确定的方案做独立测试。残差分析帮助我们提出解释,解释本身仍需要证据。
2.6 线性模型的优势、局限与常见陷阱
2.6.1 优势
- 可解释。 每个权重都有明确的含义和量纲,可以与已有的化学知识相互印证(2.5.1.2 节的活化能、2.5.2.4 节的带隙权重)。其中活化能的对应关系来自已知方程;带隙描述符的系数则需要检查稳定性,并与因果解释区分。
- 优化问题性质良好。 均方误差损失是凸函数,没有非全局的局部极小值;当设计矩阵列满秩时,最优解唯一(2.3.4 节与附录 B.3)。批量梯度下降在合适的固定学习率下可以收敛,也可以直接求解线性最小二乘。
- 计算代价低。 预测只需一次内积,训练在小数据集上几乎瞬时完成。
- 小数据下较为稳健。 参数较少,便于在样本有限时先建立一个可检查的参照;是否优于复杂模型仍应在相同数据划分下比较。
- 外推行为可以预见。 线性模型在特征空间中沿直线(超平面)延伸,其外推行为完全由特征的函数形式决定,可以根据所选特征检查其延伸趋势。需要强调的是,这并不意味着外推是有界的或可靠的:2.5.3 节中,只用 的模型外推时误差无限增长, 模型更是给出了方向错误的预测。外推是否合理,取决于特征是否反映了正确的物理趋势。
2.6.2 局限
- 只能表示给定特征的线性组合。 可以通过输入变换(如 、)或目标变换(如 )描述某些非线性关系;特征间的交互作用也可以显式写成乘积项。选择哪些变换仍需要我们决定,模型不能仅靠调整权重自行补上未知的关系。
- 对共线性敏感。 描述符高度相关时, 接近奇异,权重对数据中的微小扰动很敏感,甚至改变符号。
- 平方误差会突出大的偏差。 在独立、同方差的高斯噪声假设下,最小二乘与最大似然估计等价(附录 B.2);但选择平方误差本身并不证明这些假设成立。若数据含有离群点,平方会放大它们的影响;若不同样本的误差大小不同(异方差,例如跨越几个数量级的速率常数),应考虑对目标做变换或使用加权最小二乘。
2.6.3 与其他常用模型的比较
表 13 把线性单元与化学和材料研究中常用的几类模型做一个粗略的比较。表中的描述只是典型情形,具体表现取决于数据和实现。
表 13 常用回归模型的比较
| 维度 | 线性单元 | 岭回归 / LASSO | 决策树与随机森林 | 核岭回归 / 高斯过程 | 神经网络 |
|---|---|---|---|---|---|
| 非线性表达能力 | 无(需人工构造特征) | 无(需人工构造特征) | 强 | 强(取决于核函数) | 强 |
| 可解释性 | 高 | 高;LASSO 可将部分权重压为零,起到特征选择作用(岭回归不能) | 中(可给出特征重要性) | 较低 | 低 |
| 外推行为 | 沿直线延伸,是否合理取决于特征 | 同左,权重被收缩 | 预测值在训练范围外保持常数 | 远离数据时回归先验均值 | 难以预见 |
| 主要超参数 | 学习率(或直接解析求解) | 正则化强度 | 树深、树的数量等 | 核函数及其参数、噪声水平 | 结构、学习率、正则化等 |
| 典型适用规模 | 任意 | 任意,尤其是特征多或共线性强时 | 几十至几十万 | 精确求解通常限于约 个样本以内 | 通常需要大量数据 |
2.6.4 典型失败模式
表 14 汇总了本章遇到的六类失败模式。它们的共同点是:仅看训练集上的 往往发现不了问题。
表 14 线性模型的典型失败模式
| 失败模式 | 表现 | 原因 | 对策 | 本章实例 |
|---|---|---|---|---|
| 特征未标准化 | 梯度下降不收敛,或必须用极小的学习率 | 特征数值范围悬殊或均值远离零,条件数很大 | 训练前做标准化 | 2.5.1.3 节:用 时 |
| 随机划分过于乐观 | 测试集指标很好,对新类别化合物却很差 | 测试集中的样本在训练集中有“近亲”,测的是插值 | 按化学类别、骨架或时间划分 | 2.5.2.5 节: 从 0.75 降至 −0.12 |
| 函数形式外推失真 | 训练误差小,外推误差大,甚至趋势反向 | 特征的函数形式在训练范围外不符合物理 | 依据物理选择特征,并做真正的外推检验 | 2.5.3.2 节: 预测 C20 为 95 °C |
| 共线性导致权重不稳定 | 权重符号与化学直觉相反,或随数据子集变化 | 描述符高度相关, 接近奇异 | 检查条件数和相关系数,删减特征或使用岭回归 | 2.5.3.3 节: 时两列完全相同 |
| 学习率过大 | 损失先降后升,迅速溢出 | 超过稳定上限 | 估计 ,或从较小的学习率开始逐步增大 | 附录 B.7: 时发散 |
| 残差存在系统性结构 | 尚可,但残差图有弯曲或分组偏差 | 存在模型未描述的物理因素 | 分析残差,补充描述符,必要时改用非线性模型 | 2.5.2.3 节:过渡金属氧化物全部被高估 |
2.6.5 化学机器学习中的常见陷阱
除表 14 外,以下问题在化学与材料的数据建模中也很常见,读者在自己的研究中应当留意:
- 用测试集挑选特征或超参数。 反复在测试集上比较不同方案,会使测试集信息泄漏到模型选择中,报告的指标偏乐观(2.5.3.3 节)。
- 超出适用域使用模型。 应当说明模型在哪类化合物、哪个条件范围内经过检验(2.5.2.5 节)。
- 单位不统一。 混用 °C 与 K、kJ/mol 与 kcal/mol、Å 与 pm。
- 只报告 。 依赖于数据本身的方差,应同时报告 RMSE 或 MAE 等有单位的指标。
- 随意删除离群点。 偏离模型的样本可能恰恰包含新的物理(如 2.5.2.3 节的过渡金属氧化物),删除前应查明原因。
- 时间或流程上的信息泄漏。 例如在预测反应产率时,使用了只有反应完成后才能得到的量作为特征。
- 跨越数个数量级的量不做变换。 对速率常数、溶解度、电导率等跨越多个数量级的目标,可以比较原始值与对数值建模;选择时要结合物理关系、误差结构和实际评价目标(2.5.1 节)。
- 在很小的数据集上使用参数很多的模型。 样本少时,先建立线性基线并检查验证结果,再判断增加参数是否带来稳定收益。
2.7 本章小结与下一章
2.7.1 回到最初的拟合问题
本章从一张 Arrhenius 图出发,把“拟合直线”拆成了可以检查的步骤:输入温度的变换值,算出预测,与实测值比较,再根据损失对参数的梯度调整斜率和截距。学习率控制每次调整的幅度,标准化改善输入的计算尺度。
读到这里,应当能区分三种问题。损失还在明显下降,可能是训练尚未完成;训练已经收敛但残差仍有规律,可能是特征或模型形式不够合适;训练误差很小而新数据误差很大,则需要检查数据划分、模型选择与适用范围。它们需要不同的处理办法。
三个化学案例也各自留下一个判断依据:Arrhenius 的斜率可以换算活化能,是因为已有物理方程;带隙模型的残差提示哪些材料需要补充信息;烷烃外推表明,训练范围内拟合得好,不能替代范围外的实际检验。训练方法与科学判断要配合使用。
2.7.2 从人工选择特征到多层网络
线性单元只能把给定特征做线性组合。我们可以人为提供 、 或 ,但模型不会仅靠继续调整权重就自行发现这些变换。下一章将把线性变换与非线性函数分层连接,让中间各层也参与特征的构造。
这带来一个新的问题:输出与实测值之间的误差可以直接计算,但中间各层的参数怎样调整?第 3 章的反向传播会用链式法则计算这些参数的梯度,再由梯度下降更新。因而,本章“模型—损失—梯度—更新”的顺序会继续使用。
延伸阅读:线性单元仍在深度模型中工作。 在分子与材料性质预测中,SchNet、DimeNet、PaiNN、GemNet、Equiformer 等模型使用更复杂的中间表示。回归输出中常用的一个步骤,是把已经得到的表示 送入线性层:
前面的网络负责学习表示,最后的线性映射把表示换成性质预测。具体模型还可能包含原子贡献的汇总等操作。分类时也常先得到线性打分,再用 softmax 转换为类别概率。径向基、球谐函数和等变消息传递等表示方法会在后面的章节介绍,当前只需认出其中的线性计算。
2.8 思考与练习
2.8.1 先检查是否理解训练过程
- 在 2.2.4 节的手算例子中,把学习率改成 0.5,再改成 2。分别计算一次更新后的参数和损失。为什么知道局部下降方向,还需要控制步幅?
- 不看代码,用自己的话解释
residuals、grad_w和learning_rate分别表示什么。它们在一次训练更新中按什么顺序出现? - 程序已经得到稳定的训练损失,是否可以据此宣称能准确预测新材料?分别用带隙划分和烷烃外推的例子说明。
2.8.2 进一步推导与研究练习
下面保留本章的九道深入练习;正文提到的“习题 5”“习题 7”等均指这一组。涉及 Hessian 的题目可以读完附录后再做。
(残差的性质) 由式 (16) 和式 (21) 证明:在最小二乘解处,残差的平均值为零,且残差与每个特征列都正交。这对 2.5.2.3 节的残差图意味着什么?
(学习率) 某二元线性问题的 Hessian 矩阵特征值为 、。求:(a) 梯度下降稳定的学习率范围;(b) 最优学习率和对应的收缩因子;(c) 若采用 ,哪个方向收敛更慢?
(为什么 1000/T 仍然病态) 一元问题中,设特征的均值为 、标准差为 。(a) 证明 ;(b) 利用 和 ,证明当 较小时 ;(c) 代入 、,与表 6 中的条件数比较。
(汽化焓的温度依赖) 用
demo_arrhenius.py分别拟合 0~50 °C 和 50~100 °C 两段水蒸气压数据,比较得到的 ,并用 2.5.1.4 节的讨论解释差异。(权重的稳定性) 修改
demo_bandgap.py:(a) 分别去掉 、、 中的一个,记录其余权重的变化;(b) 取 的岭回归重复 (a)。哪些权重的符号是稳定的?哪些物理解读因此更可信?(补充描述符) 为带隙数据增加一个描述符“阳离子 d 电子数”(主族化合物取 0 或 10),重新拟合并观察过渡金属氧化物的残差。只有 5 种化合物从这个新特征中受益,你如何判断改进是否可靠?应当如何划分数据来检验?
(式 (28) 的外推范围) 由 2.5.3.2 节的拟合参数,求 时的碳数 。超过这一碳数后模型会给出什么样的预测?这对式 (28) 的适用范围说明了什么?
(规范的模型选择) 用 C1–C7 训练、C8–C10 作为验证集选择 2.5.3.3 节的指数 ,再用 C11–C20 做一次性检验。所选的 和外推误差与表 12 有何不同?
(负的 ) 2.5.2.5 节中按类别划分时,测试集 可以为负。说明 的含义,并解释为什么在训练集上用最小二乘拟合时(含截距项) 不会为负。
参考文献
[1] Widrow, B., & Hoff, M. E. Adaptive switching circuits. IRE WESCON Convention Record, Part 4, 96–104, 1960.
[2] Cauchy, A. Méthode générale pour la résolution des systèmes d'équations simultanées. Comptes Rendus de l'Académie des Sciences, 25, 536–538, 1847.
[3] Polyak, B. T. Some methods of speeding up the convergence of iteration methods. USSR Computational Mathematics and Mathematical Physics, 4(5), 1–17, 1964.
[4] Hoerl, A. E., & Kennard, R. W. Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67, 1970.
[5] Hansch, C., Leo, A., & Taft, R. W. A survey of Hammett substituent constants and resonance and field parameters. Chemical Reviews, 91(2), 165–195, 1991.
[6] Daniels, F., & Johnston, E. H. The thermal decomposition of gaseous nitrogen pentoxide. A monomolecular reaction. Journal of the American Chemical Society, 43(1), 53–71, 1921.
[7] Zaanen, J., Sawatzky, G. A., & Allen, J. W. Band gaps and electronic structure of transition-metal compounds. Physical Review Letters, 55(4), 418–421, 1985.
[8] Sheridan, R. P. Time-split cross-validation as a method for estimating the goodness of prospective prediction. Journal of Chemical Information and Modeling, 53(4), 783–790, 2013.
[9] Meredig, B., Antono, E., Church, C., et al. Can machine learning identify the next high-temperature superconductor? Examining extrapolation performance for materials discovery. Molecular Systems Design & Engineering, 3(5), 819–825, 2018.
延伸阅读
历史文献
- Rosenblatt, F. The perceptron: A probabilistic model for information storage and organization in the brain. Psychological Review, 65(6), 386–408, 1958.
- Hammett, L. P. The effect of structure upon the reactions of organic compounds. Benzene derivatives. Journal of the American Chemical Society, 59(1), 96–103, 1937.
- Hansch, C., Maloney, P. P., Fujita, T., & Muir, R. M. Correlation of biological activity of phenoxyacetic acids with Hammett substituent constants and partition coefficients. Nature, 194, 178–180, 1962.
教材与专著
- Bishop, C. M. Pattern Recognition and Machine Learning. Springer, 2006.(第 3 章:线性回归模型)
- Hastie, T., Tibshirani, R., & Friedman, J. The Elements of Statistical Learning, 2nd ed. Springer, 2009.(第 3 章:线性回归、岭回归与 LASSO)
- Nocedal, J., & Wright, S. J. Numerical Optimization, 2nd ed. Springer, 2006.(梯度法的收敛理论)
- Goodfellow, I., Bengio, Y., & Courville, A. Deep Learning. MIT Press, 2016.(第 4 章:数值计算;第 8 章:优化方法)
化学与材料中的机器学习方法学
- Butler, K. T., Davies, D. W., Cartwright, H., Isayev, O., & Walsh, A. Machine learning for molecular and materials science. Nature, 559, 547–555, 2018.
- Schmidt, J., Marques, M. R. G., Botti, S., & Marques, M. A. L. Recent advances and applications of machine learning in solid-state materials science. npj Computational Materials, 5, 83, 2019.
- Wallach, I., & Heifets, A. Most ligand-based classification benchmarks reward memorization rather than generalization. Journal of Chemical Information and Modeling, 58(5), 916–932, 2018.
- Kapoor, S., & Narayanan, A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns, 4(9), 100804, 2023.
附录 A 数学补充
A.1 均方误差中因子 1/2 的作用
式 (13) 中的因子 只是为了求导方便。对单个样本的损失求导:
平方项求导产生的因子 2 恰好与 相消。由于把目标函数乘以任意正常数不改变极小点的位置,引入 不影响最优解 ,只是让梯度表达式(式 (15)~(17))更简洁。需要注意,学习率的数值与损失的归一化方式有关:若去掉 ,梯度加倍,等效学习率也随之加倍。
A.2 均方误差损失的凸性
定义 设 。若对任意 和任意 ,都有
则称 为凸函数;若对 、 严格不等号成立,则称 为严格凸函数。几何上,这意味着函数图像上任意两点之间的弦都不低于函数图像。
判别准则 若 二阶连续可微,则 是凸函数的充要条件是其 Hessian 矩阵处处半正定,即 ;若 Hessian 矩阵处处正定,则 是严格凸函数(反之不一定成立,例如 严格凸,但在 处二阶导数为零)。
命题 式 (13) 的损失 是凸函数;若 列满秩,则 是严格凸函数。
证明 由式 (17), 的梯度为 。再对 求导,由于 与 无关,得到常数 Hessian 矩阵 (式 (49))。对任意 ,
故 , 是凸函数。若 列满秩,则 当且仅当 ,于是对任意 有 , 正定, 是严格凸函数,其极小点唯一。
A.3 固定步长梯度下降的收敛速率
考虑一般的强凸二次函数
线性单元的损失 (13) 是它的特例:,,再加一个与 无关的常数。极小点满足 。固定步长的梯度下降为 。记误差 ,利用 得
即式 (53)。把对称矩阵 正交对角化为 ,特征值 。在特征向量基下, 的各分量相互独立地演化:
由于 是正交矩阵,,因此
是 的分段线性函数,在区间 上的最大值只能在端点处取得。随着 增大, 减小而 最终增大,当两者相等时 最小:
代回得最优收缩因子
这就是式 (56)。若要求 (),只需
其中用到了 。可见,在固定步长下,所需迭代次数大致与条件数成正比:条件数增大 10 倍,迭代次数也大约增大 10 倍。
说明 上述分析针对固定步长。若每一步沿负梯度方向做精确线搜索(最速下降法),利用 Kantorovich 不等式可以证明,下一步的函数值误差 不超过当前误差的 倍,与式 (38) 的收敛因子有对应关系(参见 Nocedal & Wright 的教材)。这里比较的是两种不同算法的界;参数误差与函数值误差也要区分。
A.4 标准化后 Hessian 矩阵的结构
设各特征按式 (7) 标准化,即每一列的均值为 0、(总体)方差为 1。增广设计矩阵为 ,则
由于每列均值为零,;右下角元素 ;左上角 的第 个元素正是特征 与特征 的相关系数,对角元均为 1。这就得到式 (57):
由此可见:中心化消除了权重与截距之间的耦合,缩放使各对角元相等。标准化后剩余的病态只来自特征之间的相关性( 的非对角元)。一元问题中 ,,条件数恰为 1(表 6);而带隙问题的四个特征彼此相关,标准化后条件数仍约为 41(2.5.2.2 节)。
附录 B 进阶阅读与实现说明
这里集中回答正文没有展开的数学问题。B.1 交代历史联系;B.2 解释平方误差的统计来源;B.3~B.6 定量分析损失曲面、学习率和标准化;B.7 说明完整代码。它们可以按问题分别查阅。
B.1 感知器、Adaline 与 LMS 的联系
感知器所用的阶跃激活函数为
对于式 (42) 的阶跃函数,在阈值以外都有
微调参数时,输出通常保持不变,所以不能直接用这个输出的导数指导学习。感知器通过另一套按分类错误修正权重的规则训练;线性可分时的收敛保证已经在第 1 章讨论。把同一条纠错规则原样放到一般多层网络中,并不能给出各层所需的梯度。
1960 年,斯坦福大学的 Bernard Widrow 与他的研究生 Marcian(Ted)Hoff 提出了自适应线性神经元(Adaptive Linear Neuron,Adaline)[1]。图 27 给出了它的结构示意。有些感知器使用 ±1 而不是 0/1 的标签,这不改变这里关于阶跃导数的讨论。
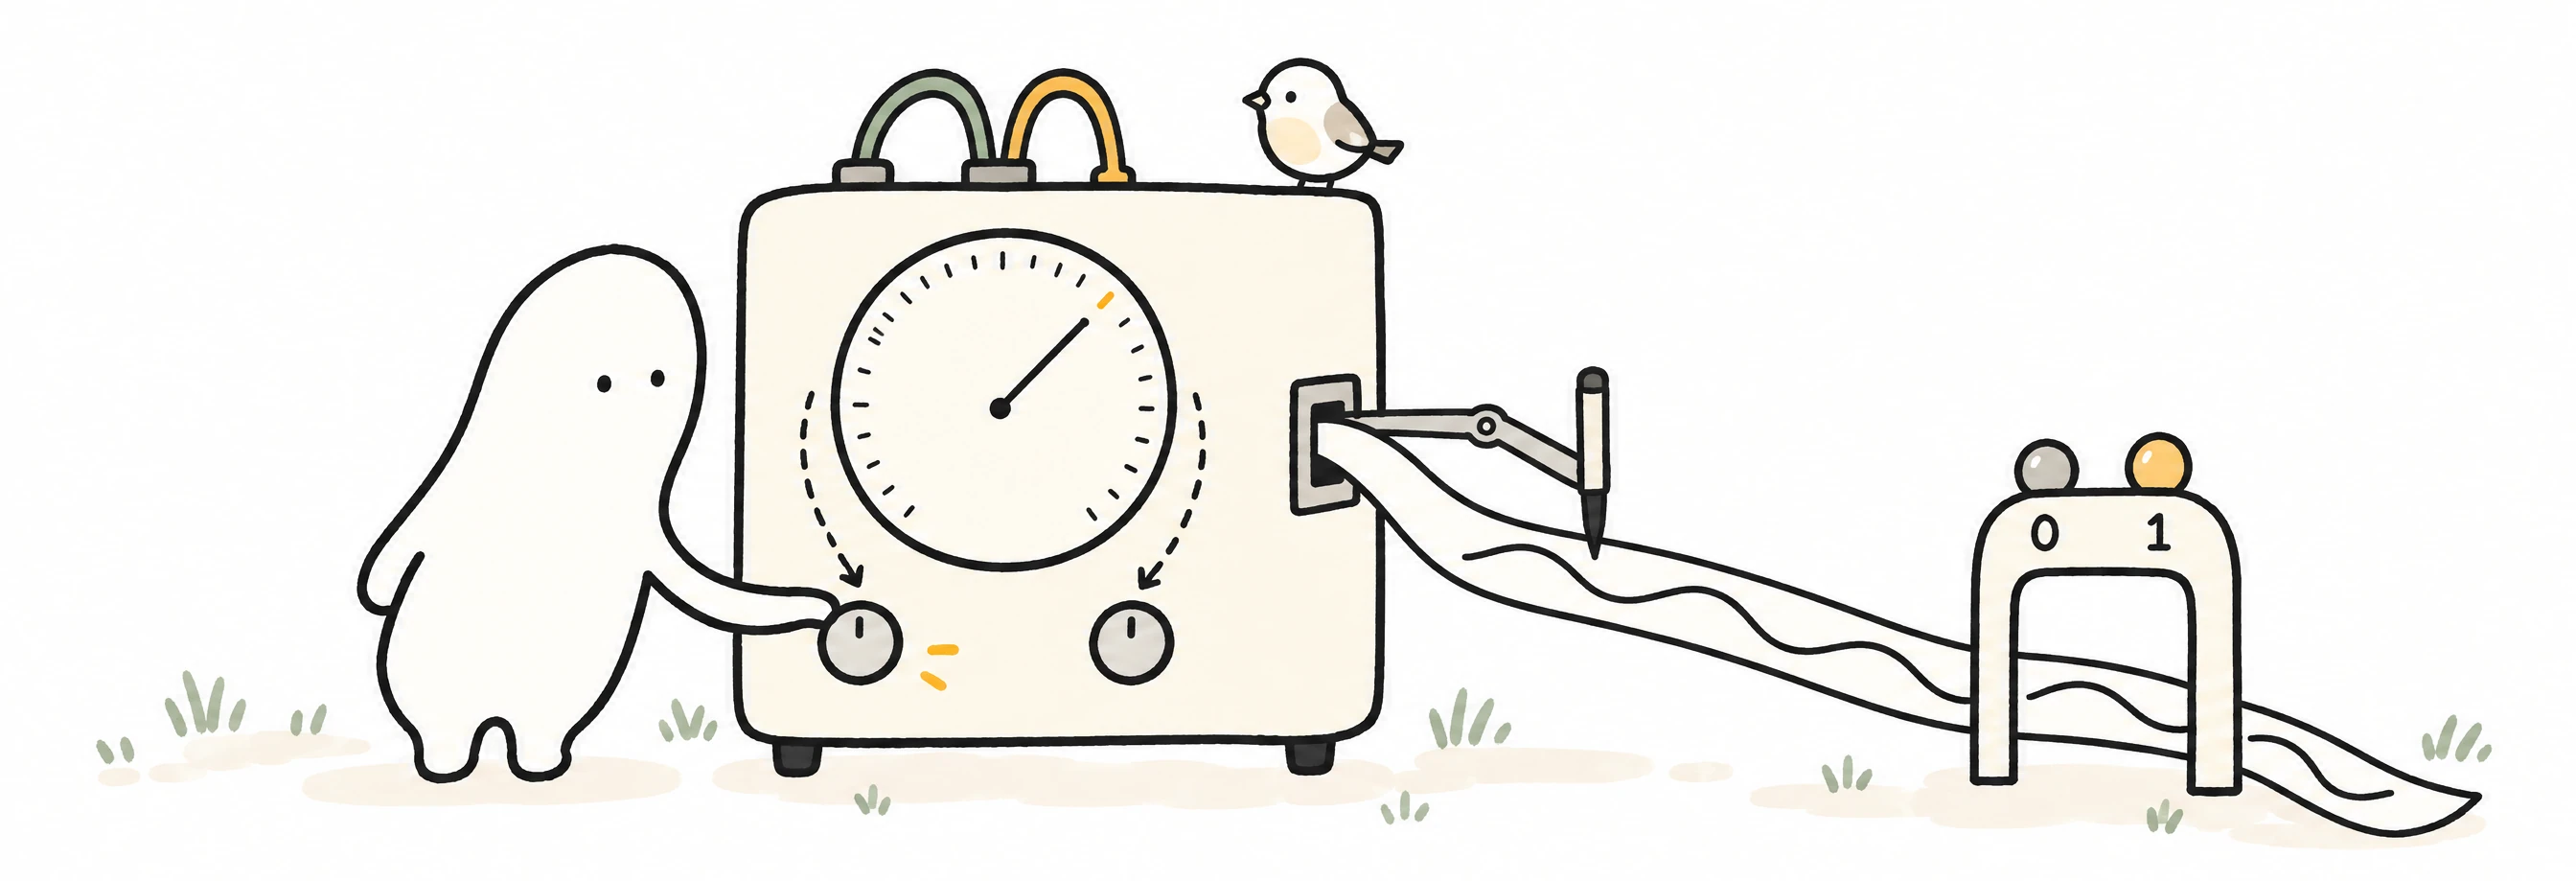
Adaline 的关键改动在于把学习过程与阈值判决分开:计算误差时,不再使用经过阶跃函数的离散输出,而是直接使用连续的净输入 ,误差定义为 。由于 是参数的线性函数,误差的平方便是参数的光滑二次函数,可以放心地求导。据此得到的逐样本更新规则为
其中 是学习率。这就是著名的最小均方(Least Mean Squares,LMS)算法,又称 Widrow–Hoff 规则。对照 2.2.3 节的梯度可以看到,式 (44) 正是对平方误差做“随机梯度下降”的一步。
需要说明的是,“沿负梯度方向迭代求极小值”的思想并非 Widrow 和 Hoff 首创,它可以追溯到 Cauchy 在 1847 年提出的最速下降法 [2]。Adaline 的历史意义在于:它把这一经典数值方法与可自适应调整的神经元结合起来,为后来的多层网络与反向传播算法奠定了基础。
B.2 平方误差的统计解释:高斯噪声与最大似然
衡量残差大小的方式有很多:可以取残差的平方,也可以取绝对值,甚至取四次方。正文先把平方误差作为衡量拟合偏差的标准。这里再说明,在什么统计假设下,这个标准与最大似然估计等价。
假设实测值等于“真实的线性关系”加上一个随机误差:
其中 是增广特征向量。也就是说,误差服从均值为 0、方差为 的正态分布。这一假设的合理性部分来自中心极限定理:若误差由许多独立的小扰动(仪器噪声、温度波动、读数误差等)叠加而成,它的分布会近似为正态分布。但这只是近似,并非必然——实际数据中的离群点、系统误差都会破坏它。
在这一假设下,给定 和参数 ,观测到 的概率密度为
若各次测量相互独立,整个数据集的似然函数就是各样本概率密度的乘积:
最大似然估计主张选取使 最大的参数,即“让已观测到的数据出现的可能性最大”。乘积不便于求导,因此通常改为最小化负对数似然:
式 (48) 右端第一项与 无关;第二项的系数 是正常数。因此,在独立、同方差的高斯噪声假设下,最大似然估计与最小化残差平方和完全等价,也就与最小化式 (13) 的均方误差等价。
这个结论同时告诉我们均方误差的适用范围:
- 若误差分布具有“重尾”(偶尔出现很大的偏差),平方会过分放大离群点的影响,此时可以考虑平均绝对误差(MAE)——它对应拉普拉斯分布的最大似然估计——或 Huber 损失;
- 若不同样本的误差大小不同(异方差),应采用加权最小二乘。2.1.4 节提到的“取对数会改变误差结构”正是这种情况:对 做普通最小二乘,隐含的假设是 的误差同方差,即 的相对误差大致恒定。
B.3 用 Hessian 描述损失曲面的形状
正文图 11、图 12 已经展示了损失曲面。下面用二阶导数描述它的曲率,并说明什么时候最优参数唯一。
曲面的弯曲程度由二阶导数描述。对式 (17) 再对 求一次导数,就得到线性单元的 Hessian 矩阵:
它是一个与 无关的常数对称矩阵——这正是二次函数的特点。对任意非零向量 ,有
因此 是半正定矩阵, 是凸函数。进一步,若 列满秩(即没有哪个特征能由其他特征和常数项线性组合精确得到),则 只有零解, 正定, 是严格凸函数(证明细节见附录 A.2)。由此得到三条重要结论:
- 没有“假”的极小点。 这里的凸二次损失不存在比全局最优更高的局部极小点;
- 梯度为零的点就是全局最优点。 对这里列满秩的线性最小二乘问题,这样的点唯一存在;
- 负梯度垂直于等高线。 如图 12(b) 所示,负梯度指向局部下降最快的方向。但要注意,它一般并不指向碗底——当等高线是扁椭圆时,两者的夹角可能很大,这正是 2.3.2 节训练缓慢问题的根源。
如果 不是列满秩的(例如把同一个特征重复输入两次), 就有零特征值,碗底不再是一个点,而是一条“平底沟槽”:沟槽上的所有点损失都相同,最优参数不唯一。第 2.5.3 节会遇到这种情形。
知识拓展:Hessian 的特征分解与等高线的几何形状
下面的椭球与有限条件数讨论假定 正定;若有零特征值,会出现平坦方向。由于 是实对称矩阵,它可以正交对角化为 ,其中 是相互正交的单位特征向量, 是对应的特征值。以最优点 为原点、以 为坐标轴,损失函数可以写成
可见:(1)等高线(面)是以 为主轴的椭圆(椭球),沿 方向的半轴长与 成正比;(2) 是曲面沿 方向的曲率, 越大,该方向越“陡”。最大与最小特征值之比
称为 的条件数(condition number),它衡量碗的“扁平程度”: 时等高线是正圆, 时等高线是极扁的椭圆,碗变成一条狭长的峡谷。附录 B.5 将说明,梯度下降的收敛速率正是由 决定的。
B.4 学习率如何决定每个方向的变化
为了定量判断学习率,需要跟踪参数与最优解之间的距离。记第 步的参数误差为 。由于最优点满足 ,由式 (17)、(49) 可得 。代入式 (18),得到
把误差投影到 的特征向量上,记 ,由于 ,式 (53) 分解为 个互不耦合的标量递推:
式 (54) 给出了可以直接检查的规律:沿每个特征向量方向,误差每一步都乘以同一个因子 。 下面的分类与 B.5 节的稳定条件都从这个式子出发。
根据式 (54),正文图 8 的几种行为都可以由因子 的取值刻画。表 15 还列出了临界边界的情况。
表 15 沿某一特征方向,学习率与迭代行为的对应关系
| 的范围 | 因子 | 该方向上误差的行为 |
|---|---|---|
| 单调衰减,不越过谷底; 越小衰减越慢 | ||
| 一步到位 | ||
| 正负交替(每步越过谷底),幅度逐渐衰减 | ||
| 等幅振荡,既不收敛也不发散 | ||
| 正负交替且幅度不断增大,发散 |
表 15 只描述了单个方向。整体的行为取决于所有方向中最“差”的那一个:若某个方向 且初始误差在该方向上非零,这个误差分量就会增大;收敛的快慢则由 决定。
图 28 给出了一个具体的数值例子。所用数据与代码清单 2-5 第二部分相同:横坐标是 13 个常见的 Hammett 取代基常数 ,响应 是为演示而构造的(加入了一个小的扰动项)。对这组 ,Hessian 的两个特征值为 、。
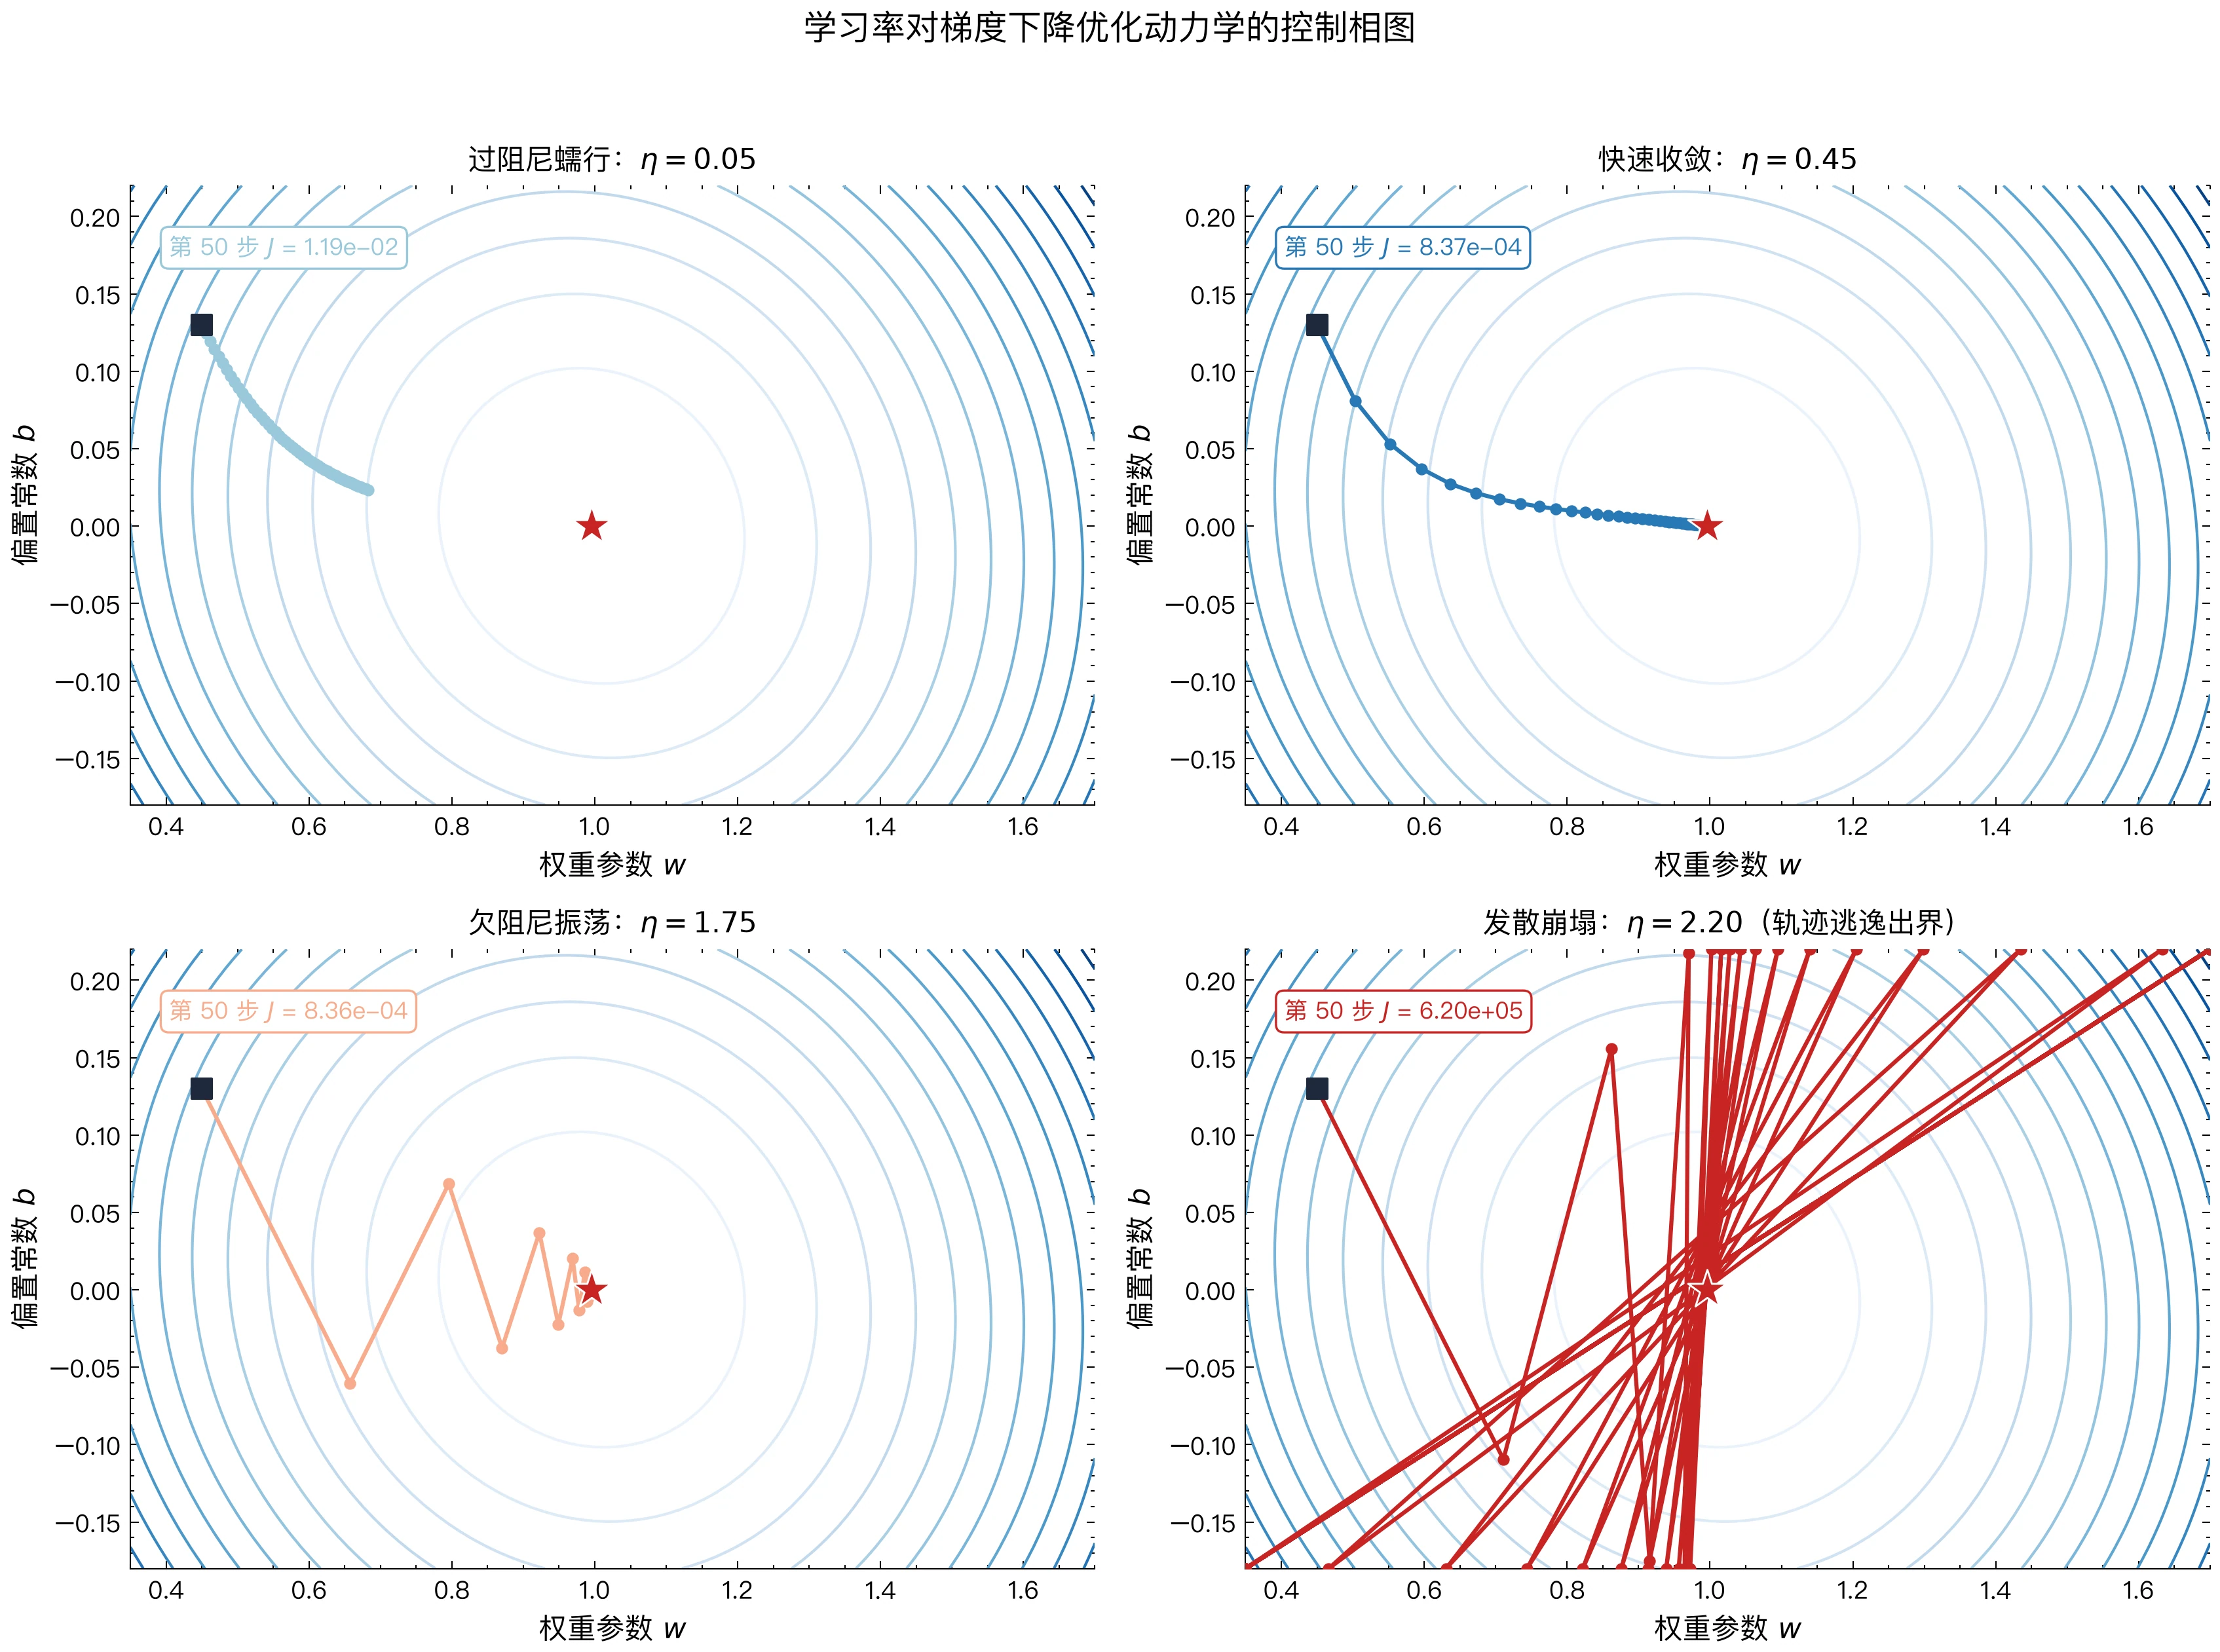
对照表 15 来读图 28:(a)(b) 两种情况下两个方向的 都小于 1,路径不越过谷底;(c) 中陡峭方向的 落在 1~2 之间,因此出现了来回跳跃;(d) 中 ,迭代发散。
参数来回跨过最优点,并不一定收敛得慢。 在 (b) 中,收敛速率由平缓方向决定,;而在 (c) 中,,反而更小。因此 (c) 虽然左右摆动,却收敛得更快。读者可在 demo_playground.py 第二部分中将学习率列表改为 0.45 和 1.75,增加第 50 步的输出后比较: 的损失与最优值的相对差异已小于 ,而 时仍高出约 1%。
文献中有时借用振动力学的术语,把 (a)(b) 称为“过阻尼”、把 (c) 称为“欠阻尼”。这只是一种形象的类比:梯度下降本身并不含阻尼项,其行为完全由表 15 中的因子 决定。
B.5 固定学习率的稳定范围与收敛速率
这里假设 Hessian 正定,讨论批量梯度下降和固定学习率。要保证从任意初始参数出发都收敛,所有方向都必须满足 ,即
若进一步要求各特征向量方向上的参数误差都不变号,则需 。
那么,最快的学习率是多少?收敛速率由 决定,而这个最大值只可能出现在 或 处。当两端的因子大小相等、符号相反时, 取最小值,由此得到(推导见附录 A.3)
式 (56) 表明:条件数 越大,即使采用最优学习率,误差每步的收缩也越少。 当 时,把误差缩小到原来的 倍大约需要 步。例如 时,收缩因子约为 0.9998,要把误差缩小 倍需要约 7 万步。
以上分析在真实数据上同样成立。图 29 使用第 2.5.2 节将要介绍的带隙数据集,取两个标准化后的特征(电负性差 与平均电负性 )进行学习率扫描。
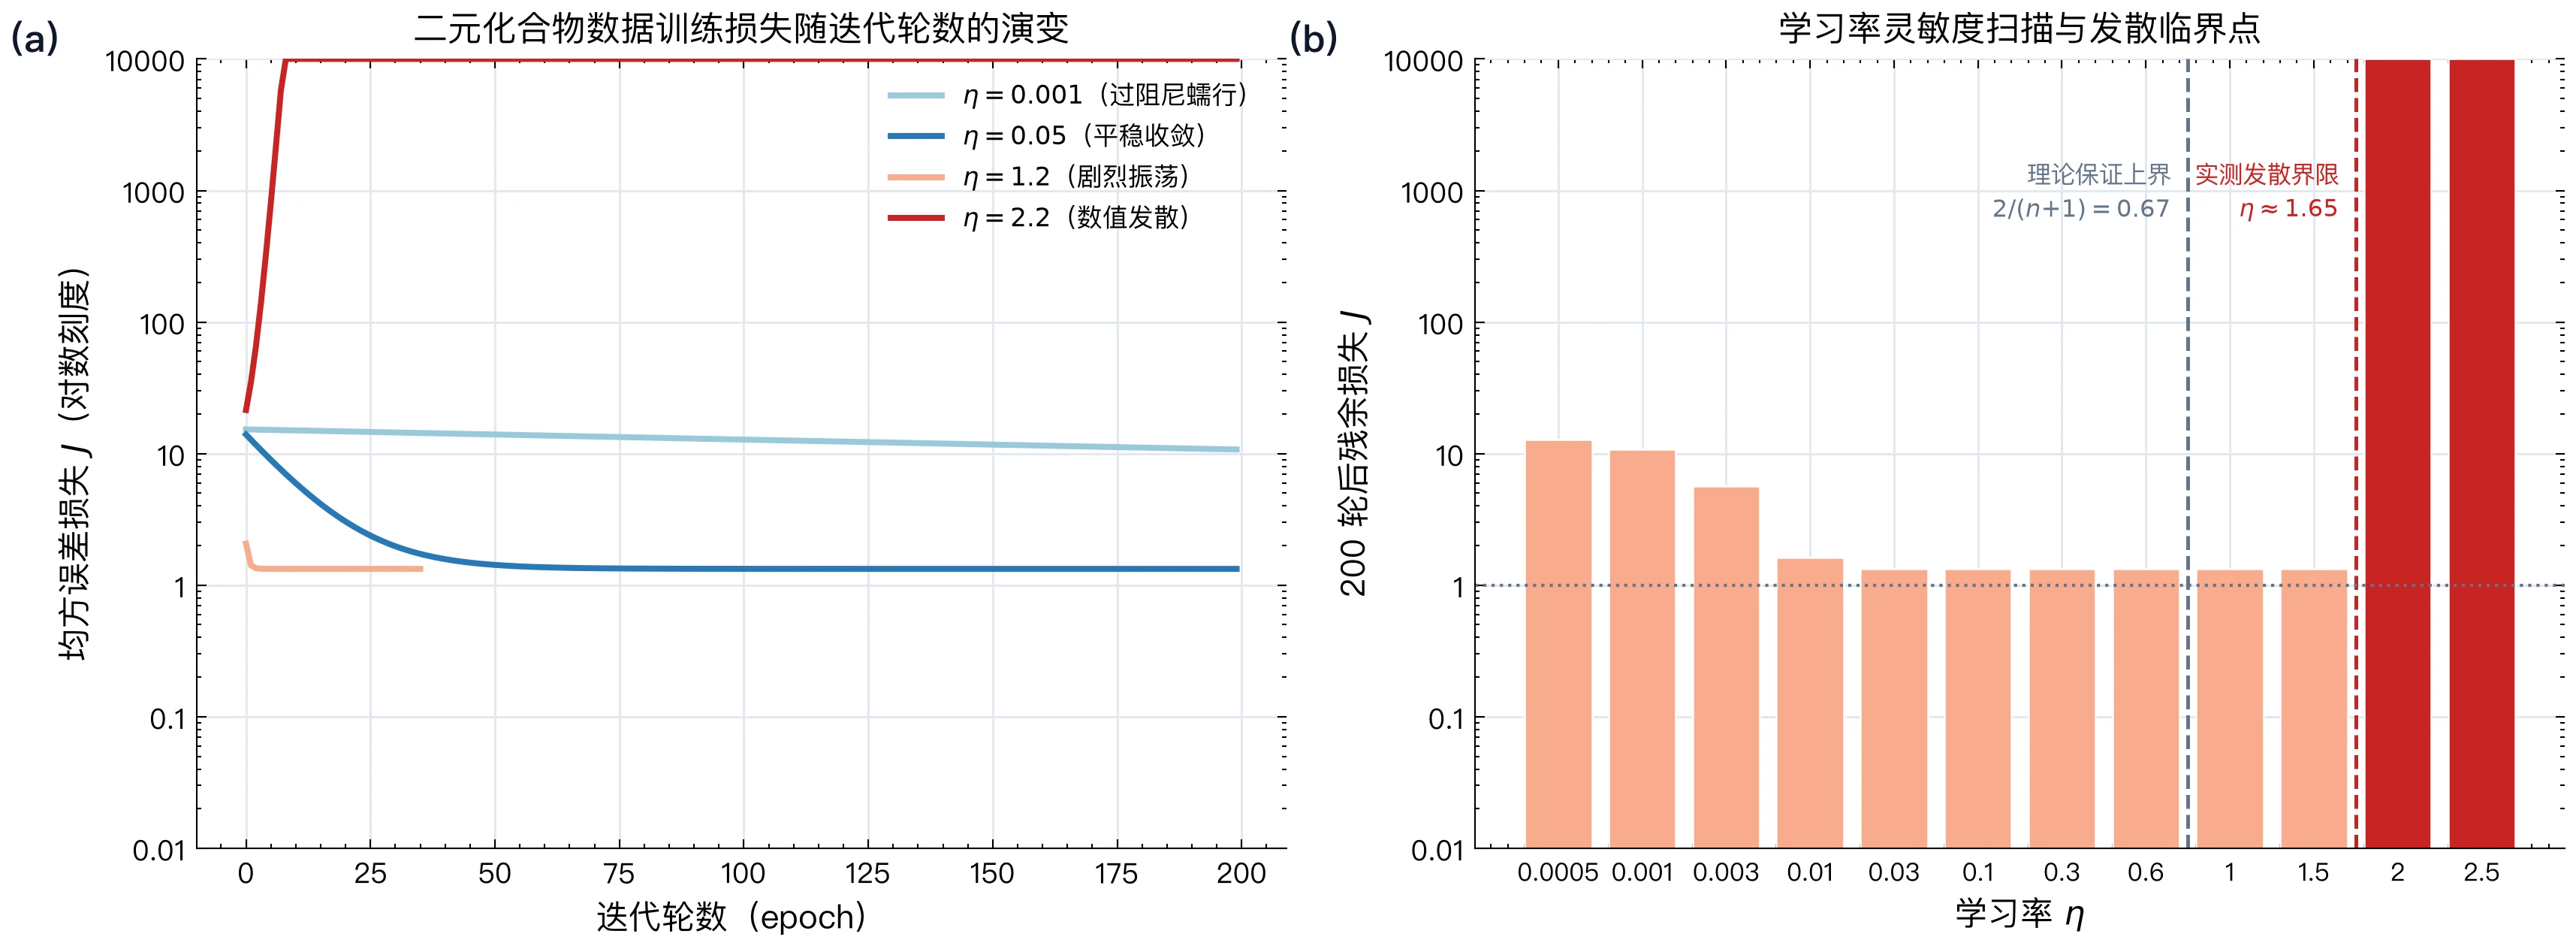
对这两个特征,Hessian 的特征值为 、(来自截距方向)和 ,于是 ,,。图 29(b) 中损失在 处陡然上升,正是式 (55) 的直接体现。这些特征值为什么恰好是 和 1,将在附录 B.6 解释。
其中 称为动量系数,常取 0.9; 时退化为普通梯度下降。对正定二次损失,重球法取相应最优的 和 时,渐近收敛因子可以从 改善为 。例如 时,前者约为 0.9998,后者约为 0.98,所需步数减少约两个数量级。
B.6 标准化与正则化怎样改变曲率
标准化包括中心化(减去均值)和缩放(除以标准差),分别处理均值偏移和数值尺度。对各列应用式 (7) 后,每列特征的均值为零、方差为 1, 中特征列与常数列的交叉项全部为零,对角元全部为 1,于是
其中 是各特征之间的相关系数矩阵。式 (57) 说明:
- 中心化使特征与截距“解耦”,截距方向的特征值恰好为 1;
- 缩放使各特征的曲率处于同一量级;
- 标准化无法消除特征之间的相关性。对两个相关系数为 的特征, 的特征值为 ,因此 。
现在可以解释附录 B.5 中的特征值了:在图 29 中, 与 的相关系数 ,所以特征值为 (即 1.21 和 0.79),再加上截距方向的 1。同理,图 10(b) 中 而不是 1,也是因为 与 之间存在一定的相关性。若特征之间高度相关,即使标准化后条件数依然可能很大——第 2.5.2 节使用 4 个特征时,标准化后的 约为 41。这时需要借助 2.3.7 节的正则化,或删去冗余特征。
中心化的重要性在第 2.5.1 节的 Arrhenius 案例中体现得尤为明显:横坐标 的数值约为 3,量级“正常”,但由于它的均值(约 3.15)远大于标准差(约 0.14),这一列几乎与常数列平行,条件数仍高达约 。只有同时中心化和缩放,条件数才降到 1。
岭回归的 Hessian 为 ,最后的零表示不惩罚截距。若特征已经中心化,权重与截距对应的块分开,权重块的各特征值增加 ;不能在一般未中心化的增广矩阵中,把所有特征值都简单加上 。正的惩罚系数能够使权重解唯一并改善某些病态问题,但包含未惩罚截距的整体条件数并不保证随 增大而一直降低。
普通梯度下降下,L2 项带来的更新可写成对权重的衰减;这一等价关系不能不加条件地推广到所有优化器。
B.7 完整代码的阅读顺序
先打开 linear_unit.py,按下面的顺序查阅即可,无需从头读到尾:
predict、loss和gradient:分别计算预测、平方误差和梯度。_apply_update与fit:完成参数更新,控制批量大小、动量与学习率安排。StandardScaler:保存训练集的均值与标准差,再用于新数据。normal_equation与check_gradient:核对直接解和手写梯度。- 数据划分与评价函数:支持案例中的训练集、测试集和交叉验证。
dot 是向量点积,axpy 计算 ,名称沿用 BLAS;col 取出矩阵的一列。指标函数包括 MSE、RMSE、MAE 与 ;其中 mse 没有损失函数里的 。RMSE 和 的定义见式 (27)。
学习率安排 lr_schedule 支持固定值、逆时衰减 ,以及按阶段减半。MinMaxScaler 将特征映射到 ,最大值与最小值同样只能从训练集计算。PolynomialFeatures 生成平方项、交叉项和立方项;输入发生了变化,但模型仍对参数保持线性。
normal_equation 构造正规方程并用列主元高斯消元求解。condition_number 用幂迭代与反幂迭代估计最大、最小特征值,并把常数列计入。train_test_split 支持随机划分与按 groups 整组划分,kfold_indices 提供交叉验证所需的索引。
检查梯度时,可以用中心差分近似每个偏导数:
计算某个参数的差分时,其他参数保持不变。中心差分的截断误差为 ,但过小的 也会受到浮点舍入影响。配套程序在带隙数据上得到的最大相对误差约为 ,可作为该实现的数值核对;一次核对通过并不替代对其他输入的检查。
chem_data.py 保留了 48 种元素的性质表、支持多重括号的化学式解析器,以及描述符计算函数。数据包括 73 种无机固体的带隙、C1–C20 正构烷烃的沸点、五个 N₂O₅ 速率常数、水的饱和蒸气压,以及 21 种取代基的 Hammett 常数 [5]。描述符包括电负性差、平均电负性、平均共价半径、平均主量子数、摩尔质量和第一电离能差。
带隙数值取自文献中常被使用的室温附近值,实验方法、晶型和样品不同会带来差异,应按教学数据使用。demo_playground.py 中使用 Hammett 常数构造的响应还特别标明为演示值,并非实验测量。
demo_playground.py 依次打印参数变化,比较学习率、特征缩放和批量大小。学习率实验的输出如下:
text
最小二乘解对应的最低损失 J* = 0.000204561(数据含扰动项,J* 不为 0)

     学习率 η         第 20 步 J        第 200 步 J 现象
------------------------------------------------------------------------------
      0.01         0.102187        0.0452624 仍在缓慢下降
      0.10        0.0448449      0.000217121 仍在缓慢下降
      0.50        0.0011493      0.000204561 200 步内收敛
      1.00      0.000208793      0.000204561 200 步内收敛
2.20 2.07894 2.33822e+29 发散:一步比一步更远这组演示数据的稳定上限约为 2。表中选取的 0.01、0.1、0.5、1.0 都能收敛,2.2 会发散;不能据此推断在整个稳定区间内,学习率越大一定越快,B.5 节给出了最优固定学习率的条件。